
Dalla carta topografica storica al rilievo 3D: digitalizzare le isoipse con GX-TXT e Python
Una carta topografica stampata è già un modello del territorio: le curve di livello descrivono l’andamento delle quote, ma non costituiscono ancora una superficie tridimensionale utilizzabile per analisi e visualizzazioni. Per passare dall’una all’altra occorre ricostruire coordinate, distinguere le singole isoipse, attribuire le elevazioni corrette e affrontare un problema meno banale di quanto sembri: i tracciati ricavati da una scansione possono essere incompleti, imprecisi o persino intersecarsi tra loro.
In questo esperimento utilizziamo GX-TXT per digitalizzare una porzione di una carta storica dello Yosemite e uno script Python, eseguito attraverso le API pubbliche del framework, per ottenere una superficie interpolata, un rapporto quantitativo di qualità e due visualizzazioni 3D. L’obiettivo non è riprodurre perfettamente il paesaggio attuale, ma mostrare un procedimento verificabile e riutilizzabile su altri documenti cartografici.
Dati dell’esperimento: carta USGS Yosemite del 1909; scala dichiarata 1:125.000; intervallo delle isoipse 100 ft; immagine acquisita a 400 DPI; otto tracciati digitalizzati appartenenti a sette quote, da 4000 a 4600 ft; 8.046 punti pubblicati nel Dataset di origine. Il link di riferimento è inserito nella sezione manuali.
Una carta del 1909 come sorgente scientifica
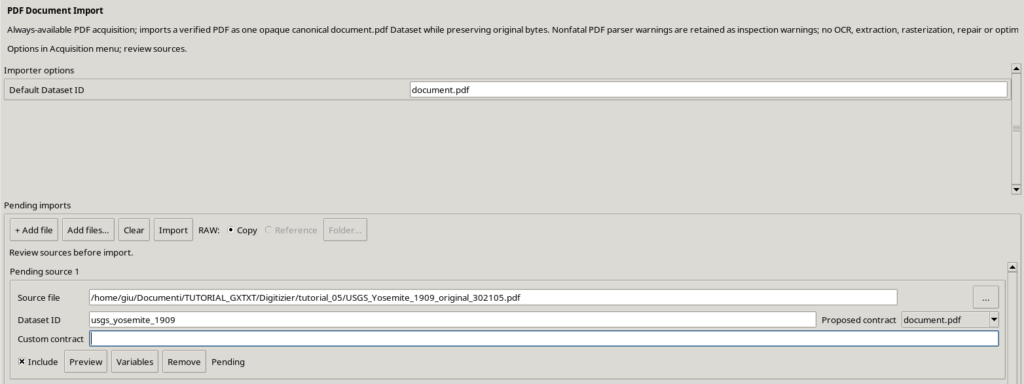
La base dell’esperimento è una carta topografica storica dello United States Geological Survey (USGS), relativa al quadrangolo dello Yosemite, datata 1909 e successivamente ristampata. La carta riporta quote in piedi e una distanza tra isoipse di 100 ft. Il suo valore, per questo lavoro, è duplice: permette di affrontare un caso reale di acquisizione da documento antico e offre un insieme di linee di quota riconoscibili, adatte alla digitalizzazione assistita.
Non bisogna però attribuirle una precisione moderna. La documentazione stampata riporta anche una nota storica relativa a quote successivamente risultate 85 ft troppo elevate. Nell’esperimento abbiamo conservato i valori riportati dalla carta, senza applicare silenziosamente alcuna correzione altimetrica. Anche l’orientamento e la geometria di una scansione sono soggetti a distorsioni: i risultati sono quindi riferiti a un sistema cartesiano locale, non a coordinate geografiche o UTM assegnate artificialmente.
Dall’immagine alle coordinate metriche
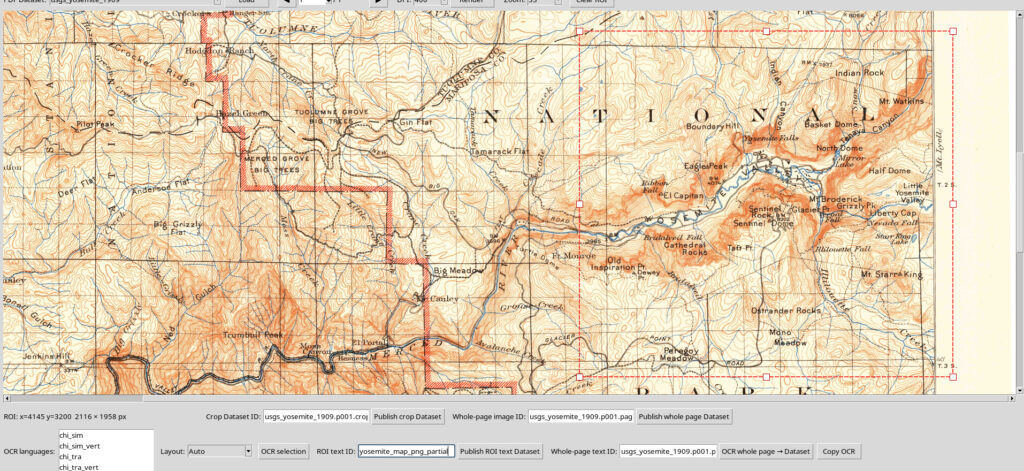
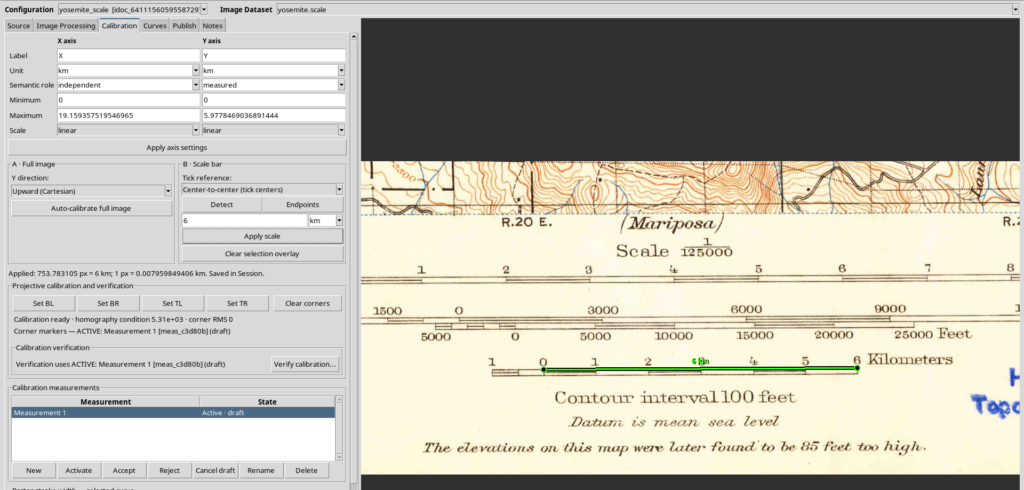
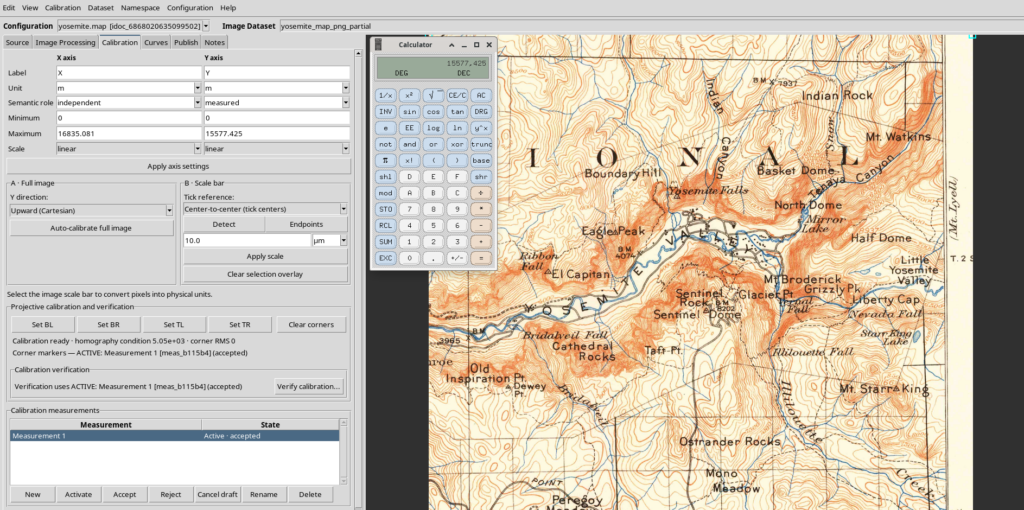
Abbiamo lavorato su un’immagine raster ottenuta dal PDF originale a 400 DPI, selezionando due regioni distinte: una per l’area topografica da analizzare e una per la barra di scala. Tenere separato il riferimento metrico dall’area di studio facilita il controllo della calibrazione.
Il passaggio fondamentale consiste nell’associare una distanza nota della barra di scala a una distanza misurata in pixel. Nel nostro caso, il segmento di 6 km corrisponde a circa 753,78 pixel, da cui si ricava un fattore vicino a 7,96 m/pixel. Questo rapporto è stato poi impiegato per calibrare la regione topografica, con assi X e Y espressi in metri.
Non è necessario raddrizzare artificialmente la scansione per ottenere un esempio utile. In questo caso è stata mantenuta la geometria originale del documento, utilizzando come riferimento la linea della barra di scala. Resta comunque importante verificare che la scelta sia coerente con l’accuratezza richiesta: una calibrazione di scala locale non elimina automaticamente rotazione, deformazioni anisotrope o errori cartografici.
Digitalizzare isoipse, non semplicemente disegnare linee
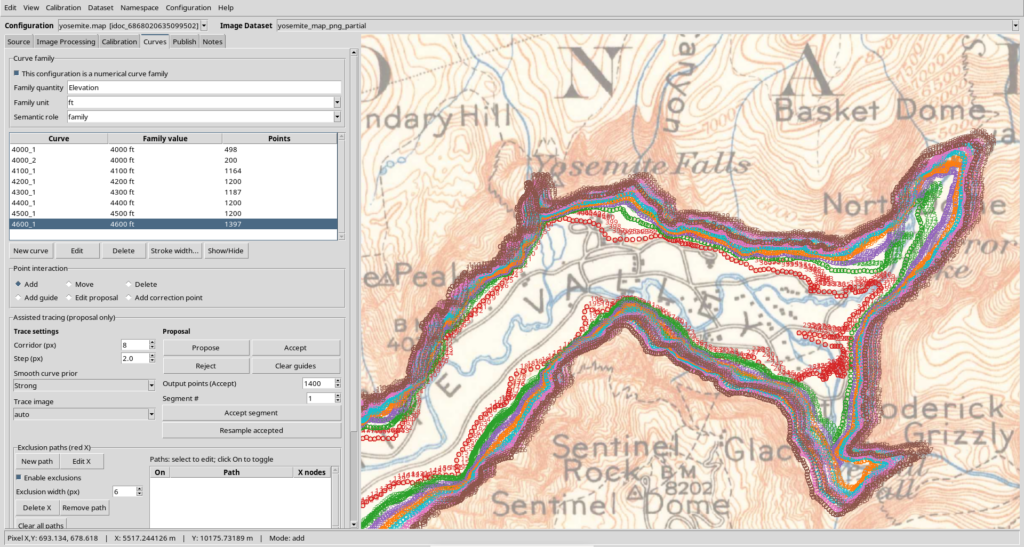
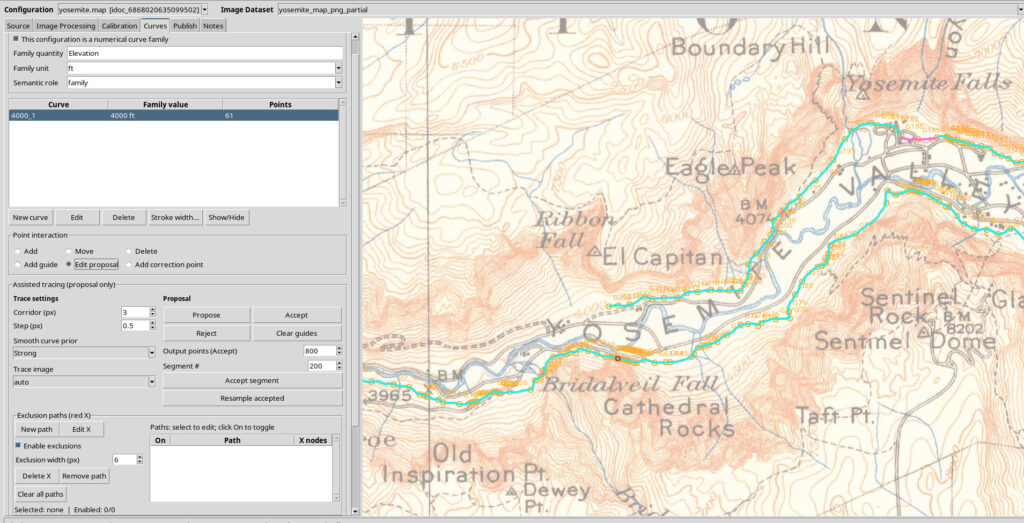
Nel Curve Digitalizer di GX-TXT ogni curva segue una sequenza ordinata di punti. La funzione di proposta assistita permette di seguire un tracciato riconoscibile nell’immagine e di correggerlo prima dell’accettazione. Per una carta antica il controllo visivo resta indispensabile: scritte, fiumi, strade, zone scolorite o linee ravvicinate possono confondere il riconoscimento automatico.
Abbiamo impostato una famiglia numerica di curve con grandezza Elevation, unità ft. Le quote pubblicate sono 4000, 4100, 4200, 4300, 4400, 4500 e 4600 ft. A 4000 ft sono stati digitalizzati due tratti distinti: per questo abbiamo otto curve, ma sette livelli altimetrici. La struttura non richiede una curva per ciascuna quota, né un numero prestabilito di punti per curva.
Il Dataset pubblicato
La pubblicazione produce un Dataset canonico di tipo curve_family.table. Al suo interno ogni riga rappresenta un punto e sono conservate le informazioni necessarie a ricostruire il tracciato:
- X e Y: coordinate sul piano, in metri;
- Curve ID (
curve_key): identificatore stabile del tracciato a cui appartiene il punto; - Ordine del punto (
point_order): posizione lungo la singola curva; - Parametro della famiglia: quota del tracciato, in piedi.
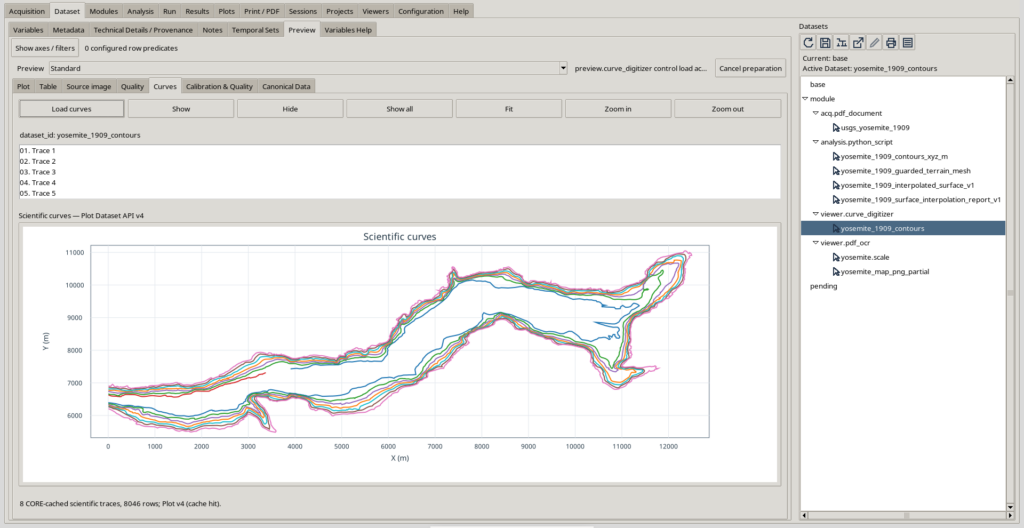
Il Dataset utilizzato per l’interpolazione si chiama yosemite_1909_contours e contiene 8.046 punti. Un unico Dataset può quindi contenere più isoipse distinte; non occorre creare una pubblicazione autonoma per ciascuna curva.
Prima di passare alla ricostruzione 3D conviene utilizzare la Preview per individuare salti anomali e collegamenti rettilinei che non seguono la cartografia. L’ordine numerico dei punti può essere corretto e la geometria comunque sbagliata: l’ispezione del grafico è una verifica complementare, non un semplice abbellimento.
Perché ricostruire una superficie non è un’operazione automatica
Un’isoipsa assegna una quota ai punti di una linea. Per costruire una superficie tridimensionale dobbiamo stimare la quota anche tra una linea e l’altra. Indicando con X e Y le coordinate planimetriche, il risultato cercato è una funzione:
\[ Z=f(X,Y) \]
Questa rappresentazione è adatta a un normale modello altimetrico a valori singoli. Ha però una conseguenza: nello stesso punto XY non possono esistere due quote diverse. Se due isoipse con elevazioni differenti si intersecano dopo la digitalizzazione, almeno una parte dei vincoli è incompatibile con una superficie di questo tipo.
Tali incroci possono derivare da punti inseriti in modo impreciso, tratti molto ravvicinati, errori della mappa, passaggi ambigui oppure dalla scelta di rappresentare con una superficie monovalore geometrie che, in natura, sarebbero più complesse. Uno script scientifico non dovrebbe trasformare automaticamente questi casi in pareti sospese o attribuire arbitrariamente ragione a una delle due linee.
La soluzione adottata è conservare integralmente il Dataset originale, identificare le zone problematiche e utilizzare le osservazioni circostanti per ricostruire, dove possibile, una superficie interpolata. Il risultato è un modello derivato, non una correzione certificata del documento storico.
Gli script Python: un workflow riutilizzabile
La parte più interessante dell’esperimento è che l’interpolazione non è una funzione speciale scritta esclusivamente per lo Yosemite. È realizzata con uno script Python eseguito nel Python Script Workspace, che legge un Dataset pubblicato dal Curve Digitalizer e richiama le API pubbliche GX-TXT tramite Script Bridge.
Per chi desidera ripetere o adattare il procedimento, i file essenziali sono tre:
| Script | Scopo | Cosa produce |
|---|---|---|
04_interpolate_yosemite_surface_bridge.py | Legge le isoipse, rileva i conflitti, interpola e valuta la qualità | Dataset HDF5 della superficie + Dataset testuale del rapporto |
05_plot_interpolated_surface_v4.py | Crea i due grafici della superficie mediante Plot Dataset API v4 | Plot altimetrico e Plot della distanza dalle isoipse |
06_finalize_yosemite_plot_v4_scenes.py | Configura la presentazione e rende persistenti le scene 3D | Due rappresentazioni Native3D associate ai Plot |
I numeri iniziali sono parte dei nomi dei file di lavoro, non indicano passaggi obbligatori di una serie di guide. Per eseguire il workflow completo, invece, l’ordine dei tre script è importante: prima si pubblica la superficie, poi si creano i Plot, infine si configurano le scene.
Tra i materiali forniti nella sezione Materiali è possibile scaricare tutti gli script python prodotti per la guida.
Lo script principale può gestire un numero qualsiasi di curve?
Il numero di curve non è fissato a otto. Lo script legge le righe del Dataset e le raggruppa utilizzando il curve_key. Può quindi lavorare con quattro, dieci, venti o più tracciati, purché siano rispettati i requisiti dei dati e i limiti computazionali configurati.
In particolare:
- devono essere presenti almeno due curve e almeno due quote differenti;
- ogni curva deve avere almeno due punti, con ordine coerente;
- quote diverse possono avere un numero diverso di segmenti e punti;
- due o più curve possono condividere la stessa quota;
- le coordinate X/Y devono essere già calibrate in metri e il parametro altimetrico della famiglia deve essere espresso in piedi, come richiesto dalla versione attuale dello script.
Lo script non identifica le colonne contando le posizioni in un CSV: usa i ruoli semantici pubblicati nei metadati GX-TXT. Per questo può leggere curve differenti con una stessa struttura canonica senza conoscere in anticipo i loro identificativi. Non significa, tuttavia, che funzioni senza modifiche con qualunque tabella numerica o con unità differenti.
Quali API eseguono realmente i calcoli?
Python si occupa dell’organizzazione delle osservazioni, del raggruppamento, della preparazione degli array e del controllo geometrico locale. Per i passaggi numerici fondamentali viene invece richiamato il framework:
| Operazione | API pubblica GX-TXT utilizzata |
|---|---|
| Lettura dei Dataset e dei metadati | CANONICAL_DATASET_API_v2, DATASET_METADATA_API_v1, DATASET_VARIABLE_SCHEMA_API_v3 |
| Ricampionamento delle singole linee | NUMERIC_API_v1.interpolate |
| Interpolazione bidimensionale dei punti sparsi | NUMERIC_API_v1.foundation — scattered / interpolate |
| Filtro di regolarizzazione della griglia | NUMERIC_API_v1.linear_matrix |
| Distanza dai punti di vincolo | NUMERIC_API_v1.foundation — geometry / kdtree_query |
| Confronto del modello con le osservazioni | NUMERIC_API_v1.foundation — grid / sample e NUMERIC_API_v1.residual_metrics |
| Pendenza della superficie | NUMERIC_API_v1.foundation — calculus / gradient_grid |
| Pubblicazione del campo numerico e del rapporto | DATASET_PUBLICATION_API_v2, DATASET_FILE_PUBLICATION_API_v1 |
| Plot e scene tridimensionali | PLOT_DATASET_API_v4 |
Il controllo delle intersezioni tra segmenti delle isoipse e alcune maschere locali restano implementati con Python/NumPy e con scipy.spatial.cKDTree, perché non abbiamo utilizzato un’unica API pubblica vettoriale del framework capace di eseguire tutto questo controllo topologico. È una distinzione importante: lo script sfrutta le API numeriche disponibili, ma non pretende che ogni singola operazione geometrica sia delegata a GX-TXT.
Questa architettura è utile anche per esplorare il framework stesso: il ricercatore può identificare esattamente quali operazioni GX-TXT espone agli script, quali calcoli esegue attraverso il Bridge e quali richiedono ancora logica applicativa.
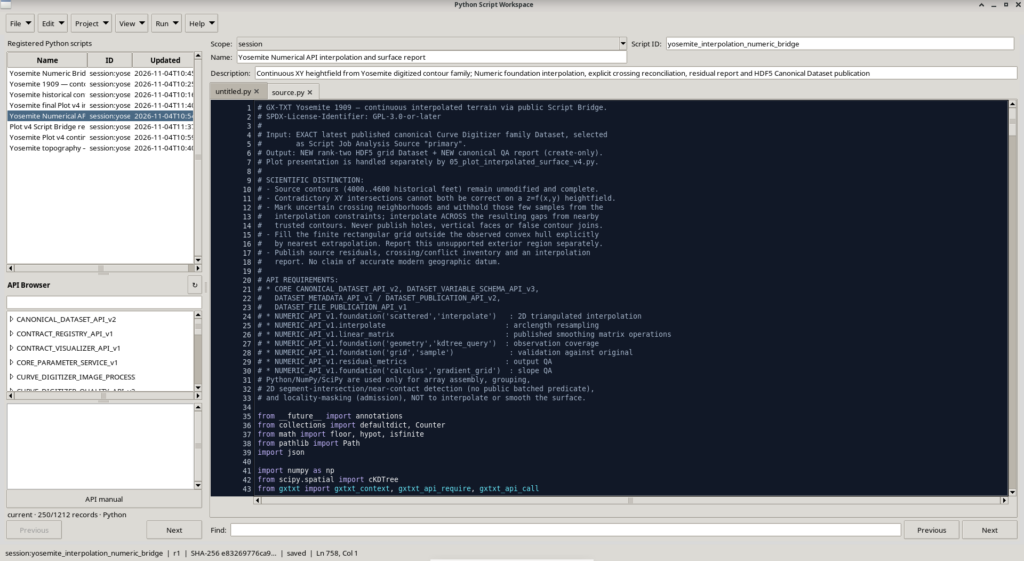
Utilizzare gli script nel Python Script Workspace
Il procedimento seguente descrive il percorso riproducibile attraverso l’interfaccia. Nel nostro esperimento l’esecuzione originale è stata avviata programmaticamente tramite la pubblica Script Job API, con la Session esplicitamente indicata; non è necessario adottare quella modalità per riprodurre i risultati. Un utente può servirsi del normale Script Runner di GX-TXT.
Preparare i dati
Aprire una Session GX-TXT e pubblicare dal Curve Digitalizer una famiglia numerica di curve con coordinate X/Y metriche e quote in ft. Controllare la Preview e annotare l’ID effettivo del Dataset: nell’esempio è yosemite_1909_contours.
È utile salvare o duplicare la Session prima di eseguire elaborazioni alternative, così da tenere separati il Dataset originale, le diverse prove di interpolazione e i risultati finali.
Importare e registrare lo script
Aprire Viewers → Python Script Workspace. Il Workspace supporta l’importazione di sorgenti Python UTF-8 mediante File → Import .py (Ctrl+O), oltre alla creazione di un nuovo script e all’editing del codice.
- Importare
04_interpolate_yosemite_surface_bridge.pyoppure copiarne il contenuto in un nuovo script Python. - Impostare Scope = Session per mantenerlo nella Session dell’esperimento, e assegnare un ID univoco. Nell’esempio lo script è registrato come
yosemite_interpolation_numeric_bridge, con nome visualizzato Yosemite Numerical API interpolation and surface report. - Verificare le API richieste e salvare lo script. Il Registry registra la revisione e l’hash del sorgente.
- Controllare il valore della costante
INPUTnel codice: deve coincidere con il Dataset effettivamente pubblicato.
Importare un file non significa eseguirlo. Il sorgente deve essere salvato e avviato esplicitamente dopo la revisione delle sorgenti scientifiche.
Selezionare l’input e avviare il Job
Nel menu Run del Python Script Workspace scegliere Open Script Runner. Il Runner permette di aggiungere un input Dataset e di associarlo a un nome semantico. Per questo script l’alias richiesto è esattamente primary; il Dataset associato deve corrispondere alla costante INPUT.
Controllare Session, Script ID/revisione, Dataset sorgente, prerequisiti Python e API disponibili. Utilizzare la validazione del Runner prima di premere Run Job. Lo script effettua un ulteriore controllo iniziale: se la sorgente non coincide con quella attesa o se mancano le unità e i ruoli richiesti, si interrompe anziché produrre un Dataset ambiguo.
La procedura necessita di un ambiente Python con NumPy e SciPy, oltre al client gxtxt reso disponibile nell’ambiente di esecuzione GX-TXT. Non è uno script pensato per essere lanciato come un normale python script.py fuori dal framework: in quel caso mancherebbero il contesto di Session e le API pubbliche Script Bridge.
Verificare che il risultato sia stato pubblicato
Al termine del Job, nella Session devono essere presenti due nuovi Dataset:
yosemite_1909_interpolated_surface_v1: la superficie interpolata su griglia regolare, memorizzata in HDF5;yosemite_1909_surface_interpolation_report_v1: il rapporto testuale con metodo, parametri, controlli topologici, residui e chiamate API.
La superficie include non soltanto la variabile z_m, ma anche distance_to_contour_m, slope_rise_over_run, outside_hull e near_conflicting_contours. Questi campi aiutano a capire dove il modello è meno vincolato dalle osservazioni.
La griglia HDF5 non va confusa con una semplice tabella di punti: z_m è una variabile a due dimensioni, associata agli assi X e Y.
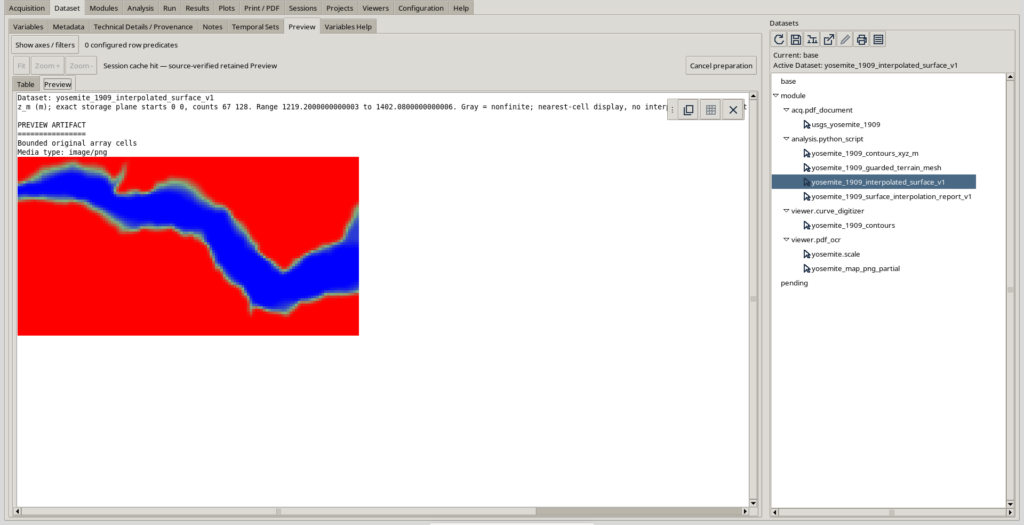
Produrre i Plot v4 e le scene Native3D
Dopo che il Dataset HDF5 è stato pubblicato, utilizzare 05_plot_interpolated_surface_v4.py nel Python Script Workspace, scegliendo come input primary il Dataset della superficie (non più quello delle isoipse). Lo script prepara due rappresentazioni Plot Dataset v4:
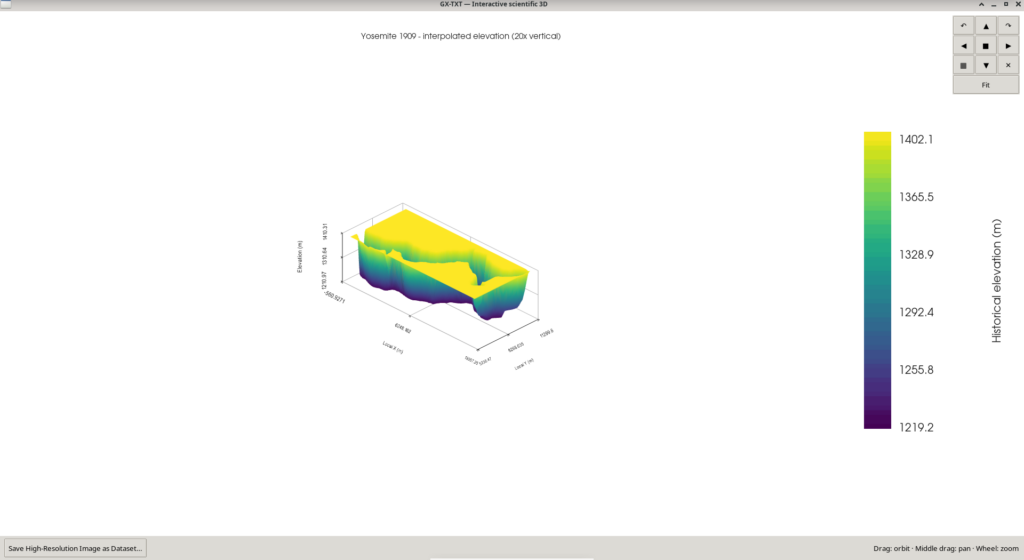
- Elevation: la quota
z_mdetermina l’andamento e la colorazione della superficie. - Distance to contour: la geometria resta la stessa, ma il colore esprime
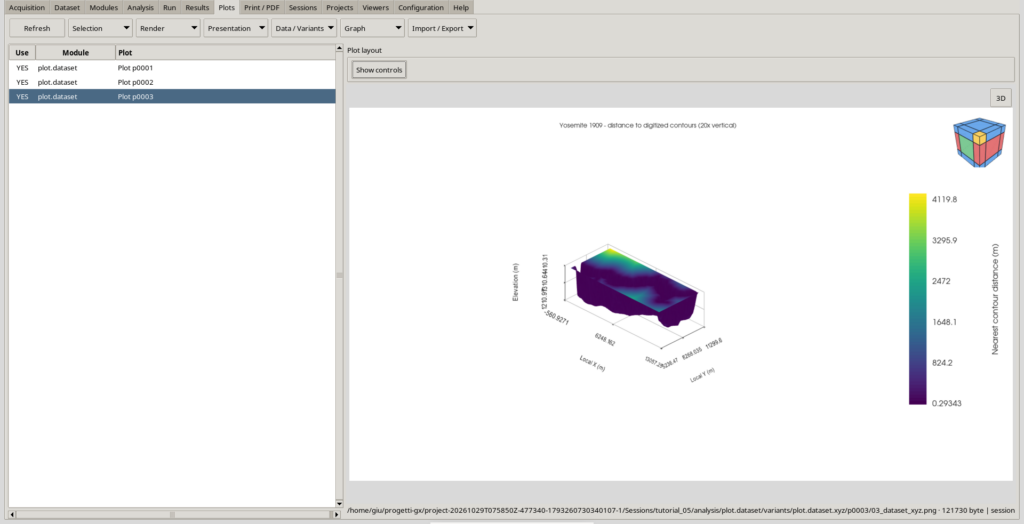
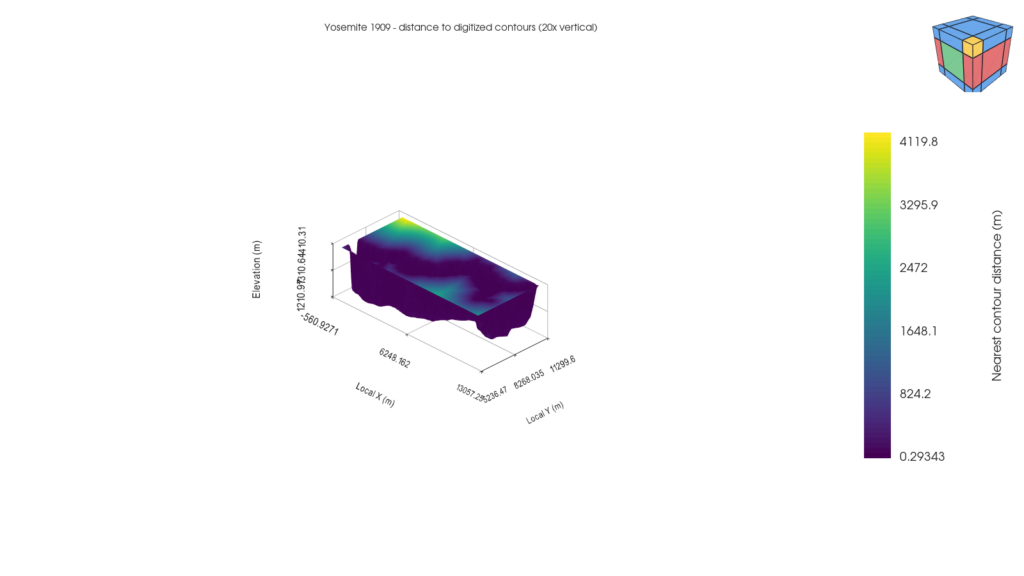
distance_to_contour_m, cioè la distanza planimetrica dai vincoli digitalizzati più vicini.
Aprire i Plot nell’interfaccia di GX-TXT e verificarli mediante la visualizzazione 3D. Il file 06_finalize_yosemite_plot_v4_scenes.py può essere utilizzato per impostare programmaticamente presentazione e persistenza delle rappresentazioni, ma richiede particolare attenzione agli ID delle Varianti: nella Session dell’esempio erano p0002 e p0003; in una Session nuova potrebbero essere diversi. Leggerli dai risultati del secondo script e aggiornare i relativi riferimenti nel terzo. Non tentare di forzare il database Workspace se un’altra istanza lo sta già utilizzando.
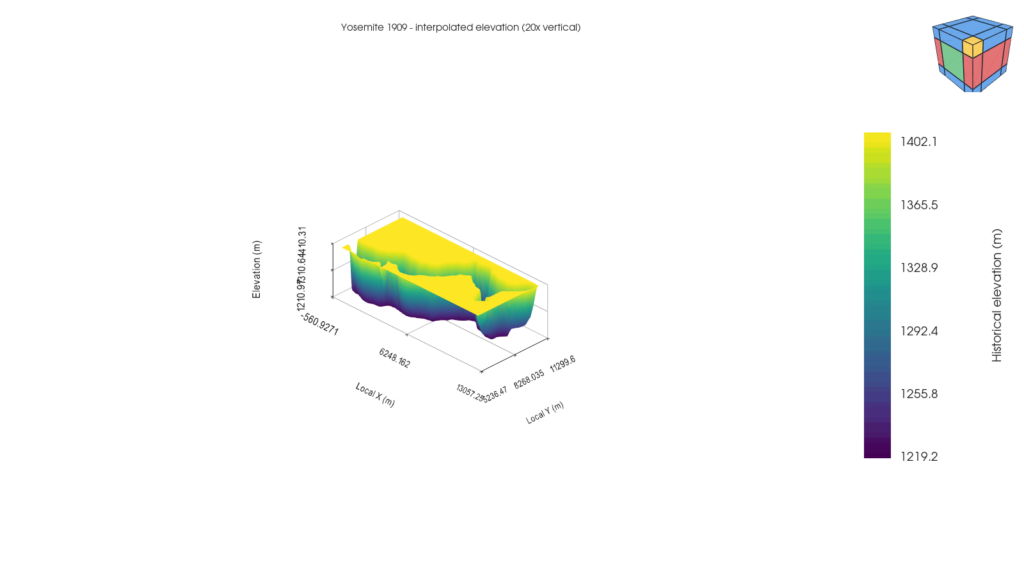
Nel nostro caso la presentazione finale utilizza una esagerazione verticale dichiarata di 20×, scelta per rendere leggibile il profilo. Non modifica le quote memorizzate, ma va indicata nella didascalia per evitare interpretazioni errate.
Come adattare lo script a un’altra carta
L’uso più interessante non è ripetere gli stessi numeri dello Yosemite, ma trasferire il metodo ad altre carte o a nuove digitalizzazioni. I cambiamenti ordinari si concentrano in poche costanti e nei parametri all’inizio dello script principale.
Scegliere nuovi ID senza sovrascrivere il lavoro precedente
All’inizio di 04_interpolate_yosemite_surface_bridge.py compaiono:
INPUT = "yosemite_1909_contours"
OUTPUT = "yosemite_1909_interpolated_surface_v1"
REPORT_DATASET = "yosemite_1909_surface_interpolation_report_v1"
Per una nuova carta occorre assegnare a INPUT l’ID del Dataset canonico delle isoipse e scegliere due nuovi ID liberi per OUTPUT e REPORT_DATASET. La pubblicazione è impostata in modalità create-only: non sostituisce automaticamente un Dataset già esistente. È una protezione intenzionale contro sovrascritture accidentali.
Se si cambia il nome del Dataset di superficie, bisogna aggiornare anche DATASET_ID nel file 05_plot_interpolated_surface_v4.py e DATASET nel file 06_finalize_yosemite_plot_v4_scenes.py. Gli ID delle Varianti Plot usati nello script finale vanno poi adattati a quelli creati nella nuova Session.
Esempio: per confrontare due configurazioni della stessa carta si possono usare gli stessi dati di ingresso ma output distinti, come terrain_surface_test_a e terrain_surface_test_b, ciascuno con il proprio rapporto. Così diventa possibile verificare se una diversa impostazione produce miglioramenti senza perdere i risultati precedenti.
I parametri che conviene conoscere
Nel dizionario CFG dello script principale si trovano le impostazioni operative. Non occorre riscrivere gli algoritmi per eseguire un confronto controllato.
| Parametro | Valore usato | Che cosa controlla | Come interpretarne una modifica |
|---|---|---|---|
resample_step_m | 34 m | Distanza approssimativa fra vincoli ricampionati lungo le curve | Valori più piccoli aggiungono campioni e lavoro numerico; non aggiungono informazione cartografica originale |
conflict_guard_radius_m | 44 m | Intorno dei conflitti altimetrici escluso dai vincoli della stima | Aumentarlo rende più prudente la ricostruzione locale, ma affida più spazio all’interpolazione |
close_contact_threshold_m | 4 m | Soglia per trattare come problematiche due isoipse molto vicine di quote diverse | È una tolleranza geometrica, non una misura diretta dell’incertezza della carta |
near_contact_warning_m | 16 m | Soglia di segnalazione degli avvicinamenti | Produce avvisi diagnostici; non elimina automaticamente tutti i punti a quella distanza |
grid_pitch_m | 85 m | Passo desiderato della griglia | Un passo minore produce più nodi e dettagli grafici, ma non nuovi dati misurati |
minimum_grid_size / maximum_grid_size | 35 / 205 | Limiti del numero di nodi per direzione | Il passo effettivo può differire da quello richiesto per rispettare tali limiti |
smoothing_kernel | [0.16, 0.68, 0.16] | Intensità del filtro di regolarizzazione sui due assi | Conservare una terna simmetrica e non negativa; più peso ai vicini tende a smussare maggiormente il rilievo |
confidence_nearest_distance_m | 250 m | Distanza oltre la quale un nodo viene segnalato come poco coperto | È un indicatore nel rapporto, non una soglia che rimuove celle |
maximum_source_rows | 100.000 | Limite amministrativo di punti in ingresso | Aumentarlo non garantisce automaticamente tempi o memoria sufficienti |
Per iniziare, la scelta più sensata è mantenere i parametri verificati e modificare un solo valore alla volta. Ogni variante dovrebbe avere nuovi ID di pubblicazione e un rapporto distinto, così da confrontare superficie, residui e area di extrapolazione.
Il filtro è implementato come kernel simmetrico sui due assi: è quindi opportuno usare una terna della forma [a, b, a], con pesi non negativi e somma pari a 1. La versione attuale ricava entrambi i coefficienti laterali dal primo elemento della terna; modificare solo il terzo elemento non ha l’effetto che ci si potrebbe aspettare. Per esperimenti più articolati è preferibile revisionare consapevolmente anche la funzione di costruzione della matrice, invece di modificare il vettore a caso.
E se la carta è in metri, anziché in piedi?
La versione testata si aspetta quote in ft e applica il fattore esatto:
\[ 1\ \mathrm{ft} = 0{,}3048\ \mathrm{m} \]
Questo requisito viene anche verificato nei metadati. Per lavorare con quote originariamente espresse in metri non basta cambiare il nome del Dataset: è necessario adattare coerentemente il controllo dell’unità in read_source(), il fattore FT_TO_M, le denominazioni delle variabili e i metadati pubblicati. Lo stesso vale per carte con coordinate XY in chilometri o in altre unità.
Si tratta di una modifica relativamente contenuta, ma deve essere dichiarata e testata. Un Dataset che usa metri e viene interpretato come piedi genererebbe una superficie formalmente valida e scientificamente sbagliata.
E se ci sono molte più isoipse?
Non è necessario inserire il numero di curve in una costante: lo script rileva automaticamente Curve ID e livelli presenti nel Dataset. Si possono digitalizzare più tracciati della stessa quota oppure aggiungere nuovi livelli, sempre conservando il relativo curve_key e l’ordine dei punti.
L’aumento delle curve non elimina però i problemi topologici: può anzi aumentare il numero di intersezioni da esaminare. Conviene quindi controllare il rapporto a ogni nuova pubblicazione e verificare il numero di nodi trattenuti dopo l’esclusione delle zone conflittuali. Restano inoltre i limiti configurati sui punti sorgente, sui confronti geometrici e sulla griglia.
Un errore da evitare: confondere maggiore risoluzione con maggiore accuratezza
Portare grid_pitch_m da 85 a 20 metri produce una griglia più fitta, non una scansione migliore né nuovi rilievi del terreno. Una parte significativa dei punti sarebbe comunque stimata a partire dagli stessi tracciati. Analogamente, usare un ricampionamento lungo le isoipse molto più fitto della risoluzione originaria non recupera dettagli che la carta non contiene.
La qualità dipende soprattutto dalla copertura altimetrica, dalla correttezza delle curve, dalla calibrazione e dall’adeguatezza del modello scelto. Le impostazioni numeriche possono rendere il risultato più stabile e leggibile, ma non sostituiscono le osservazioni mancanti.
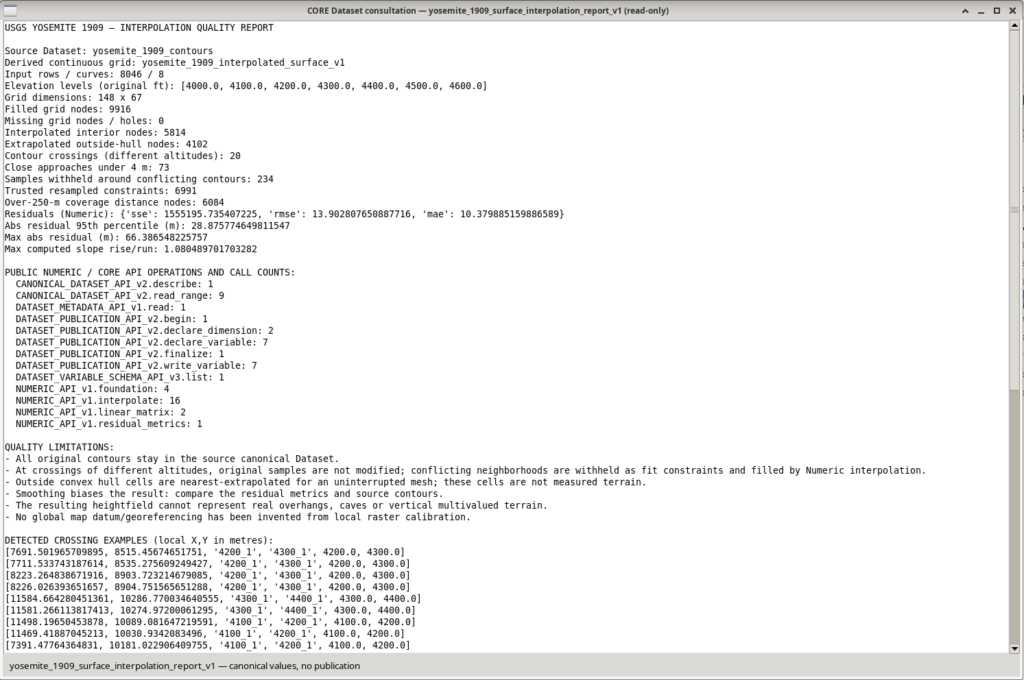
Il rapporto delle interpolazioni: che cosa controllare davvero
Lo script non si limita a produrre un’immagine: registra le scelte effettuate e fornisce indicatori utili per valutarne il risultato.
| Indicatore dell’esperimento Yosemite | Valore |
|---|---|
| Curve originali | 8, su 7 quote |
| Punti digitalizzati nel Dataset sorgente | 8.046 |
| Intersezioni XY fra isoipse di quote differenti | 20 |
| Avvicinamenti molto stretti, entro 4 m | 73 |
| Punti ricampionati candidati | 7.225 |
| Punti esclusi localmente dai vincoli per conflitti | 234 |
| Punti effettivi usati nell’interpolazione | 6.991 |
| Griglia finale | 148 × 67, cioè 9.916 nodi |
| Nodi interni all’inviluppo convesso, interpolati | 5.814 |
Nodi esterni, estrapolati mediante nearest | 4.102 (41,4%) |
| Nodi senza valore, ossia «buchi» | 0 |
| Nodi lontani oltre 250 m dal vincolo più vicino | 6.084 |
| RMSE rispetto ai punti originali | 13,90 m |
| 95º percentile dell’errore assoluto sui punti originali | 28,88 m |
| Errore assoluto massimo sui punti originali | 66,39 m |
Il dato più importante da interpretare è la copertura: circa il 41,4% dei nodi della griglia rettangolare ricade fuori dall’inviluppo convesso dei vincoli disponibili. Questi nodi hanno ricevuto valori mediante una extrapolazione nearest. Questo permette di visualizzare una superficie senza lacune, ma può produrre grandi zone piatte ai bordi. Non significa che il terreno storico fosse davvero pianeggiante.
Anche il valore RMSE = 13,90 m va letto correttamente: confronta la superficie calcolata con i punti delle isoipse originarie. È un residuo rispetto ai dati utilizzati nell’esperimento, non un errore predittivo indipendente e neppure un’incertezza assoluta della quota sul terreno. Non comprende una verifica geodetica della carta, una stima completa degli errori di digitalizzazione o una validazione contro un modello altimetrico esterno.
Nelle zone in cui due isoipse di quote diverse risultano incompatibili, il modello non sceglie in modo occulto quale linea correggere: nel nostro caso 234 vincoli ricampionati sono stati temporaneamente esclusi dalla stima in prossimità dei conflitti. Le curve originali, invece, sono rimaste nel loro Dataset canonico. Nel rapporto sono elencati anche esempi di coordinate e coppie di isoipse problematiche.
Come interpretare le due immagini 3D
Il Plot altimetrico risponde alla domanda: quale superficie continua si ottiene applicando il metodo scelto alle isoipse digitalizzate? La scala colori indica le quote in metri. Le eventuali terrazze o pareti apparenti ai limiti della copertura richiedono un confronto con la seconda immagine, non un’interpretazione geomorfologica immediata.
Il Plot della distanza dai tracciati risponde a una domanda differente: in quali zone il modello è vicino a punti digitalizzati e in quali zone se ne allontana? Non è una mappa probabilistica dell’incertezza; è un indicatore geometrico di supporto osservativo. Le zone più lontane sono quelle in cui nuove isoipse potrebbero migliorare maggiormente il modello.
Che cosa resta da controllare quando si cambia Dataset
Prima di considerare soddisfacente una ricostruzione su una carta diversa, suggeriamo quattro verifiche semplici e ripetibili:
- Calibrazione e unità. Controllare distanza nota, unità X/Y e unità delle quote. Non assumere che un’altra carta usi gli stessi piedi o la stessa scala.
- Continuità delle curve. Esaminare la Preview per individuare tratti che collegano zone distanti, punti fuori traccia, sovrapposizioni e direzioni inattese.
- Rapporto di interpolazione. Confrontare numero di punti trattenuti, intersezioni, residui e frazione estrapolata. Un modello continuo non è automaticamente un modello attendibile.
- Plot e dato originale affiancati. Verificare che gli elementi più marcati del modello siano compatibili con le isoipse osservate; non fidarsi soltanto del rendering 3D.
Per aumentare l’affidabilità, spesso il miglior investimento non è cambiare algoritmo, ma digitalizzare altre isoipse nelle zone scarsamente coperte, mantenendo identità, quote e ordine delle curve coerenti. Lo script può poi essere rilanciato su un nuovo Dataset pubblicato, usando nuovi ID di output e confrontando i rapporti.
Un metodo generale, con limiti dichiarati
Questo esperimento mostra come collegare tre attività che spesso restano separate: la digitalizzazione scientifica di un documento, l’elaborazione numerica mediante API pubbliche e la pubblicazione di risultati consultabili e rappresentazioni 3D persistenti nella stessa Session GX-TXT.
La procedura è applicabile, con gli adattamenti necessari, ad altre carte storiche, sezioni altimetriche o dati rappresentati da famiglie di curve quotate. Non sostituisce un DEM georeferenziato o un rilievo topografico moderno: produce una ricostruzione interpretativa controllabile, accompagnata da una descrizione esplicita delle scelte e delle regioni meno affidabili.
Il vantaggio di rendere pubblico anche lo script non è soltanto mostrare come è stata generata un’immagine. Significa consentire a chi legge di aggiungere altre curve, modificare la densità della griglia, confrontare diverse strategie e documentare i risultati, senza dover riscrivere da zero il processo di analisi.
Materiale per riprodurre l’esperimento
Download scripts python :
04_interpolate_yosemite_surface_bridge.py, 05_plot_interpolated_surface_v4.py e 06_finalize_yosemite_plot_v4_scenes.py.DownloadMappa utilizzata:
Yosemite Quadrangle, edizione 1909, ristampa 1951, identificativo 302105
Software utilizzato nell’esperimento: GX-TXT DEV112, Curve Digitalizer, Python Script Workspace, NUMERIC_API_v1, Canonical Dataset API, Plot Dataset API v4 e Native3D.
Altre tappe del progetto
- Curve Digitizer in GX-TXT: le curve dei datasheet diventano Dataset
- Dal grafico al Dataset scientifico: il primo esperimento con GX-TXT Curve Digitalizer
- GX-TXT Curve Digitalizer — digitalizzare una famiglia di curve con calibrazioni multiple
- GX-TXT Curve Digitalizer — digitalizzare una curva con assi logaritmici
- GX-TXT Curve Digitalizer – digitalizzazione scientifica con doppio asse Y, calibrazione e propagazione delle incertezze
- GX-TXT Curve Digitalizer: dalla microfotografia botanica all’analisi morfometrica con Python