

Catalogo Dataset e identità stabile
Corso Python scientifico in GX-TXT · Modulo 4 · Lezione 19
Un nome leggibile aiuta a riconoscere un Dataset, ma per richiederlo in modo affidabile uno script ha bisogno di un identificativo. In questa lezione esploriamo il catalogo della Session e descriviamo un Dataset attraverso l’API pubblica di GX-TXT.
Obiettivi: distinguere identificativo e nome
visibile; usare list e describe; leggere un
descrittore annidato senza assumere che l’ordine del catalogo sia
fisso.
Prerequisiti: dizionari e catalogo Dataset delle lezioni 5 e 9; Session con la serie sintetica del corso.
Identificativo, etichetta e contesto
Un identificativo è un valore usato per riferirsi a un oggetto all’interno di un contesto. Un’etichetta visibile (display label) serve invece a presentarlo alle persone e può essere più descrittiva. Due oggetti possono avere etichette simili; affidarsi alla posizione nell’elenco o a un nome mostrato sullo schermo può portare a selezionare l’oggetto sbagliato.
Nel nostro esempio l’ID è corso_python_serie_sintetica.
Lo usiamo come chiave della richiesta al bridge. L’identità va
interpretata nel contesto della Session: un ID uguale
in un’altra Session non dimostra che i dati siano gli stessi. Anche
quando un ID rimane uguale, una revisione del Dataset o dei suoi
metadati può cambiare il contenuto; per confronti riproducibili occorre
sapere quale versione dei dati si sta usando.
Catalogo e descrizione
CANONICAL_DATASET_API_v2/list elenca gli ID disponibili
nella Session corrente. describe, con un ID come argomento,
restituisce un dizionario di metadati. La struttura può includere
contratto, numero di righe e descrizioni delle variabili. Un Dataset può
rappresentare tipi di contenuto differenti: un documento testuale e una
tabella scientifica non hanno necessariamente le stesse variabili o
proprietà.
La chiamata pubblica si scrive:
catalogo = gxtxt_api_call("CANONICAL_DATASET_API_v2", "list", [])
descrizione = gxtxt_api_call("CANONICAL_DATASET_API_v2", "describe", [dataset_id])
Il terzo argomento è la lista degli argomenti dell’operazione. Non
c’è un ID per list; describe riceve un ID. Non
assumere che il primo elemento del catalogo sia sempre lo stesso: scegli
l’identificativo appropriato e verifica il suo significato.
Il Dataset dell’esempio
La serie creata nella lezione 9 contiene quattro coppie sintetiche di
tempo in secondi e segnale in millivolt. Non sono misure reali e non è
stata assegnata un’incertezza. La descrizione include il contratto
table.generic, il numero di righe e le variabili
tempo e segnale.
Le variabili hanno a loro volta identificativi e metadati. Non
confondere l’ID del Dataset con l’ID di una variabile: una lettura come
read_range richiede entrambi. Analizzeremo lo schema delle
variabili nella prossima lezione.
Codice completo
from gxtxt import gxtxt_api_call, gxtxt_api_require

gxtxt_api_require("CANONICAL_DATASET_API_v2@2")
dataset_id = "corso_python_serie_sintetica"
catalogo = gxtxt_api_call("CANONICAL_DATASET_API_v2", "list", [])
print("Dataset nel catalogo:", len(catalogo))
print("ID richiesto presente:", dataset_id in catalogo)
descrizione = gxtxt_api_call("CANONICAL_DATASET_API_v2", "describe", [dataset_id])
print("ID descritto:", descrizione.get("dataset_id"))
print("Contratto:", descrizione.get("contract"))
print("Righe:", descrizione.get("row_count"))
print("Variabili:", descrizione.get("variables"))
len conta gli ID, mentre in verifica se
quello richiesto è presente. La funzione get legge campi
del dizionario e restituisce None quando un campo non
esiste. La stampa completa delle variabili può essere lunga; non
assumere che tutte le versioni restituiscano gli stessi campi
facoltativi.
In un’applicazione riutilizzabile, gestisci esplicitamente l’assenza
del Dataset prima di chiamare describe. Qui lo script
presuppone che la lezione 9 sia stata eseguita nella stessa Session; se
l’ID manca, fermati e verifica la Session anziché inventare
metadati.
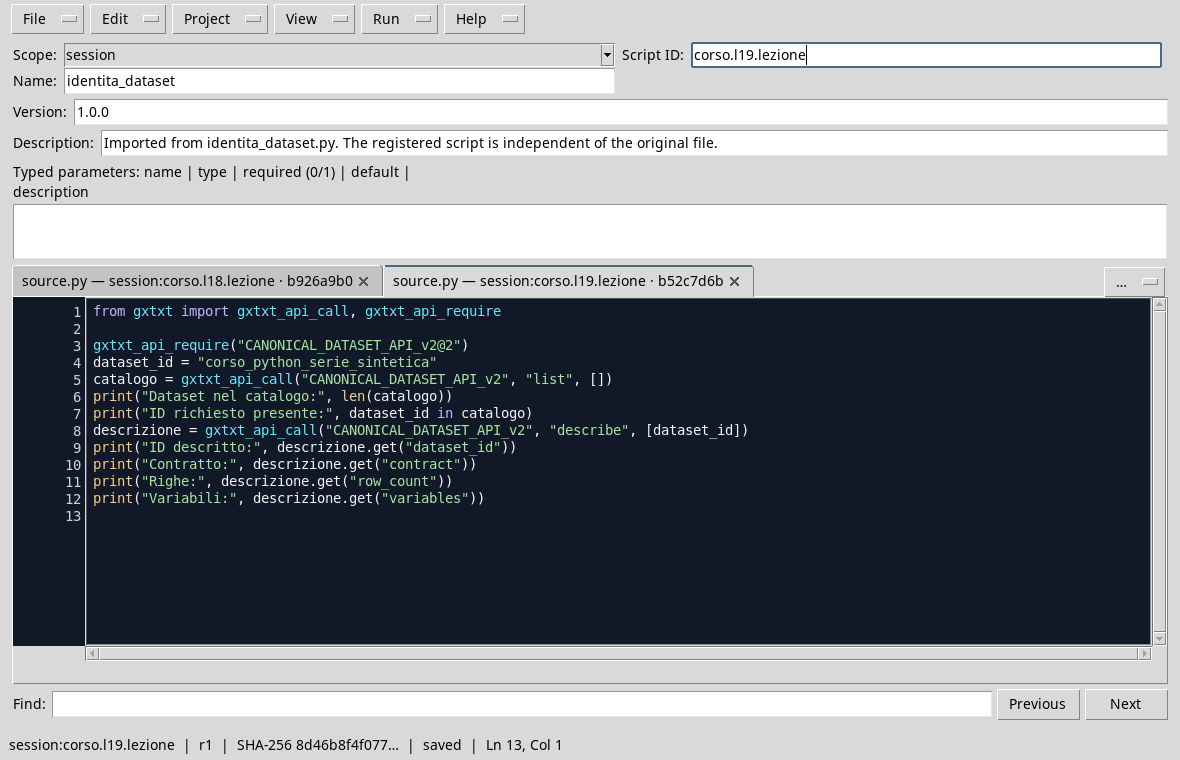
Lo script usa l’identificativo per richiedere il descrittore.
Esecuzione
- Apri la Session contenente
corso_python_serie_sinteticae il Viewer Python Scripts. - Importa
identita_dataset.py, assegna nome e Script ID nello scopesession, quindi salva. - Apri il Runner, premi Run Job e osserva l’output.
- Controlla che l’ID richiesto sia presente e coincida con quello descritto. Nell’esempio le righe sono quattro; il numero totale di Dataset può differire nella tua Session.
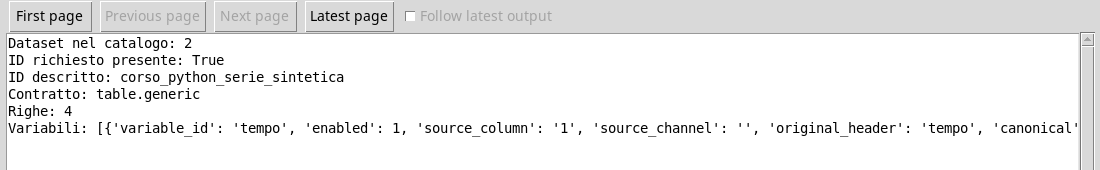
Il catalogo dell’esempio contiene due Dataset; la descrizione richiesta è quella della serie sintetica.
Errore comune
Usare catalogo[0] come sinonimo di «la mia serie» è
fragile: aggiungere un Dataset o cambiare l’ordine del catalogo può far
puntare a un altro oggetto. L’indice è utile per esplorare una lista;
per una richiesta scientifica usa l’ID previsto e verifica contesto e
metadati.
Esercizio
Se catalogo = ["serie_a", "serie_b"], quale espressione
verifica la presenza di "serie_b" senza fare ipotesi sulla
posizione? Che cosa significa se in un’altra Session esiste un Dataset
con lo stesso ID?
Soluzione ragionata
"serie_b" in catalogo restituisce True. Lo
stesso ID in un’altra Session identifica un oggetto in un contesto
diverso: da solo non dimostra che contenuto, unità o revisione siano
identici.
Nella prossima lezione leggeremo schema, unità e metadati delle variabili.