

Variabili, schemi e unità scientifiche
Corso Python scientifico in GX-TXT · Modulo 4 · Lezione 20
Una colonna numerica non è ancora una descrizione completa di un dato scientifico. Per interpretarla servono almeno identità, significato e unità, oltre al contesto necessario per capire origine e qualità. In questa lezione leggeremo lo schema delle variabili di un Dataset GX-TXT e i suoi metadati pubblici.
Obiettivi: distinguere ID e nome di una variabile; leggere descrittori e unità; riconoscere campi assenti; evitare di attribuire significati non documentati.
Prerequisiti: dizionari, catalogo e identità Dataset delle lezioni 5 e 19; Session con la serie sintetica della lezione 9.
Che cosa descrive uno schema
Uno schema descrive la struttura dei dati: quali variabili esistono, come sono identificate e quali proprietà sono disponibili. A seconda del Dataset e della versione, un descrittore può contenere tipo numerico, forma, unità, etichetta, ruolo semantico e informazioni sulle coordinate.
Un ID di variabile è il riferimento usato nelle chiamate pubbliche. Un nome o una etichetta sono informazioni di presentazione e possono avere regole diverse. Non usare la posizione della colonna come sostituto dell’ID quando l’API offre un’identità stabile.
Nel Dataset corso_python_serie_sintetica gli ID sono
tempo e segnale. La prima variabile usa
secondi (s), la seconda millivolt (mV). I
quattro punti sono sintetici, scelti per il corso, e non hanno
un’incertezza sperimentale assegnata.
Tipo, unità e ruolo
Il tipo, per esempio float64, descrive come sono
rappresentati i valori numerici. Non dice da solo se un numero
rappresenta tempo o tensione. L’unità specifica la scala della
grandezza, mentre il ruolo semantico può indicarne il significato, come
time o voltage.
Un’intestazione di colonna come segnale non garantisce
da sola unità, precisione, provenienza o incertezza. Se una proprietà
non è presente, va trattata come assente: non inventare un’unità o una
conversione sulla base del solo nome. Una stringa vuota, un campo
assente e un valore None possono richiedere interpretazioni
diverse secondo il contratto dell’API.
API pubbliche per lo schema
DATASET_VARIABLE_SCHEMA_API_v3/list riceve l’ID del
Dataset e restituisce una lista di descrittori di variabile.
get riceve l’ID del Dataset e quello di una variabile e
restituisce il suo descrittore.
DATASET_METADATA_API_v1/read legge i metadati del Dataset
nella Session corrente.
Nell’esempio iteriamo sulle variabili restituite da
list, prendiamo variable_id e chiediamo i
dettagli con get. Usiamo .get per campi
facoltativi. Nel risultato osservato il campo interrogato come
name non è presente e quindi viene mostrato
None: questo non significa che la variabile non abbia un
ID. Per i nomi e le etichette effettivamente disponibili occorre
consultare i campi documentati del descrittore nella versione in
uso.
Le chiamate nel ciclo sono una per variabile: su Dataset con molte variabili o su archivi remoti possono avere un costo. Riutilizza i descrittori già ottenuti quando il tuo lavoro lo consente e non fare ipotesi sull’ordine della lista.
Codice completo
from gxtxt import gxtxt_api_call, gxtxt_api_require

gxtxt_api_require("DATASET_VARIABLE_SCHEMA_API_v3@3")
gxtxt_api_require("DATASET_METADATA_API_v1@1")
dataset = "corso_python_serie_sintetica"
variabili = gxtxt_api_call("DATASET_VARIABLE_SCHEMA_API_v3", "list", [dataset])
print("Numero variabili:", len(variabili))
for voce in variabili:
    identificatore = voce["variable_id"]
    dettaglio = gxtxt_api_call("DATASET_VARIABLE_SCHEMA_API_v3", "get", [dataset, identificatore])
    print("ID:", identificatore, "nome:", dettaglio.get("name"), "unita:", dettaglio.get("unit"))
    print("Tipo:", dettaglio.get("dtype"), "ruolo:", dettaglio.get("semantic_role"))
metadati = gxtxt_api_call("DATASET_METADATA_API_v1", "read", [dataset])
print("Metadati disponibili:", metadati)
voce["variable_id"] richiede un campo indispensabile per
la chiamata successiva. Gli altri campi sono letti con get,
così un’assenza rimane visibile come None. L’ultima
chiamata legge metadati del Dataset, distinti dai descrittori delle
singole variabili.
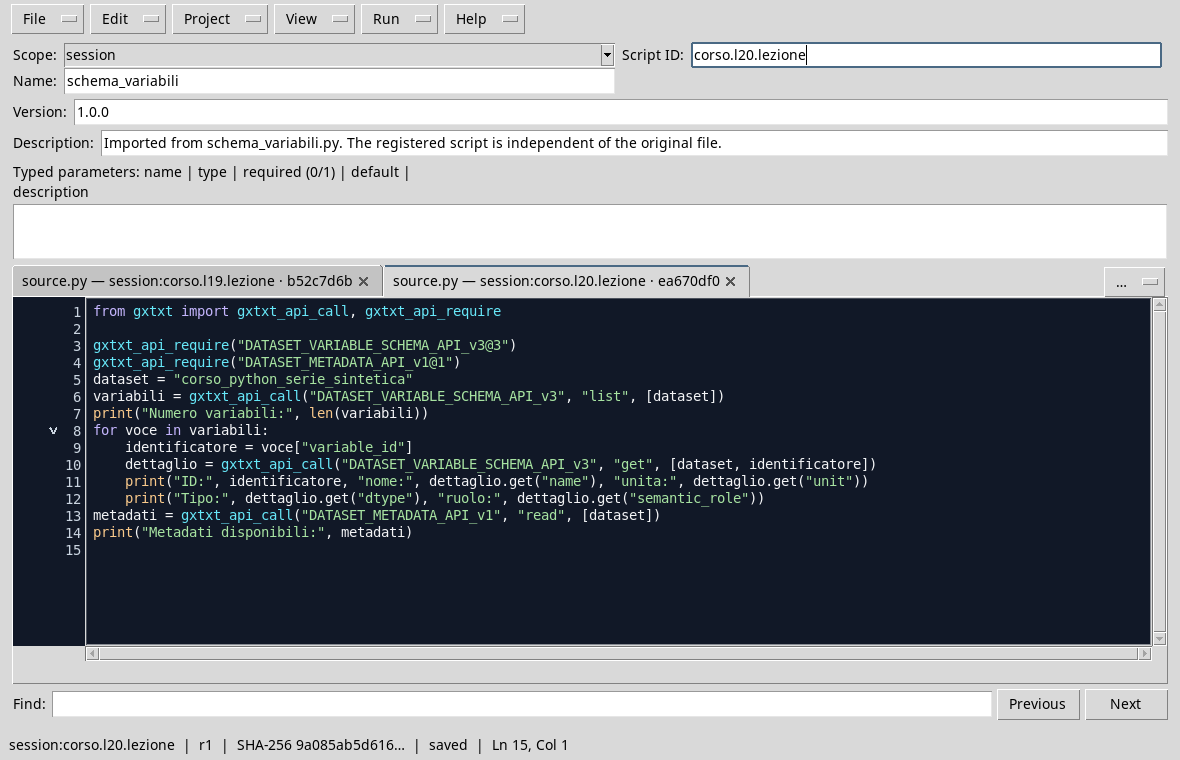
Lo script interroga l’elenco e i dettagli delle variabili con le API pubbliche.
Esecuzione
- Apri la Session che contiene
corso_python_serie_sinteticae il Viewer Python Scripts. - Importa
schema_variabili.py, assegna nome e Script ID nello scopesession, quindi salva. - Avvia il Runner e premi Run Job.
- Controlla l’output: nell’esempio sono presenti due variabili.
temporiporta unitàse ruolotime;segnaleriportamVe ruolovoltage. Il camponameinterrogato appare comeNonenella risposta mostrata.
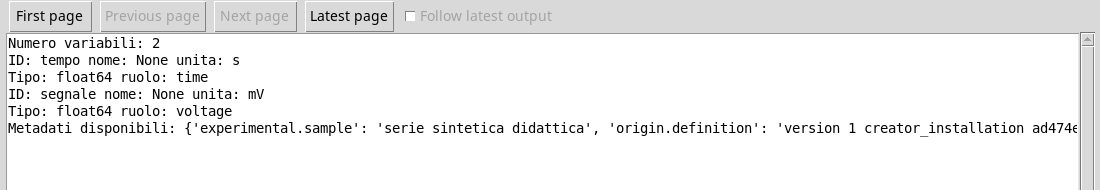
Gli ID, le unità e i ruoli sono letti dal Dataset; un campo non presente non viene inventato.
Errore comune
Vedere una colonna chiamata tempo e assumere che sia
sempre espressa in secondi può produrre conversioni sbagliate. Leggi
l’unità dichiarata e verifica che sia appropriata per l’analisi. Allo
stesso modo, float64 non indica la precisione sperimentale:
descrive la rappresentazione numerica, non l’incertezza della
misura.
Esercizio
Un descrittore contiene
{"variable_id": "temperatura", "unit": "K"} ma non contiene
la chiave dtype. Che cosa restituisce
descrittore.get("dtype")? È corretto concludere che il tipo
sia float64?
Soluzione ragionata
get restituisce None quando la chiave manca
e non è fornito un valore alternativo. Non è corretto inventare
float64: consulta lo schema e i dati disponibili o segnala
che l’informazione non è presente.
Nella prossima lezione leggeremo più variabili per blocchi mantenendone l’allineamento.