

Lettura progressiva e gestione delle righe
Corso Python scientifico in GX-TXT · Modulo 4 · Lezione 21
Quando un Dataset contiene più variabili correlate, leggere tutte le colonne necessarie nello stesso intervallo aiuta a conservarne l’allineamento. Questa lezione riprende la lettura per blocchi e la organizza in una funzione riutilizzabile.
Obiettivi: leggere due variabili per intervalli; controllare le lunghezze; ricomporre i blocchi nell’ordine corretto; verificare le coppie iniziale e finale e una proprietà numerica.
Prerequisiti: funzioni, lettura per blocchi, array e schema Dataset delle lezioni 10–20.
Righe e variabili
Nel Dataset sintetico corso_python_serie_sintetica,
tempo è espresso in secondi e segnale in
millivolt. Le quattro coppie sono (0.0, 1.2),
(0.5, 1.5), (1.0, 1.3) e
(1.5, 1.6). Sono dati didattici inventati, non misure
sperimentali; non è assegnata un’incertezza.
Le due variabili condividono la relazione riga per riga: il primo
tempo appartiene al primo segnale e così via. Se leggiamo intervalli
diversi per le due variabili, possiamo ottenere array della stessa
lunghezza ma con coppie sbagliate. Chiedere entrambi gli ID nella stessa
chiamata a read_range rende esplicito l’intervallo
comune.
Funzione per un blocco
La funzione leggi_blocco(dataset, inizio, quanti) riceve
l’ID del Dataset, una posizione iniziale da zero e il numero di righe.
Usa CANONICAL_DATASET_API_v2/read_range con gli ID
tempo e segnale, converte i valori in array
NumPy e restituisce la coppia di array.
Nel formato osservato, ciascuna variabile arriva come colonna.
reshape(-1) produce un vettore monodimensionale: qui è
appropriato perché sappiamo che ciascuna variabile è una singola
colonna. Per dati con più dimensioni non appiattire senza verificare il
significato degli assi.
La funzione confronta le lunghezze e solleva ValueError
se sono diverse. Questo controllo è utile ma non sufficiente a garantire
l’allineamento scientifico: occorre anche che i valori provengano dallo
stesso intervallo e da variabili realmente correlate.
Ricomporre senza salti
Leggiamo due righe a partire da 0 e due a partire da 2. I blocchi
coprono rispettivamente indici 0–1 e 2–3.
np.concatenate((prima_t, ultima_t)) unisce i blocchi
temporali nello stesso ordine; facciamo lo stesso per i segnali. Il
risultato contiene quattro righe, con prima coppia
(0.0 s, 1.2 mV) e ultima (1.5 s, 1.6 mV).
La media dei quattro segnali è
(1.2 + 1.5 + 1.3 + 1.6) / 4 = 1.4 mV, coerente con la
lezione 17. Questa media verifica un semplice riassunto, ma da sola non
prova che l’ordine delle righe sia corretto: controlliamo anche le
coppie agli estremi e, quando necessario, ogni riga.
Codice completo
import numpy as np
from gxtxt import gxtxt_api_call, gxtxt_api_require

def leggi_blocco(dataset, inizio, quanti):
    risposta = gxtxt_api_call("CANONICAL_DATASET_API_v2", "read_range", [dataset, ["tempo", "segnale"], inizio, quanti])
    tempo = np.asarray(risposta["tempo"]["values"]).reshape(-1)
    segnale = np.asarray(risposta["segnale"]["values"]).reshape(-1)
    if len(tempo) != len(segnale):
        raise ValueError("Le variabili hanno lunghezze diverse")
    return tempo, segnale

gxtxt_api_require("CANONICAL_DATASET_API_v2@2")
dataset = "corso_python_serie_sintetica"
prima_t, prima_y = leggi_blocco(dataset, 0, 2)
ultima_t, ultima_y = leggi_blocco(dataset, 2, 2)
tempi = np.concatenate((prima_t, ultima_t))
segnali = np.concatenate((prima_y, ultima_y))
print("Tempo (s):", tempi)
print("Segnale (mV):", segnali)
print("Righe:", len(tempi), "prima coppia:", tempi[0], segnali[0])
print("Ultima coppia:", tempi[-1], segnali[-1])
print("Media segnale (mV):", np.mean(segnali))
return tempo, segnale restituisce una tupla;
l’assegnazione prima_t, prima_y = ... separa i due valori
tramite unpacking. L’esempio presuppone esattamente quattro righe
disponibili. Per un Dataset generico consulta describe,
gestisci eventuali intervalli più brevi e il caso vuoto prima di
accedere a [0] o [-1].
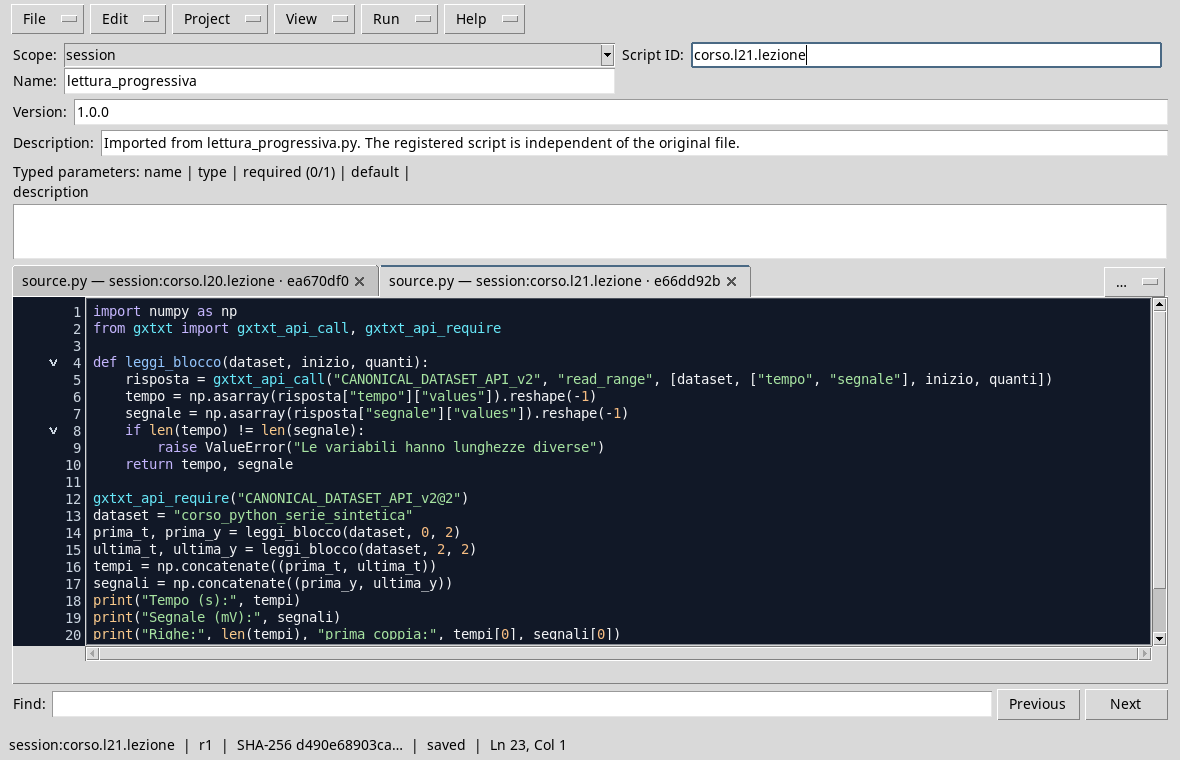
La funzione chiede le due variabili per lo stesso intervallo.
Esecuzione e controllo
- Apri la Session che contiene il Dataset della lezione 9 e il Viewer Python Scripts.
- Importa
lettura_progressiva.py, assegna nome e Script ID nello scopesession, quindi salva. - Apri il Runner, premi Run Job e osserva l’output.
- Confronta i quattro tempi e segnali con la serie originale.
Controlla gli estremi e la media
1.4 mV.
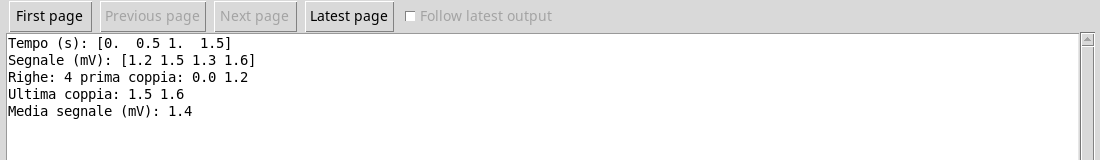
I due blocchi ricompongono quattro coppie nell’ordine atteso.
Memoria e numero di chiamate
Richiedere più variabili correlate in una chiamata può ridurre il numero di richieste al bridge. Blocchi troppo piccoli aumentano l’overhead; blocchi troppo grandi richiedono più memoria. La dimensione appropriata dipende dal Dataset e dall’ambiente.
Questo esempio concatena tutti i dati, quindi la memoria complessiva cresce con la serie. Per Dataset grandi, se il calcolo lo consente, elabora ogni blocco e conserva soltanto gli accumulatori necessari. Valuta separatamente dati mancanti, unità e precisione numerica.
Errore comune
Due blocchi che iniziano a 0 e 1 con dimensione 2 coprono 0–1 e 1–2: la riga 1 è duplicata e la riga 3 manca. La somma delle dimensioni richieste è quattro, ma non dimostra che siano state lette quattro righe distinte. Controlla intervalli, contiguità e valori agli estremi.
Esercizio
Per cinque righe, scegli due blocchi contigui senza sovrapposizioni:
il primo di tre righe, il secondo con le rimanenti. Quali argomenti
inizio e quanti usi?
Soluzione ragionata
Il primo blocco è (inizio=0, quanti=3) e copre 0–2. Il
secondo è (inizio=3, quanti=2) e copre 3–4. Prima di
chiamare l’API verifica che il Dataset contenga davvero cinque righe e
che gli ID richiesti siano corretti.
Nella prossima lezione affronteremo Dataset multidimensionali e sottoinsiemi hyperslab.