

Regressione lineare e minimi quadrati
Corso Python scientifico in GX-TXT · Modulo 5 · Lezione 27
Una retta può riassumere una relazione approssimata tra due grandezze. In questa lezione stimiamo intercetta e pendenza con l’API numerica di GX-TXT e studiamo ciò che resta fuori dal modello: i residui. Tutti i dati sono sintetici e adimensionali.
Obiettivi
- Scrivere il modello \(y=a+bx\).
- Comprendere il criterio dei minimi quadrati e la matrice di progetto.
- Distinguere i valori previsti, i residui e le osservazioni.
- Valutare forma, rango e condizionamento prima di interpretare un fit.
Il problema
Creiamo cinque ascisse da 0 a 4 e una serie secondo
\(y=1+2x+\varepsilon\). Il rumore è una sequenza scelta
appositamente, [0.1, -0.1, 0, -0.1, 0.1]: non rappresenta
un esperimento né una distribuzione statistica misurata. I valori
risultanti sono [1.1, 2.9, 5.0, 6.9, 9.1].
La regressione lineare ordinaria sceglie i parametri che minimizzano
la somma dei quadrati dei residui, cioè delle differenze
osservato - previsto. Elevare al quadrato rende positivi i
contributi e attribuisce più peso alle differenze grandi. Per questi
dati particolari, il rumore è stato scelto in modo che la retta ottimale
abbia intercetta 1 e pendenza 2, a parte piccoli effetti della virgola
mobile.
Esecuzione
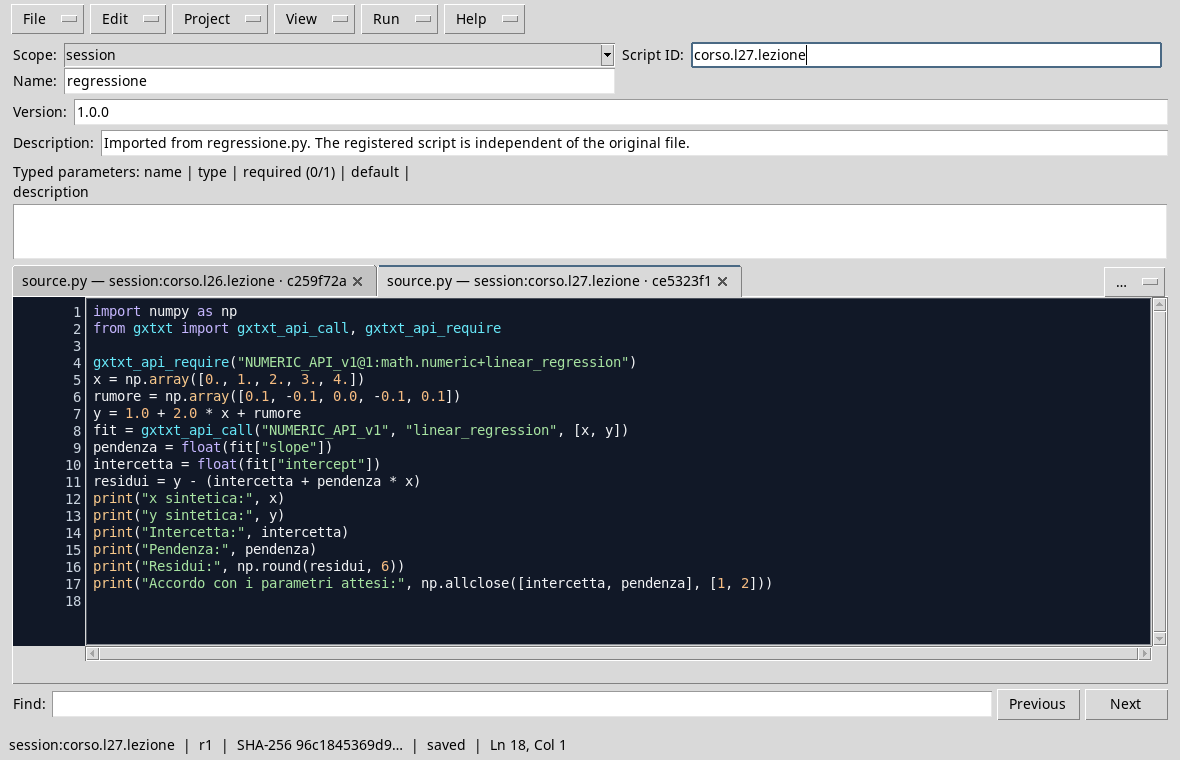
Nella Sessione corso_python, importa regressione.py, salva lo script nel
Python Script Workspace e avvialo da Run → Open Script Runner →
Run Job.
import numpy as np
from gxtxt import gxtxt_api_call, gxtxt_api_require

gxtxt_api_require("NUMERIC_API_v1@1:math.numeric+linear_regression")
x = np.array([0., 1., 2., 3., 4.])
rumore = np.array([0.1, -0.1, 0.0, -0.1, 0.1])
y = 1.0 + 2.0 * x + rumore
fit = gxtxt_api_call("NUMERIC_API_v1", "linear_regression", [x, y])
pendenza = float(fit["slope"])
intercetta = float(fit["intercept"])
residui = y - (intercetta + pendenza * x)
print("x sintetica:", x)
print("y sintetica:", y)
print("Intercetta:", intercetta)
print("Pendenza:", pendenza)
print("Residui:", np.round(residui, 6))
print("Accordo con i parametri attesi:", np.allclose([intercetta, pendenza], [1, 2]))
La richiesta preventiva individua la capacità di regressione. La
chiamata linear_regression riceve x e
y; per impostazione predefinita include l’intercetta e usa
minimi quadrati ordinari senza pesi. La risposta espone
slope e intercept. Lo script calcola le
previsioni con quei parametri e sottrae ciascuna previsione dal
corrispondente valore sintetico.
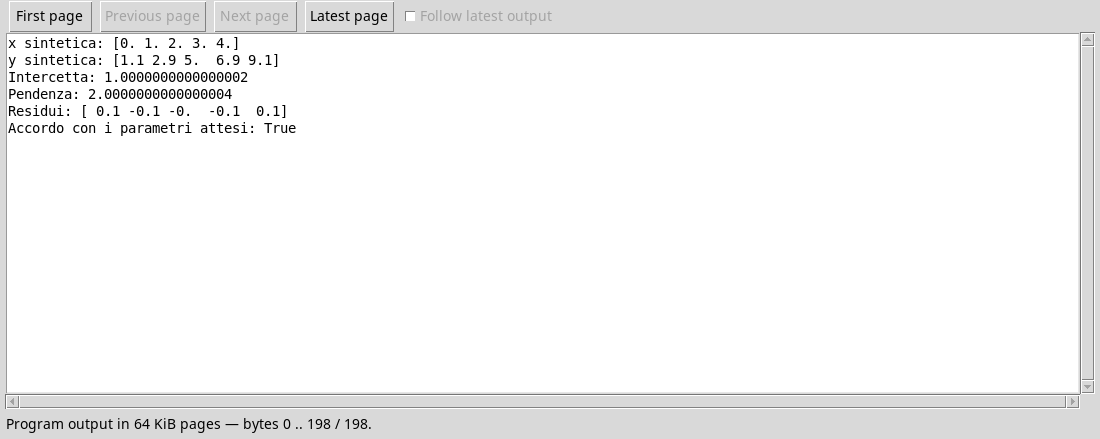
L’output riporta valori molto vicini a 1 e 2. Le piccole cifre
aggiuntive sono normali effetti dei calcoli in virgola mobile;
np.allclose usa una tolleranza. I residui coincidono con il
rumore inserito, a precisione numerica, perché questo esempio è stato
progettato appositamente. Con dati diversi, i parametri stimati non
coincidono necessariamente con quelli usati per generare i dati.
Matrice di progetto e condizioni del problema
Il modello può essere scritto come prodotto fra una matrice di
progetto e il vettore dei parametri. Qui ogni riga della matrice è
[1, x_i], mentre il vettore contiene
[intercetta, pendenza]. La prima colonna rappresenta il
termine costante; la seconda associa ogni valore di x alla
pendenza. Cinque osservazioni per due parametri rendono il problema
sovradeterminato: in generale non esiste una retta che passi esattamente
per tutti i punti.
Non basta avere più righe che colonne. Se tutte le x
fossero identiche, le due colonne non sarebbero indipendenti e la
pendenza non sarebbe identificabile in modo univoco. Anche quando il
rango è completo, colonne con scale molto diverse possono rendere il
problema mal condizionato: piccoli cambiamenti nei dati possono produrre
grandi variazioni dei parametri. Controlla rango, numero di
condizionamento e scala delle variabili; valuta una centratura o un
cambio di scala coerente con il problema. L’API
least_squares consente una matrice di progetto esplicita e
fornisce diagnostiche, ma richiede di rispettare il suo contratto.
Se x e y avessero unità fisiche,
l’intercetta avrebbe l’unità di y e la pendenza quella di
y divisa per quella di x. La bontà di una
retta non prova una relazione causale: servono un disegno sperimentale e
ipotesi adeguate. Anche pesi, incertezze e correlazioni richiedono un
modello appropriato; questo esempio è una regressione ordinaria non
pesata.
Esercizio
- Per \(x=3\), quale valore prevede la retta stimata e quale residuo risulta dal dato sintetico?
- Quante colonne ha la matrice di progetto per una retta con intercetta? Scrivi la riga corrispondente a \(x=3\).
- Perché cinque osservazioni con lo stesso valore di
xnon bastano a identificare separatamente intercetta e pendenza?
Soluzione ragionata
- La previsione è \(1+2\cdot3=7\); il dato è
6,9, quindi il residuo osservato meno previsto è-0,1. - Due colonne; la riga è
[1, 3]. - Le colonne della matrice di progetto sono proporzionali. Molte coppie di parametri producono lo stesso valore previsto in quell’unica ascissa; il rango non è sufficiente.
Nella prossima lezione passeremo a modelli non lineari e funzioni Python utilizzate come callback.