

Generazione del Dataset e pubblicazione nativa
Corso Python scientifico in GX-TXT · Modulo 10 · Lezione 56
Generiamo le due serie previste dal protocollo e le pubblichiamo nella Sessione con segnale ideale, segnale sintetico rumoroso e incertezza standard esplicita.
Obiettivi
- Usare
numpy.random.Generatorcon seed dichiarato. - Separare curva ideale e rumore sintetico.
- Pubblicare variabili e unità con il writer canonico.
- Rileggere i Dataset e associarvi note di provenienza.
Esecuzione
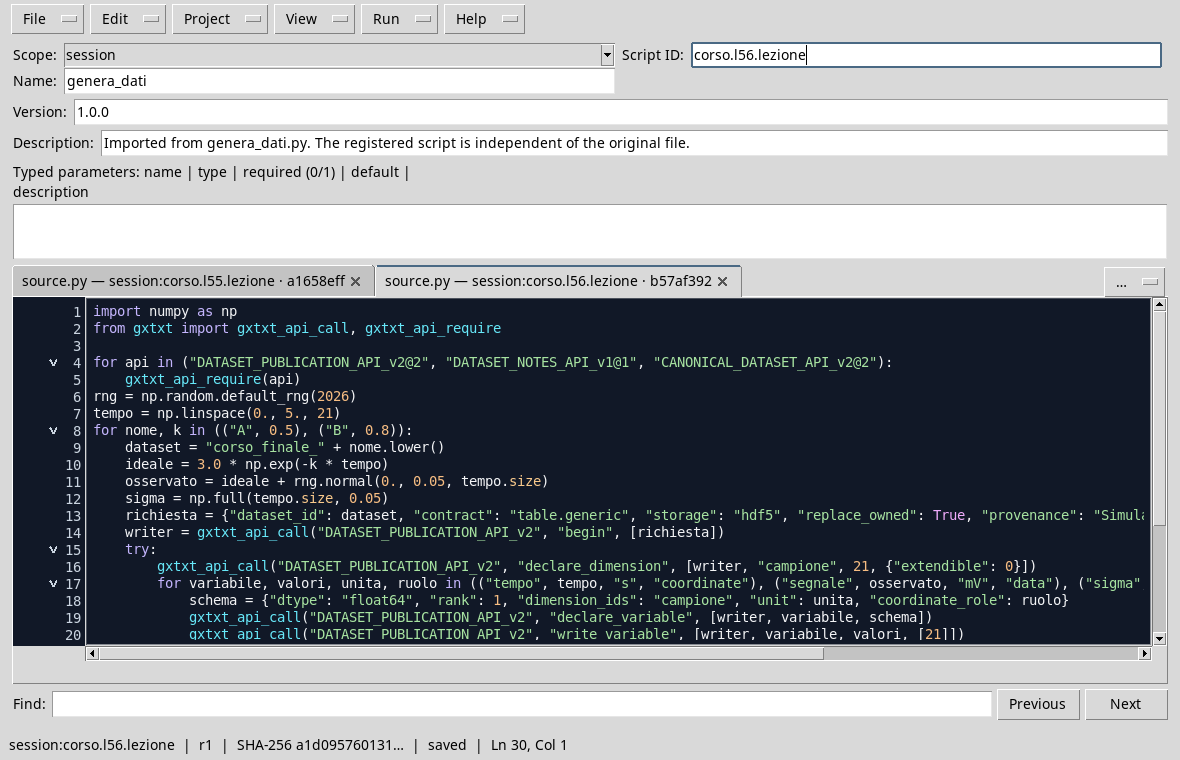
Importa genera_dati.py nella
Sessione corso_python, salvalo ed eseguilo nel Runner. Lo
script pubblica corso_finale_a e
corso_finale_b; replace_owned si applica solo
agli output che lo script è autorizzato a sostituire.
import numpy as np
from gxtxt import gxtxt_api_call, gxtxt_api_require

for api in ("DATASET_PUBLICATION_API_v2@2", "DATASET_NOTES_API_v1@1", "CANONICAL_DATASET_API_v2@2"):
    gxtxt_api_require(api)
rng = np.random.default_rng(2026)
tempo = np.linspace(0., 5., 21)
for nome, k in (("A", 0.5), ("B", 0.8)):
    dataset = "corso_finale_" + nome.lower()
    ideale = 3.0 * np.exp(-k * tempo)
    osservato = ideale + rng.normal(0., 0.05, tempo.size)
    sigma = np.full(tempo.size, 0.05)
    richiesta = {"dataset_id": dataset, "contract": "table.generic", "storage": "hdf5", "replace_owned": True, "provenance": "Simulazione sintetica: seed 2026"}
    writer = gxtxt_api_call("DATASET_PUBLICATION_API_v2", "begin", [richiesta])
    try:
        gxtxt_api_call("DATASET_PUBLICATION_API_v2", "declare_dimension", [writer, "campione", 21, {"extendible": 0}])
        for variabile, valori, unita, ruolo in (("tempo", tempo, "s", "coordinate"), ("segnale", osservato, "mV", "data"), ("sigma", sigma, "mV", "data"), ("ideale", ideale, "mV", "data")):
            schema = {"dtype": "float64", "rank": 1, "dimension_ids": "campione", "unit": unita, "coordinate_role": ruolo}
            gxtxt_api_call("DATASET_PUBLICATION_API_v2", "declare_variable", [writer, variabile, schema])
            gxtxt_api_call("DATASET_PUBLICATION_API_v2", "write_variable", [writer, variabile, valori, [21]])
        gxtxt_api_call("DATASET_PUBLICATION_API_v2", "finalize", [writer])
    except Exception:
        gxtxt_api_call("DATASET_PUBLICATION_API_v2", "abort", [writer])
        raise
    nota = f"# Studio sintetico {nome}\n\nNon sono misure. A=3 mV; k={k} s^-1; sigma=0.05 mV; seed=2026.\n"
    gxtxt_api_call("DATASET_NOTES_API_v1", "write", [dataset, nota])
    lettura = gxtxt_api_call("CANONICAL_DATASET_API_v2", "read_range", [dataset, ["tempo", "segnale", "sigma", "ideale"], 0, 21])
    print(dataset, "righe:", len(lettura["tempo"]["values"]), "sigma (mV):", sigma[0])
print("Generazione completata: dati sintetici, non misure")
Per ogni condizione, il generatore costruisce l’ideale
3 exp(-k t) e aggiunge rumore normale con deviazione
standard 0,05 mV. La variabile sigma conserva
tale valore per ogni riga; ideale resta separata dal
segnale rumoroso. Il writer dichiara una dimensione di 21
campioni e quattro variabili con unità; finalize pubblica
il Dataset completo, mentre abort gestisce un’eccezione
prima della finalizzazione.
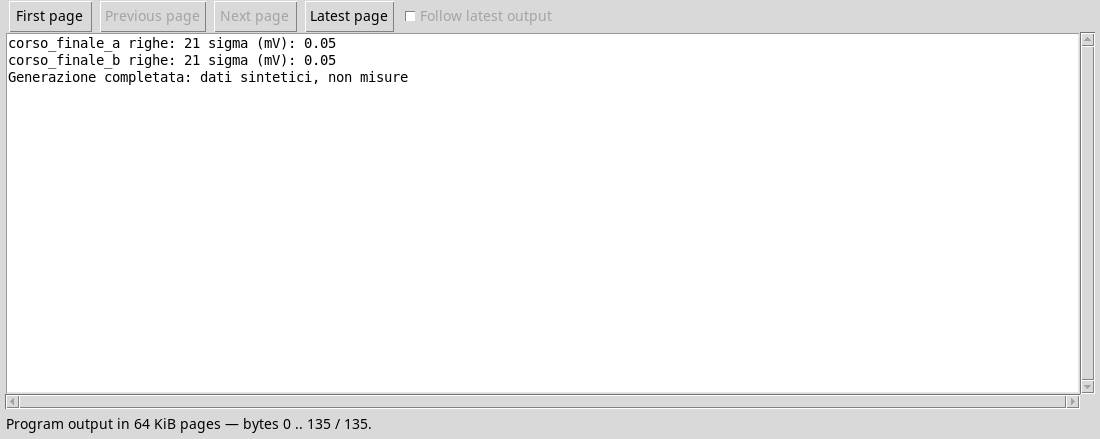
La nota associata a ciascun Dataset registra modello, parametri, seed e natura sintetica. L’output conferma la lettura di 21 righe per entrambe le condizioni. Il seed e l’ordine delle chiamate al generatore sono parte della procedura riproducibile; cambiare l’ordine cambia la sequenza assegnata alle condizioni.
Esercizio
- Quali variabili contengono il segnale ideale e quello rumoroso?
- Qual è l’unità di
sigma? - Perché la nota dice che i dati non sono misure?
Soluzione ragionata
idealeesegnale, rispettivamente.- mV, la stessa del segnale.
- Perché sono stati generati da un modello e da rumore pseudo-casuale, non acquisiti in laboratorio.