
GX-TXT: il tuo esperimento e il tuo progetto in un unico ambiente
Il problema: i dati sperimentali si perdono per strada
Chi fa misure in laboratorio conosce bene la scena. I dati grezzi stanno in una cartella, gli script in un’altra, i grafici sono esportati come immagini, il fit è stato fatto in un altro programma e gli appunti sono su un quaderno o in un file di testo. Ogni passaggio da uno strumento all’altro è un export e un import, e a ogni passaggio si perde qualcosa: le unità, il nome della variabile, il filtro applicato, il punto escluso, la versione dello script.
Dopo qualche mese, davanti a un grafico, la domanda “da quali dati viene esattamente questa curva?” spesso non ha più una risposta certa. GX-TXT nasce per rispondere a questa domanda in ogni momento.
Perché l’ho costruito
GX-TXT è nato dal mio lavoro sperimentale, non da un’idea a tavolino. All’inizio volevo una cosa semplice: rimettere in ordine i miei script, non perdere più i dati per strada e smettere di riscrivere ogni volta il codice per i grafici. Il primo nucleo è nato dalle prove su un telecomando a infrarossi: segnali da acquisire, analizzare e confrontare. Da lì il bisogno si è allargato a misure, fit, curve storiche da digitalizzare, geometrie da costruire sopra i dati.
Nessuno strumento che conoscevo teneva insieme tutto questo senza perdere il legame con il dato di partenza. Così ho cominciato a costruirne uno. Il primo utente sono io: ogni strumento che trovate dentro esiste perché mi serviva per lavorare.
Cos’è GX-TXT: tanti strumenti, un solo ambiente
GX-TXT è un ambiente integrato per gestire un esperimento e il progetto che lo contiene, dall’acquisizione dei dati fino ai risultati. Dentro ci sono strumenti che di solito vivono in programmi separati:
- un foglio di calcolo per i dati tabellari;
- editor scientifici di curve: il digitalizzatore, il Curve Workbench, l’Interactive Builder, il fitter;
- moduli di analisi — statistica, spettri, analisi delle repliche e molto altro — un centinaio nella versione attuale;
- script Python e GNU Octave, compatibile con la sintassi di MATLAB;
- grafici 2D e 3D interattivi e un editor 3D;
- acquisizione e importazione da strumenti, file, audio, immagini e documenti.
L’interfaccia è in Tcl/Tk, il calcolo passa da GNU Octave e Python, la geometria da motori nativi in C e C++. È software libero, sotto licenza GNU GPL 3 o successiva. La versione attuale è una beta: ne parlo più avanti.
Progetto ed esperimento: i dati restano insieme
Il punto su cui ho costruito tutto è l’organizzazione. In GX-TXT il lavoro ha tre livelli:
- Project: il contenitore che raccoglie esperimenti correlati, con nome, descrizione, tag e autore;
- Experiment: l’identità scientifica dello studio, con il suo quaderno — obiettivo, procedura, osservazioni, operatore, data, note;
- Session: il record operativo e riproducibile, che conserva configurazione, Dataset, file sorgente, note, script registrati, analisi, grafici e provenienza.
Il Project organizza senza duplicare: associare un esperimento a un progetto non copia né sposta i dati, e staccarlo non cancella niente. Una Session si può esportare in forma portabile e riaprire altrove con le sue identità intatte. I dettagli sono nella guida Projects, Experiments e Sessions.
Ogni dato è un Dataset canonico, organizzato in namespace, con variabili che hanno un identificativo stabile, un’unità e i loro metadati. Su ogni cosa — un dataset, una curva, un grafico — puoi mettere appunti e metadati. Quando uno strumento produce un risultato, il risultato è un nuovo Dataset che porta con sé da dove viene: sorgente, filtri, parametri.
Il dato originale non viene mai modificato, e da ogni risultato si risale a quello da cui è nato. Così, dopo mesi, riapri il progetto e trovi non solo i numeri, ma anche come ci sei arrivato.
Dietro ci sono pochi principi, che ricorrono in tutto il sistema:
- Dataset canonici: gli strumenti lavorano su identità registrate e metadati scientifici, non su file scelti caso per caso dal codice;
- API pubbliche: script e moduli accedono a Dataset, grafici, selezioni e persistenza attraverso contratti versionati;
- Session e provenance: configurazioni, sorgenti, script e risultati restano collegati al lavoro che li ha prodotti;
- Separazione fra calcolo e presentazione: i dati scientifici restano distinti da grafici e viewer;
- Estendibilità: Python, GNU Octave e moduli installabili permettono di passare dall’esplorazione alla distribuzione senza modificare il CORE.
Un esempio: da un vecchio datasheet a curve con le loro incertezze
Il 2D21 è un thyratron, e il suo datasheet originale è un PDF scansionato: le curve caratteristiche — corrente di griglia in funzione della tensione di griglia, per diverse correnti anodiche — esistono solo come disegno. Ecco come diventano dati con la loro incertezza, senza uscire da GX-TXT.
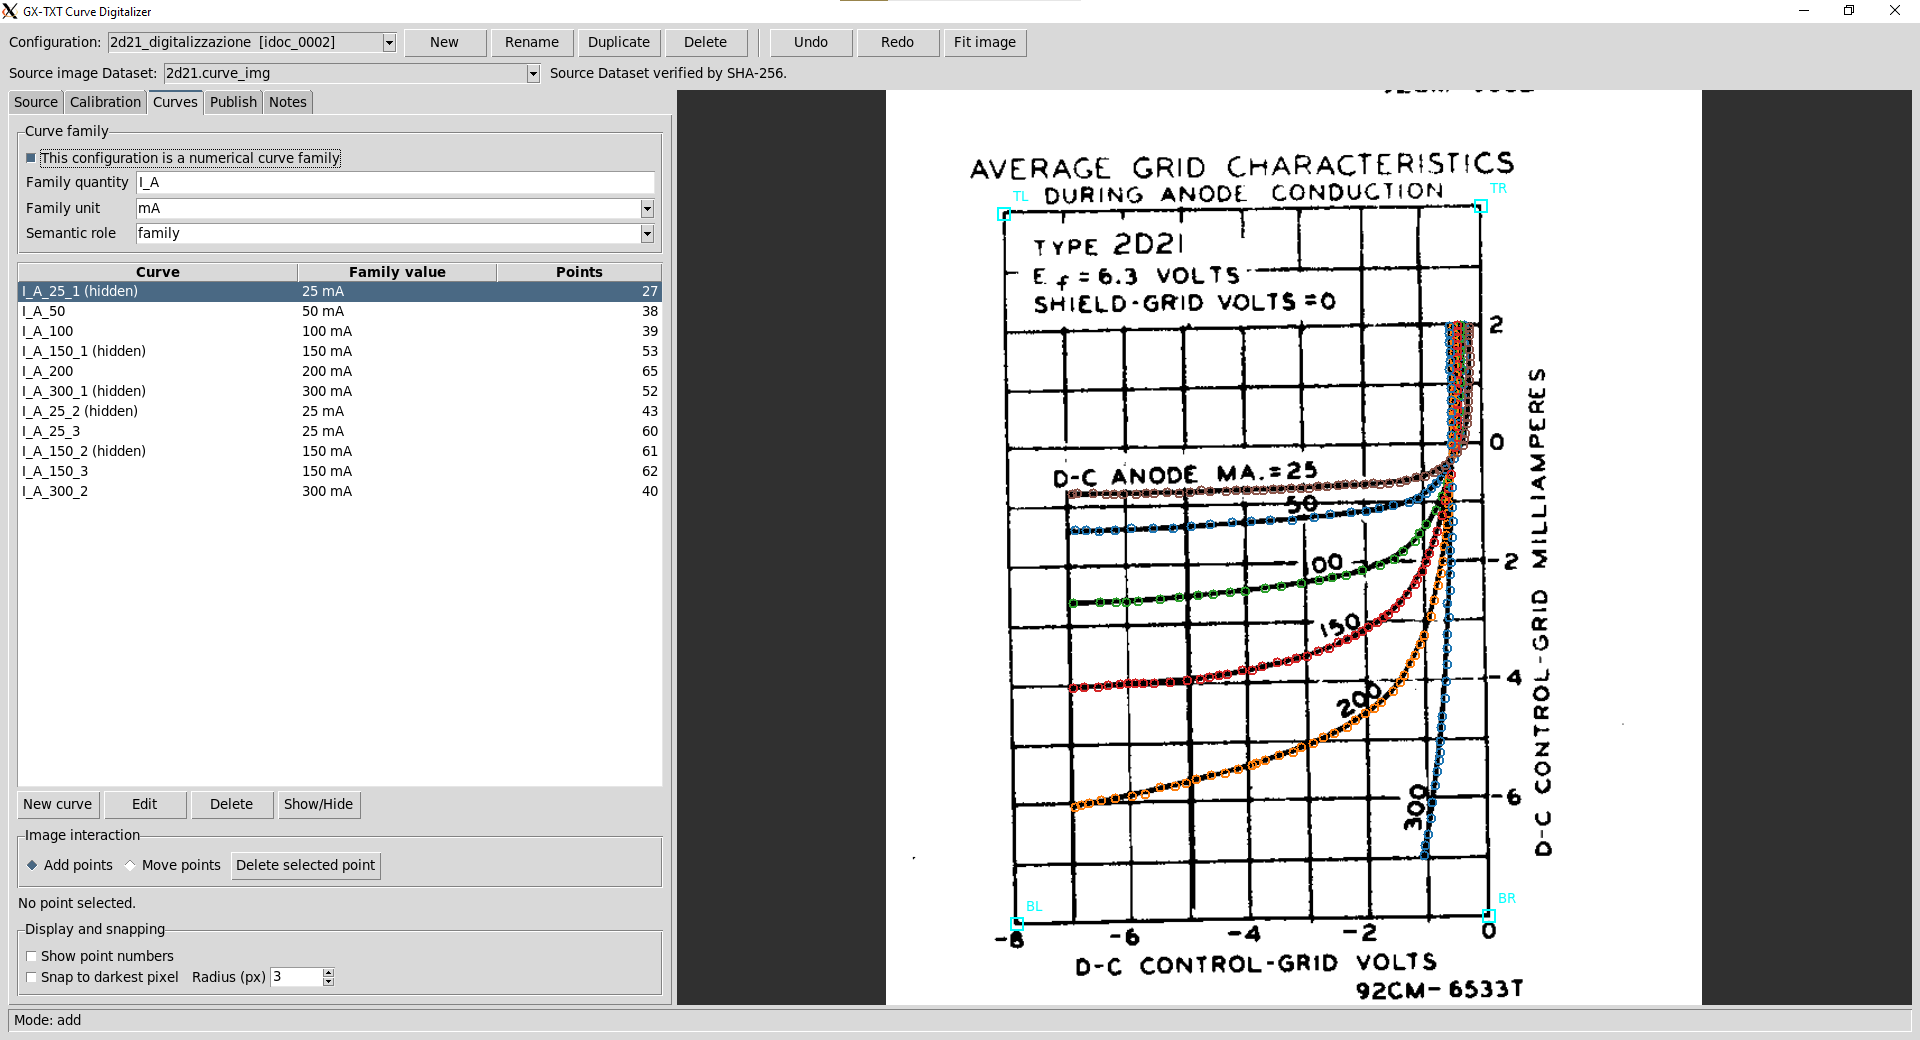
1. Digitalizzazione. L’immagine del datasheet entra nel progetto come Dataset, verificato con SHA-256. Nel Curve Digitizer calibro gli assi sui quattro angoli del grafico e definisco la famiglia di curve: la grandezza è la corrente anodica I_A, in mA, con una curva per ogni valore (25, 50, 100, 150, 200 e 300 mA). Alcune curve le ho digitalizzate più volte, apposta.
2. Analisi delle repliche. Le digitalizzazioni ripetute diventano Dataset distinti. Il modulo Replicate Curve Analysis le mette insieme e produce, per ogni curva della famiglia, una curva di consenso con la sua incertezza, separando le componenti dovute alla ripetizione nella stessa sorgente e alle differenze tra sorgenti.
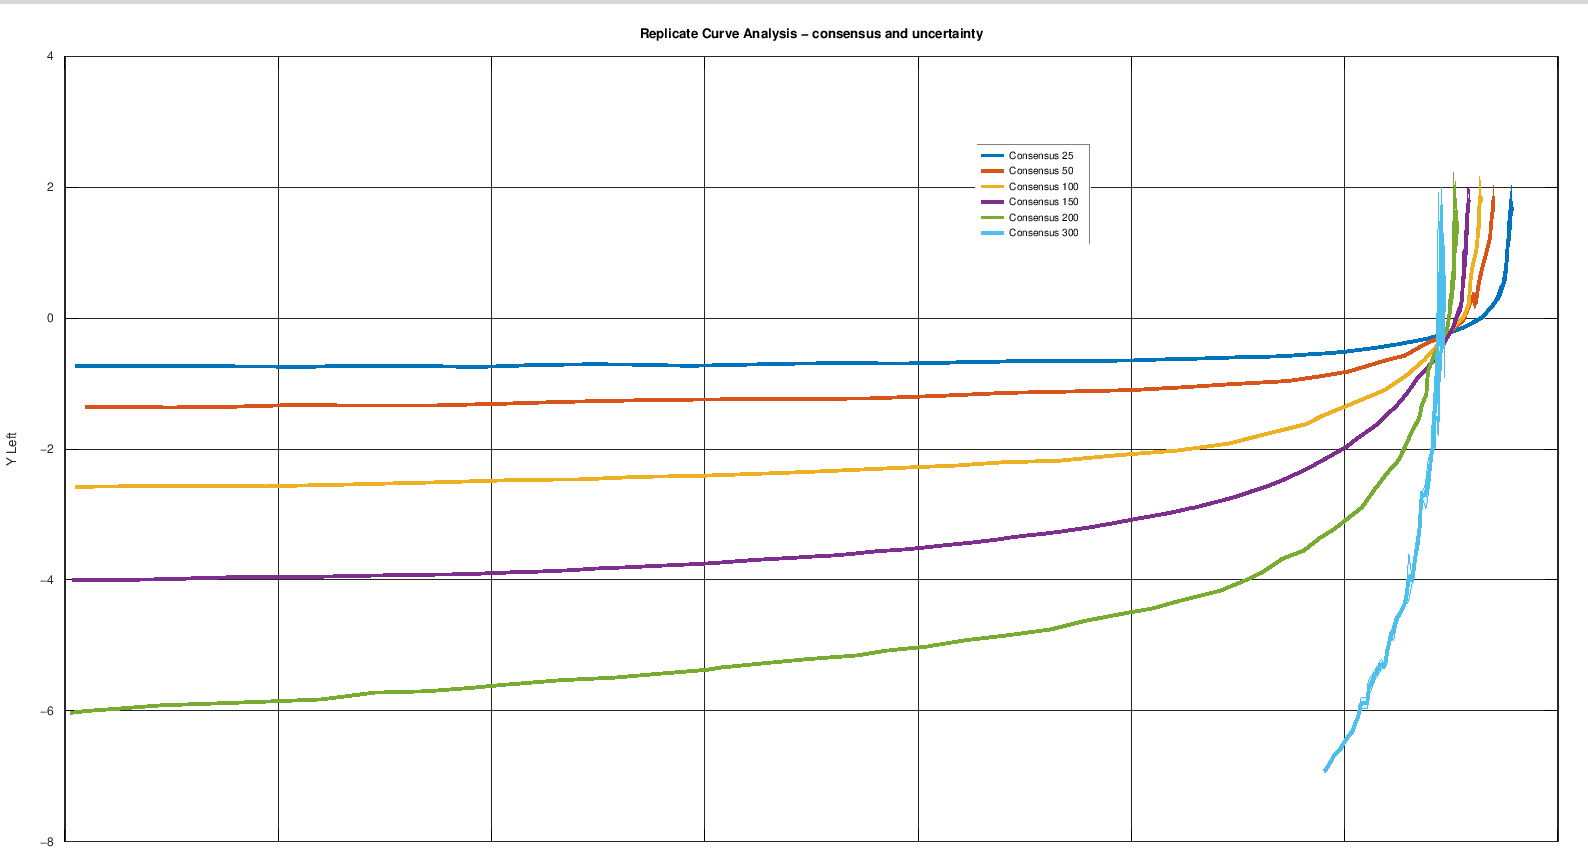
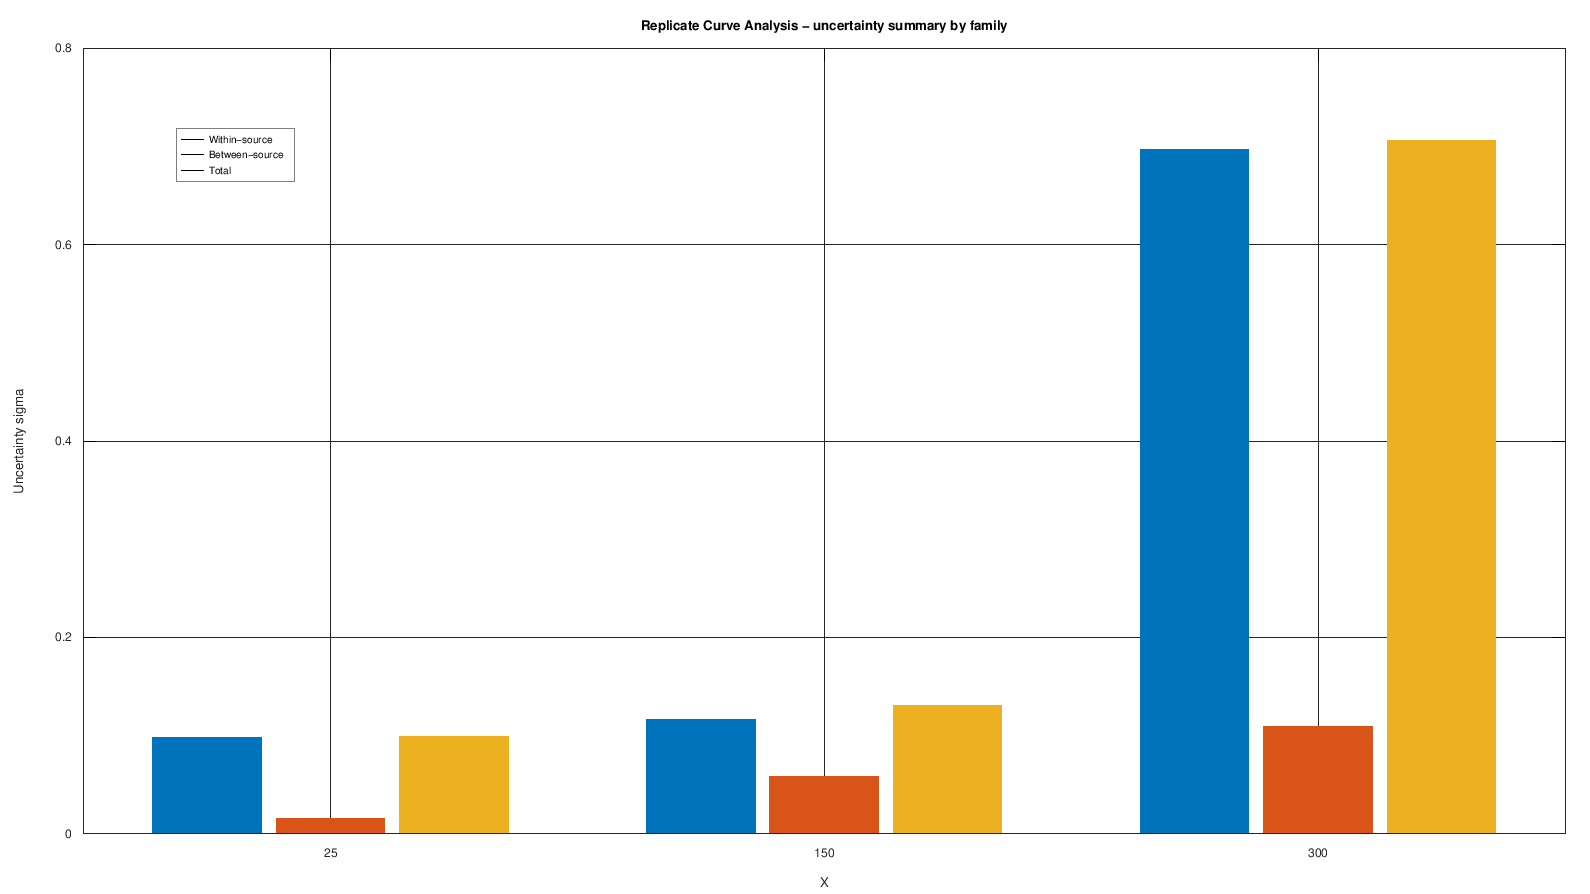
Il risultato mostra qualcosa che a occhio non si vede: l’incertezza è piccola nei tratti quasi orizzontali e cresce di colpo dove la curva diventa quasi verticale, perché lì un errore minimo sulla tensione letta sposta molto la corrente. Per la curva a 300 mA l’incertezza totale è circa sette volte quella della curva a 25 mA.
3. Fit. Le curve passano al fitter con la provenienza intatta: ogni parametro resta riconducibile al datasheet di partenza, alla calibrazione e alle repliche usate. Ogni passaggio produce un Dataset con i suoi metadati e i suoi appunti, nello stesso progetto.
Dalla misura al modello: Dataset Curve Fit
Il fitter lavora direttamente su un Dataset: scegli il dataset, le variabili X e Y, eventuali filtri (anche con espressioni, utili quando si lavora su famiglie di curve), poi il modello. Il flusso è sempre lo stesso: anteprima del fit, controllo, e solo alla fine Accept, che pubblica il risultato come nuova curva con la sua provenienza.
I modelli disponibili oggi vanno dal lineare e polinomiale all’esponenziale, alla legge di potenza e alla gaussiana, fino a spline di smoothing, PCHIP, serie di Fourier, archi, curve di Bézier e modelli parametrici. L’orientamento si può scegliere (Y = f(X), X = f(Y), parametrico, polare), così anche le curve che non sono funzioni si possono trattare correttamente.
Sotto il grafico ci sono i residui, punto per punto, nelle unità originali. È la parte che preferisco: è il fit stesso a dirti dove il modello non funziona.
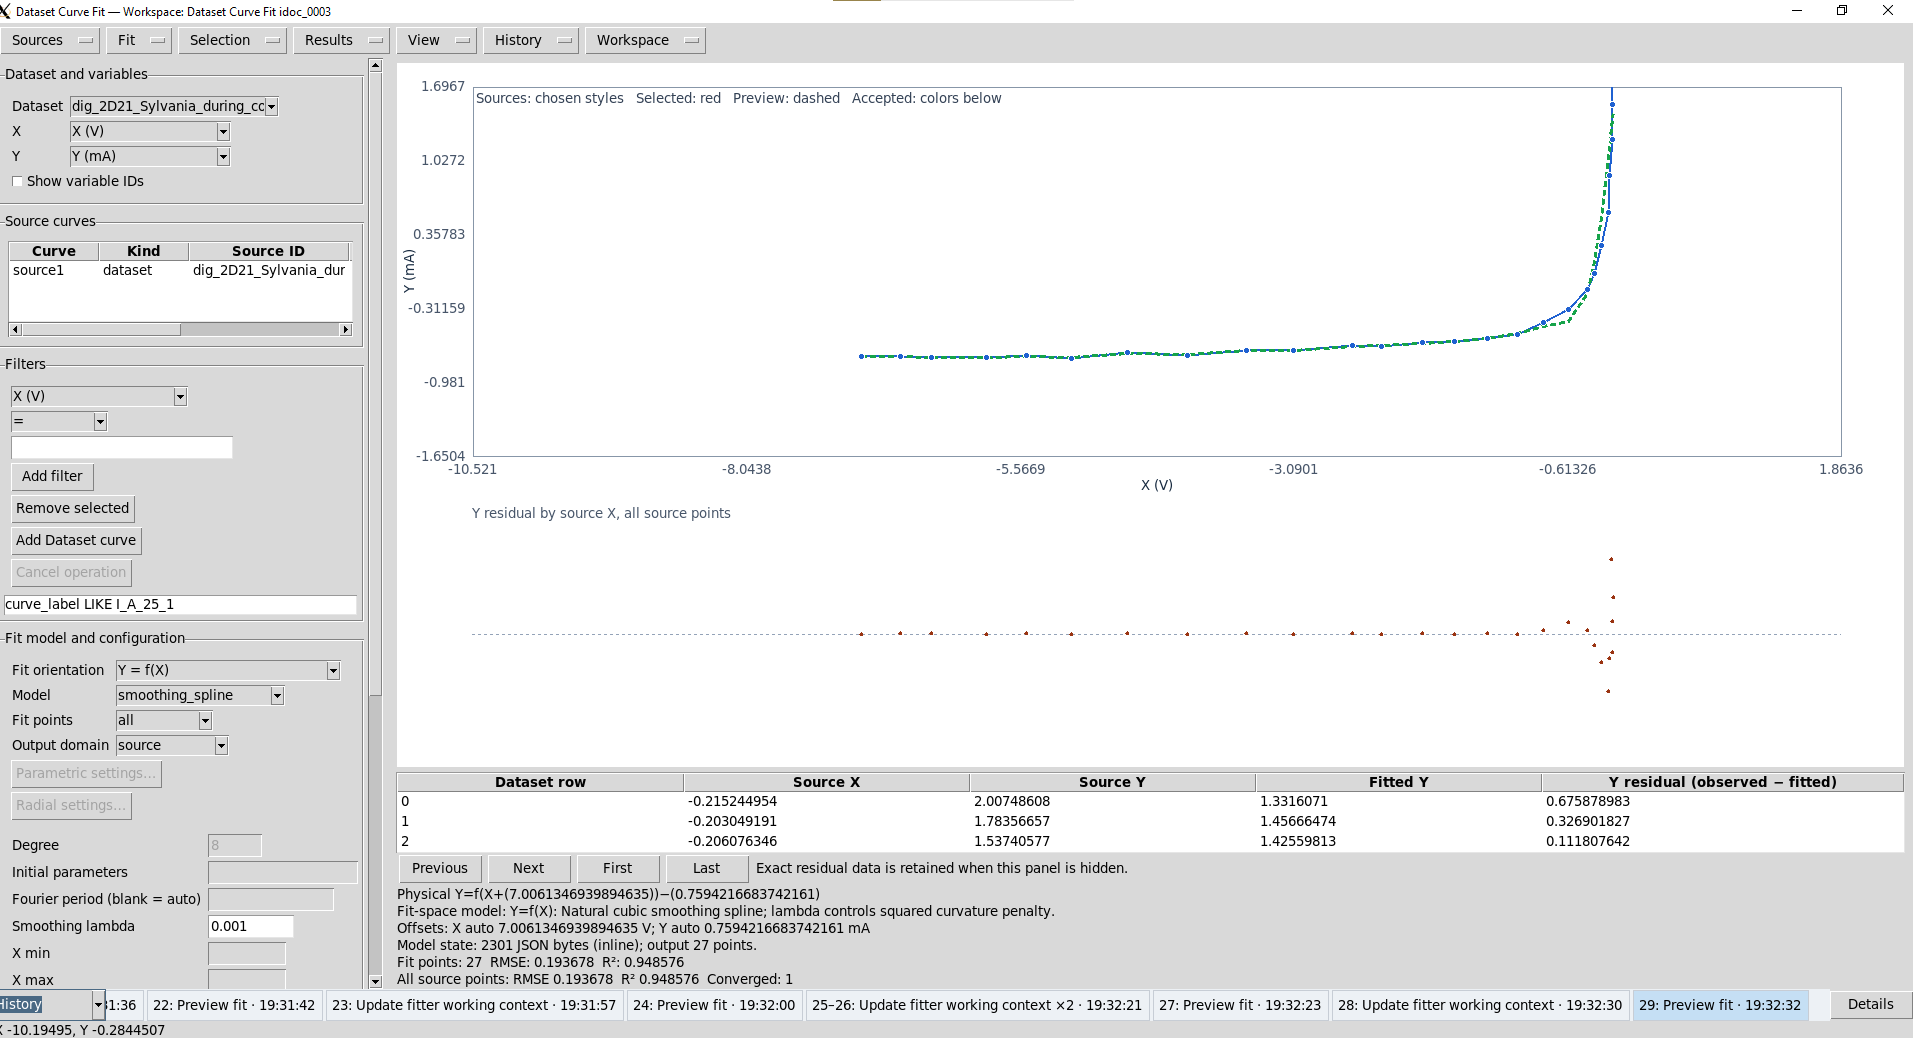
Il fitter è la parte su cui sto lavorando di più in questo momento. Essendo una beta, molte cose arriveranno con le prossime versioni: più modelli, statistiche complete e incertezze sui parametri, un’interfaccia più rifinita.
Curve Workbench: dati sperimentali e geometria insieme
Il Curve Workbench è un banco di lavoro per curve. Non è un CAD, anche se ha molto di quello che ci si aspetta da un CAD 2D: linee, archi, cerchi, spline, Bézier, vincoli, quote, snap, modifica numerica dei punti di controllo. La differenza è lo scopo: qui la geometria convive con i dati sperimentali, e i due restano sempre distinti. Essendo uno strumento geometrico, con rotazioni, simmetrie e distanze, dà il meglio quando X e Y hanno la stessa unità: profili, contorni, sezioni, percorsi. Per curve che legano grandezze diverse, come una tensione e una corrente, gli strumenti giusti sono il fitter e l’Interactive Builder.
Una curva che viene da un Dataset mantiene i suoi punti esatti e la sua provenienza. Sopra puoi disegnare le tue costruzioni: tangenti, rette di riferimento, approssimazioni. E puoi chiedere allo strumento quanto la tua costruzione si allontana dal dato misurato, con Compare / residuals. I metodi grafici classici fatti a occhio diventano così metodi grafici con l’errore misurato.
Un dataset si può convertire in geometria e una geometria in dataset. Ogni conversione crea un oggetto nuovo: il dato originale resta lì, e quello derivato resta riconoscibile come tale.
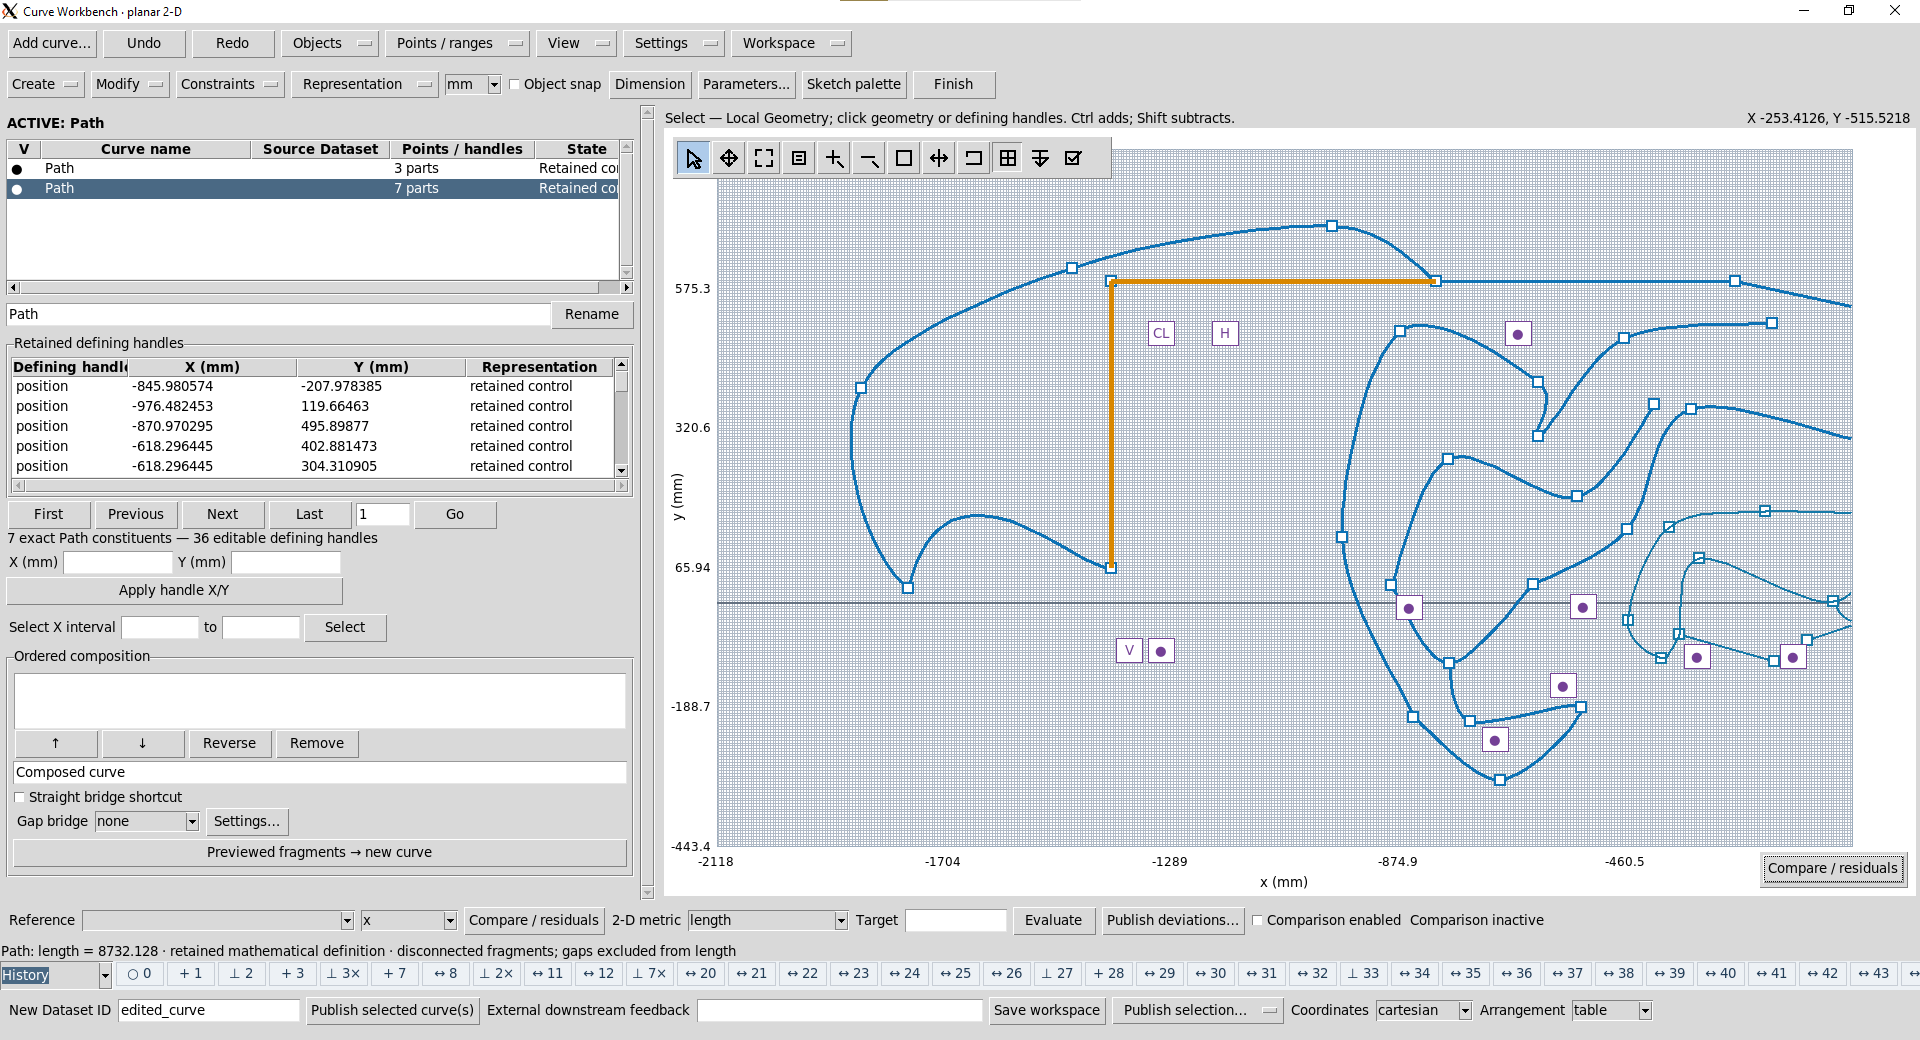
Grafici 3D interattivi e geometria nativa
I grafici 3D dei Dataset sono interattivi davvero: si aprono in una finestra separata, si ruotano, si spostano, si ingrandiscono. Nella demo geospaziale, per esempio, la quota del terreno della valle del Ticino fa da superficie e la densità di popolazione ISTAT 2021 da colore. Anche l’immagine ad alta risoluzione che ne ricavi si salva come Dataset, con la sua provenienza.
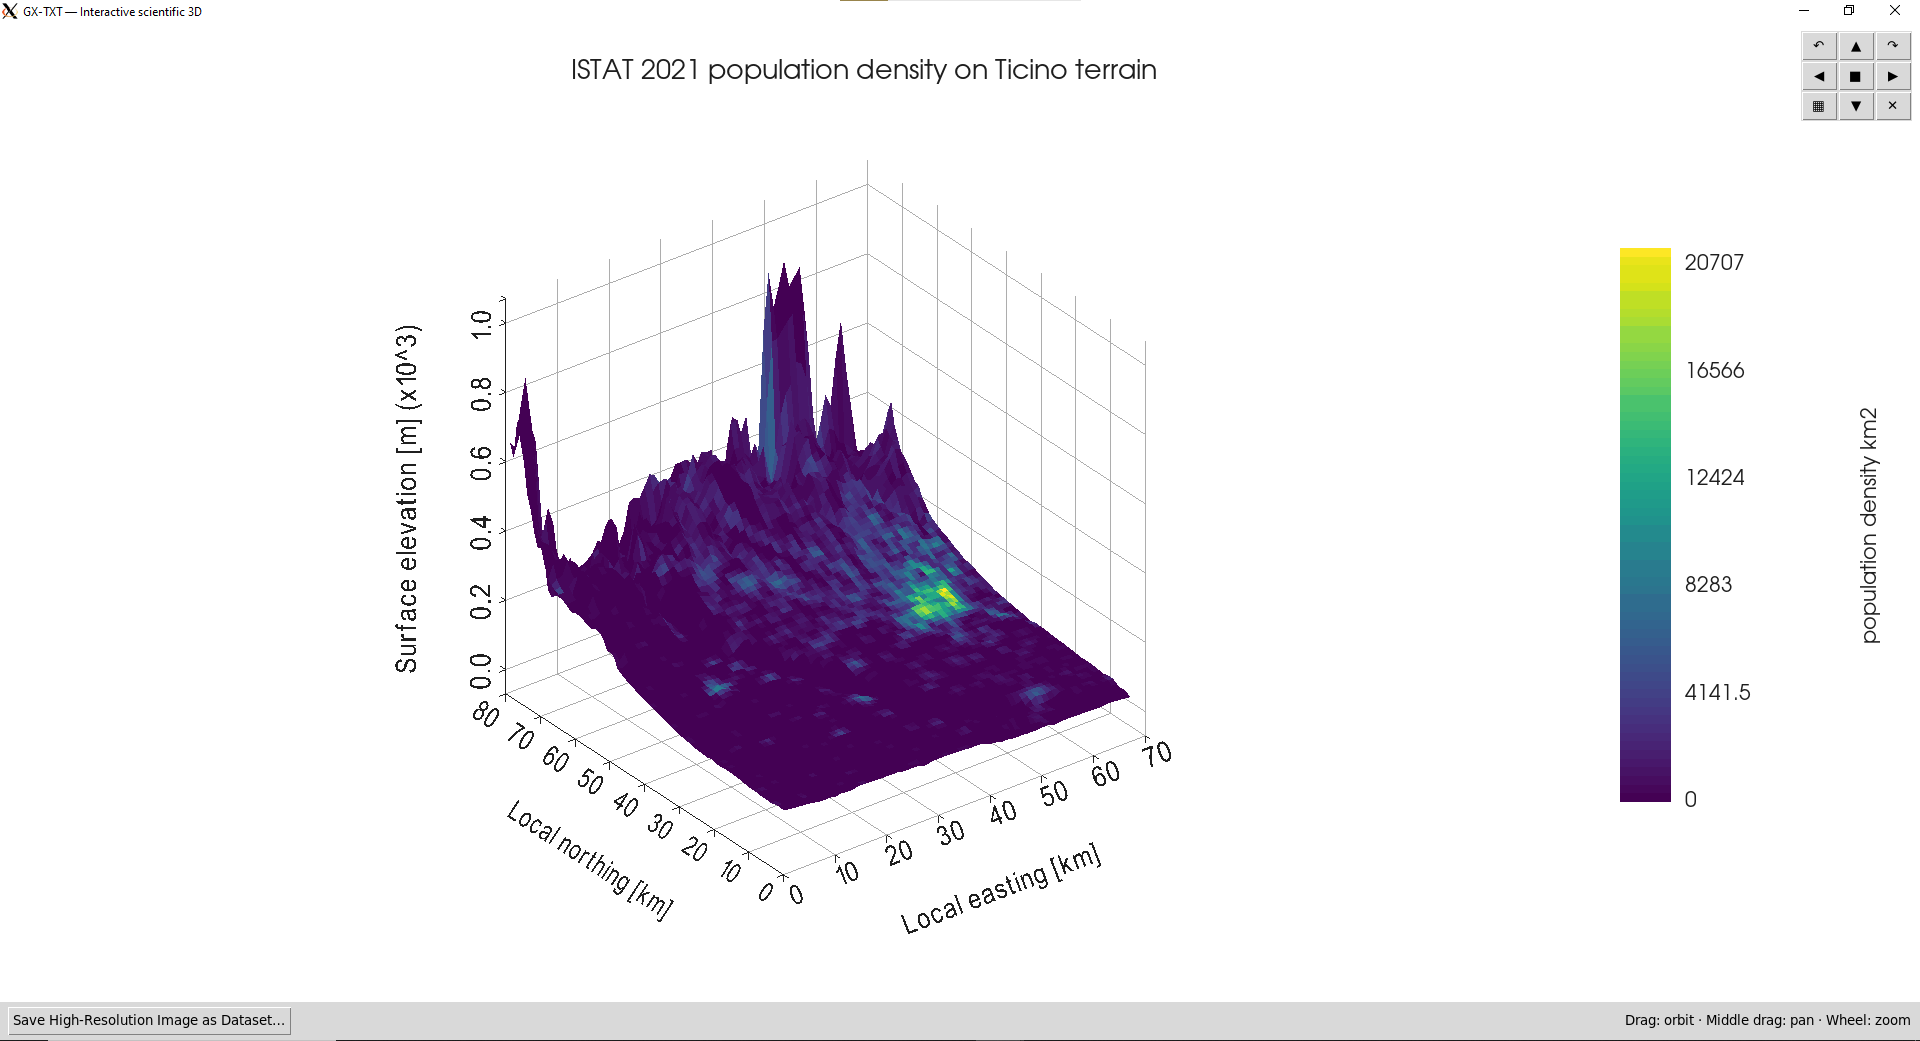
Sotto ci sono due motori geometrici nativi: uno 2D, scritto in C, e uno 3D, in C++. Le API 3D sono già molto avanzate; il viewer geometrico 3D è invece ancora giovane, e lo sto completando. Tengo distinte le due cose anche nella documentazione: i grafici 3D dei dati funzionano oggi, il viewer per la geometria 3D arriverà.
Script Python e Octave: due esempi
Chi preferisce scrivere codice non deve rinunciare a niente. Gli script Python e GNU Octave si registrano nella Session e lavorano attraverso le stesse API pubbliche usate dagli strumenti grafici: leggono e pubblicano Dataset, usano le funzioni numeriche, creano grafici. Un risultato ottenuto da script ha la stessa provenienza di uno ottenuto dall’interfaccia.
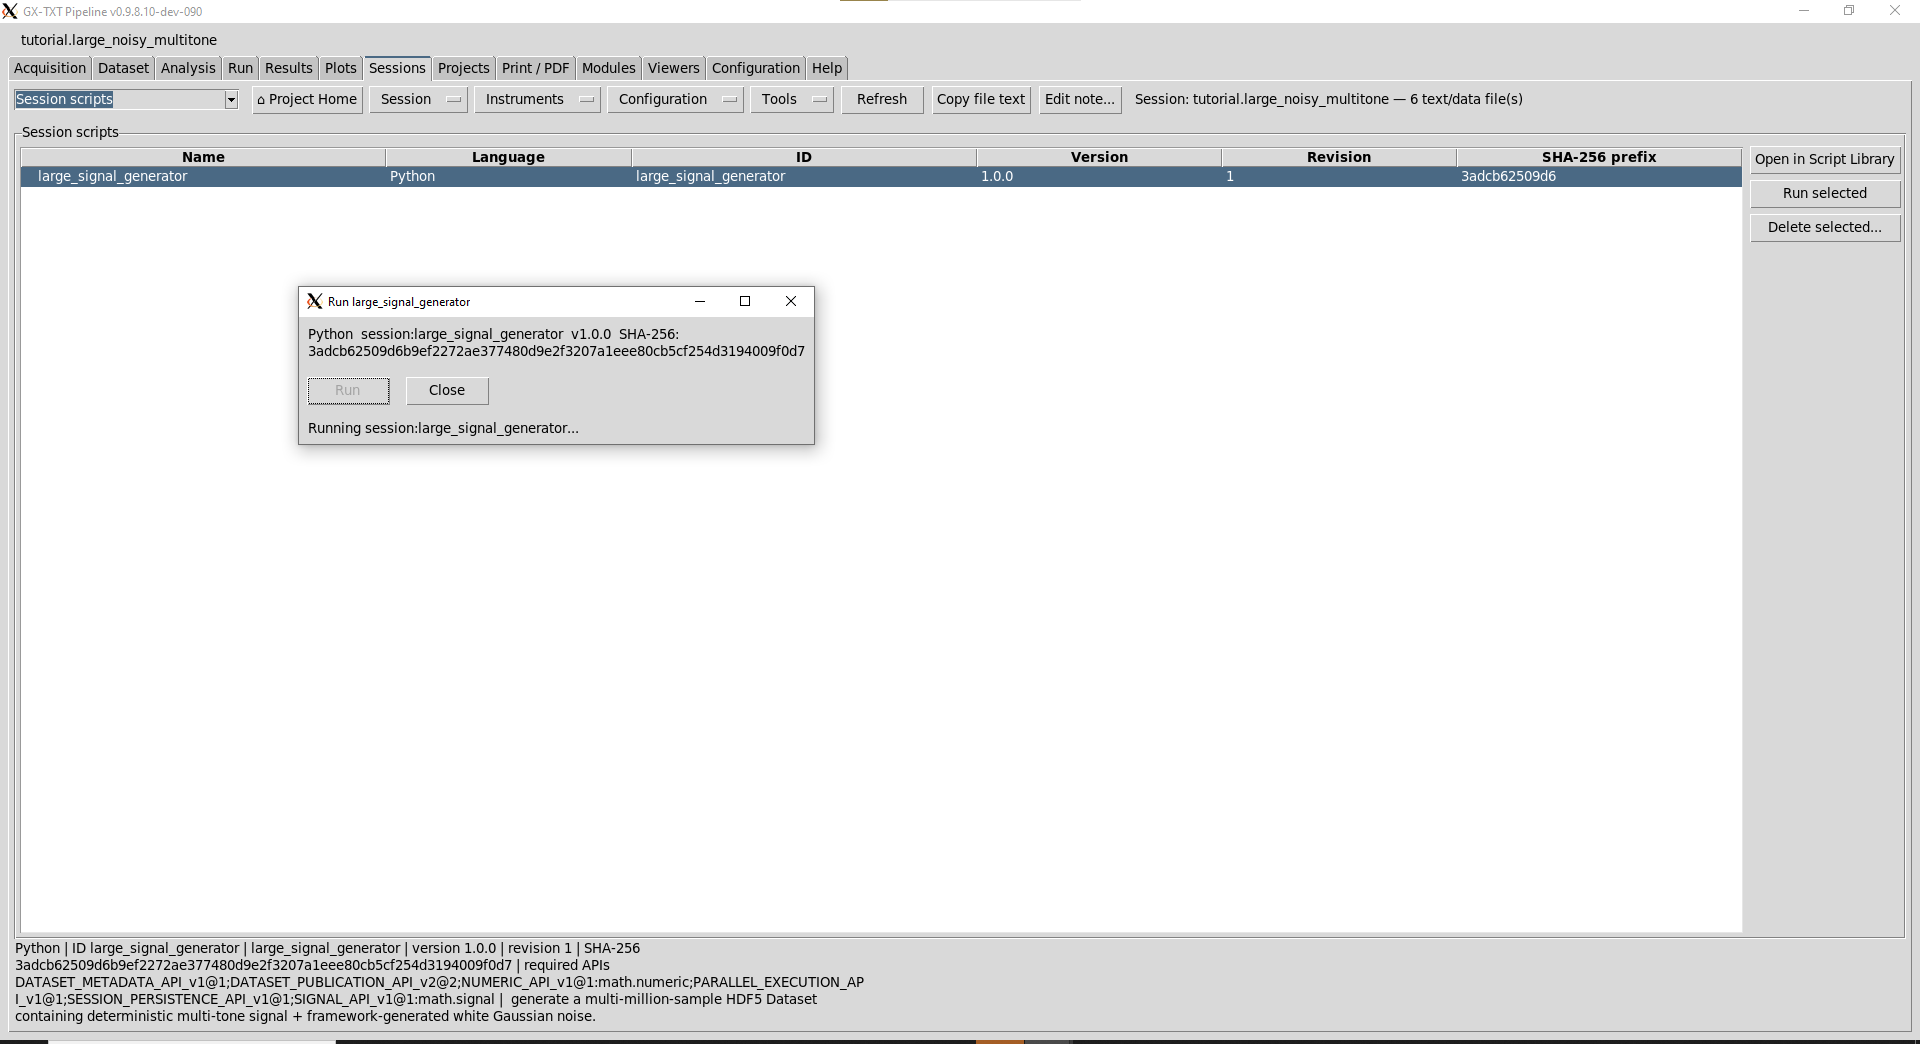
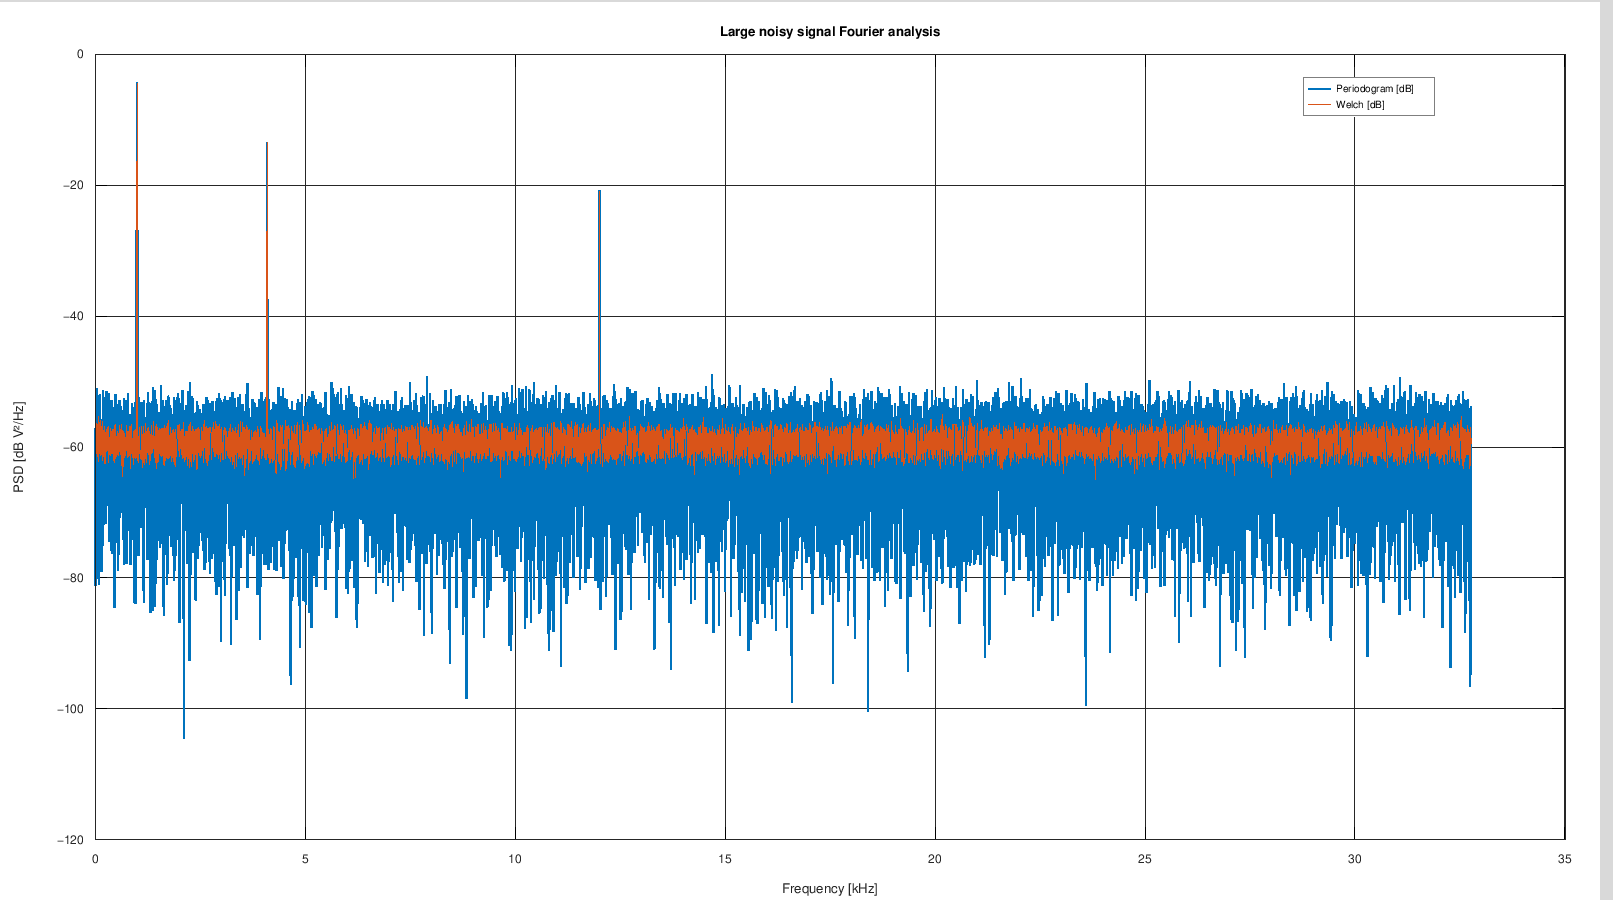
Grandi Dataset, Fourier e calcolo parallelo. Uno script genera un segnale di 4.194.304 campioni — tre toni a 997, 4.093 e 12.011 Hz più rumore bianco — e lo pubblica come Dataset HDF5 in circa 3 secondi. Un secondo script lo legge a blocchi e ne calcola le statistiche senza caricarlo tutto in memoria. Un terzo calcola periodogramma e Welch e crea un grafico persistente nella Session. Un quarto confronta FFT seriali e parallele su quattro processi, con uno speedup di circa 2,4 volte.
STFT e ricostruzione. Il secondo esempio parte da un segnale non stazionario di 131.072 campioni: un chirp da 100 a 3.000 Hz, rumore bianco e due impulsi a 4 e 11 secondi. Lo script calcola la trasformata di Fourier a tempo breve con le API del framework e la conserva intera, come matrice complessa in un Dataset HDF5 a due dimensioni: 2.048 frequenze per circa 513 finestre temporali. Poi la inverte e ricostruisce il segnale con un errore quadratico medio dell’ordine di 10⁻¹⁶ V, cioè alla precisione della macchina. Finestra, passo e NFFT stanno nei metadati, e ogni Dataset derivato rimanda a quello di partenza.
In entrambi i casi i risultati sono Dataset con i loro metadati, consultabili dagli altri strumenti: nessuno script scrive file privati o immagini per conto suo.
Le funzionalità sono organizzate in moduli installabili. Le API sono documentate come contratti versionati, una sessantina di documenti, così chi scrive un modulo sa esattamente su cosa può contare.
A che punto siamo
Quella pubblicata oggi è una beta, la 0.9.8.10-dev-095. Funziona e la uso tutti i giorni, ma non è ancora la versione definitiva: l’interfaccia cambia spesso, alcuni flussi interni sono in piena riscrittura e molte rifiniture devono ancora arrivare.
Cosa arriva nelle prossime versioni:
- un flusso interno dei dati riscritto e un fitter molto ampliato, con statistiche e incertezze dei parametri;
- il viewer geometrico 3D completo;
- nuove librerie scientifiche;
- la gestione delle traiettorie CFD e un viewer per preparare i dictionary di OpenFOAM;
- documentazione e tutorial rifatti sulla versione stabile.
Non do date: la prima versione stabile uscirà quando avrà tutto quello che deve avere e i test passeranno. Fino ad allora pubblicherò altre beta, chiaramente marcate come tali.
Come provarlo
Il codice sorgente è su GitHub: giuxlab-hub/GX-TXT. La documentazione, ancora in costruzione, è su gxtxt.giux-lab.it.
Cosa serve:
- Linux (le librerie native incluse sono per Linux);
- Tcl/Tk con
wishper l’interfaccia; - GNU Octave e Python 3 per i moduli scientifici e gli script, più le dipendenze dei moduli che si usano (NumPy, SciPy, Matplotlib e altre).
Si avvia con wish gxtxt_pipeline.tcl. È una distribuzione sorgente, non un installer: per ora conviene provarlo su una Session di test, non su dati importanti.
Se lo provate, mi interessa sapere cosa funziona, cosa si rompe e cosa manca per il vostro lavoro.
Il primo di una serie
Questo articolo dà solo un’idea. Nei prossimi entrerò nei singoli strumenti: digitalizzazione e analisi delle repliche, il fitter, gli script Python su grandi Dataset, l’analisi spettrale, i grafici 3D.