
GX-TXT Curve Digitalizer: dalla fotografia TLC ai fattori di ritenzione con Python
La cromatografia su strato sottile, o TLC (Thin-Layer Chromatography), è una tecnica semplice e versatile per separare e confrontare i componenti di una miscela. Normalmente si osservano le macchie sviluppate sulla lastrina, si individuano la linea di deposizione e il fronte raggiunto dal solvente e si misurano le distanze necessarie per calcolare il fattore di ritenzione, indicato con \( R_f \).
In questo esperimento utilizziamo GX-TXT Curve Digitalizer per trasformare una fotografia reale di una lastrina TLC in un Dataset di coordinate. Successivamente, mediante uno script Python eseguito in GX-TXT, ricaviamo il centro geometrico delle regioni annotate, calcoliamo cinque valori di \( R_f \), pubblichiamo i risultati come tabella scientifica e li rappresentiamo con il CORE Scientific Dataset Viewer.
Non useremo una fotografia artificiale, né una tabella di valori inventati. Il punto di partenza è un’immagine esistente, con annotazioni già tracciate da chi ha eseguito l’esperimento. Questo aspetto rende il caso didatticamente interessante, ma impone anche di distinguere ciò che è misurabile dall’immagine da ciò che richiederebbe una verifica chimica indipendente.
La fotografia TLC e i materiali necessari
La fotografia è tratta dal documento Amino acids TLC with English translation, pubblicato su Wikimedia Commons da Dvnyn, adattando materiale attribuito a TheFatDrummer. L’opera originale è distribuita con licenza Creative Commons CC BY-SA 4.0.

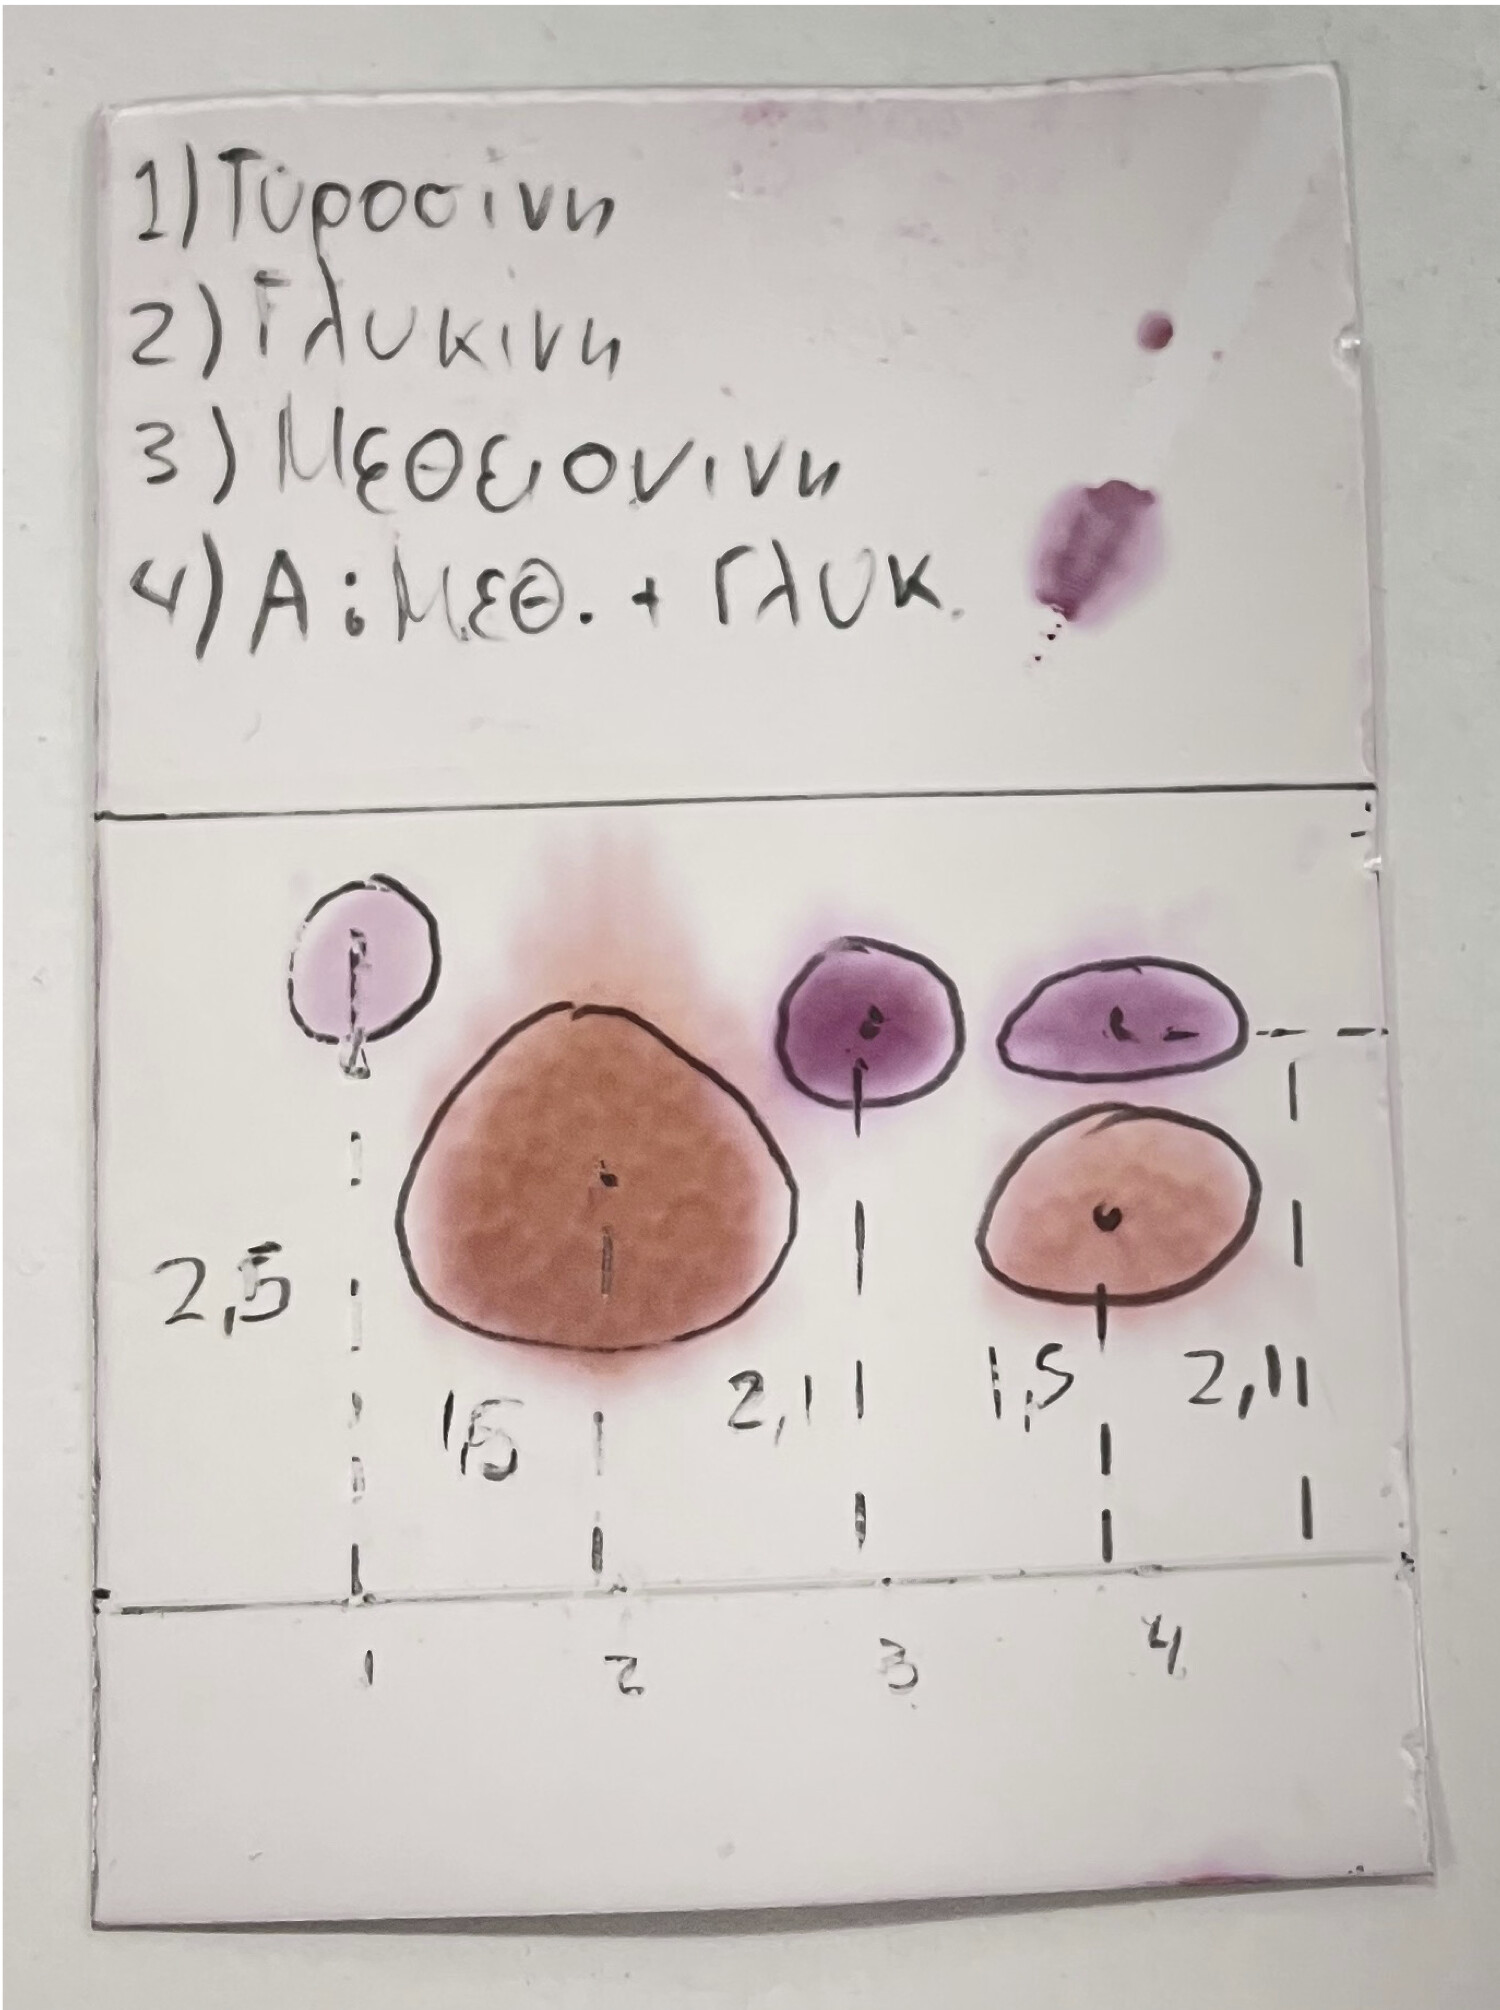
Il documento completo mostra sia la fotografia della lastrina sia uno schema esplicativo. Per lavorare in GX-TXT abbiamo preparato un ritaglio della sola fotografia, senza modificarne i colori o ricostruire le macchie. Il file utilizzato misura 1500 × 2010 pixel. Mettiamo a disposizione il PNG pronto per l’importazione: il lettore non deve eseguire procedure di preparazione o programmi di ritaglio.
Scarica la fotografia per l’esperimento:
Per consultare l’immagine completa e la relativa attribuzione, utilizzare la pagina originale su Wikimedia Commons, dalla quale è disponibile anche il download del PNG originale.

Nell’immagine sono indicate quattro corsie: tre standard descritti dalla fonte come tirosina, glicina e metionina, e una quarta corsia con una miscela attribuita a glicina e metionina. Le etichette e i contorni a pennarello sono elementi già presenti nella fonte: saranno utili per costruire un esperimento riproducibile, ma non costituiscono, da soli, una nuova identificazione analitica.
Importare e calibrare la lastrina, non l’intera fotografia
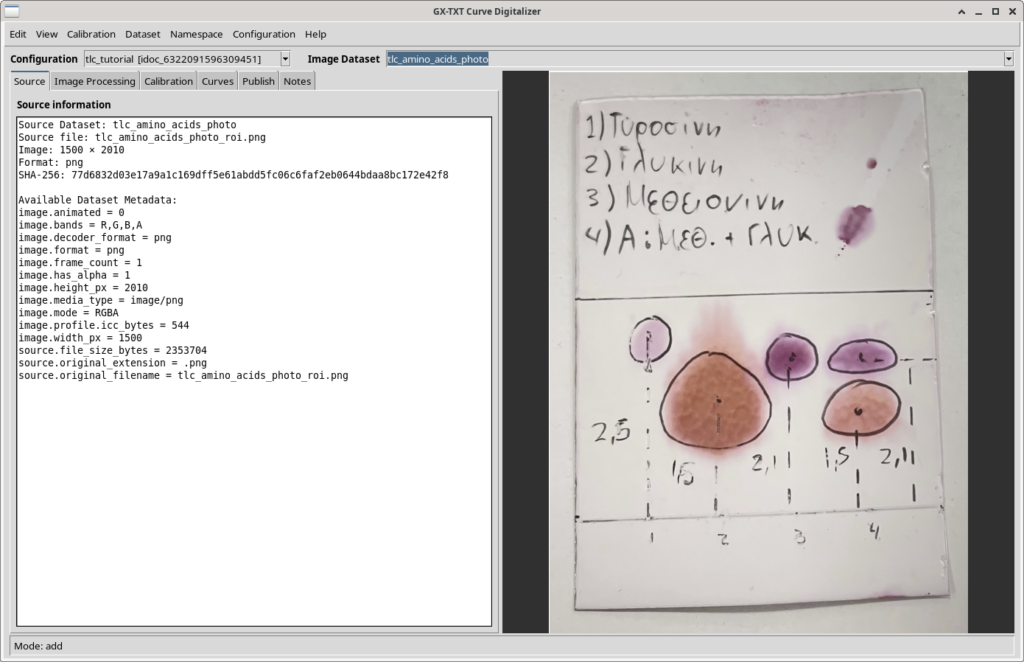
Il primo passaggio consiste nell’importare il PNG in una Session GX-TXT, creando un Image Dataset, e nell’aprirlo nel Curve Digitalizer. L’immagine da acquisire non contiene una scala fisica indipendente necessaria per conoscere in modo affidabile millimetri o centimetri: per il nostro obiettivo non è un problema, perché \( R_f \) è un rapporto adimensionale.
È invece importante che le coordinate descrivano correttamente il piano della lastrina, fotografato con una lieve prospettiva. Per questo abbiamo scelto la calibrazione proiettiva manuale a quattro punti, individuando i vertici reali della piastrina, non gli angoli del PNG o del foglio di sfondo. Nel pannello Calibration i riferimenti sono:
- BL (Bottom Left): angolo inferiore sinistro della lastrina;
- BR (Bottom Right): angolo inferiore destro;
- TL (Top Left): angolo superiore sinistro;
- TR (Top Right): angolo superiore destro.
GX-TXT calcola una trasformazione proiettiva, o omografia, che consente di esprimere nello stesso sistema le coordinate dei punti digitalizzati. Nel nostro lavoro abbiamo mantenuto assi lineari con unità nominale px: sono coordinate della lastrina rettificata, non misure fisiche certificate. La calibrazione è stata verificata e accettata prima dell’acquisizione delle curve.
Una rettifica proiettiva non elimina necessariamente la distorsione dell’obiettivo fotografico e non corregge deformazioni fisiche della lastrina. È però più appropriata, in questo caso, dell’autocalibrazione degli angoli dell’intera immagine.
Digitalizzare la linea di partenza e il fronte del solvente
Per calcolare il fattore di ritenzione servono due riferimenti. In Curves creiamo due curve indipendenti, con due punti per ciascuna:
BASELINE, corrispondente alla linea di deposizione, vicina alla parte inferiore;SOLVENT_FRONT, corrispondente alla linea superiore che viene interpretata come fronte raggiunto dal solvente.
È utile definire questi riferimenti come segmenti, invece di assumere a priori che abbiano tutti la stessa coordinata verticale. In questo modo lo script può valutare le distanze nella direzione di migrazione tenendo conto dell’orientamento delle linee.
L’identificazione della linea superiore come fronte del solvente deriva dall’interpretazione dell’immagine e delle sue annotazioni. Per una misura analitica indipendente dovrebbe essere confermata dalla documentazione sperimentale originale.
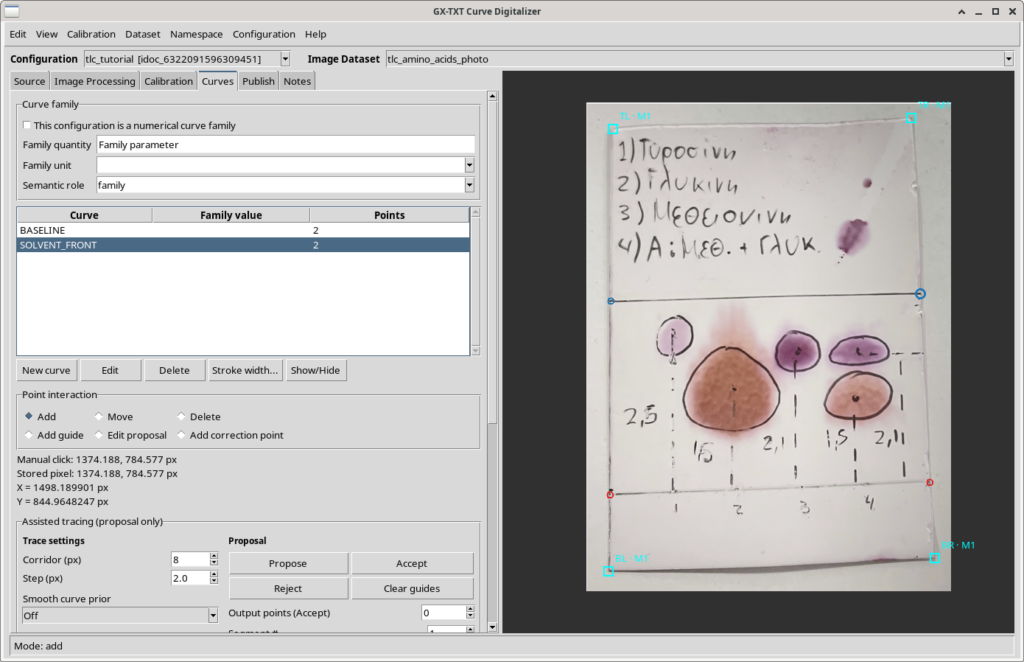
Le cinque macchie: digitalizzare regioni annotate
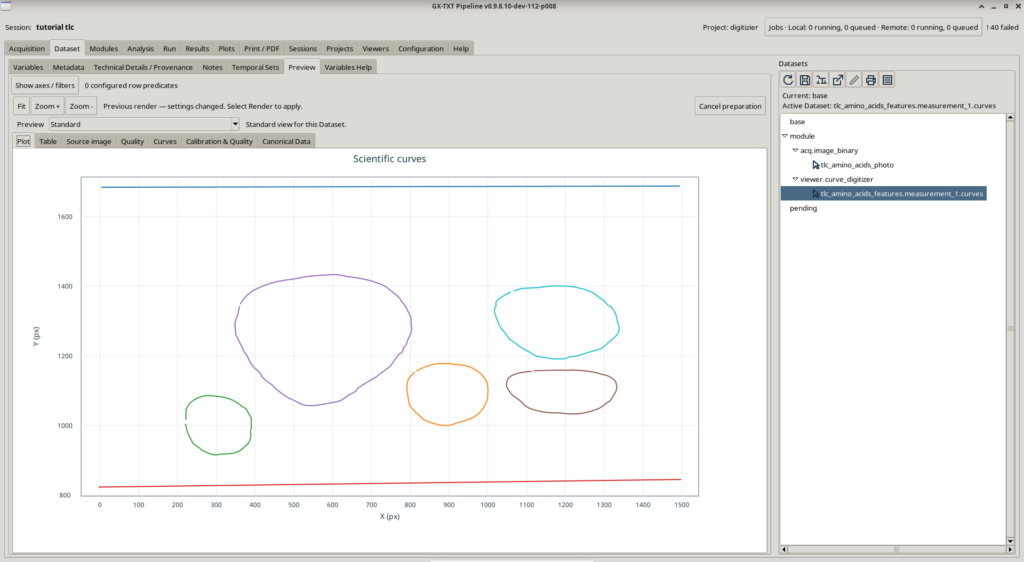
Nel caso fotografato il chimico ha segnato a pennarello i contorni delle macchie. Abbiamo scelto di digitalizzare precisamente quelle delimitazioni, anziché inventare una soglia cromatica o simulare una segmentazione automatica. È una scelta riproducibile: chi ripete l’esperimento può seguire le stesse regioni riportate sull’immagine.
Le cinque curve hanno i seguenti nomi:
| Corsia | Nome della curva | Regione indicata nella fotografia |
|---|---|---|
| 1 | SPOT_L01_S01_TYROSINE | Tirosina |
| 2 | SPOT_L02_S01_GLYCINE | Glicina |
| 3 | SPOT_L03_S01_METHIONINE | Metionina |
| 4 | SPOT_L04_S01_GLYCINE | Macchia inferiore della miscela |
| 4 | SPOT_L04_S02_METHIONINE | Macchia superiore della miscela |
Le curve sono mantenute in modalità independent curves, non come famiglia numerica. Ogni contorno è descritto da una sequenza ordinata di punti. La digitalizzazione è stata particolarmente dettagliata, così da conservare anche le irregolarità delle sagome annotate.
La tirosina merita una precisazione: il colore della sua macchia è molto tenue. Il suo contorno è stato acquisito perché era segnato nell’immagine originale, non perché fosse possibile determinare con uguale precisione il bordo effettivo della colorazione. Di conseguenza, i risultati che ne derivano devono essere interpretati come misure della regione delimitata a pennarello.
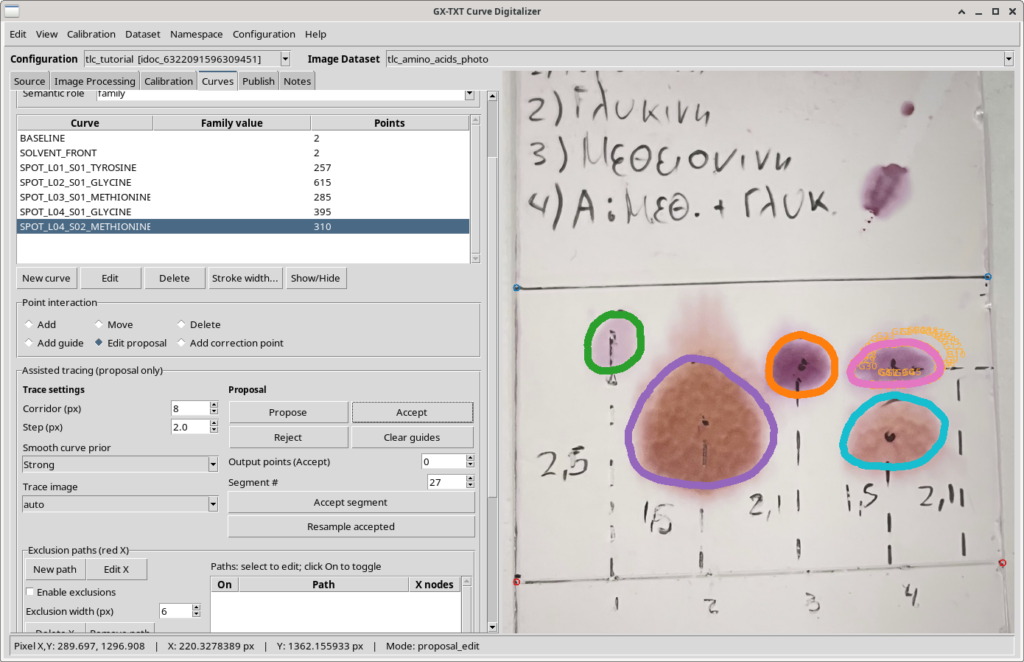
Pubblicare le coordinate in un Dataset GX-TXT
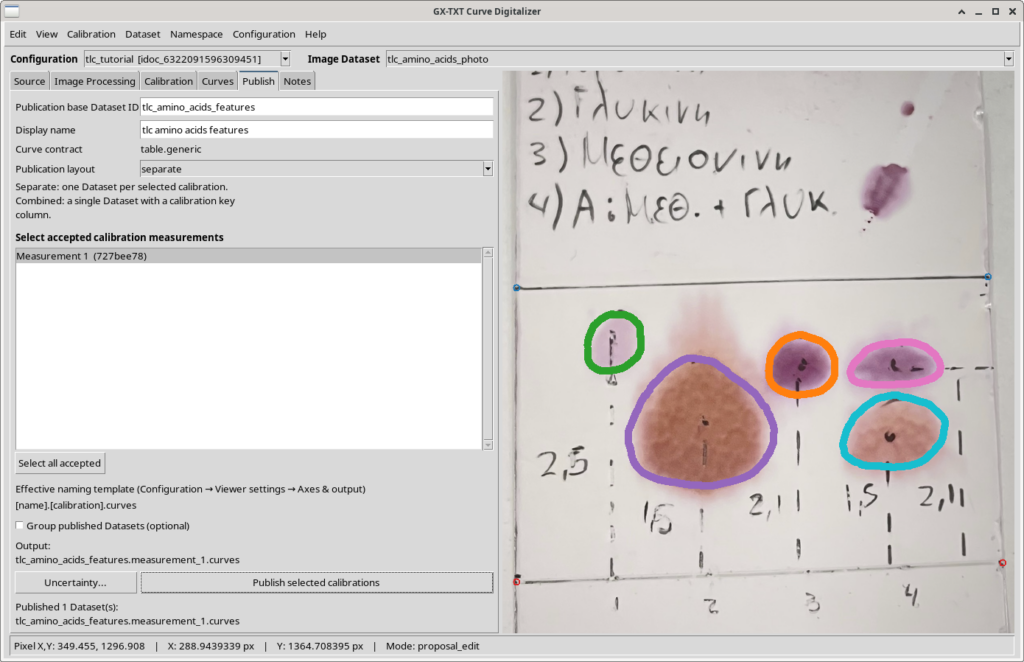
Al termine della digitalizzazione, la scheda Publish consente di pubblicare i dati sotto forma di Dataset canonico. Nel nostro caso abbiamo selezionato una misura di calibrazione accettata, scelto la disposizione separata per calibrazione e mantenuto il contratto table.generic, appropriato per curve indipendenti.
La pubblicazione reale contiene sette curve — i due segmenti di riferimento e le cinque regioni — per un totale di 1.866 punti. Ogni riga conserva le coordinate scientifiche, le coordinate originali nell’immagine, l’identità della curva e l’ordine dei punti. Queste informazioni permettono allo script di ricostruire esattamente le sagome e non soltanto di leggere una tabella di X e Y.
GX-TXT può aggiungere un suffisso relativo alla calibrazione selezionata. Nell’esperimento, ad esempio, il Dataset di origine è stato pubblicato come tlc_amino_acids_features.measurement_1.curves. Non occorre inserire questo identificativo nel codice Python: lo selezioneremo direttamente come Dataset di input durante l’esecuzione.
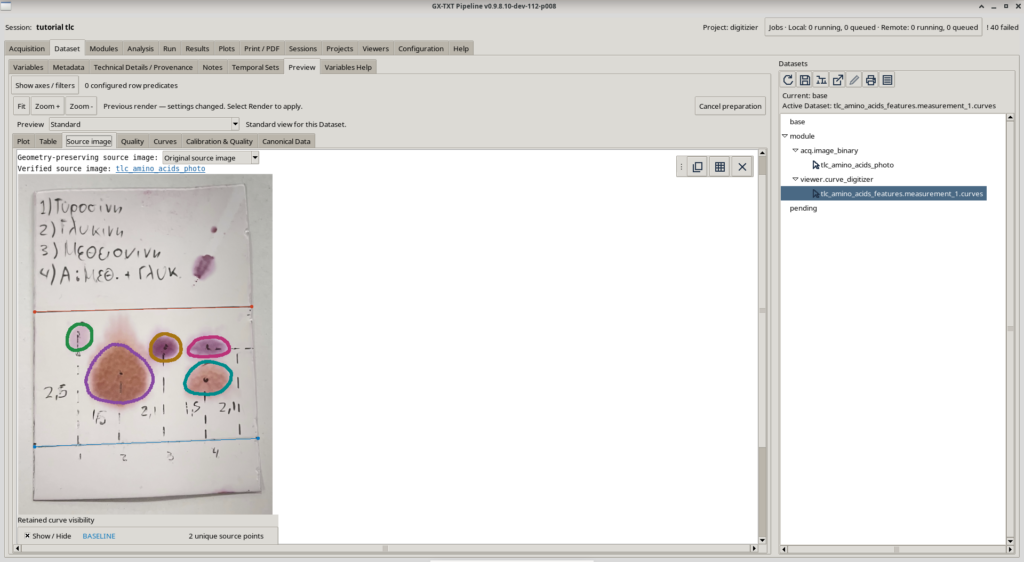
Dal contorno al fattore di ritenzione
Il fattore di ritenzione di una macchia TLC è definito come il rapporto tra la distanza percorsa dalla sostanza e quella percorsa dal fronte del solvente, entrambe misurate a partire dalla linea di deposizione:
\[ R_f = \frac{d_{\mathrm{macchia}}}{d_{\mathrm{fronte}}} \]
Il rapporto non richiede una conversione in centimetri, purché le due distanze siano definite nello stesso sistema di coordinate.
Il nostro script non sceglie un punto arbitrario della macchia. Tratta ogni contorno come un poligono e ne calcola il centroide geometrico, cioè il baricentro della regione delimitata:
\[ \mathbf{c}=\frac{1}{A}\iint_{\Omega}(x,y)\,\mathrm{d}A \]
Questa definizione è utile quando le regioni sono asimmetriche o irregolari: spostare manualmente un singolo punto centrale diventerebbe una scelta più soggettiva. La regione viene chiusa geometricamente collegando l’ultimo punto al primo; lo script controlla anche l’entità dell’eventuale apertura residua.
Per valutare le distanze, il programma ricava la direzione normale alla BASELINE e considera il fronte del solvente nella posizione corrispondente alla macchia. La logica è quindi più generale di una semplice sottrazione fra due coordinate Y: funziona anche quando le rette non sono perfettamente orizzontali.
L’area e il perimetro calcolati descrivono il poligono annotato, non una stima fisica in millimetri quadrati o un’analisi della quantità di sostanza. Il software produce così una serie di grandezze geometriche, ma il risultato chimico principale resta \( R_f \).
Lo script Python: come utilizzarlo
Il programma principale è tlc_rf_table_generic_csv.py. È uno script pensato per funzionare anche con altre fotografie TLC: non è vincolato al nome del nostro Dataset e non è limitato alle cinque macchie di questo esempio.
#!/usr/bin/env python3
# SPDX-License-Identifier: GPL-3.0-or-later
"""Generic TLC Rf table Dataset from a Curve Digitalizer canonical Dataset.

Use Python Script Workspace -> Run -> Open Script Runner, and choose the
published Curve Digitalizer Dataset as Analysis Source with alias 'primary'.

No source Dataset ID or technical input column name is hardcoded.
The actual Curve Digitalizer roles and Variable IDs are obtained using public
Dataset Metadata API v1 and Variable Schema API v3 through the Script Bridge.
The public Curve Digitizer Dataset Schema host API is not Script-bridged in
the currently installed framework, so it cannot be called from Python.

Curve *labels* distinguish BASELINE, SOLVENT_FRONT and SPOT_Lnn_Snn_*;
edit the three conventions below if a different naming scheme was used.
The ROI contours are annotations by an operator, not automatic segmentation.
Only one canonical table.generic CSV Dataset is published. A separate Markdown
note is prepared in the Job output for attachment via GX-TXT Dataset Notes UI;
Python Script Bridge does not expose the host-only Dataset Notes writer.
"""

from __future__ import annotations

from collections import defaultdict
from hashlib import sha256
from math import dist, hypot, isfinite
from pathlib import Path
import json
import re

from gxtxt import gxtxt_api_call, gxtxt_api_require, gxtxt_context

SOURCE_ALIAS = "primary"
BASELINE_LABEL = "BASELINE"
FRONT_LABEL = "SOLVENT_FRONT"
SPOT_LABEL_PATTERN = r"^SPOT_L(\d{1,3})_S(\d{1,3})(?:_[A-Z0-9_]+)?$"
RESULT_VERSION = "v2"          # Choose v2, v3 ... to publish another analysis.
MAX_SOURCE_ROWS = 100000
MAX_GAP_FRACTION = 0.10        # Safety check for obviously open polygons.
SPOT_PATTERN = re.compile(SPOT_LABEL_PATTERN)

REQUIRED_APIS = [
    "CANONICAL_DATASET_API_v2@2",
    "DATASET_METADATA_API_v1@1",
    "DATASET_VARIABLE_SCHEMA_API_v3@3",
    "DATASET_PUBLICATION_API_v2@2",
]


def api(owner, operation, args):
    return gxtxt_api_call(owner, operation, args)


def selected_source(ctx):
    inputs = ctx.get("inputs", {}) or {}
    source = (inputs.get(SOURCE_ALIAS, {}) or {}).get("dataset_id", "")
    source = str(source).strip()
    if not source:
        raise RuntimeError(
            "In Open Script Runner, add a Dataset input with alias 'primary'.")
    return source


def output_names(source):
    stem = re.sub(r"[^a-z0-9_]+", "_", source.lower()).strip("_")
    if len(stem) > 66:
        stem = stem[:54].rstrip("_") + "_" + sha256(source.encode()).hexdigest()[:9]
    if not stem or not re.fullmatch(r"v[1-9][0-9]*", RESULT_VERSION):
        raise RuntimeError("Invalid source identity or RESULT_VERSION")
    return stem + "_rf_" + RESULT_VERSION


def _column(block, variable_id):
    source = block[variable_id]["values"]
    if hasattr(source, "reshape"):
        return source.reshape(-1).tolist()
    result = []
    for value in source:
        if isinstance(value, (list, tuple)):
            if len(value) != 1:
                raise RuntimeError("Non-rank-one canonical input column")
            value = value[0]
        result.append(value)
    return result


def read_digitizer_source(dataset_id):
    """Resolve the producer's role manifest, not CSV headers or fixed IDs."""
    md = api("DATASET_METADATA_API_v1", "read", [dataset_id])
    if md.get("curve_digitizer.plugin_id") != "viewer.curve_digitizer":
        raise RuntimeError("The selected Dataset was not published by Curve Digitalizer")
    if md.get("curve_digitizer.curve_mode") != "independent":
        raise RuntimeError("Select a Dataset of independent digitized curves")
    if md.get("curve_digitizer.curve_grouping") != "curve_key":
        raise RuntimeError("Select a single-calibration publication (curve_key grouping)")
    schema_version = str(md.get("curve_digitizer.curve_schema_version", ""))
    if schema_version not in ("1", "2"):
        raise RuntimeError("Unsupported or missing Curve Digitalizer schema version")

    desc = api("CANONICAL_DATASET_API_v2", "describe", [dataset_id])
    if desc.get("contract") != "table.generic":
        raise RuntimeError("Expected Curve Digitalizer table.generic contract")
    rows = int(desc.get("row_count", 0))
    if rows < 7 or rows > MAX_SOURCE_ROWS:
        raise RuntimeError("Unexpected source point count: " + str(rows))

    schema = api("DATASET_VARIABLE_SCHEMA_API_v3", "list", [dataset_id])
    by_id = {str(col["variable_id"]): col for col in schema}
    roles = ("x", "y", "curve_key", "curve_name", "point_order")
    columns = {}
    dimension = str(md.get("curve_digitizer.curve_row_dimension", ""))
    if not dimension:
        raise RuntimeError("Missing Curve Digitalizer row dimension metadata")
    for role in roles:
        key = "curve_digitizer.curve_column." + role
        variable_id = str(md.get(key, "")).strip()
        if not variable_id or variable_id not in by_id:
            raise RuntimeError("Missing producer semantic column role: " + role)
        col = by_id[variable_id]
        if str(col.get("rank")) != "1":
            raise RuntimeError("Non-scalar producer column for role: " + role)
        declared_dimensions = col.get("dimension_ids")
        if isinstance(declared_dimensions, (list, tuple)):
            declared_dimensions = list(declared_dimensions)
        elif isinstance(declared_dimensions, str):
            declared_dimensions = declared_dimensions.replace(";", " ").split()
        else:
            declared_dimensions = []
        if declared_dimensions != [dimension]:
            raise RuntimeError("Producer column dimension mismatch: " + role)
        columns[role] = variable_id
    if len(set(columns.values())) != len(roles):
        raise RuntimeError("Duplicate Variable IDs mapped to different roles")
    xy_unit = str(by_id[columns["x"]].get("unit", ""))
    if not xy_unit or xy_unit != str(by_id[columns["y"]].get("unit", "")):
        raise RuntimeError("X and Y must share a consistent unit")
    if xy_unit not in ("px", "1", "mm", "cm", "m"):
        raise RuntimeError("Review unfamiliar source unit: " + xy_unit)

    curves_by_key = defaultdict(list)
    names_by_key = {}
    wanted = list(dict.fromkeys(columns.values()))
    for start in range(0, rows, 1000):
        count = min(1000, rows - start)
        block = api("CANONICAL_DATASET_API_v2", "read_range",
                    [dataset_id, wanted, start, count])
        data = {role: _column(block, var) for role, var in columns.items()}
        if any(len(v) != count for v in data.values()):
            raise RuntimeError("Canonical read_range returned incomplete data")
        for i in range(count):
            x, y = float(data["x"][i]), float(data["y"][i])
            key = str(data["curve_key"][i]).strip()
            name = str(data["curve_name"][i]).strip().upper()
            order = int(data["point_order"][i])
            if not (isfinite(x) and isfinite(y) and key and name):
                raise RuntimeError("Invalid Curve Digitalizer point")
            if key in names_by_key and name != names_by_key[key]:
                raise RuntimeError("Conflicting labels for one curve key")
            names_by_key[key] = name
            curves_by_key[key].append((order, (x, y)))

    curves = {}
    for key, rows_for_curve in curves_by_key.items():
        rows_for_curve.sort(key=lambda item: item[0])
        if [v[0] for v in rows_for_curve] != list(range(len(rows_for_curve))):
            raise RuntimeError("Inconsistent point_order for curve " + key)
        label = names_by_key[key]
        if label in curves:
            raise RuntimeError("Duplicate curve label: " + label)
        curves[label] = [xy for _, xy in rows_for_curve]
    return curves, xy_unit, rows, columns


def dot(u, v):
    return u[0]*v[0] + u[1]*v[1]


def sub(a, b):
    return a[0]-b[0], a[1]-b[1]


def polygon_centroid(vertices):
    """Shoelace centroid for a closed hand-annotated contour."""
    if len(vertices) < 3:
        raise RuntimeError("Spot contour requires three or more points")
    pts = vertices[:-1] if dist(vertices[0], vertices[-1]) < 1e-8 else vertices
    if len(pts) < 3:
        raise RuntimeError("Degenerate polygon")
    cross_sum = sum_x = sum_y = perimeter = 0.0
    for a, b in zip(pts, pts[1:] + pts[:1]):
        cross = a[0]*b[1] - b[0]*a[1]
        cross_sum += cross
        sum_x += (a[0] + b[0])*cross
        sum_y += (a[1] + b[1])*cross
        perimeter += dist(a, b)
    if abs(cross_sum) < 1e-8 or perimeter < 1e-8:
        raise RuntimeError("Spot has invalid polygon area or perimeter")
    gap = dist(vertices[0], vertices[-1])
    if gap/perimeter > MAX_GAP_FRACTION:
        raise RuntimeError("Contour closure gap exceeds the reviewed limit")
    centroid = (sum_x/(3*cross_sum), sum_y/(3*cross_sum))
    if not all(isfinite(z) for z in centroid):
        raise RuntimeError("Non-finite polygon centroid")
    return centroid, abs(cross_sum)/2, perimeter, gap


def rf_measurements(curves):
    """Measure each ROI by its perpendicular distance along the plate."""
    baseline = curves.get(BASELINE_LABEL)
    front = curves.get(FRONT_LABEL)
    if baseline is None or front is None:
        raise RuntimeError("Missing BASELINE or SOLVENT_FRONT annotated curves")
    if len(baseline) != 2 or len(front) != 2:
        raise RuntimeError("BASELINE and SOLVENT_FRONT need exactly two points each")
    b0, b1 = baseline
    f0, f1 = front
    direction = sub(b1, b0)
    length = hypot(*direction)
    if length <= 1e-9:
        raise RuntimeError("Degenerate baseline segment")
    tangent = direction[0]/length, direction[1]/length
    normal = (-tangent[1], tangent[0])
    midpoint_front = ((f0[0]+f1[0])/2, (f0[1]+f1[1])/2)
    if dot(sub(midpoint_front, b0), normal) < 0:
        normal = (-normal[0], -normal[1])
    front_pos0 = dot(sub(f0, b0), tangent)
    front_delta = dot(sub(f1, f0), tangent)
    if abs(front_delta) < 1e-9:
        raise RuntimeError("Front is transverse to the migration coordinate")
    min_u, max_u = sorted((front_pos0, front_pos0+front_delta))

    observations = []
    for name, points in sorted(curves.items()):
        if name in (BASELINE_LABEL, FRONT_LABEL):
            continue
        match = SPOT_PATTERN.fullmatch(name)
        if match is None:
            raise RuntimeError(
                f"Unknown spot curve label: {name}; change SPOT_LABEL_PATTERN")
        centroid, area, perimeter, gap = polygon_centroid(points)
        u = dot(sub(centroid, b0), tangent)
        if not min_u-1e-6 <= u <= max_u+1e-6:
            raise RuntimeError("Spot lies outside the annotated solvent front: "+name)
        f = (u-front_pos0)/front_delta
        front_here = (f0[0]+f*(f1[0]-f0[0]),
                      f0[1]+f*(f1[1]-f0[1]))
        d_solvent = dot(sub(front_here, b0), normal)
        d_spot = dot(sub(centroid, b0), normal)
        if d_solvent <= 0:
            raise RuntimeError("Nonpositive migration distance: " + name)
        retention = d_spot/d_solvent
        if not 0.0 <= retention <= 1.0:
            raise RuntimeError("Rf outside [0,1]; check source lines: " + name)
        observations.append({
            "name": name,
            "lane": int(match.group(1)),
            "spot_index": int(match.group(2)),
            "centroid_x": centroid[0],
            "centroid_y": centroid[1],
            "distance_spot": d_spot,
            "distance_front": d_solvent,
            "rf": retention,
            "annotated_area": area,
            "annotated_perimeter": perimeter,
            "closure_gap": gap,
            "source_points": len(points),
        })
    if not observations:
        raise RuntimeError("No SPOT_Lnn_Snn curves in selected input Dataset")
    if len({(r["lane"],r["spot_index"]) for r in observations}) != len(observations):
        raise RuntimeError("Duplicate lane and spot identifiers")
    return observations


TABLE_FIELDS = (
    # Stable column IDs, readable labels, internal field, dtype, unit rule.
    ("feature_name", "Digitized feature label", "name", "string", "text"),
    ("lane", "TLC lane", "lane", "int32", "1"),
    ("spot_index", "Spot within lane", "spot_index", "int32", "1"),
    ("rf", "Retention factor (Rf)", "rf", "float64", "1"),
    ("spot_distance", "Spot migration distance (mapped coordinates)",
     "distance_spot", "float64", "unit"),
    ("solvent_distance", "Solvent-front migration distance (mapped coordinates)",
     "distance_front", "float64", "unit"),
    ("centroid_x", "Annotated region centroid X",
     "centroid_x", "float64", "unit"),
    ("centroid_y", "Annotated region centroid Y",
     "centroid_y", "float64", "unit"),
    ("annotated_area", "Annotated region area (mapped coordinates squared)",
     "annotated_area", "float64", "area"),
    ("annotated_perimeter", "Annotated region perimeter",
     "annotated_perimeter", "float64", "unit"),
    ("closure_gap", "Unclosed contour gap",
     "closure_gap", "float64", "unit"),
    ("source_points", "Original digitized points",
     "source_points", "int32", "1"),
)


def _unit_for_field(u, coordinate_unit):
    if u == "text":
        return ""
    if u == "unit":
        return coordinate_unit
    if u == "area":
        return "1" if coordinate_unit == "1" else coordinate_unit + "^2"
    return u


def publish_table_dataset(source, output, unit, measurements, column_roles,
                          original_rows):
    metadata = {
        "processing.kind": "tlc_retention_factor_from_annotated_polygons",
        "processing.input_dataset_id": source,
        "processing.input_coordinate_unit": unit,
        "processing.source_rows": str(original_rows),
        "processing.spot_count": str(len(measurements)),
        "processing.method": "chemist_marker_polygon_centroid",
        "processing.rf_method": "baseline_normal_perpendicular_distance_ratio",
        "processing.geometry": "source_projective_calibration",
        "processing.uncertainty": "not_quantified",
        "processing.spot_identities": "source_labels_only_not_verified",
        "processing.input_column_mapping": json.dumps(
            column_roles, sort_keys=True, ensure_ascii=False),
        "processing.annotation_type": "chemist_drawn_marker_ROI",
        "processing.rf_definition": "spot_distance_divided_by_solvent_distance",
        "processing.coordinate_reference": "projectively_mapped_TLC_plate",
    }
    definition = {
        "dataset_id": output,
        "contract": "table.generic",
        "storage": "csv",
        "producer_version": "2.0.0",
        "replace_owned": False,
        "source_dataset_ids": [source],
        "source_variable_ids": [],
        "source": "GX-TXT Python Script Workspace public Script Bridge",
        "provenance": (
            "TLC geometric centroid and Rf from a published Curve Digitalizer "
            "Dataset; validated producer semantic columns; single canonical table."),
        "structured_metadata": metadata,
    }
    writer = api("DATASET_PUBLICATION_API_v2", "begin", [definition])
    try:
        api("DATASET_PUBLICATION_API_v2", "declare_dimension",
            [writer, "row", 0, {"extendible": True}])
        columns = {}
        for field_id, label, key, dtype, unit_rule in TABLE_FIELDS:
            schema = {
                "dtype": dtype,
                "rank": 1,
                "dimension_ids": "row",
                "coordinate_role": "data",
                "name": field_id,
                "display_label": label,
                "unit": _unit_for_field(unit_rule, unit),
                "semantic_role": "" if dtype == "string" else "derived",
            }
            api("DATASET_PUBLICATION_API_v2", "declare_variable",
                [writer, field_id, schema])
            if dtype == "string":
                vals = [str(item[key]) for item in measurements]
            elif dtype == "int32":
                vals = [int(item[key]) for item in measurements]
            else:
                vals = [float(item[key]) for item in measurements]
            columns[field_id] = vals
        api("DATASET_PUBLICATION_API_v2", "append",
            [writer, "row", columns])
        receipt = api("DATASET_PUBLICATION_API_v2", "finalize", [writer])
        writer = None
        return receipt
    except Exception:
        if writer is not None:
            api("DATASET_PUBLICATION_API_v2", "abort", [writer])
        raise


def prepare_dataset_notes(source, output, unit, columns, source_rows,
                          measurements, ctx):
    # The current Python Script Bridge has NO Dataset Notes API write operation.
    # Do not manufacture a second Dataset or mutate the Session registry.
    # Save reviewable Markdown in the owned Job output directory; attach it in
    # the ordinary Dataset -> Notes editor after verifying the published table.
    root = Path(ctx["output_dir"]).resolve()
    root.mkdir(parents=True, exist_ok=True)
    lines = [
        "# TLC retention factor — scientific notes",
        "",
        "## Provenance",
        "",
        "Source Dataset: " + source,
        "",
        "Result Dataset: " + output,
        "",
        "Original Curve Digitalizer rows: " + str(source_rows),
        "",
        "Coordinate unit in source: " + unit,
        "",
        "The spot regions were **drawn in marker by a chemist** on the "
        "original photograph. We digitized those annotations, not automatically "
        "segmented chemical stain boundaries. Chemical names are source "
        "labels, not independently verified identities.",
        "",
        "## Method",
        "",
        "Each annotated contour was treated as a polygon. Its shoelace "
        "centroid was projected onto the migration direction, defined as the "
        "normal to BASELINE. The solvent front was evaluated at the same "
        "baseline-tangent coordinate. Rf equals spot migration distance "
        "divided by solvent-front migration distance.",
        "",
        "Values are dimensionless; source coordinate units describe a "
        "projectively mapped plate, **not a certified physical mm scale**.",
        "",
        "## Measured spots",
        "",
        "| Source curve name | Lane | Spot | Rf |",
        "|---|---:|---:|---:|",
    ]
    for item in measurements:
        lines.append(
            "| " + str(item["name"]) + " | " +
            str(item["lane"]) + " | " +
            str(item["spot_index"]) + " | " +
            format(item["rf"], ".6f") + " |")
    lines.extend([
        "",
        "## Producer semantic role mappings",
        "",
        "Resolved from the source's Curve Digitalizer metadata and the "
        "public Variable Schema API, not from hardcoded CSV column headers.",
        "",
    ])
    for role, var_id in sorted(columns.items()):
        lines.append("- " + role + ": " + var_id)
    lines.extend([
        "",
        "## Limitations",
        "",
        "- The upper reference line is presumed to be the solvent front; "
        "its identity requires experimental confirmation.",
        "- A manually drawn perimeter may not coincide exactly with the stain.",
        "- The faint tyrosine region is especially sensitive to operator annotation.",
        "- Rf alone cannot establish chemical identity or concentration.",
        "- Lens distortion and nonplanarity are not corrected by a projective mapping.",
        "- Source-coordinate uncertainties and propagated Rf uncertainties "
        "have not been quantified.",
        "",
        "This note can be associated via the GX-TXT Dataset Notes editor. "
        "It is not a second scientific Dataset.",
        "",
    ])
    path = root / "tlc_rf_dataset_notes.md"
    path.write_text("\n".join(lines),
                    encoding="utf-8")
    return path


def main():
    gxtxt_api_require(REQUIRED_APIS)
    ctx = gxtxt_context()
    source = selected_source(ctx)
    output = output_names(source)
    curves, unit, count, columns = read_digitizer_source(source)
    observations = rf_measurements(curves)
    print("TLC_INPUT", source, "rows", count, "curves", len(curves))
    print("TLC_DISCOVERED_ROLES", columns)
    for row in observations:
        print("TLC_RF", row["name"], format(row["rf"], ".6f"))
    notes = prepare_dataset_notes(source, output, unit, columns, count,
                                  observations, ctx)
    print("TLC_DATASET_NOTES_MARKDOWN_READY", str(notes), flush=True)
    receipt = publish_table_dataset(source, output, unit, observations,
                                    columns, count)
    print("TLC_TABLE_DATASET_PUBLISHED", receipt, flush=True)
    print("TLC_NOTE_ATTACHMENT_REQUIRED",
          "Use Dataset -> Notes to associate the Markdown with the new Dataset",
          flush=True)


if __name__ == "__main__":
    main()
La procedura di esecuzione è la seguente:
- Aprire la Session contenente il Dataset pubblicato dal Curve Digitalizer.
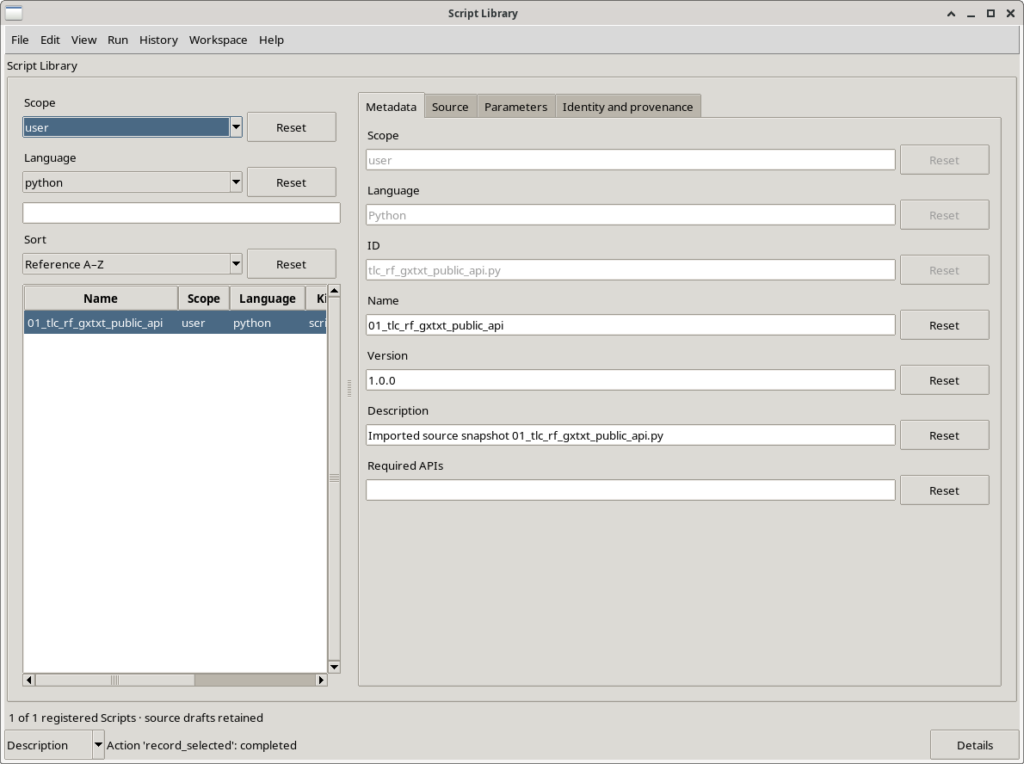
- Importare lo script tramite la Script Library di GX-TXT, ad esempio nello User Space. È possibile conservarlo e riutilizzarlo in Session differenti.
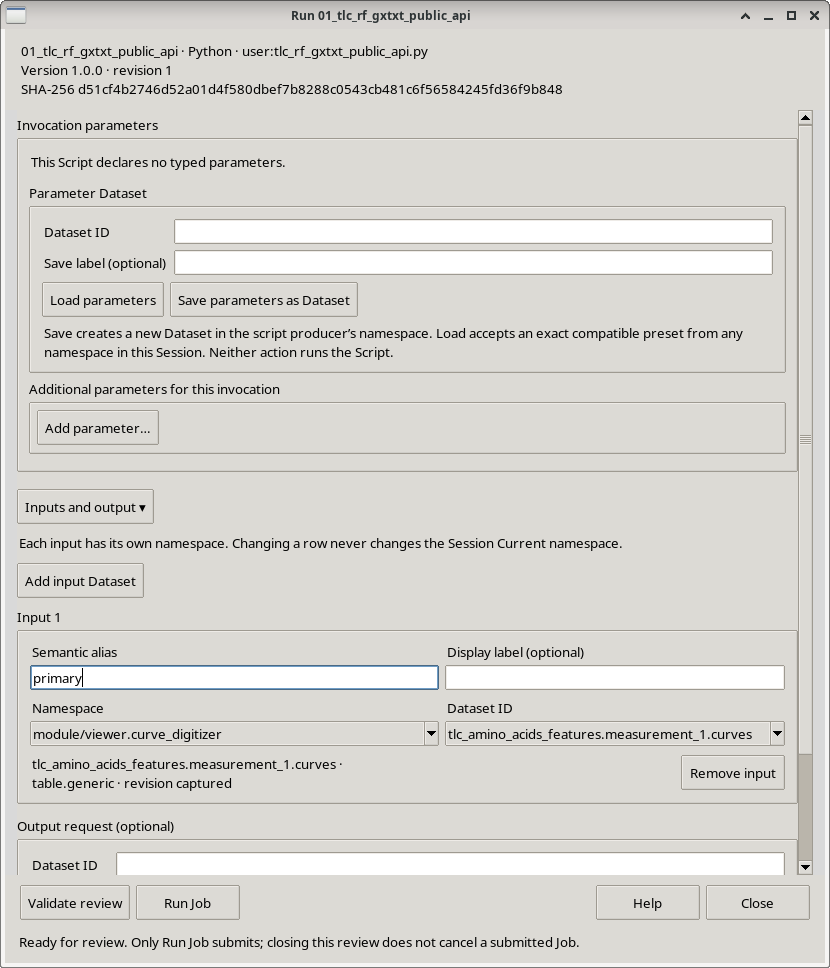
- Aprire il Script Runner per lo script selezionato.
- Nella sezione Inputs and output, aggiungere il Dataset delle curve, scegliendo come Semantic alias il valore esatto
primary. - Premere Validate review, verificare che sia selezionato il Dataset corretto e quindi eseguire Run Job.
- Controllare l’esito del Job e aprire il nuovo Dataset contenente i fattori di ritenzione.
Perché è uno script riutilizzabile
Nello script l’identificativo del Dataset viene recuperato dal contesto di esecuzione di GX-TXT, mediante gxtxt_context(). I nomi tecnici delle colonne, come coordinate X/Y, identità della curva e ordine dei punti, sono ricavati dai metadati pubblicati dal Curve Digitalizer e verificati attraverso le API pubbliche dedicate allo schema delle variabili. I dati vengono poi letti tramite la Canonical Dataset API.
Questo significa che non è necessario modificare il programma ogni volta che GX-TXT assegna un nome diverso al Dataset o utilizza identificativi tecnici differenti per le colonne. L’analisi dipende dai ruoli semantici dichiarati dal produttore dei dati, non dalla posizione delle colonne in un CSV.
Il Dataset di uscita viene pubblicato tramite Dataset Publication API v2 come table.generic in formato CSV, con metadati e descrittori delle variabili. La scelta del formato permette di consultare facilmente le misure sia con gli strumenti del framework sia con altri programmi scientifici.
Come adattarlo ad altre TLC
Gli elementi che un utente può modificare sono pochi e hanno un significato chiaro:
BASELINE_LABEL: il nome della curva che identifica la linea di deposizione, normalmenteBASELINE.FRONT_LABEL: il nome del fronte del solvente, normalmenteSOLVENT_FRONT.SPOT_LABEL_PATTERN: la convenzione per riconoscere le regioni delle macchie, ad esempioSPOT_L01_S01_TYROSINE. La letteraLindica la corsia eSil numero della macchia nella corsia.RESULT_VERSION: il suffisso dell’output (v2,v3e così via). Cambiandolo è possibile pubblicare una nuova analisi senza sovrascrivere un risultato precedente.- I controlli sui poligoni, compresa la soglia massima di apertura e il limite di righe leggibili, possono essere adeguati a esperimenti di dimensioni differenti, mantenendo le verifiche di coerenza.
Il numero di corsie e di macchie non è fissato nel programma: possono essere presenti più macchie nella stessa corsia, come accade nel nostro campione misto. Sono invece necessarie le due curve di riferimento e una nomenclatura coerente con quella riconosciuta dallo script. I punti di un contorno devono appartenere alla stessa regione ed essere ordinati lungo il suo bordo.
L’analisi va sempre controllata scientificamente. Uno script generico può elaborare correttamente i dati di ingresso, ma non può garantire che un pennarello abbia delimitato il vero segnale cromatografico o che i riferimenti siano stati interpretati senza ambiguità.
I risultati dell’esperimento
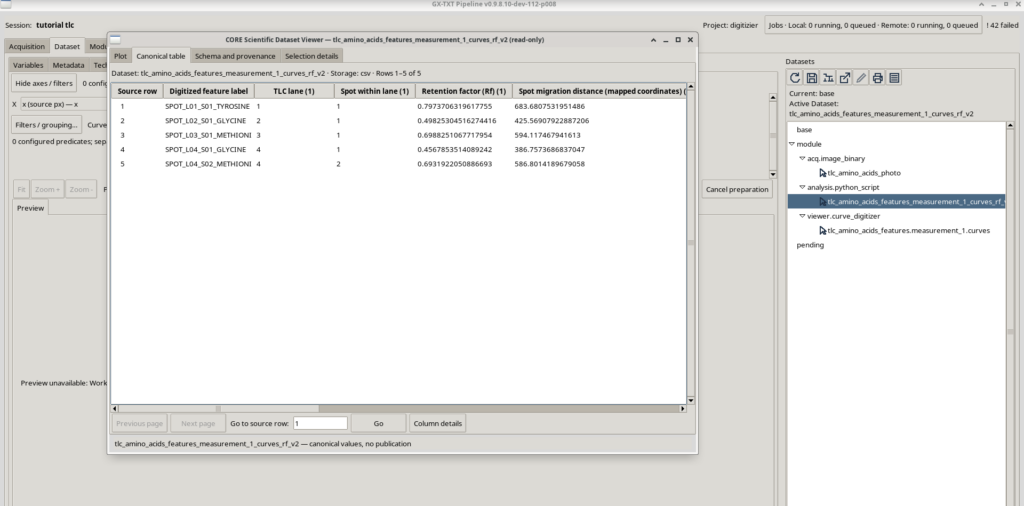
L’esecuzione ha prodotto una tabella canonica con cinque righe e dodici colonne, comprendente il nome della regione, la corsia, il numero della macchia, il centroide, le distanze geometriche, l’area e il perimetro della regione annotata e il fattore \( R_f \).
| Corsia e regione | \( R_f \) |
|---|---|
| 1 — tirosina | 0,797371 |
| 2 — glicina | 0,498253 |
| 3 — metionina | 0,698825 |
| 4 — glicina, macchia inferiore | 0,456785 |
| 4 — metionina, macchia superiore | 0,693192 |
I valori provengono dal Dataset realmente pubblicato da GX-TXT, non da una tabella ricostruita per la guida.
La metionina presenta valori particolarmente vicini nelle corsie 3 e 4 (circa 0,699 e 0,693). I due valori associati alla glicina sono meno concordi (circa 0,498 e 0,457). Questo confronto mostra l’utilità delle misure, ma non costituisce una validazione analitica della composizione del campione. Influiscono la posizione dei contorni marcati, la determinazione del centroide, la calibrazione e la scelta del fronte del solvente.
Rappresentare i risultati in un grafico
Non è necessario scrivere altro codice Python per visualizzare i fattori di ritenzione. Il CORE Scientific Dataset Viewer permette di scegliere esplicitamente le variabili del Dataset scientifico.
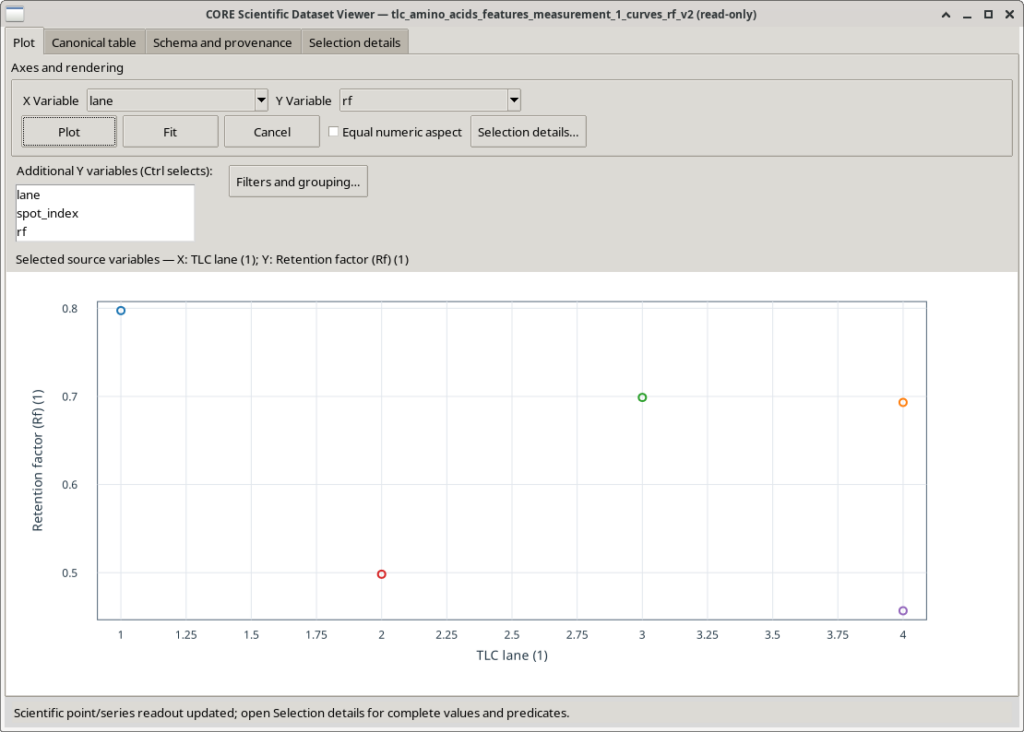
Dopo aver aperto il Dataset, nella scheda Plot abbiamo impostato X Variable = lane e Y Variable = rf. Attraverso Filters and grouping… abbiamo separato le serie usando feature_name, mantenendo le macchie come punti indipendenti, anziché unirle con una linea continua.
Il diagramma mostra quindi cinque punti distribuiti su quattro corsie: nella corsia 4 compaiono i due valori della miscela. È una rappresentazione sintetica che permette di confrontare immediatamente la mobilità relativa attribuita agli standard e al campione.
Poiché il Dataset contiene più variabili numeriche e una colonna testuale, la Preview incorporata nella finestra principale non seleziona necessariamente gli assi in modo automatico. L’apertura del Dataset Viewer consente invece di impostarli correttamente e di consultare anche la tabella e lo schema delle variabili.
Risultati, metadati e note metodologiche
La tabella numerica è un Dataset table.generic con metadati scientifici strutturati: origine delle misure, metodo di calcolo, coordinate e limitazioni dichiarate. Le osservazioni più discorsive possono essere conservate in un documento Markdown separato.
Per rendere disponibili anche le note nell’ambiente GX-TXT abbiamo utilizzato un secondo script opzionale, tlc_rf_notes_group_bridge.py: seleziona tramite l’alias primary il Dataset dei risultati \( R_f \), pubblica un documento Markdown di accompagnamento e crea un Dataset Group che contiene entrambi. La tabella rimane il componente principale del gruppo e non viene modificata.
#!/usr/bin/env python3
# SPDX-License-Identifier: GPL-3.0-or-later
"""Optional Script Bridge compatibility: TLC result + Markdown Dataset Group.

Select the already published table.generic Rf results as input alias primary.
The existing numeric Dataset is never rewritten. A new supporting Markdown
Dataset is published with the public file publication API, and both Dataset
IDs are linked by the public producer-scoped Dataset Group API. This is not
a substitute for native Dataset Notes and is explicitly labelled as such.
"""

from __future__ import annotations

import hashlib
from pathlib import Path
import re

from gxtxt import gxtxt_api_call, gxtxt_api_require, gxtxt_context

SOURCE_ALIAS = "primary"
VERSION = "v1"


def call(api_id, operation, args):
    return gxtxt_api_call(api_id, operation, args)


def source_from_context(ctx):
    ds = str((ctx.get("inputs", {}).get(SOURCE_ALIAS, {}) or {})
             .get("dataset_id", "")).strip()
    if not re.fullmatch(r"[A-Za-z][A-Za-z0-9_.-]{0,255}", ds):
        raise RuntimeError("Select a canonical TLC results Dataset as primary")
    return ds


def output_ids(ds):
    stem = re.sub(r"[^A-Za-z0-9_.-]", "_", ds)
    if len(stem) > 185:
        stem = stem[:168].rstrip("_.-") + "_" + hashlib.sha256(
            ds.encode("utf-8")).hexdigest()[:12]
    return stem + "_method_notes_" + VERSION, stem + "_with_notes_" + VERSION


def flatten(block, var_id):
    src = block[var_id]["values"]
    if hasattr(src, "reshape"):
        return src.reshape(-1).tolist()
    out = []
    for cell in src:
        if isinstance(cell, (tuple, list)):
            if len(cell) != 1:
                raise ValueError("Expected scalar canonical table variable")
            cell = cell[0]
        out.append(cell)
    return out


def load_table(ds):
    info = call("CANONICAL_DATASET_API_v2", "describe", [ds])
    if info.get("contract") != "table.generic":
        raise RuntimeError("This is not a canonical table.generic Dataset")
    metadata = call("DATASET_METADATA_API_v1", "read", [ds])
    if metadata.get("processing.kind") != "tlc_retention_factor_from_annotated_polygons":
        raise RuntimeError("This Dataset is not a published TLC Rf analysis")
    schema = call("DATASET_VARIABLE_SCHEMA_API_v3", "list", [ds])
    vars_by_id = {str(v["variable_id"]): v for v in schema}
    selected = ("feature_name", "lane", "spot_index", "rf")
    if any(k not in vars_by_id for k in selected):
        raise RuntimeError("Missing TLC source columns: feature_name/lane/spot_index/rf")
    n = int(info.get("row_count", 0))
    if not 1 <= n <= 10000:
        raise RuntimeError("Invalid TLC row count")
    records = []
    for start in range(0, n, 400):
        width = min(400, n-start)
        batch = call("CANONICAL_DATASET_API_v2", "read_range",
                     [ds, list(selected), start, width])
        columns = {k: flatten(batch, k) for k in selected}
        if any(len(v) != width for v in columns.values()):
            raise RuntimeError("Incomplete canonical TLC table")
        for j in range(width):
            records.append({k: columns[k][j] for k in selected})
    return metadata, records


def build_markdown(ds, metadata, records):
    lines = [
        "# TLC — retention factors and methodological notes",
        "",
        "## Origin and interpretation",
        "",
        "Result table: " + ds,
        "",
        "Regions were traced following the hand-drawn marker outlines placed",
        "by a chemist around spots on the source photograph. They are annotated",
        "regions of interest, not objectively segmented color boundaries.",
        "Chemical labels are those supplied by the source, not independently",
        "verified analyte identities.",
        "",
        "## Retention factors",
        "",
        "| Spot label | Lane | Spot | Rf |",
        "| --- | ---: | ---: | ---: |",
    ]
    for r in records:
        label = str(r["feature_name"]).replace("|", "/").replace("\n", " ")
        lines.append("| " + label + " | " + str(int(r["lane"])) + " | " +
                     str(int(r["spot_index"])) + " | " +
                     format(float(r["rf"]), ".6f") + " |")
    lines.extend([
        "",
        "## Method",
        "",
        "Rf is the ratio of the annotated polygon-centroid migration distance",
        "to the solvent-front migration distance. Both were calculated in the",
        "same projectively rectified coordinate system with the original",
        "baseline and solvent-front lines.",
        "",
        "Rf is dimensionless. These mapped coordinates do not establish an",
        "absolute or independently certified physical length scale.",
        "",
        "## Structured provenance",
        "",
    ])
    for k in (
        "processing.input_dataset_id",
        "processing.input_coordinate_unit",
        "processing.method",
        "processing.geometry",
        "processing.rf_method",
        "processing.uncertainty",
    ):
        if k in metadata:
            lines.append("- " + k + ": " + str(metadata[k]))
    lines.extend([
        "",
        "## Limitations",
        "",
        "- The upper marked line is assumed to be the solvent front.",
        "- Spot outline interpretation is operator-dependent.",
        "- Faint stains, notably the first lane, are less reliable.",
        "- Identity and concentration are not proven by photographic Rf alone.",
        "- Lens distortion and plate nonplanarity are not independently corrected.",
        "- Measurement uncertainties and propagated Rf uncertainty are not quantified.",
        "",
        "## Framework version note",
        "",
        "At the time of this tutorial the GX-TXT Script Bridge did not expose",
        "the direct Dataset Notes association API. This note was therefore",
        "published as a separate canonical Markdown Dataset and grouped with",
        "the numerical results. Native Script Bridge integration of Dataset",
        "Notes is planned for the final framework; actual availability",
        "depends on the version installed by the reader.",
        "",
    ])
    return "\n".join(lines)


def main():
    for required in (
        "CANONICAL_DATASET_API_v2@2",
        "DATASET_METADATA_API_v1@1",
        "DATASET_VARIABLE_SCHEMA_API_v3@3",
        "DATASET_FILE_PUBLICATION_API_v1@1",
        "DATASET_GROUP_API_v1@1",
    ):
        gxtxt_api_require(required)
    context = gxtxt_context()
    numeric_id = source_from_context(context)
    metadata, rows = load_table(numeric_id)
    note_id, group_id = output_ids(numeric_id)

    existing = call("DATASET_GROUP_API_v1", "list", [])
    for group in existing:
        if group.get("group_id") == group_id:
            raise RuntimeError("This group already exists; do not re-run")
        if any(m.get("dataset_id") == numeric_id for m in group.get("members", [])):
            raise RuntimeError("Numeric Dataset is already in another group")

    output_dir = Path(context["output_dir"]).resolve()
    output_dir.mkdir(parents=True, exist_ok=True)
    file = output_dir / "tlc_rf_group_notes.md"
    file.write_text(build_markdown(numeric_id, metadata, rows), encoding="utf-8")

    file_result = call("DATASET_FILE_PUBLICATION_API_v1", "publish", [{
        "dataset_id": note_id,
        "contract": "document.text",
        "format": "md",
        "source_file": str(file),
        "storage_kind": "text",
        "media_type": "text/markdown",
        "producer_version": "1.0.0",
        "replace_owned": False,
        "source_dataset_ids": [numeric_id],
        "source": "GX-TXT TLC tutorial Python Script Bridge",
        "provenance": "Interpretation of chemist-annotated TLC Rf results",
        "structured_metadata": {
            "documentation.kind": "tlc_method_notes",
            "documentation.for_dataset_id": numeric_id,
            "documentation.association": "dataset_group_compatibility",
            "documentation.direct_dataset_notes_script_api": "not_available_at_tutorial_time",
        },
    }])
    print("TLC_NOTES_DATASET_PUBLISHED", file_result, flush=True)

    definition = {
        "group_id": group_id,
        "display_name": "TLC Rf results and methodological notes",
        "group_contract": "scientific.tlc_rf_results",
        "primary_dataset_id": numeric_id,
        "members": [
            {"dataset_id": numeric_id, "role": "primary.result_table",
             "required": True, "contract": "table.generic"},
            {"dataset_id": note_id, "role": "supporting.method_notes",
             "required": False, "contract": "document.text"},
        ],
    }
    # Review pins actual Session, ownership, Namespace and opaque revisions.
    review = call("DATASET_GROUP_API_v1", "review", [[numeric_id, note_id]])
    receipt = call("DATASET_GROUP_API_v1", "create", [definition, review])
    print("TLC_GROUP_CREATED", receipt, flush=True)


if __name__ == "__main__":
    main()
# TLC retention factor — scientific notes

## Provenance

Source Dataset: tlc_amino_acids_features.measurement_1.curves

Result Dataset: tlc_amino_acids_features_measurement_1_curves_rf_v2

Original Curve Digitalizer rows: 1866

Coordinate unit in source: px

The spot regions were **drawn in marker by a chemist** on the original photograph. We digitized those annotations, not automatically segmented chemical stain boundaries. Chemical names are source labels, not independently verified identities.

## Method

Each annotated contour was treated as a polygon. Its shoelace centroid was projected onto the migration direction, defined as the normal to BASELINE. The solvent front was evaluated at the same baseline-tangent coordinate. Rf equals spot migration distance divided by solvent-front migration distance.

Values are dimensionless; source coordinate units describe a projectively mapped plate, **not a certified physical mm scale**.

## Measured spots

| Source curve name | Lane | Spot | Rf |
|---|---:|---:|---:|
| SPOT_L01_S01_TYROSINE | 1 | 1 | 0.797371 |
| SPOT_L02_S01_GLYCINE | 2 | 1 | 0.498253 |
| SPOT_L03_S01_METHIONINE | 3 | 1 | 0.698825 |
| SPOT_L04_S01_GLYCINE | 4 | 1 | 0.456785 |
| SPOT_L04_S02_METHIONINE | 4 | 2 | 0.693192 |

## Producer semantic role mappings

Resolved from the source's Curve Digitalizer metadata and the public Variable Schema API, not from hardcoded CSV column headers.

- curve_key: curve_id
- curve_name: curve_label
- point_order: point_index
- x: x
- y: y

## Limitations

- The upper reference line is presumed to be the solvent front; its identity requires experimental confirmation.
- A manually drawn perimeter may not coincide exactly with the stain.
- The faint tyrosine region is especially sensitive to operator annotation.
- Rf alone cannot establish chemical identity or concentration.
- Lens distortion and nonplanarity are not corrected by a projective mapping.
- Source-coordinate uncertainties and propagated Rf uncertainties have not been quantified.

This note can be associated via the GX-TXT Dataset Notes editor. It is not a second scientific Dataset.
Nella versione di GX-TXT impiegata per questo esperimento, gli script Python non disponevano ancora dell’associazione diretta delle note Markdown ai Dataset. Abbiamo quindi utilizzato un Dataset Group per riunire risultati e documentazione. L’integrazione diretta è prevista nella versione definitiva del framework; chi segue la guida potrà verificare la modalità disponibile nella propria installazione.
Chi preferisce una procedura più semplice può scaricare il documento Markdown dall’articolo e consultarlo separatamente, senza utilizzare il secondo script: il calcolo di \( R_f \) non dipende dalle note.
Cosa abbiamo ottenuto e cosa resta da verificare
L’esperimento ha mostrato una procedura completa: fotografia reale, calibrazione prospettica della lastrina, digitalizzazione di sette curve, pubblicazione delle coordinate, analisi mediante Python, pubblicazione di una tabella di risultati e visualizzazione con gli strumenti grafici di GX-TXT.
Il dato più interessante non è soltanto il numero finale \( R_f \), ma la tracciabilità dell’elaborazione: la tabella deriva da regioni annotate, conserva il collegamento alle curve di origine ed è riproducibile da chi dispone della fotografia, di GX-TXT e degli script. Separare i dati numerici dai commenti scientifici rende inoltre più semplice riutilizzare i risultati in analisi successive.
È fondamentale conservare i limiti dell’esempio: le delimitazioni provengono dal pennarello del chimico, la macchia della tirosina è poco contrastata, il fronte del solvente va interpretato in base alla fonte e le incertezze non sono state quantificate. La vicinanza di due valori \( R_f \) suggerisce una coerenza geometrica, non prova da sola l’identità di una sostanza.
Per proseguire si potrebbe confrontare la posizione dei centroidi con quella individuata tramite segmentazione cromatica, ripetere indipendentemente la digitalizzazione o introdurre un modello di incertezza per la posizione della baseline, del fronte e dei contorni. Sarebbe un naturale sviluppo dell’esperimento, senza dover cambiare il principio fondamentale: partire da una misura verificabile e documentare ciò che il dato permette realmente di concludere.
Fonte e licenza della fotografia: Amino acids TLC with English translation, Dvnyn, adattamento da TheFatDrummer, Wikimedia Commons, CC BY-SA 4.0. Nell’articolo si utilizza un ritaglio della parte fotografica del documento originale.