

Lezione 16 – Dal segnale UV-Vis alla costante cinetica: un progetto scientifico completo con GNU Octave e GX-TXT
Nelle lezioni precedenti abbiamo imparato a rappresentare dati, risolvere sistemi lineari, eseguire regressioni, integrare equazioni differenziali e pubblicare Dataset. Ora riuniamo queste tecniche in un esperimento: osserviamo una trasformazione chimica mediante spettrofotometria UV-Vis a due lunghezze d’onda, ricostruiamo le concentrazioni delle specie e verifichiamo la legge cinetica. L’intero percorso si svolge in una Session GX-TXT utilizzando GNU Octave e le API pubbliche del framework.
Versione di riferimento: GX-TXT 0.9.8.10-dev-112 Release 2 P009 — release ufficiale GitHub, sorgenti al commit 059ff073eb43770292b6609f7c0cc3cbc811710d. Gli script sono distribuiti con licenza GPL-3.0-or-later; tutti i commenti nel codice sono in inglese.
Natura dei dati. Le assorbanze di questa lezione sono sintetiche e deterministiche: simulano un esperimento coerente con la legge di Beer-Lambert, aggiungendo piccole perturbazioni definite matematicamente. Non sono misure di laboratorio né una validazione sperimentale di un meccanismo chimico.
Cosa impareremo
Al termine saremo in grado di collegare misure, modello fisico e risultati persistenti. Riprenderemo l’organizzazione di un programma in fasi, la forma matriciale di un modello di misura, la soluzione di più sistemi con una sola chiamata, il fitting con controllo dei residui, l’integrazione con ode45, il debugger nativo e la conservazione dei risultati scientifici come Dataset e Plot Dataset.
Collegamento con il percorso: che cosa cambia nella Lezione 16
Le Lezioni 10–15 hanno già spiegato i singoli strumenti. Qui impariamo soprattutto a farli collaborare senza perdere il significato fisico dei dati.
| Conoscenza già acquisita | Utilizzo nuovo nel progetto finale |
|---|---|
| Lezione 10 — regressione e residui | Stimare un parametro cinetico a partire da concentrazioni che prima devono essere ricavate da segnali ottici |
| Lezione 11 — calcolo numerico su serie temporali | Mantenere allineate le osservazioni e controllare le unità durante più elaborazioni successive |
| Lezione 12 — rango, condizionamento e soluzione di matrici | Risolvere 31 sistemi con la stessa matrice, usando 31 colonne di termini noti in una singola operazione |
| Lezione 13 — rappresentazione e campionamento dei segnali | Trattare due canali strumentali come misure sincronizzate dello stesso fenomeno |
Lezione 14 — funzioni anonime, ode45 e conservazione | Alimentare un modello dinamico con parametri stimati, invece di fissarli tutti prima della simulazione |
| Lezione 15 — controlli fisici, unità e verifiche indipendenti | Organizzare verifiche prima, durante e dopo l’elaborazione, fino alla pubblicazione dei risultati |
È anche un esercizio di progettazione del software: passeremo da programmi che eseguono un calcolo a un flusso di lavoro con precondizioni, postcondizioni e risorse scientifiche persistenti.
1. Il problema scientifico: seguire una reazione A → B
Consideriamo una reazione irreversibile del primo ordine:
\[
A \xrightarrow{k} B,\qquad
\frac{d[A]}{dt}=-k[A],\qquad
\frac{d[B]}{dt}=k[A].
\]
Partendo da \([A]_0=2{,}0\ \mathrm{mmol/L}\) e \([B]_0=0\), con una costante cinetica di riferimento \(k=0{,}045\ \mathrm{min}^{-1}\), la soluzione esatta è
\[
[A](t)=[A]_0e^{-kt}, \qquad [B](t)=[A]_0-[A](t).
\]
La somma \([A](t)+[B](t)\) resta costante per conservazione della materia. Registriamo 31 istanti, da 0 a 60 minuti a intervalli di 2 minuti. In questa lezione non utilizziamo la costante impiegata per generare i dati durante la regressione: la stimiamo dalle assorbanze, per poi confrontarla con il valore noto.
Perché due lunghezze d’onda?
Una singola assorbanza è la somma dei contributi delle specie presenti. Se entrambe assorbono, non possiamo ricavare separatamente le due concentrazioni da una sola osservazione. Con misure a 430 nm e 520 nm otteniamo invece due equazioni indipendenti.
Per un cammino ottico \(\ell=1\ \mathrm{cm}\) imponiamo la matrice delle assorbività molari
\[
E=\begin{bmatrix}0{,}75&0{,}20\\0{,}12&0{,}62\end{bmatrix}
\quad\mathrm{L/(mmol\cdot cm)}.
\]
La legge di Beer-Lambert diventa
Le righe rappresentano le lunghezze d’onda, le colonne le specie chimiche; mantenere quest’ordine è fondamentale. Le assorbanze sono adimensionali (unità dichiarata 1). L’esperimento funziona perché la matrice è di rango 2 e permette di distinguere le specie.
Il concetto scientifico nuovo: un problema inverso dipendente dal tempo
Lo strumento misura due assorbanze; le concentrazioni di A e B non sono osservate direttamente. Ricostruirle significa risolvere un problema inverso: partire dagli effetti misurabili per risalire alle grandezze che li hanno prodotti. La stessa relazione di Beer-Lambert, usata in avanti, permette poi di ricostruire le assorbanze e controllare il risultato.
Se indichiamo con \(Y\) i segnali, con \(C\) le concentrazioni e con \(\Delta Y\) le piccole perturbazioni, il modello generativo è
\[
Y=(\ell E)C+\Delta Y.
\]
Per ricavare \(C\), il programma utilizza \(\ell E\) e i valori di \(Y\); non legge le concentrazioni di riferimento come input della soluzione inversa. I Dataset reference sono disponibili soltanto per il confronto con la soluzione ottenuta. In questo esperimento assumiamo note le assorbività delle due specie e il cammino ottico; non stimiamo tali coefficienti, né la loro incertezza.
Una difficoltà specifica compare perché la misura è una serie temporale multicanale: tutte le colonne devono riferirsi agli stessi istanti. Due vettori contenenti 31 valori non sono necessariamente sincronizzati. Per questo il terzo script verifica anche l’uguaglianza delle coordinate temporali, non soltanto il numero di osservazioni.
2. Preparare il primo script: vettori, matrici e Dataset
Il programma L16_00_Prepare_UVVis_Kinetics.m costruisce il vettore dei tempi con (0:2:60)'; l’apostrofo crea un vettore colonna. Le concentrazioni di riferimento si ottengono usando exp e la moltiplicazione elemento per elemento .*. Con il punto davanti all’operatore chiediamo a Octave di elaborare ogni campione separatamente, non di effettuare una moltiplicazione matriciale.
Il programma calcola quindi le due assorbanze e aggiunge piccoli termini sinusoidali riproducibili. Queste perturbazioni simulano le imperfezioni di un segnale, ma non rappresentano un modello statistico con incertezza strumentale stimata.
Ogni serie viene associata a una definizione esplicita della variabile orizzontale time_min, a un variable_id per la variabile misurata, alle unità, alla provenienza sintetica e a metadati scientifici. Lo script pubblica in una sola operazione cinque Dataset:
| Dataset | Significato |
|---|---|
lesson16_uvvis_430nm | Assorbanza sintetica a 430 nm |
lesson16_uvvis_520nm | Assorbanza sintetica a 520 nm |
lesson16_reference_A | Concentrazione analitica di A |
lesson16_reference_B | Concentrazione analitica di B |
lesson16_reference_total | Somma teorica conservata |
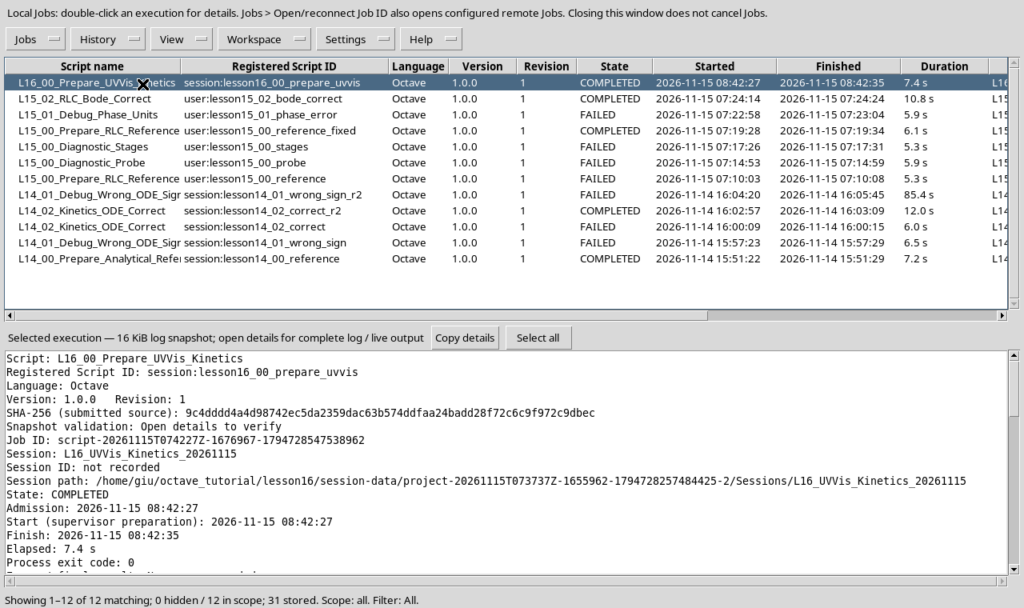
Quando la pubblicazione termina, lo script usa read_range per leggere nuovamente i cinque Dataset e confrontarli con le serie originali. Il risultato non è solo un messaggio numerico: le risorse restano collegate alla Session e consultabili dai Viewer GX-TXT.
3. Imparare a ragionare con le dimensioni delle matrici
Nel programma finale, le assorbanze vengono organizzate in una matrice \(\mathbf{Y}\) di dimensioni \(2\times31\). Ogni riga corrisponde a una lunghezza d’onda; ogni colonna a un istante di misura.
\[
E\ (2\times2)\ \cdot\ C\ (2\times31)=Y\ (2\times31).
\]
L’obiettivo è determinare \(C\), dove la prima riga contiene le concentrazioni di A e la seconda quelle di B. GNU Octave distingue la trasposizione semplice .' dalla trasposizione coniugata ': con dati reali coincidono, ma su matrici complesse il risultato sarebbe differente. Qui [abs430.'; abs520.'] trasforma due colonne da 31 osservazioni nella matrice \(2\times31\) richiesta dal problema.
Non calcoliamo esplicitamente l’inversa di \(E\). Attraverso NUMERIC_API_v1/linear_matrix chiediamo al CORE di controllarne rango e condizionamento e poi di risolvere il sistema con più termini noti. Una sola chiamata elabora quindi tutte le 31 osservazioni.
E = [0.75, 0.20; 0.12, 0.62];
Y = [abs430.'; abs520.'];
envelope_E = struct('real', E, 'imaginary', zeros(size(E)));
envelope_Y = struct('real', Y, 'imaginary', zeros(size(Y)));

check = gxtxt_api_call('NUMERIC_API_v1', 'linear_matrix', ...
  {'inspect', envelope_E, []});
solution = gxtxt_api_call('NUMERIC_API_v1', 'linear_matrix', ...
  {'solve', envelope_E, envelope_Y});
recovered_A = solution.value_real(1,:).';
recovered_B = solution.value_real(2,:).';
L’envelope real/imaginary è il formato dichiarato dal contratto pubblico per il trasporto di matrici attraverso lo Script Bridge. Non serve conoscere la rappresentazione interna del CORE. Il risultato è ricondotto a normali array Octave.
Programmazione Octave: cell array, strutture e campi dinamici
Le lezioni precedenti hanno introdotto vettori, struct e cell array singolarmente. Il passo ulteriore è usarli insieme per gestire un insieme di Dataset senza duplicare il codice di lettura. Nel terzo script troviamo lo schema seguente (estratto con le variabili già dichiarate):
source_values = cell(1,numel(source_ids));
for j = 1:numel(source_ids)
  node = gxtxt_api_call(dataset_api,'read_range', ...
    {source_ids{j},{'time_min',source_y_ids{j}},0,n});
  source_values{j} = node.(source_y_ids{j}).values(:);
endfor
È importante comprendere precisamente la sintassi:
| Istruzione Octave | Significato |
|---|---|
cell(1,numel(source_ids)) | Prealloca una cell array con una cella per ogni Dataset |
source_ids{j} | Estrae il contenuto della cella j, qui una stringa; source_ids(j) restituirebbe invece una cell array |
node.(source_y_ids{j}) | Accede a un campo dinamico della struttura, usando il Variable ID letto dalla cella |
.values(:) | Estrae i valori e li normalizza in un vettore colonna, qualunque fosse l’orientamento iniziale |
[abs430.'; abs520.'] | Trasforma due vettori colonna in due righe e le concatena verticalmente |
result.value_real(1,:).' | Seleziona la prima riga della soluzione e la riporta a vettore colonna |
Il programma costruisce anche tabelle di configurazione sotto forma di cell array bidimensionali: required{j,1} è il nome di un’API, mentre required{j,2} identifica l’operazione da controllare; rows(required) fornisce il numero delle righe da percorrere. Lo stesso schema è impiegato per definire i cinque grafici in plot_defs, separando i dati delle specifiche grafiche dal ciclo che le crea.
Un dettaglio più avanzato riguarda il batch di pubblicazione:
publish = gxtxt_api_call(publication_api,'publish_series_batch', ...
  {struct('series',{derived})});
Qui derived è una cell array di sette specifiche. Le parentesi graffe interne {derived} fanno sì che il campo series contenga l’intera raccolta, invece di costruire una struttura per ciascuna cella; quelle esterne racchiudono l’argomento posizionale della chiamata pubblica. Capire questo livello di annidamento è essenziale quando si passano strutture complesse attraverso lo Script Bridge.
4. Debugger: l’errore scientifico delle lunghezze d’onda invertite
Lo script L16_01_Debug_Swapped_Wavelengths.m contiene deliberatamente una riga sbagliata:
wrong_absorbances = [A520.'; A430.'];L’algoritmo è matematicamente eseguibile, ma i dati vengono associati alle righe sbagliate di \(E\): una risposta a 520 nm viene interpretata come se fosse a 430 nm, e viceversa. Il programma produce così concentrazioni impossibili, anche negative. È un esempio concreto del perché un Job eseguito senza errori sintattici non costituisca automaticamente un risultato scientificamente valido.
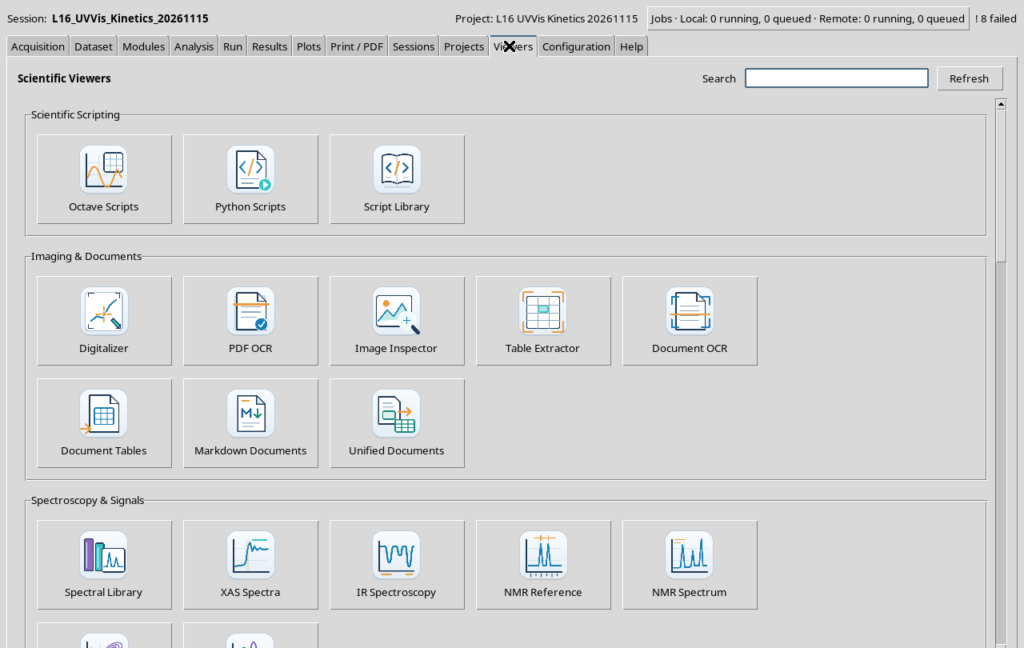
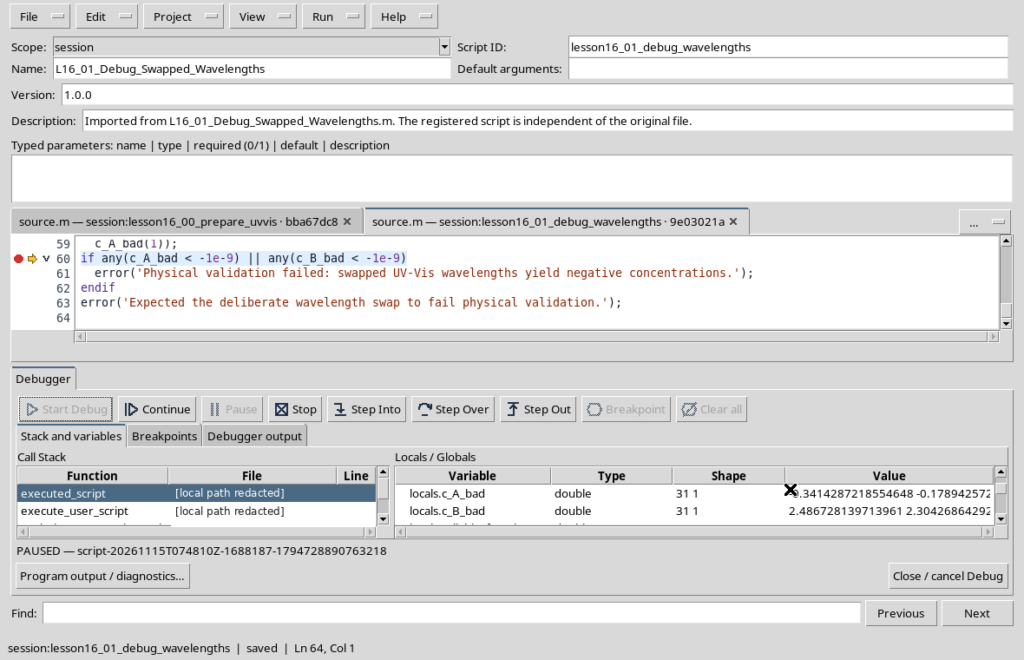
Nel Viewer Octave Scripts, apriamo Run → Debug Session script, scegliamo lo script, inseriamo un breakpoint alla riga 60 e avviamo il debugger. A quel punto ispezioniamo c_A_bad e c_B_bad, oltre alla matrice wrong_absorbances. La concentrazione iniziale di A ricostruita in modo errato è circa −0,3414 mmol/L, mentre quella di B supera 2,48 mmol/L: violano le condizioni fisiche del modello scelto.
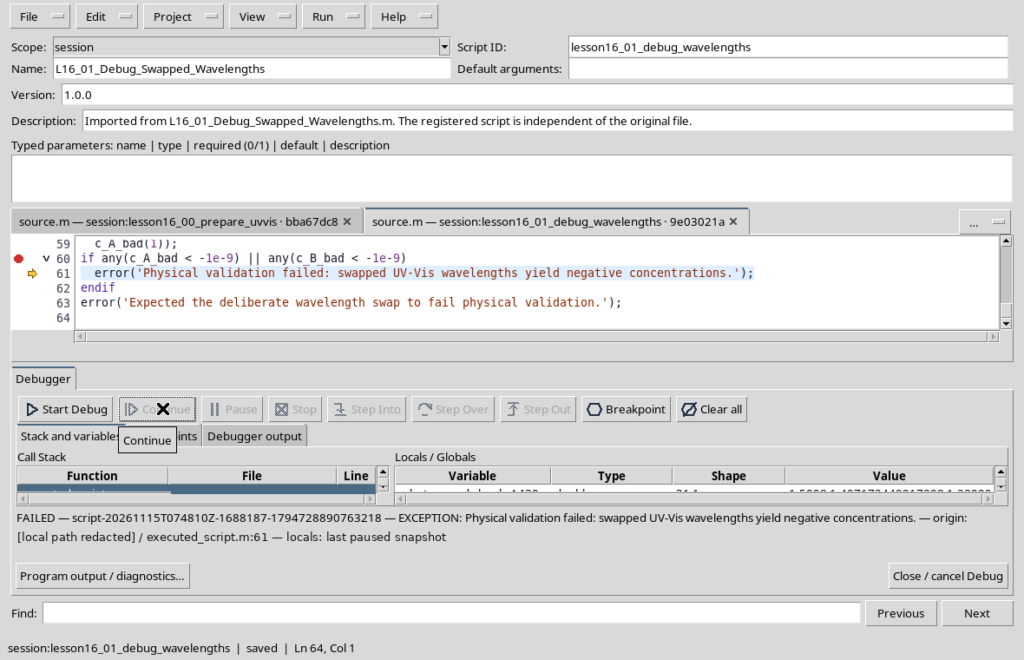
Con Continue il controllo delle concentrazioni provoca il fallimento intenzionale del Job. È il comportamento corretto: non vengono pubblicati Dataset derivati da un’assegnazione strumentale incoerente.
5. Stimare la costante cinetica con una regressione
Dopo aver ricostruito correttamente le concentrazioni, possiamo testare la cinetica del primo ordine. Applicando il logaritmo naturale:
\[
\ln[A](t)=\ln[A]_0-kt.
\]
Il grafico di \(\ln[A]\) contro \(t\) dovrebbe essere approssimativamente lineare. La sua pendenza è \(-k\), mentre l’intercetta stima \(\ln[A]_0\). Utilizziamo la regressione lineare pubblica di GX-TXT:
fit = gxtxt_api_call('NUMERIC_API_v1', 'linear_regression', ...
  {time_min, log(recovered_A), [], struct('intercept', true)});
k_estimated = -fit.slope;
A0_estimated = exp(fit.intercept);
R2 = fit.r_squared;
Il vettore vuoto [] occupa la posizione dei pesi: stiamo eseguendo una regressione ordinaria non pesata. struct('intercept',true) richiede di stimare anche l’intercetta. Octave fornisce log ed exp; la stima dei coefficienti è svolta dall’API numerica pubblica.
La trasformazione logaritmica cambia il significato delle deviazioni: un rumore additivo nello spazio delle assorbanze non diventa automaticamente un errore omoscedastico in \(\ln[A]\). Per questo motivo consideriamo qui la regressione uno strumento didattico e riportiamo esplicitamente tale limite, senza attribuire intervalli di confidenza non calcolati.
Una distinzione nuova: errore di misura, errore di stima, errore del modello
In questa catena di calcolo compaiono tre confronti diversi, da non confondere:
- Le perturbazioni sono aggiunte alle assorbanze \(A_{430}\) e \(A_{520}\): appartengono allo spazio dei segnali.
- La regressione minimizza le deviazioni di \(\ln[A]\) da una retta: il coefficiente \(R^2\) si riferisce allo spazio logaritmico della concentrazione.
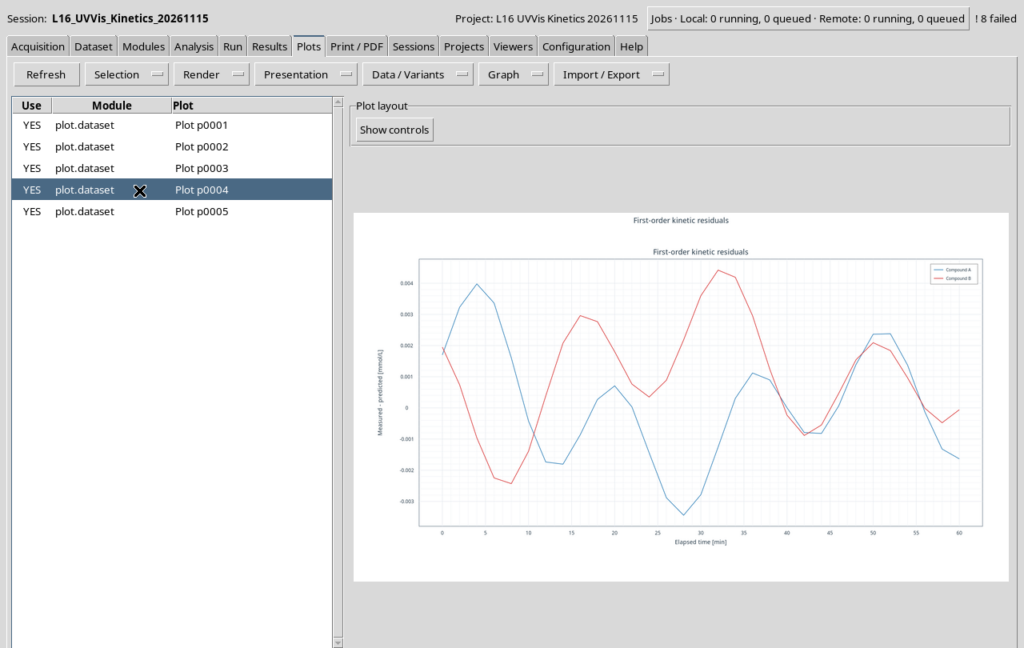
- I residui finali confrontano concentrazioni ricostruite e previste dall’ODE: il loro RMS è espresso in mmol/L.
Un valore \(R^2\) molto vicino a 1 non garantisce, da solo, che il bilancio di materia sia rispettato o che le due assorbanze siano state assegnate alla lunghezza d’onda corretta. I tre controlli rispondono a domande differenti.
La regressione stima sia \(\hat{k}\) sia \(\widehat{[A]_0}\); la condizione iniziale \([B]_0=0\) è invece imposta dal modello scelto, non stimata da un ulteriore fitting. Il valore di riferimento 0.045 compare nella generazione e nel confronto finale dei dati sintetici, non come parametro fornito alla regressione. In una misura reale, il valore vero di \(k\) sarebbe normalmente ignoto e occorrerebbe un’analisi dell’incertezza e dell’adeguatezza del modello.
6. Integrare le equazioni differenziali con ode45
Riprendiamo la Lezione 14. Usando i parametri ricavati dalla regressione, definiamo una funzione anonima in Octave:
rhs = @(t, y) [-k_estimated*y(1); k_estimated*y(1)];
options = odeset('RelTol',1e-10,'AbsTol',1e-11);
[t_model, state_model] = ode45(rhs, time_min, ...
  [A0_estimated; 0], options);
Il vettore y contiene \([A]\) e \([B]\). La funzione rhs restituisce le due derivate nel medesimo ordine. ode45 è una funzione nativa GNU Octave, non un’API GX-TXT: l’integrazione numerica viene insegnata come parte del linguaggio. Il framework gestisce, tramite le proprie API, l’ingresso dei Dataset e la persistenza dei risultati.
Il programma confronta la soluzione numerica per A con la formula esatta \(A_0e^{-kt}\) e controlla che \(A+B\) rimanga costante. Questo doppio controllo individua errori nel modello differenziale, nelle condizioni iniziali e nell’allineamento degli array.
7. Verificare modello, residui e conservazione della materia
Non basta ottenere una curva sovrapposta a quella osservata. Il programma verifica separatamente la qualità della ricostruzione e la coerenza delle equazioni:
- Positività: le concentrazioni di A devono essere positive per poter applicare il logaritmo.
- Rango: la matrice delle assorbività deve permettere di separare le due specie.
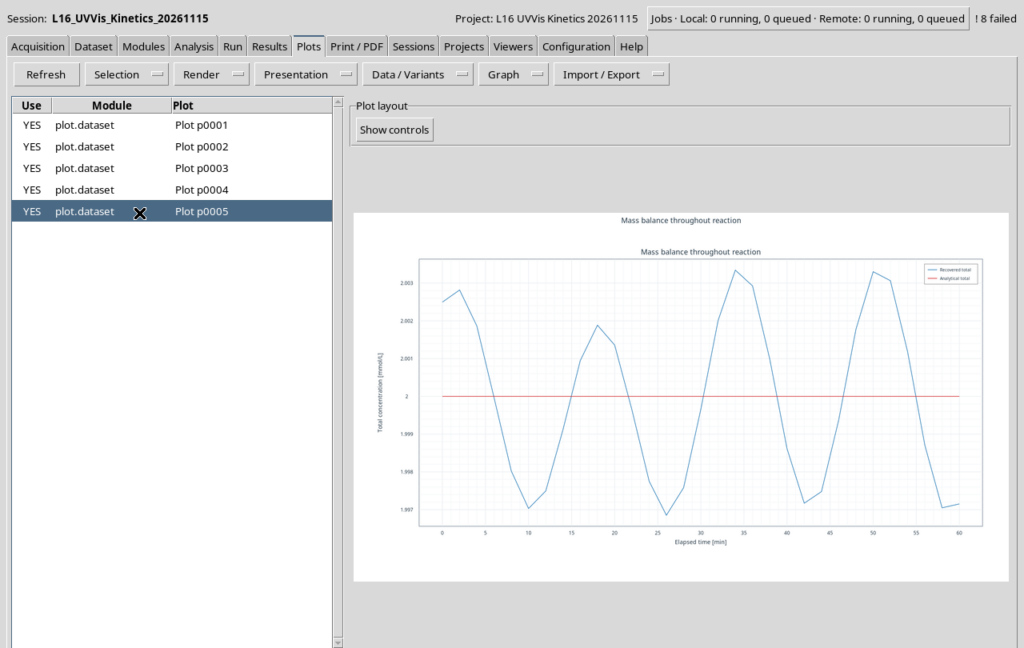
- Conservazione: \([A]_{\mathrm{rec}}+[B]_{\mathrm{rec}}\) deve restare vicina a \(2\ \mathrm{mmol/L}\).
- Residui: per ciascuna specie calcoliamo differenze osservato–previsto e scarto quadratico medio (RMS).
- Riferimento sintetico: il valore stimato di \(k\) viene confrontato con quello impiegato per produrre i dati.
Per il caso incluso negli script sono stati ottenuti:
| Quantità | Risultato |
|---|---|
| Costante di riferimento \(k\) | \(0,045000\ \mathrm{min}^{-1}\) |
| Costante stimata \(\hat{k}\) | \(0,04495570\ \mathrm{min}^{-1}\) |
| \([A]_0\) stimata | \(1,99884590\ \mathrm{mmol/L}\) |
| Coefficiente \(R^2\) della regressione log-lineare | \(0,99996245\) |
| RMS residui della specie A | \(0,00184381\ \mathrm{mmol/L}\) |
| RMS residui della specie B | \(0,00198044\ \mathrm{mmol/L}\) |
| Massima deviazione dal bilancio totale | \(0,00334298\ \mathrm{mmol/L}\) |
Questi valori sono relativi esclusivamente al modello sintetico scelto, e non possono essere interpretati come accuratezza garantita su dati sperimentali.
Programmazione difensiva: precondizioni, invarianti e postcondizioni
Uno script scientifico affidabile non controlla soltanto l’esistenza dei Dataset. Deve verificare che cosa significa il dato ricevuto e quale forma ha. Il terzo programma applica controlli su più livelli:
| Livello | Controllo effettuato | Conseguenza di un errore |
|---|---|---|
| Ingresso | Dataset e Variable ID presenti; tempo strettamente crescente; assi temporali uguali | Il calcolo viene interrotto prima di combinare serie incompatibili |
| Struttura numerica | Matrice di rango 2, condizionamento accettabile, risposta di dimensioni \(2\times31\) | Non si interpretano componenti o colonne sbagliate |
| Significato fisico | Concentrazioni finite e fisicamente ammissibili, \(\hat{k}>0\), conservazione | Non si trasformano soluzioni matematiche in risultati scientifici non plausibili |
| Modello | Concordanza ODE–soluzione analitica; residui, \(R^2\), scostamento dal riferimento sintetico | Si distinguono errori del calcolo da limiti della ricostruzione |
| Persistenza | Ricevuta di pubblicazione e rilettura dei Dataset attraverso read_range | Si controlla che il risultato registrato corrisponda a quello calcolato |
Ecco un controllo sulle dimensioni presente nello script corretto:
if !isequal(size(result.value_real),[2,n]) || ...
   max(abs(result.value_imaginary(:))) > 1e-12
  error('Unexpected complex concentration result or response dimensions.');
endif
size restituisce le dimensioni dell’array; isequal verifica che siano esattamente quelle attese. (:) permette di controllare tutte le componenti immaginarie come un unico vettore. L’operatore || è un OR con valutazione breve: se il primo controllo segnala un problema, Octave non deve valutare il secondo. Altri costrutti già incontrati nel corso, come numel, any, diff, isfinite, assert ed error, diventano qui parte di una strategia unitaria di validazione.
Le soglie del programma sono criteri didattici, non standard metrologici universali. Per esempio, il limite al numero di condizionamento (< 100), \(R^2>0{,}99\), il limite di \(0{,}02\ \mathrm{mmol/L}\) per alcuni scarti e il confronto di \(\hat{k}\) con il riferimento sintetico servono a verificare questo esempio. Non costituiscono intervalli di confidenza o una propagazione dell’incertezza. Inoltre il controllo numerico della conservazione della soluzione ODE è distinto dal controllo del totale ricostruito dalle misure: il primo verifica il modello, il secondo i dati elaborati.
8. Le API pubbliche GX-TXT: come e perché le utilizziamo
Questa lezione distingue con precisione tra operazioni del linguaggio Octave e servizi scientifici del framework. Tutte le operazioni sui Dataset e sui grafici utilizzano solo API pubbliche, senza aprire file di registri o percorsi di storage del CORE.
| API pubblica | Operazione | Funzione didattica |
|---|---|---|
OCTAVE_SCRIPT_BRIDGE_API_v1 | gxtxt_api_require | Verifica la disponibilità delle API richieste prima dell’elaborazione |
| Script Bridge | gxtxt_api_has_operation | Controlla se il provider espone una singola operazione |
| Script Bridge | gxtxt_api_call | Esegue una chiamata pubblica con argomenti posizionali racchiusi in una cell array |
CANONICAL_DATASET_API_v2 | list | Individua i Dataset identificati da ID logici stabili |
| Canonical Dataset v2 | read_range | Legge Variable ID selezionati con riga iniziale zero-based e numero di righe esplicito |
NUMERIC_API_v1 | linear_matrix('inspect') | Verifica rango e condizionamento della matrice di Beer-Lambert |
| Numeric v1 | linear_matrix('solve') | Risolve il sistema per 31 colonne di dati in un’unica chiamata |
| Numeric v1 | linear_regression | Calcola pendenza, intercetta e \(R^2\) della regressione cinetica |
DATASET_PUBLICATION_API_v2 | publish_series_batch | Pubblica più serie in modo atomico, con unità, metadati e provenienza |
PLOT_DATASET_API_v4 | new_spec, validate_spec | Crea e valida una specifica grafica riferita ai Dataset |
| Plot Dataset v4 | upsert_plot, render, artifacts | Registra, rappresenta e rende rintracciabili i grafici persistenti |
read_range riceve per esempio {'lesson16_uvvis_430nm', {'time_min','absorbance_430_au'},0,31}. Il primo valore è il Dataset ID; la cell array interna elenca i Variable ID; 0 rappresenta la prima riga e 31 il numero di osservazioni. Non passiamo percorsi CSV, riferimenti HDF5 o handle interni. Il Script Bridge traduce la risposta in strutture Octave convenzionali.
Con publish_series_batch forniamo una serie di strutture contenenti dataset_id, x_values, y_values, x_variable, y_variable, unità, origine e structured_metadata. Atomico significa che la pubblicazione dei Dataset di quel batch viene trattata come una singola operazione coerente, anziché creare risultati parziali uno a uno. Il programma controlla la ricevuta e poi legge di nuovo i Dataset pubblicati.
Per i grafici, una curva si identifica attraverso dataset_id, x_variable_id e y_variable_id. Non salviamo PNG generati da Octave al posto dei grafici scientifici: utilizziamo la famiglia nativa Plot Dataset v4, che conserva i riferimenti ai dati.
Architettura dell’esperimento: dal Dataset di ingresso alla prova del risultato
La novità di integrazione con GX-TXT è rendere espliciti i confini tra le fasi del programma:
- Acquisizione logica.
listeread_rangerecuperano serie identificate da Dataset ID e Variable ID, non tramite nomi di file. Il programma verifica l’allineamento temporale e i valori finiti. - Problema inverso.
linear_matrix('inspect')verifica la matrice;linear_matrix('solve')ricostruisce 31 coppie di concentrazioni a partire dalle assorbanze. - Identificazione e previsione.
linear_regressionstima i parametri;ode45di Octave calcola una previsione del modello distinta dalla ricostruzione puntuale delle assorbanze, ma basata sui parametri stimati dalle stesse osservazioni. - Validazione e pubblicazione. Solo dopo i controlli lo script invoca
publish_series_batch. La ricevuta conferma il batch eread_rangeverifica i sette Dataset derivati. - Visualizzazione persistente.
new_spec,validate_spec,upsert_plot,rendereartifactscollegano le curve ai Dataset pubblicati, senza trasformarle in immagini scollegate dai dati.
Il codice distingue anche identificativi, contenuti e provenienza. Per i sette Dataset derivati, source_dataset_ids indica esplicitamente i due Dataset delle assorbanze utilizzati come sorgenti della ricostruzione. structured_metadata conserva, fra le altre informazioni, \(\hat{k}\), \(\widehat{[A]_0}\), \(R^2\) e gli RMS; non è necessario inserire questi numeri nel nome del file o accedere agli archivi interni del CORE.
Un ultimo principio riguarda la ripetibilità controllata: i due script che pubblicano Dataset verificano prima che gli ID da creare non esistano già. Se si riesegue l’esperimento nella stessa Session, si rischia un conflitto di ID; per una ripetizione completa si crea quindi una nuova Session, conservando intatta la precedente. upsert_plot gestisce invece la registrazione o l’aggiornamento della specifica del grafico identificato dal suo Plot ID. Queste semantiche sono diverse e devono rimanere chiare allo studente.
9. Cinque grafici scientifici persistenti
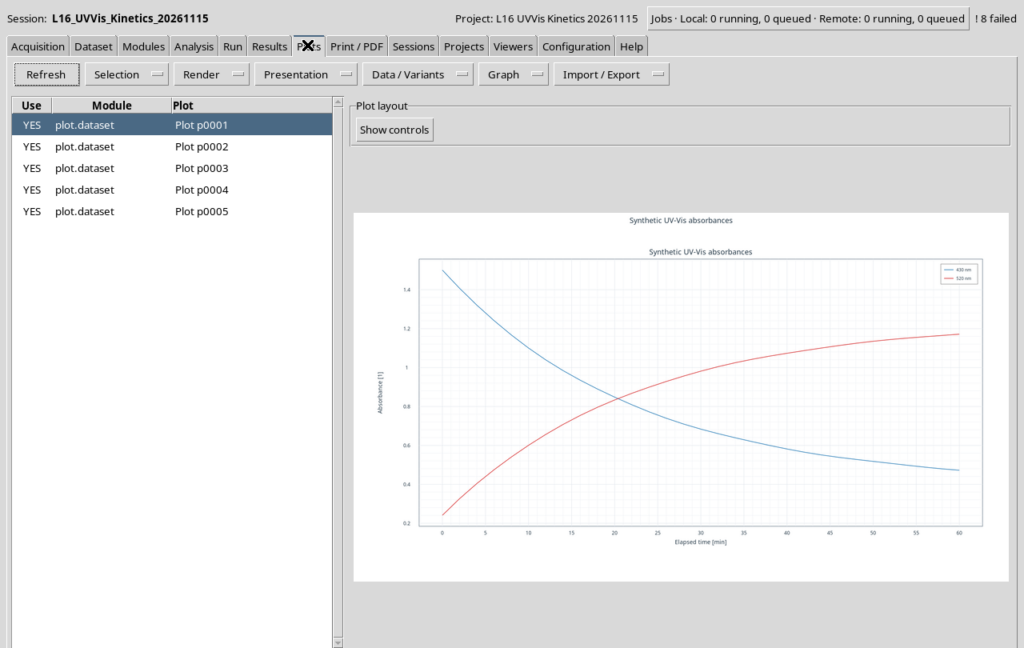
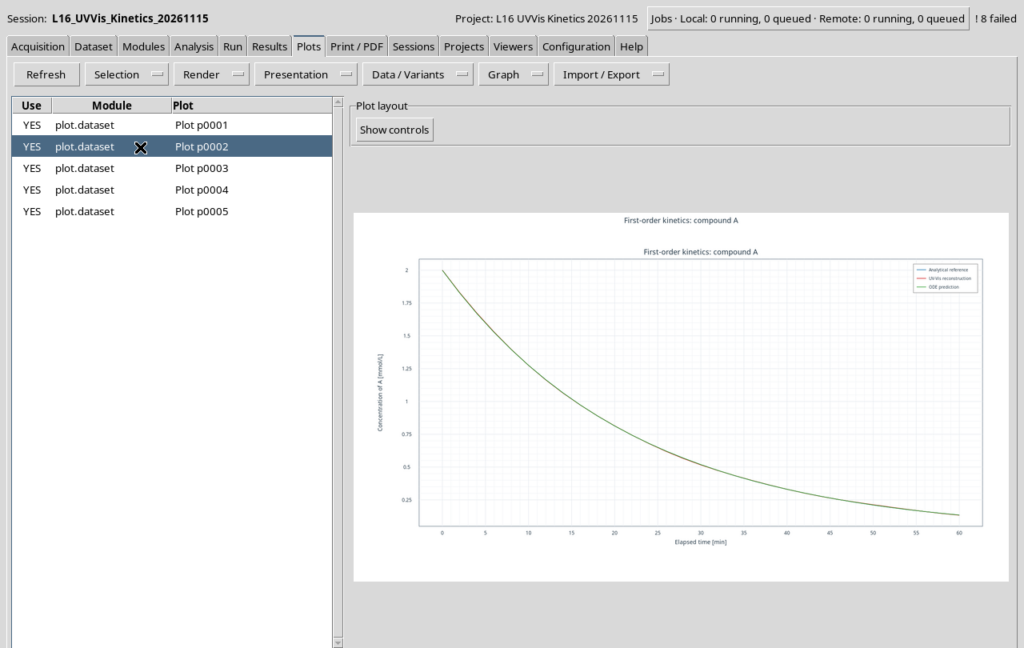
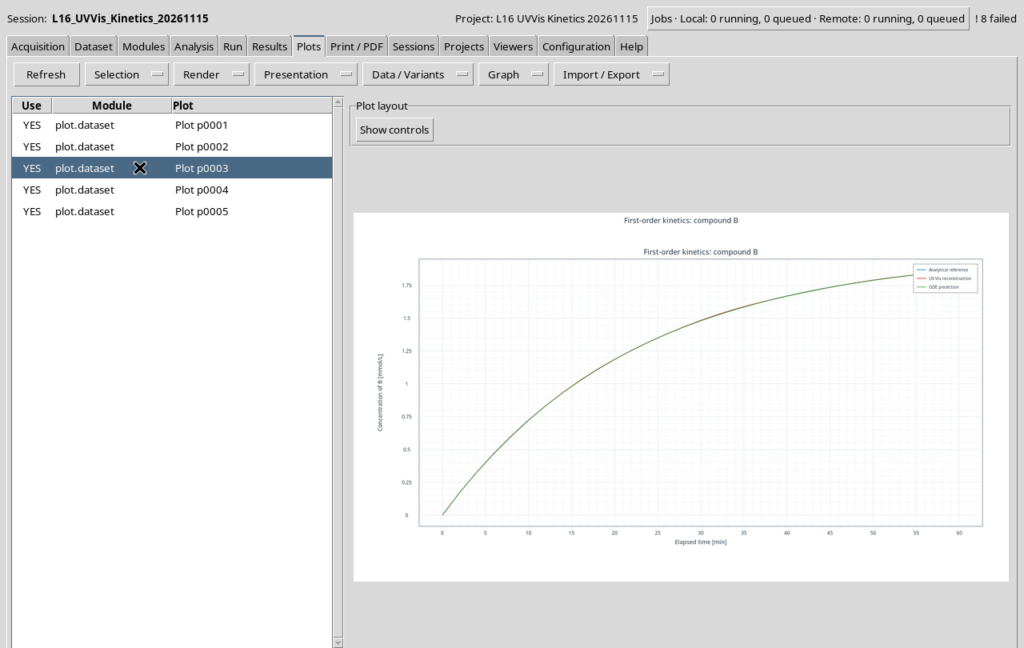
Il terzo script L16_02_UVVis_Kinetics_Correct.m crea cinque grafici diversi, tutti consultabili tramite la scheda Plots del framework. La distinzione tra figure è intenzionale: confrontare assorbanze, concentrazioni e residui richiede scale e interpretazioni differenti.
Assorbanze a 430 e 520 nm
Ricostruzione della specie A
Ricostruzione della specie B
Residui del modello
Bilancio di materia
10. Eseguire l’esperimento nel Viewer Octave Scripts
- Aprire una nuova Session dentro un Project GX-TXT. Gli script preparatori usano ID a creazione unica, quindi per ripetere l’intero esercizio occorre una Session nuova.
- In Viewers → Octave Scripts, importare
L16_00_Prepare_UVVis_Kinetics.m, attribuirgli uno Script ID univoco, salvarlo ed eseguirlo da Run → Open Script Runner. Controllare lo statoCOMPLETEDe i cinque Dataset d’ingresso. - Importare
L16_01_Debug_Swapped_Wavelengths.mcon un altro Script ID. Aprire Run → Debug Session script, impostare un breakpoint alla riga 60, ispezionare le variabili e premere Continue. Il JobFAILEDè atteso: dimostra il controllo fisico. - Importare
L16_02_UVVis_Kinetics_Correct.m, assegnare un terzo Script ID, salvare ed eseguire. Verificare che il Job termini inCOMPLETED. - Aprire Dataset per controllare i dodici Dataset e Plots per esplorare le cinque figure native e le rispettive legende.
Nella procedura si utilizzano i servizi di Session, Dataset e Plot già esposti dalla GUI e dallo Script Bridge; nessuna operazione richiede di modificare file interni del framework.
11. Esercizi di approfondimento
- Portare \(k\) a \(0{,}030\ \mathrm{min}^{-1}\) nello script preparatorio e confrontare le curve e la nuova stima della regressione in una Session differente.
- Modificare le due righe della matrice di assorbività rendendole quasi proporzionali. Studiare il numero di condizionamento e spiegare perché la separazione delle specie diventa meno affidabile.
- Aumentare l’ampiezza delle perturbazioni sintetiche; controllare come cambiano \(R^2\), RMS dei residui e bilancio della materia.
- Modificare la griglia temporale: quali righe
read_rangee quali attese su numero di campioni devono essere aggiornate? - Confrontare l’approccio log-lineare con un fit non lineare direttamente nello spazio delle assorbanze. Quali ipotesi sul rumore cambiano?
Esercizi finali di programmazione Octave
- Orientamento degli array. Nel debugger confrontare
size(abs430),size(abs430.')esize(measurements). Invertire intenzionalmente una trasposizione, identificare il messaggio diagnostico e ripristinare l’orientamento \(2\times31\). - Cell array e campi dinamici. Spiegare perché
source_y_ids{j}non è equivalente asource_y_ids(j)e perché l’accessonode.(source_y_ids{j}).values(:)consente di riutilizzare lo stesso ciclo per cinque variabili differenti. - Controlli anticipati. Creare una copia dello script e introdurre una verifica per gli assi temporali prima del problema inverso. Spiegare la differenza tra fermare un input incoerente e rilevare un residuo eccessivo dopo il fitting.
- Modularizzazione. Come estensione, estrarre il controllo di coerenza di due assi temporali in una funzione Octave riutilizzabile, specificandone input, output e condizione di errore; conservare l’accesso ai Dataset esclusivamente attraverso le API pubbliche.
12. Conclusione: dal calcolo a un risultato riproducibile
Questo esperimento riunisce il percorso didattico: la matrice collega i segnali strumentali alle concentrazioni, la regressione fornisce un parametro cinetico, l’integrazione differenziale ne ricostruisce l’andamento nel tempo e i controlli di coerenza impediscono la pubblicazione di risultati fisicamente impossibili.
L’elemento caratteristico dell’integrazione con GX-TXT è che Dataset, unità, provenienza e grafici rimangono risorse scientifiche della Session, non semplici numeri stampati da uno script. Le funzioni del linguaggio Octave e le API pubbliche svolgono ruoli complementari e ben identificabili.
Bilancio conclusivo del corso
Con questa lezione si conclude il percorso introduttivo di 16 lezioni: dalla sintassi e dai vettori Octave siamo arrivati a un’applicazione che collega strumenti di misura simulati, algebra lineare, regressione, modelli dinamici, verifica fisica, gestione degli errori e pubblicazione di risultati tracciabili. Il risultato più importante non è una singola costante cinetica, ma la capacità di spiegare e verificare ogni passaggio che collega l’osservazione a quella costante.
Il progetto didattico resta estendibile con esercizi e studi di caso successivi; la Lezione 16 chiude il ciclo previsto senza implicare la fine dello sviluppo di GX-TXT o delle applicazioni scientifiche con GNU Octave.
Versione GX-TXT e documentazione pubblica
Framework utilizzato: GX-TXT 0.9.8.10-dev-112 Release 2 P009, versione disponibile su GitHub al momento della lezione. Commit sorgente verificato: 059ff073eb43770292b6609f7c0cc3cbc811710d. Data di riferimento: 15 novembre 2026.
- Octave Script Bridge API v1
- Canonical Dataset API v2
- Dataset Publication API v2
- Plot Dataset API v4
- Numeric API v1
Materiali didattici
Gli script GNU Octave completi, commentati in inglese, sono inclusi nel pacchetto scaricabile della Lezione 16: L16_00_Prepare_UVVis_Kinetics.m, L16_01_Debug_Swapped_Wavelengths.m e L16_02_UVVis_Kinetics_Correct.m. I sorgenti sono inoltre consultabili nei riquadri espandibili dell’articolo.
Script GNU Octave completi
Espandi ogni riquadro per leggere e copiare il sorgente completo.
Programma 00 — L16_00_Prepare_UVVis_Kinetics.m
% Lesson 16 - Publish deterministic UV-Vis measurements and exact kinetic references.
% Course: GNU Octave with GX-TXT | DEV112 Release 2 + P009
% GitHub source commit: 059ff073eb43770292b6609f7c0cc3cbc811710d
% SPDX-License-Identifier: GPL-3.0-or-later
%
% Run this create-only preparation script in a fresh managed GX-TXT Session.
% All Datasets are created and verified through public GX-TXT APIs.
% The signals are synthetic, not experimental observations.

dataset_api = 'CANONICAL_DATASET_API_v2';
publication_api = 'DATASET_PUBLICATION_API_v2';
gxtxt_api_require({dataset_api, publication_api});
required = {dataset_api, 'list'; dataset_api, 'read_range'; ...
            publication_api, 'publish_series_batch'};
for j = 1:rows(required)
  if !gxtxt_api_has_operation(required{j,1}, required{j,2})
    error('Required public operation unavailable: %s/%s.', ...
          required{j,1}, required{j,2});
  endif
endfor

% A -> B first-order reaction. Concentrations are in mmol/L and time in min.
time_min = (0:2:60)';
initial_A_mmol_L = 2.0;
rate_min_inverse = 0.045;
path_length_cm = 1.0;
epsilon_L_mmol_cm = [0.75, 0.20; 0.12, 0.62];
n = numel(time_min);
assert(n == 31 && all(diff(time_min) > 0));
assert(rank(epsilon_L_mmol_cm) == 2);

% Exact analytical reference serves as ground truth for this synthetic example.
reference_A = initial_A_mmol_L .* exp(-rate_min_inverse .* time_min);
reference_B = initial_A_mmol_L - reference_A;
reference_total = reference_A + reference_B;

% Beer-Lambert absorbance at 430 and 520 nm, with fixed instrumental deviations.
% The deterministic perturbations make the example repeatable without a PRNG.
absorbance_430 = path_length_cm .* ...
  (epsilon_L_mmol_cm(1,1).*reference_A + epsilon_L_mmol_cm(1,2).*reference_B) ...
  + 0.0015 .* sin(0.40.*time_min) + 0.0008 .* cos(0.13.*time_min);
absorbance_520 = path_length_cm .* ...
  (epsilon_L_mmol_cm(2,1).*reference_A + epsilon_L_mmol_cm(2,2).*reference_B) ...
  + 0.0013 .* cos(0.37.*time_min + 0.2) - 0.0006 .* sin(0.16.*time_min);
assert(all(absorbance_430 > 0) && all(absorbance_520 > 0));
assert(max(abs(reference_total - initial_A_mmol_L)) < 1e-12);

dataset_ids = {'lesson16_uvvis_430nm','lesson16_uvvis_520nm', ...
               'lesson16_reference_A','lesson16_reference_B', ...
               'lesson16_reference_total'};
existing_ids = gxtxt_api_call(dataset_api, 'list', {});
for j = 1:numel(dataset_ids)
  if any(strcmp(existing_ids, dataset_ids{j}))
    error('Dataset already exists: %s. Use a fresh Session.', dataset_ids{j});
  endif
endfor

% Stable Variable IDs, explicit units and compatible dataset contracts.
time_variable = struct('variable_id','time_min','name','time_min', ...
  'display_label','Elapsed time','unit','min','dtype','float64', ...
  'value_kind','number','semantic_source','generator');
abs430_variable = struct('variable_id','absorbance_430_au', ...
  'name','absorbance_430_au','display_label','Absorbance at 430 nm', ...
  'unit','1','dtype','float64','value_kind','number', ...
  'semantic_source','generator');
abs520_variable = struct('variable_id','absorbance_520_au', ...
  'name','absorbance_520_au','display_label','Absorbance at 520 nm', ...
  'unit','1','dtype','float64','value_kind','number', ...
  'semantic_source','generator');
refA_variable = struct('variable_id','concentration_A_mmol_L', ...
  'name','concentration_A_mmol_L','display_label','Reference concentration A', ...
  'unit','mmol/L','dtype','float64','value_kind','number', ...
  'semantic_source','generator');
refB_variable = struct('variable_id','concentration_B_mmol_L', ...
  'name','concentration_B_mmol_L','display_label','Reference concentration B', ...
  'unit','mmol/L','dtype','float64','value_kind','number', ...
  'semantic_source','generator');
total_variable = struct('variable_id','total_mmol_L', ...
  'name','total_mmol_L','display_label','Reference total concentration', ...
  'unit','mmol/L','dtype','float64','value_kind','number', ...
  'semantic_source','generator');
values = {absorbance_430, absorbance_520, reference_A, reference_B, reference_total};
y_variables = {abs430_variable, abs520_variable, refA_variable, refB_variable, total_variable};
descriptions = {'Synthetic UV-Vis absorbance at 430 nm', ...
  'Synthetic UV-Vis absorbance at 520 nm', ...
  'Exact first-order analytical concentration of A', ...
  'Exact first-order analytical concentration of B', ...
  'Exact conserved molar concentration'};

series = cell(1,numel(dataset_ids));
for j = 1:numel(dataset_ids)
  metadata = struct();
  metadata.('lesson16.synthetic') = true;
  metadata.('lesson16.reaction') = 'A_to_B_first_order';
  metadata.('lesson16.rate_min_inverse') = rate_min_inverse;
  metadata.('lesson16.initial_A_mmol_L') = initial_A_mmol_L;
  metadata.('lesson16.path_length_cm') = path_length_cm;
  metadata.('lesson16.epsilon430_A') = epsilon_L_mmol_cm(1,1);
  metadata.('lesson16.epsilon430_B') = epsilon_L_mmol_cm(1,2);
  metadata.('lesson16.epsilon520_A') = epsilon_L_mmol_cm(2,1);
  metadata.('lesson16.epsilon520_B') = epsilon_L_mmol_cm(2,2);
  metadata.('lesson16.series_kind') = descriptions{j};
  series{j} = struct('dataset_id',dataset_ids{j}, ...
    'contract','table.generic','storage','auto', ...
    'x_values',time_min,'y_values',values{j}, ...
    'x_variable',time_variable,'y_variable',y_variables{j}, ...
    'source','GX-TXT GNU Octave Lesson 16','producer_version','1.0.0', ...
    'provenance','Deterministic first-order and Beer-Lambert synthetic generator', ...
    'notes',descriptions{j},'structured_metadata',metadata);
endfor
receipt = gxtxt_api_call(publication_api,'publish_series_batch', ...
  {struct('series',{series})});
if !receipt.atomic || receipt.output_count != numel(dataset_ids)
  error('Atomic publication did not confirm all five source Datasets.');
endif
for j = 1:numel(dataset_ids)
  check = gxtxt_api_call(dataset_api, 'read_range', ...
    {dataset_ids{j},{'time_min',y_variables{j}.variable_id},0,n});
  observed_time = check.time_min.values(:);
  observed_values = check.(y_variables{j}.variable_id).values(:);
  if numel(observed_values) != n || ...
     max(abs(observed_time-time_min)) > 1e-10 || ...
     max(abs(observed_values-values{j})) > 1e-10
    error('Public Dataset read-back failed for %s.',dataset_ids{j});
  endif
endfor
fprintf('PASS: 5 synthetic UV-Vis and analytical reference Datasets published.\n');
fprintf('Ground-truth first-order rate k=%.6f min^-1, initial A=%.3f mmol/L.\n', ...
  rate_min_inverse, initial_A_mmol_L);
fprintf('Measurement grid: %d points, from %.0f to %.0f min.\n', ...
  n,time_min(1),time_min(end));
Programma 01 — L16_01_Debug_Swapped_Wavelengths.m
% Lesson 16 - Deliberately swap the wavelengths to debug a scientific error.
% Course: GNU Octave with GX-TXT | DEV112 Release 2 + P009
% GitHub source commit: 059ff073eb43770292b6609f7c0cc3cbc811710d
% SPDX-License-Identifier: GPL-3.0-or-later
%
% Run after L16_00 using Run > Debug Session script.
% Add a breakpoint before the physical consistency check and inspect c_A_bad.
% Expected outcome: FAILED, without publishing any new Dataset.

dataset_api = 'CANONICAL_DATASET_API_v2';
numeric_api = 'NUMERIC_API_v1';
gxtxt_api_require({dataset_api, ...
  'NUMERIC_API_v1@1:math.numeric+complex_linear_algebra'});
required = {dataset_api,'list'; dataset_api,'read_range'; ...
            numeric_api,'linear_matrix'};
for j = 1:rows(required)
  if !gxtxt_api_has_operation(required{j,1},required{j,2})
    error('Required public operation unavailable: %s/%s.', ...
      required{j,1},required{j,2});
  endif
endfor

source_ids = {'lesson16_uvvis_430nm','lesson16_uvvis_520nm'};
available_ids = gxtxt_api_call(dataset_api,'list',{});
for j = 1:numel(source_ids)
  if !any(strcmp(available_ids,source_ids{j}))
    error('Missing source Dataset %s. Run L16_00 first.',source_ids{j});
  endif
endfor
n = 31;
data430 = gxtxt_api_call(dataset_api,'read_range', ...
  {source_ids{1},{'time_min','absorbance_430_au'},0,n});
data520 = gxtxt_api_call(dataset_api,'read_range', ...
  {source_ids{2},{'time_min','absorbance_520_au'},0,n});
time_min = data430.time_min.values(:);
A430 = data430.absorbance_430_au.values(:);
A520 = data520.absorbance_520_au.values(:);
if numel(time_min) != n || ...
   max(abs(data520.time_min.values(:)-time_min)) > 1e-12
  error('Time axes are not aligned.');
endif

% Correct molar absorptivities, with rows in the order 430 nm and 520 nm.
epsilon = [0.75,0.20;0.12,0.62];
matrix_node = struct('real',epsilon,'imaginary',zeros(size(epsilon)));

% BUG: the measured 520 nm signal is placed in the 430 nm row, and vice versa.
wrong_absorbances = [A520.'; A430.'];
bad_rhs = struct('real',wrong_absorbances, ...
                 'imaginary',zeros(size(wrong_absorbances)));
result = gxtxt_api_call(numeric_api,'linear_matrix', ...
  {'solve',matrix_node,bad_rhs});
c_A_bad = result.value_real(1,:).';
c_B_bad = result.value_real(2,:).';

% BREAKPOINT: inspect wrong_absorbances, c_A_bad(1), min(c_A_bad), c_B_bad.
% A negative concentration is not an acceptable result of this model.
fprintf('Swapped wavelengths: initial reconstructed A=%.6f mmol/L.\n', ...
  c_A_bad(1));
if any(c_A_bad < -1e-9) || any(c_B_bad < -1e-9)
  error('Physical validation failed: swapped UV-Vis wavelengths yield negative concentrations.');
endif
error('Expected the deliberate wavelength swap to fail physical validation.');
Programma 02 — L16_02_UVVis_Kinetics_Correct.m
% Lesson 16 - Complete synthetic UV-Vis kinetics analysis with GX-TXT.
% Course: GNU Octave with GX-TXT | DEV112 Release 2 + P009
% GitHub source commit: 059ff073eb43770292b6609f7c0cc3cbc811710d
% SPDX-License-Identifier: GPL-3.0-or-later
%
% Run after L16_00 in a managed GX-TXT Session.
% The Dataset, numerical linear/regression, publication and plot operations
% all use versioned public GX-TXT APIs through the Octave Script Bridge.
% ode45 and the array expressions are GNU Octave language operations.

dataset_api = 'CANONICAL_DATASET_API_v2';
numeric_api = 'NUMERIC_API_v1';
publication_api = 'DATASET_PUBLICATION_API_v2';
plot_api = 'PLOT_DATASET_API_v4';
gxtxt_api_require({dataset_api, ...
  'NUMERIC_API_v1@1:math.numeric+complex_linear_algebra', ...
  publication_api,plot_api});
required = {dataset_api,'list';dataset_api,'read_range'; ...
  numeric_api,'linear_matrix';numeric_api,'linear_regression'; ...
  publication_api,'publish_series_batch'; ...
  plot_api,'new_spec';plot_api,'validate_spec'; ...
  plot_api,'upsert_plot';plot_api,'render';plot_api,'artifacts'};
for j=1:rows(required)
  if !gxtxt_api_has_operation(required{j,1},required{j,2})
    error('Missing public GX-TXT operation: %s/%s.',required{j,1},required{j,2});
  endif
endfor

% 1. Read five canonical source Datasets by stable Dataset and Variable IDs.
source_ids={'lesson16_uvvis_430nm','lesson16_uvvis_520nm', ...
            'lesson16_reference_A','lesson16_reference_B', ...
            'lesson16_reference_total'};
source_y_ids={'absorbance_430_au','absorbance_520_au', ...
              'concentration_A_mmol_L','concentration_B_mmol_L','total_mmol_L'};
existing_ids=gxtxt_api_call(dataset_api,'list',{});
for j=1:numel(source_ids)
  if !any(strcmp(existing_ids,source_ids{j}))
    error('Missing source Dataset %s. Run L16_00 first.',source_ids{j});
  endif
endfor
n=31;
source_values=cell(1,numel(source_ids));
for j=1:numel(source_ids)
  node=gxtxt_api_call(dataset_api,'read_range', ...
    {source_ids{j},{'time_min',source_y_ids{j}},0,n});
  tx=node.time_min.values(:);
  if j==1
    time_min=tx;
  elseif numel(tx)!=n || max(abs(tx-time_min))>1e-12
    error('Source time axes differ; the kinetic model needs aligned observations.');
  endif
  source_values{j}=node.(source_y_ids{j}).values(:);
  if numel(source_values{j})!=n || any(!isfinite(source_values{j}))
    error('Nonfinite or incomplete source values in %s.',source_ids{j});
  endif
endfor
if numel(time_min)!=n || any(diff(time_min)<=0)
  error('The time grid is not strictly increasing.');
endif
abs430=source_values{1};
abs520=source_values{2};
reference_A=source_values{3};
reference_B=source_values{4};
reference_total=source_values{5};
assert(max(abs(reference_A+reference_B-reference_total))<1e-12);

% 2. Beer-Lambert matrix: rows are wavelengths, columns are compounds A and B.
% E has units L/(mmol*cm), path length has cm and concentrations are mmol/L.
path_length_cm=1.0;
epsilon_L_mmol_cm=[0.75,0.20;0.12,0.62];
design=epsilon_L_mmol_cm*path_length_cm;
measurements=[abs430.';abs520.'];
design_node=struct('real',design,'imaginary',zeros(size(design)));
rhs_node=struct('real',measurements,'imaginary',zeros(size(measurements)));
matrix_info=gxtxt_api_call(numeric_api,'linear_matrix', ...
  {'inspect',design_node,[]});
if matrix_info.rank!=2 || matrix_info.condition_number>=100
  error('The Beer-Lambert matrix is rank-deficient or poorly conditioned.');
endif

% 3. Solve the two-by-two system for all times in a single multi-RHS call.
result=gxtxt_api_call(numeric_api,'linear_matrix', ...
  {'solve',design_node,rhs_node});
if !isequal(size(result.value_real),[2,n]) || ...
   max(abs(result.value_imaginary(:)))>1e-12
  error('Unexpected complex concentration result or response dimensions.');
endif
recovered_A=result.value_real(1,:).';
recovered_B=result.value_real(2,:).';
if any(recovered_A<=0) || any(recovered_B<0)
  error('Negative or zero physical concentrations: check wavelength ordering.');
endif
reconstruction=design*[recovered_A.';recovered_B.'];
if max(abs(reconstruction(:)-measurements(:)))>1e-10
  error('Beer-Lambert algebraic reconstruction failed.');
endif
total_recovered=recovered_A+recovered_B;
max_mass_error=max(abs(total_recovered-reference_total));

% 4. Estimate first-order rate by public regression of ln([A]) vs time.
% The log-linear approximation is educational; noise is in absorbance space.
fit=gxtxt_api_call(numeric_api,'linear_regression', ...
  {time_min,log(recovered_A),[],struct('intercept',true)});
estimated_k_min_inverse=-fit.slope;
estimated_A0_mmol_L=exp(fit.intercept);
if estimated_k_min_inverse<=0 || estimated_A0_mmol_L<=0 || ...
   !isfinite(estimated_k_min_inverse) || fit.r_squared<0.99
  error('Regression did not yield a plausible first-order kinetic law.');
endif

% 5. Integrate the coupled kinetic system with GNU Octave ode45.
% dnA/dt = -k*A, dnB/dt = k*A; initial B is zero in the chosen model.
rhs=@(t,y) [-estimated_k_min_inverse*y(1);estimated_k_min_inverse*y(1)];
ode_options=odeset('RelTol',1e-10,'AbsTol',1e-11);
[time_solution,state_solution]=ode45(rhs,time_min, ...
  [estimated_A0_mmol_L;0],ode_options);
if numel(time_solution)!=n || max(abs(time_solution-time_min))>1e-8
  error('ode45 did not return the requested observation grid.');
endif
model_A=state_solution(:,1);
model_B=state_solution(:,2);
analytic_A=estimated_A0_mmol_L.*exp(-estimated_k_min_inverse.*time_min);
if max(abs(model_A-analytic_A))>1e-7 || ...
   max(abs(model_A+model_B-estimated_A0_mmol_L))>1e-8
  error('ODE solution violates the independent analytical or mass-balance test.');
endif

% 6. Quantify model residuals and compare with synthetic ground truth.
residual_A=recovered_A-model_A;
residual_B=recovered_B-model_B;
rms_A=sqrt(mean(residual_A.^2));
rms_B=sqrt(mean(residual_B.^2));
true_k_min_inverse=0.045;
max_reference_error=max([abs(recovered_A-reference_A); ...
                         abs(recovered_B-reference_B)]);
if max_mass_error>0.02 || max_reference_error>0.02 || ...
   rms_A>0.02 || rms_B>0.02 || ...
   abs(estimated_k_min_inverse-true_k_min_inverse)>0.005
  error('Kinetic reconstruction failed the specified scientific validation.');
endif
fprintf('Estimated k=%.8f min^-1; A(0)=%.6f mmol/L; R^2=%.8f.\n', ...
  estimated_k_min_inverse,estimated_A0_mmol_L,fit.r_squared);
fprintf('Residual RMS A=%.8f, B=%.8f mmol/L; max mass error=%.8f mmol/L.\n', ...
  rms_A,rms_B,max_mass_error);
fprintf('Design rank=%d; condition number=%.6f.\n', ...
  matrix_info.rank,matrix_info.condition_number);

% 7. Publish seven derived canonical series as one atomic GX-TXT operation.
derived_ids={'lesson16_recovered_A','lesson16_recovered_B', ...
  'lesson16_model_A','lesson16_model_B', ...
  'lesson16_residual_A','lesson16_residual_B', ...
  'lesson16_total_recovered'};
for j=1:numel(derived_ids)
  if any(strcmp(existing_ids,derived_ids{j}))
    error('Derived Dataset already exists: %s. Use a new Session.',derived_ids{j});
  endif
endfor
time_var=struct('variable_id','time_min','name','time_min', ...
  'display_label','Elapsed time','unit','min','dtype','float64', ...
  'value_kind','number','semantic_source','plugin');
A_var=struct('variable_id','concentration_A_mmol_L', ...
  'name','concentration_A_mmol_L','display_label','Concentration of A', ...
  'unit','mmol/L','dtype','float64','value_kind','number', ...
  'semantic_source','plugin');
B_var=struct('variable_id','concentration_B_mmol_L', ...
  'name','concentration_B_mmol_L','display_label','Concentration of B', ...
  'unit','mmol/L','dtype','float64','value_kind','number', ...
  'semantic_source','plugin');
resA_var=struct('variable_id','residual_A_mmol_L', ...
  'name','residual_A_mmol_L','display_label','Residual of A', ...
  'unit','mmol/L','dtype','float64','value_kind','number', ...
  'semantic_source','plugin');
resB_var=struct('variable_id','residual_B_mmol_L', ...
  'name','residual_B_mmol_L','display_label','Residual of B', ...
  'unit','mmol/L','dtype','float64','value_kind','number', ...
  'semantic_source','plugin');
total_var=struct('variable_id','total_mmol_L', ...
  'name','total_mmol_L','display_label','Total recovered concentration', ...
  'unit','mmol/L','dtype','float64','value_kind','number', ...
  'semantic_source','plugin');
derived_y={recovered_A,recovered_B,model_A,model_B,residual_A,residual_B, ...
  total_recovered};
derived_vars={A_var,B_var,A_var,B_var,resA_var,resB_var,total_var};
notes={'Reconstructed A from the two UV-Vis wavelengths', ...
       'Reconstructed B from the two UV-Vis wavelengths', ...
       'Coupled first-order ODE prediction for A', ...
       'Coupled first-order ODE prediction for B', ...
       'Reconstructed minus predicted A concentration', ...
       'Reconstructed minus predicted B concentration', ...
       'Recovered A+B mass-balance trace'};
derived=cell(1,numel(derived_ids));
for j=1:numel(derived_ids)
  meta=struct();
  meta.('lesson16.synthetic_inputs')=true;
  meta.('lesson16.analysis')='BeerLambert_linear_solve_log_regression_ode45';
  meta.('lesson16.k_fit_min_inverse')=estimated_k_min_inverse;
  meta.('lesson16.initial_fit_mmol_L')=estimated_A0_mmol_L;
  meta.('lesson16.fit_r_squared')=fit.r_squared;
  meta.('lesson16.max_mass_error_mmol_L')=max_mass_error;
  meta.('lesson16.rms_A_mmol_L')=rms_A;
  meta.('lesson16.rms_B_mmol_L')=rms_B;
  meta.('lesson16.output_role')=notes{j};
  derived{j}=struct('dataset_id',derived_ids{j}, ...
    'contract','table.generic','storage','auto', ...
    'x_values',time_min,'y_values',derived_y{j}, ...
    'x_variable',time_var,'y_variable',derived_vars{j}, ...
    'source','GX-TXT GNU Octave Lesson 16', ...
    'producer_version','1.0.0', ...
    'source_dataset_ids',{source_ids(1:2)}, ...
    'provenance','Public linear_matrix, linear_regression and GNU Octave ode45', ...
    'notes',notes{j},'structured_metadata',meta);
endfor
publish=gxtxt_api_call(publication_api,'publish_series_batch', ...
  {struct('series',{derived})});
if !publish.atomic || publish.output_count!=numel(derived_ids)
  error('Atomic publication did not confirm seven derived Datasets.');
endif
for j=1:numel(derived_ids)
  check=gxtxt_api_call(dataset_api,'read_range', ...
    {derived_ids{j},{'time_min',derived_vars{j}.variable_id},0,n});
  yy=check.(derived_vars{j}.variable_id).values(:);
  if numel(yy)!=n || max(abs(yy-derived_y{j}))>1e-9 || ...
     max(abs(check.time_min.values(:)-time_min))>1e-9
    error('Canonical read-back mismatch for Dataset %s.',derived_ids{j});
  endif
endfor

% 8. Create five persistent native GX-TXT Plot Dataset v4 figures.
% All visible traces resolve stable Dataset IDs and Variable IDs.
plot_defs={
 'lesson16_absorbances','Synthetic UV-Vis absorbances', ...
 {'430 nm','520 nm'}, ...
 {'lesson16_uvvis_430nm','lesson16_uvvis_520nm'}, ...
 {'absorbance_430_au','absorbance_520_au'},'Absorbance [1]';
 'lesson16_kinetics_A','First-order kinetics: compound A', ...
 {'Analytical reference','UV-Vis reconstruction','ODE prediction'}, ...
 {'lesson16_reference_A','lesson16_recovered_A','lesson16_model_A'}, ...
 {'concentration_A_mmol_L','concentration_A_mmol_L','concentration_A_mmol_L'}, ...
 'Concentration of A [mmol/L]';
 'lesson16_kinetics_B','First-order kinetics: compound B', ...
 {'Analytical reference','UV-Vis reconstruction','ODE prediction'}, ...
 {'lesson16_reference_B','lesson16_recovered_B','lesson16_model_B'}, ...
 {'concentration_B_mmol_L','concentration_B_mmol_L','concentration_B_mmol_L'}, ...
 'Concentration of B [mmol/L]';
 'lesson16_concentration_residuals','First-order kinetic residuals', ...
 {'Compound A','Compound B'}, ...
 {'lesson16_residual_A','lesson16_residual_B'}, ...
 {'residual_A_mmol_L','residual_B_mmol_L'},'Measured - predicted [mmol/L]';
 'lesson16_mass_balance','Mass balance throughout reaction', ...
 {'Recovered total','Analytical total'}, ...
 {'lesson16_total_recovered','lesson16_reference_total'}, ...
 {'total_mmol_L','total_mmol_L'},'Total concentration [mmol/L]'
};
for p=1:rows(plot_defs)
  plot_id=plot_defs{p,1};
  plot_title=plot_defs{p,2};
  labels=plot_defs{p,3};
  dataset_list=plot_defs{p,4};
  variable_list=plot_defs{p,5};
  plot_spec=gxtxt_api_call(plot_api,'new_spec',{'plot.dataset.xy',plot_title});
  panel=plot_spec.panels{1};
  panel.id=['kinetic_panel_',num2str(p)];
  panel.title=plot_title;
  panel.axes=struct('x',struct('label','Elapsed time [min]','scale','linear'), ...
    'y_left',struct('label',plot_defs{p,6},'scale','linear'));
  curves=cell(1,numel(labels));
  for j=1:numel(labels)
    curves{j}=struct('id',['trace_',num2str(j)],'label',labels{j}, ...
      'dataset_id',dataset_list{j},'x_variable_id','time_min', ...
      'y_variable_id',variable_list{j},'axis','left','kind','line');
  endfor
  panel.series=curves;
  plot_spec.panels={panel};
  if !gxtxt_api_call(plot_api,'validate_spec',{plot_spec})
    error('Plot Dataset specification invalid: %s.',plot_id);
  endif
  plot_ref=gxtxt_api_call(plot_api,'upsert_plot',{plot_id,plot_spec});
  gxtxt_api_call(plot_api,'render',{plot_ref});
  artifacts=gxtxt_api_call(plot_api,'artifacts',{plot_ref});
  fprintf('Created persistent GX-TXT plot: %s.\n',plot_id);
endfor
fprintf('PASS: 7 derived canonical Datasets, 5 native plots, 1 validated kinetic model.\n');
Altre tappe del progetto
- Lezione 01 — Il primo script GNU Octave in GX-TXT
- Lezione 02 — Variabili, tipi di dati e operatori in GNU Octave con GX-TXT
- Lezione 03 — Vettori e matrici in GNU Octave con GX-TXT: analisi di misure di temperatura
- Lezione 04 — condizioni, cicli e funzioni. Simuliamo la legge di raffreddamento di Newton
- Lezione 05: Dataset scientifici e Variable ID
- Lezione 06 — Selezione e lettura dei dati sperimentali con GNU Octave e GX-TXT