
Lezione 03 — Vettori e matrici in GNU Octave con GX-TXT: analisi di misure di temperatura
Introduzione: dai singoli valori alle matrici scientifiche
Nelle lezioni precedenti abbiamo imparato a eseguire i primi calcoli con GNU Octave e a utilizzare variabili e operatori. Ora affrontiamo una delle caratteristiche più importanti del linguaggio: la capacità di lavorare direttamente con vettori e matrici.
Nelle applicazioni scientifiche raramente ci troviamo a elaborare un solo valore numerico. Un esperimento può produrre centinaia di misure raccolte in tempi diversi, oppure più strumenti possono misurare contemporaneamente la stessa grandezza fisica.
GNU Octave è particolarmente adatto a questo tipo di elaborazione perché nasce come ambiente di calcolo numerico orientato alle matrici. Molte operazioni che in altri linguaggi richiederebbero cicli espliciti possono essere espresse direttamente attraverso operazioni vettoriali e matriciali.
In questa terza lezione utilizzeremo un esperimento simulato con tre sensori di temperatura, che registrano sei misure ciascuno a intervalli regolari di cinque minuti.
Organizzeremo le 18 misure in una matrice, impareremo a selezionare righe e colonne, eseguire operazioni tra elementi, calcolare medie e individuare i valori massimi.
Infine, utilizzeremo le API pubbliche di GX-TXT per effettuare alcune elaborazioni numeriche e pubblicare i risultati come Dataset scientifici, consultabili direttamente nell’interfaccia del framework.
I dati sono sintetici e deterministici: questo ci permetterà di concentrarci sulla programmazione e di verificare facilmente la correttezza dei risultati.
2. Organizzare i dati sperimentali in vettori e matrici
Prima di iniziare a scrivere il codice, dobbiamo comprendere come rappresentare correttamente i dati del nostro esperimento.
Immaginiamo di avere tre sensori, denominati A, B e C, che misurano la temperatura dello stesso sistema in posizioni differenti. Le misure vengono effettuate ogni cinque minuti, per un periodo complessivo di 25 minuti.
I dati sperimentali simulati sono riportati nella tabella seguente.
| Tempo (min) | Sensore A (°C) | Sensore B (°C) | Sensore C (°C) |
|---|---|---|---|
| 0 | 19,8 | 20,1 | 19,9 |
| 5 | 20,3 | 20,4 | 20,2 |
| 10 | 20,8 | 20,9 | 20,6 |
| 15 | 21,1 | 21,3 | 21,0 |
| 20 | 21,0 | 21,2 | 20,9 |
| 25 | 20,6 | 20,8 | 20,5 |
Osserviamo che la temperatura aumenta inizialmente, raggiunge un massimo e successivamente diminuisce.
Per rappresentare queste misure in GNU Octave possiamo utilizzare due strutture fondamentali: un vettore per gli istanti temporali e una matrice per le temperature.
2.1 Il vettore dei tempi
Un vettore è una sequenza ordinata di elementi. In GNU Octave possiamo rappresentarlo orizzontalmente, come vettore riga, oppure verticalmente, come vettore colonna.
Nel nostro esperimento scegliamo un vettore colonna di sei elementi:
time_min = [0; 5; 10; 15; 20; 25];Le parentesi quadre [] delimitano il vettore, mentre il punto e virgola ; separa gli elementi su righe differenti.
Il vettore ha quindi dimensioni 6 × 1, ossia sei righe e una colonna.
Questa rappresentazione è utile perché ciascun elemento del vettore corrisponde a una riga della matrice delle temperature.
2.2 La matrice delle temperature
Una matrice è una struttura bidimensionale composta da righe e colonne.
Nel nostro caso utilizziamo una matrice con sei righe e tre colonne:
temperature_C = [
  19.8, 20.1, 19.9;
  20.3, 20.4, 20.2;
  20.8, 20.9, 20.6;
  21.1, 21.3, 21.0;
  21.0, 21.2, 20.9;
  20.6, 20.8, 20.5
];
La sintassi presenta alcune caratteristiche importanti:
- Le parentesi quadre delimitano l’intera matrice.
- Le virgole separano gli elementi appartenenti alla stessa riga.
- I punti e virgola separano le righe.
- Tutte le righe devono contenere lo stesso numero di elementi.
In Octave utilizziamo il punto come separatore decimale, anche quando nel testo italiano adottiamo la virgola.
La matrice contiene complessivamente 18 valori numerici, organizzati secondo la relazione:
Riga = istante di misura; colonna = sensore.
2.3 Gli indici di riga e colonna
Per accedere a un elemento della matrice utilizziamo due indici, scritti tra parentesi tonde:
temperature_C(riga, colonna)
A differenza di altri linguaggi di programmazione, GNU Octave utilizza indici che iniziano da 1 e non da 0.
Per esempio:
temperature_C(3, 2)restituisce:
ans = 20.900Il valore corrisponde alla terza riga e alla seconda colonna: la temperatura del sensore B al minuto 10.
Possiamo anche selezionare gruppi di elementi mediante l’operatore :.
Per ottenere tutte le temperature registrate al minuto 10:
temperature_C(3, :)Il risultato è un vettore riga:
20.800 20.900 20.600Per estrarre invece tutte le misure del sensore B:
temperature_C(:, 2)otteniamo un vettore colonna:
20.100
20.400
20.900
21.300
21.200
20.800
In questi esempi, i due punti : significano seleziona tutti gli elementi lungo questa dimensione.
Questa possibilità di selezionare intere righe o colonne con una sola istruzione è una caratteristica fondamentale della programmazione matriciale.
2.4 Dimensioni di una matrice
GNU Octave mette a disposizione diverse funzioni per conoscere la struttura di un array.
La funzione size() restituisce le dimensioni, mentre rows() e columns() permettono di ottenere separatamente il numero delle righe e delle colonne.
size(temperature_C)
rows(temperature_C)
columns(temperature_C)
numel(temperature_C)
Nel nostro caso i risultati sono:
| Istruzione | Risultato |
|---|---|
size(temperature_C) | [6 3] |
rows(temperature_C) | 6 |
columns(temperature_C) | 3 |
numel(temperature_C) | 18 |
Queste informazioni sono particolarmente importanti quando elaboriamo dati provenienti da strumenti scientifici, perché consentono di verificare che il numero di osservazioni e la struttura delle matrici siano coerenti con l’esperimento.
Abbiamo così trasformato una semplice tabella di misure in due strutture numeriche che GNU Octave può elaborare direttamente. Nella prossima sezione vedremo come eseguire calcoli sulle matrici, distinguendo le operazioni tra elementi dalle operazioni dell’algebra matriciale.
3. Elaborazione matriciale delle misure di temperatura
Nella sezione precedente abbiamo organizzato le misure dei nostri tre sensori in una matrice di sei righe e tre colonne.
Ora possiamo iniziare a elaborare questi dati, sfruttando una delle caratteristiche più importanti di GNU Octave: la possibilità di eseguire operazioni su interi gruppi di valori senza dover necessariamente scrivere un’istruzione per ogni singola misura.
Gli operatori aritmetici, le operazioni elemento per elemento e i principi della vettorizzazione sono già stati introdotti nella Lezione 02. Qui li utilizzeremo per risolvere un problema scientifico concreto.
Lavoreremo sulla matrice temperature_C e sul vettore temporale time_min, definiti in precedenza.
3.1 Calcolare le variazioni di temperatura tra misure consecutive
Una delle prime elaborazioni che possiamo effettuare consiste nel determinare di quanto varia la temperatura tra due acquisizioni successive.
Per ogni sensore vogliamo calcolare la differenza tra una misura e quella immediatamente precedente.
Matematicamente, indicando con T(i,j) la temperatura del sensore j all’istante i, la variazione è:
Delta_T(i,j) = T(i+1,j) - T(i,j)Poiché abbiamo sei istanti temporali, le differenze consecutive saranno cinque per ciascun sensore.
GNU Octave consente di calcolare tutte queste differenze con una sola istruzione:
temperature_change_C = temperature_C(2:end, :) - ...
                       temperature_C(1:end-1, :);
Esaminiamo attentamente le due selezioni.
temperature_C(2:end, :) estrae tutte le righe dalla seconda all’ultima, mantenendo tutte e tre le colonne. Il risultato ha cinque righe e tre colonne.
temperature_C(1:end-1, :) seleziona invece le prime cinque righe, escludendo l’ultima.
Le due matrici hanno quindi dimensioni identiche e possono essere sottratte elemento per elemento.
L’operatore end, quando compare all’interno dell’indicizzazione, rappresenta l’ultimo indice disponibile nella dimensione interessata. L’espressione end-1 indica il penultimo.
Infine, i tre punti ... alla fine della prima riga permettono di continuare la stessa istruzione sulla riga successiva. Non modificano il calcolo, ma rendono il codice più leggibile.
Otteniamo:
| Intervallo (min) | Sensore A (°C) | Sensore B (°C) | Sensore C (°C) |
|---|---|---|---|
| 0–5 | +0,5 | +0,3 | +0,3 |
| 5–10 | +0,5 | +0,5 | +0,4 |
| 10–15 | +0,3 | +0,4 | +0,4 |
| 15–20 | −0,1 | −0,1 | −0,1 |
| 20–25 | −0,4 | −0,4 | −0,4 |
Il risultato è una nuova matrice 5 × 3.
Notiamo che tutti i sensori registrano inizialmente un aumento della temperatura. Dopo il minuto 15, invece, le variazioni diventano negative, indicando una fase di raffreddamento.
Queste variazioni non rappresentano ancora una velocità di riscaldamento o raffreddamento: per ottenerla dobbiamo considerare anche il tempo trascorso fra le acquisizioni.
3.2 Calcolare gli intervalli temporali
Il vettore dei tempi contiene:
time_min = [0; 5; 10; 15; 20; 25];Per determinare la durata di ogni intervallo utilizziamo la funzione nativa diff():
step_min = diff(time_min);Il risultato è:
5
5
5
5
5
La funzione ha calcolato la differenza tra ciascun elemento e quello precedente, restituendo un vettore colonna di cinque elementi.
In questo esperimento gli intervalli sono tutti uguali, ma non dobbiamo considerarlo un requisito generale. Un sistema di acquisizione reale potrebbe registrare misure a intervalli differenti.
Utilizzando diff() otteniamo direttamente gli intervalli effettivi, senza assumere che siano sempre di cinque minuti.
3.3 Costruire una matrice degli intervalli temporali
La matrice delle variazioni di temperatura ha dimensioni 5 × 3, mentre step_min ha dimensioni 5 × 1.
Vogliamo associare a ciascuna variazione di temperatura il relativo intervallo temporale.
Per ottenere una struttura con le stesse dimensioni della matrice delle variazioni, lo script utilizza:
step_matrix = step_min * ones(1, n_sensors);La funzione ones(1, n_sensors) genera un vettore riga contenente tanti valori unitari quanti sono i sensori.
Nel nostro caso:
1 1 1Moltiplicando il vettore colonna degli intervalli, di dimensioni 5 × 1, per il vettore riga 1 × 3, otteniamo una matrice 5 × 3:
5   5   5
5   5   5
5   5   5
5   5   5
5   5   5
Questa operazione è un esempio di prodotto esterno tra due vettori.
È particolarmente utile perché permette di ripetere una stessa sequenza di valori lungo più colonne mantenendo un’espressione matematica compatta.
In versioni moderne di Octave è possibile sfruttare anche l’espansione automatica delle dimensioni compatibili per alcune operazioni elemento per elemento. Qui utilizziamo intenzionalmente la costruzione esplicita della matrice: permette di osservare più chiaramente il ruolo delle dimensioni.
3.4 Velocità media di variazione della temperatura
A questo punto possiamo dividere ogni variazione di temperatura per la durata dell’intervallo corrispondente.
Lo script utilizza:
rate_C_per_min = temperature_change_C ./ step_matrix;La divisione avviene elemento per elemento, come già spiegato nella Lezione 02.
Il risultato è:
| Intervallo (min) | Sensore A (°C/min) | Sensore B (°C/min) | Sensore C (°C/min) |
|---|---|---|---|
| 0–5 | +0,10 | +0,06 | +0,06 |
| 5–10 | +0,10 | +0,10 | +0,08 |
| 10–15 | +0,06 | +0,08 | +0,08 |
| 15–20 | −0,02 | −0,02 | −0,02 |
| 20–25 | −0,08 | −0,08 | −0,08 |
Questi numeri descrivono la velocità media di variazione della temperatura nei rispettivi intervalli.
Per esempio, il valore +0.10 del sensore A nel primo intervallo indica che la temperatura è aumentata mediamente di 0,10 °C al minuto tra il minuto 0 e il minuto 5.
Il valore -0.08 dello stesso sensore nell’ultimo intervallo indica invece un raffreddamento medio di 0,08 °C al minuto.
È importante distinguere questa grandezza da una derivata istantanea. Stiamo calcolando rapporti incrementali su intervalli finiti, non la derivata esatta di una funzione continua.
In una futura lezione sui metodi numerici approfondiremo questa distinzione e vedremo come stimare derivate a partire da dati sperimentali.
Un’ulteriore osservazione riguarda la dimensione della matrice risultante. Avendo sei misure temporali, otteniamo cinque intervalli e quindi cinque velocità medie per ogni sensore.
Questo è un comportamento naturale dei metodi basati su differenze consecutive.
3.5 La media pesata come prodotto matrice-vettore
Consideriamo ora un problema diverso.
Supponiamo che i tre sensori non abbiano la stessa importanza nella valutazione della temperatura del sistema. Possiamo assegnare loro dei pesi differenti.
Nell’esperimento utilizziamo:
sensor_weights = [0.25; 0.50; 0.25];Il sensore B riceve un peso pari al 50%, mentre A e C contribuiscono ciascuno per il 25%.
La somma dei pesi è uguale a 1.
Questi coefficienti sono stati scelti per scopi didattici: non derivano da una calibrazione, da una stima delle incertezze o da proprietà metrologiche dei sensori.
La temperatura media pesata a un determinato istante è:
T_weighted = 0.25*T_A + 0.50*T_B + 0.25*T_CPotremmo calcolare questa espressione separatamente per ciascuno dei sei istanti temporali.
Ma possiamo anche utilizzare direttamente l’algebra matriciale:
weighted_mean_C = temperature_C * sensor_weights;La matrice temperature_C ha dimensioni 6 × 3.
Il vettore colonna sensor_weights ha dimensioni 3 × 1.
Il prodotto è quindi possibile e produce un vettore 6 × 1.
In altre parole, una sola moltiplicazione matriciale calcola contemporaneamente le sei medie pesate.
I risultati sono:
| Tempo (min) | Media pesata (°C) |
|---|---|
| 0 | 19,975 |
| 5 | 20,325 |
| 10 | 20,800 |
| 15 | 21,175 |
| 20 | 21,075 |
| 25 | 20,675 |
Al minuto 10, per esempio, otteniamo:
0.25*20.8 + 0.50*20.9 + 0.25*20.6 = 20.8 °CQuesta è un’applicazione concreta della moltiplicazione matrice-vettore, molto comune nell’elaborazione di dati scientifici.
Il metodo si estende naturalmente a un numero maggiore di sensori. È sufficiente che il vettore dei pesi contenga un coefficiente per ciascuna colonna della matrice.
Attenzione: nello script calcoliamo la media pesata come esercizio di algebra matriciale, ma il quarto Dataset pubblicato in GX-TXT contiene la media aritmetica dei sensori, non quella pesata. Le due grandezze sono differenti e non devono essere confuse.
3.6 Trasposizione e orientamento dei vettori
Nell’esempio precedente abbiamo utilizzato un vettore colonna per rappresentare i pesi.
Se avessimo scritto:
sensor_weights = [0.25, 0.50, 0.25];avremmo ottenuto un vettore riga 1 × 3, non direttamente utilizzabile come secondo operando nel prodotto matriciale 6 × 3 per 3 × 1.
Per trasformare un vettore riga in un vettore colonna possiamo utilizzare la trasposizione:
sensor_weights = [0.25, 0.50, 0.25];
sensor_weights = sensor_weights.';
Il risultato è:
0.25
0.50
0.25
GNU Octave dispone di due operatori di trasposizione:
.'effettua la trasposizione senza coniugazione;'effettua la trasposizione coniugata, detta anche trasposizione hermitiana.
Per matrici che contengono soltanto numeri reali, i due operatori producono gli stessi valori trasposti.
Con numeri complessi, invece, il comportamento cambia.
Consideriamo:
z = [1+2i, 3-4i];

z_transposed = z.';
z_hermitian = z';
La prima operazione restituisce gli stessi numeri complessi disposti verticalmente:
1 + 2i
3 - 4i
La seconda cambia anche il segno della parte immaginaria:
1 - 2i
3 + 4i
Questa distinzione diventerà importante quando affronteremo segnali complessi, trasformate di Fourier, sistemi elettrici e applicazioni dell’algebra lineare.
Nel nostro esperimento la matrice delle temperature contiene soltanto numeri reali, ma lo script utilizza comunque .' quando desidera modificare esclusivamente l’orientamento dei dati.
3.7 Normalizzazione numerica rispetto a un riferimento
Lo script presenta anche una semplice divisione della matrice delle temperature per un valore di riferimento:
reference_C = 20.0;
normalized_ratio = temperature_C ./ reference_C;
Il risultato è una matrice con le stesse dimensioni dell’originale.
Per esempio, il primo valore diventa:
19.8 / 20.0 = 0.99Questa operazione mostra come applicare un fattore numerico a un’intera matrice senza modificarne l’organizzazione.
Va però precisato un aspetto fisico: il rapporto fra valori espressi in gradi Celsius non costituisce, in generale, un rapporto significativo tra temperature termodinamiche assolute, perché la scala Celsius ha uno zero convenzionale.
Qui l’operazione ha unicamente finalità didattica. Quando una grandezza richiede un rapporto fisico tra temperature assolute, è necessario utilizzare una scala appropriata, come il kelvin.
Abbiamo ora utilizzato matrici e vettori per calcolare variazioni, velocità medie, combinazioni pesate e trasformazioni numeriche.
Nella prossima sezione analizzeremo sistematicamente le funzioni native di GNU Octave impiegate nello script, in modo da comprenderne sintassi, parametri e comportamenti.
4. Le funzioni native di GNU Octave utilizzate nella lezione
Finora abbiamo concentrato l’attenzione sulle operazioni matematiche. Per comprenderne completamente l’implementazione dobbiamo però conoscere alcune funzioni fondamentali del linguaggio.
Le funzioni size(), rows(), columns() e numel() sono già state introdotte nella Sezione 2. Qui approfondiremo le altre funzioni presenti nello script.
Per ciascuna vedremo lo scopo, la sintassi e l’utilizzo pratico.
4.1 diff() — Calcolare differenze consecutive
La funzione diff() calcola le differenze tra elementi consecutivi di un array.
La forma più semplice è:
result = diff(values);Per un vettore:
x = [2, 5, 9, 14];
dx = diff(x);
otteniamo:
3 4 5Il primo valore deriva da 5 - 2, il secondo da 9 - 5 e il terzo da 14 - 9.
Il risultato contiene un elemento in meno rispetto al vettore originale.
La funzione accetta anche parametri aggiuntivi:
diff(X, n, dim)dove:
Xè il vettore o la matrice da elaborare;nindica l’ordine delle differenze;dimspecifica la dimensione lungo la quale effettuare il calcolo.
Con n = 1 si calcolano le differenze consecutive ordinarie.
Con n = 2 si applica una seconda differenza ai risultati della prima, ottenendo una differenza di secondo ordine.
Quando dim non è specificato, Octave utilizza la prima dimensione non singola, secondo le proprie regole per le operazioni sugli array.
Nel nostro esperimento utilizziamo:
step_min = diff(time_min);Avremmo potuto applicare diff() anche direttamente alla matrice delle temperature:
temperature_change_C = diff(temperature_C, 1, 1);In questo caso 1 indica le differenze di primo ordine e l’ultimo argomento 1 indica che devono essere calcolate lungo le righe.
Questa istruzione produce la stessa matrice di differenze ottenuta con la sottrazione tra blocchi di righe mostrata nella Sezione 3.
Il confronto tra le due soluzioni è interessante: l’indicizzazione esplicita rende visibile il meccanismo del calcolo, mentre diff() offre una forma più sintetica e immediatamente riconoscibile.
4.2 ones() — Generare matrici di valori unitari
La funzione ones() costruisce array i cui elementi sono tutti uguali a 1.
La sintassi più comune è:
A = ones(rows_count, columns_count);Per esempio:
A = ones(2, 3);produce:
1   1   1
1   1   1
Con un solo argomento scalare, ones(n) genera una matrice quadrata n × n.
Nel nostro script utilizziamo:
ones(1, n_sensors)per ottenere un vettore riga di tre elementi unitari.
Moltiplicandolo per il vettore colonna step_min, ripetiamo gli intervalli temporali lungo le tre colonne corrispondenti ai sensori.
La funzione è molto utile anche per inizializzare matrici, costruire modelli numerici e preparare strutture di dati con dimensioni note.
Una funzione strettamente correlata è zeros(), che produce matrici contenenti soltanto zeri. Non viene utilizzata in questo esperimento, ma ricorre spesso nella preparazione di array destinati a contenere risultati calcolati successivamente.
4.3 sum() — Sommare elementi lungo una dimensione
La funzione sum() calcola la somma degli elementi di un array.
Per un vettore:
x = [2, 4, 6];
total = sum(x);
il risultato è:
12Su una matrice possiamo specificare la dimensione interessata:
sum(A, dim)Per esempio, sum(A, 1) somma i valori lungo le righe, restituendo un risultato per ciascuna colonna.
sum(A, 2) somma invece i valori lungo le colonne, restituendo un risultato per ciascuna riga.
Nel nostro esperimento la funzione viene utilizzata per controllare che i pesi dei sensori siano normalizzati:
sensor_weights = [0.25; 0.50; 0.25];

sum(sensor_weights)
ottenendo:
1In una media pesata normalizzata, la somma dei coefficienti deve essere uguale a 1.
Lo script verifica questa condizione mediante un controllo numerico, che analizzeremo più avanti.
4.4 mean() — Calcolare la media aritmetica
La funzione mean() calcola la media aritmetica degli elementi di un array.
Per un vettore:
x = [10, 20, 30];
m = mean(x);
otteniamo:
20Su una matrice, invece, dobbiamo prestare attenzione alla dimensione lungo la quale viene eseguita la riduzione.
La sintassi è:
mean(A, dim)Nel nostro caso, la matrice delle temperature ha sei righe, corrispondenti agli istanti temporali, e tre colonne, corrispondenti ai sensori.
Se scriviamo:
mean(temperature_C, 1)otteniamo la media temporale di ciascun sensore:
20.6000 20.7833 20.5167Il risultato è un vettore riga con tre elementi.
Se invece scriviamo:
mean(temperature_C, 2)otteniamo una media tra i tre sensori per ciascun istante temporale.
Il risultato è un vettore colonna con sei elementi:
19.9333
20.3000
20.7667
21.1333
21.0333
20.6333
Questa distinzione è fondamentale nell’elaborazione di matrici sperimentali.
La scelta della dimensione determina il significato scientifico del risultato.
Nel primo caso confrontiamo il comportamento medio dei sensori durante l’esperimento.
Nel secondo caso studiamo l’evoluzione temporale della temperatura media del sistema.
La funzione mean() verrà anche utilizzata per verificare i risultati ottenuti attraverso l’API numerica pubblica di GX-TXT.
4.5 max() — Individuare il valore massimo
La funzione max() permette di individuare il valore massimo di un vettore o di un insieme di valori.
Per esempio:
x = [4, 8, 3, 6];
maximum_value = max(x);
restituisce:
8Con una matrice, max(A) opera normalmente lungo la prima dimensione non singola.
Per ottenere il massimo dell’intera matrice possiamo trasformarla temporaneamente in un vettore:
maximum_C = max(temperature_C(:));L’espressione temperature_C(:) seleziona tutti gli elementi della matrice e li dispone in un unico vettore colonna, seguendo l’ordine lineare di Octave.
Il valore massimo dell’esperimento è:
21.3Ma conoscere soltanto il massimo non è sufficiente per una corretta interpretazione scientifica.
Dobbiamo anche individuare il sensore e l’istante in cui è stato registrato.
4.6 find() — Cercare elementi e relativi indici
La funzione find() restituisce gli indici degli elementi che soddisfano una determinata condizione.
Consideriamo:
x = [3, 7, 2, 7];
positions = find(x == 7);
Il risultato contiene:
2 4perché gli elementi nelle posizioni 2 e 4 sono uguali a 7.
Nel nostro script utilizziamo:
[max_row, max_col] = find(temperature_C == maximum_C, ...
                          1, 'first');
L’istruzione contiene tre elementi importanti.
temperature_C == maximum_C costruisce una matrice logica che identifica le posizioni uguali al massimo.
Il parametro 1 richiede di restituire una sola corrispondenza.
La stringa 'first' specifica di prendere la prima corrispondenza secondo l’ordine di indicizzazione lineare della matrice.
Utilizzando due variabili di uscita, find() restituisce direttamente l’indice di riga e quello di colonna.
Nel nostro caso:
max_row = 4
max_col = 2
Possiamo quindi recuperare il tempo e il sensore:
time_min(max_row)
sensor_ids(max_col)
ottenendo:
15
2
Il valore massimo di 21,3 °C è quindi stato registrato dal sensore B al minuto 15.
Un’osservazione importante riguarda il confronto tra numeri in virgola mobile. In questo caso confrontiamo un elemento della matrice con un massimo estratto dagli stessi dati, quindi il confronto diretto è appropriato.
Quando invece confrontiamo risultati provenienti da calcoli indipendenti, dobbiamo generalmente utilizzare una tolleranza numerica anziché richiedere un’uguaglianza esatta.
4.7 all() e isfinite() — Controllare la validità dei dati
Prima di effettuare un’elaborazione scientifica è buona pratica verificare che i dati siano numericamente validi.
La funzione isfinite() controlla se gli elementi sono numeri finiti.
Restituisce valori logici veri per numeri finiti e falsi per valori come NaN o infinito.
Per esempio:
x = [1, 2, Inf, NaN];
isfinite(x)
produce:
1 1 0 0La funzione all() verifica invece se tutti gli elementi lungo la dimensione considerata soddisfano una condizione logica.
Per esempio:
all([1, 1, 0])restituisce falso.
Nel nostro script combiniamo le due funzioni:
all(isfinite(temperature_C(:)))Prima trasformiamo la matrice in un vettore, poi controlliamo che ogni elemento sia finito.
Lo script utilizza anche:
all(diff(time_min) > 0)Questa istruzione verifica che tutti gli intervalli temporali siano positivi.
È un controllo importante: se due istanti fossero uguali, il successivo calcolo di una velocità media potrebbe introdurre una divisione per zero.
Per una sequenza di tempi strettamente crescente, invece, tutte le differenze consecutive devono essere positive.
4.8 isequal() e assert() — Verificare automaticamente la correttezza
La funzione isequal() controlla se due o più array sono uguali per dimensioni e contenuto, secondo le regole della funzione.
Per esempio:
isequal([1, 2, 3], [1, 2, 3])restituisce vero.
Il confronto:
isequal([1, 2, 3], [1; 2; 3])restituisce falso perché i due array hanno orientamenti differenti.
Questa funzione è particolarmente utile per controllare la struttura dei dati.
Nel nostro esperimento verifichiamo che la matrice abbia un numero di righe uguale al numero di istanti temporali e un numero di colonne uguale al numero dei sensori:
assert(isequal(size(temperature_C), ...
               [numel(time_min), numel(sensor_ids)]));
Qui compare anche assert().
La funzione assert() verifica una condizione logica: se la condizione è vera, l’esecuzione prosegue; se è falsa, genera un errore.
Un esempio semplice è:
assert(2 + 2 == 4);Il controllo viene superato e il programma continua.
Invece:
assert(2 + 2 == 5);provoca un errore.
Nel nostro script assert() viene utilizzata per verificare le dimensioni, la validità delle misure, la normalizzazione dei pesi e la coerenza fra i risultati nativi di Octave e quelli ottenuti attraverso GX-TXT.
Questi controlli costituiscono una forma elementare ma importante di test automatico del codice scientifico.
4.9 abs() — Valore assoluto e tolleranze numeriche
La funzione abs() restituisce il valore assoluto di un numero reale oppure il modulo di un numero complesso.
Per numeri reali:
abs(-3.5)restituisce:
3.5Nel calcolo numerico viene spesso utilizzata per misurare la distanza tra due risultati.
Per esempio:
a = 0.1 + 0.2;
b = 0.3;

abs(a - b)
restituisce una differenza molto piccola, legata alla rappresentazione in virgola mobile.
Per questo motivo, nello script utilizziamo confronti del tipo:
assert(abs(sum(sensor_weights) - 1) < 1e-12);Il numero 1e-12 rappresenta la tolleranza richiesta.
Anziché pretendere che la somma sia esattamente uguale a 1 in ogni possibile calcolo, controlliamo che la differenza assoluta sia inferiore a un limite molto piccolo.
Per verificare interi array, lo script utilizza anche:
assert(max(abs(sensor_mean_C - mean(temperature_C, 1))) < 1e-10);Questa istruzione calcola le differenze fra due vettori, ne prende il valore assoluto e verifica che la differenza massima non superi la tolleranza.
Le tolleranze adottate hanno significato numerico e non devono essere confuse con l’incertezza delle misure sperimentali.
La scelta di tolleranze appropriate dipende dal problema, dalla scala dei valori e dagli algoritmi utilizzati.
4.10 disp(), fprintf() e sprintf() — Presentare i risultati
GNU Octave offre diverse funzioni per visualizzare e formattare i risultati.
disp() mostra direttamente il contenuto di una variabile:
disp(temperature_C);È particolarmente comoda per visualizzare vettori e matrici senza dover specificare manualmente la formattazione di ogni elemento.
fprintf() consente invece di costruire messaggi formattati:
fprintf('Maximum temperature: %.2f degC\n', maximum_C);La sequenza %.2f indica che il numero deve essere visualizzato con due cifre decimali.
\n inserisce un carattere di nuova riga.
Altri formati comuni sono:
| Formato | Significato |
|---|---|
%d | Numero intero |
%f | Numero in virgola mobile |
%.2f | Numero con due cifre decimali |
%.4f | Numero con quattro cifre decimali |
%s | Stringa |
\n | Nuova riga |
La funzione sprintf() utilizza una sintassi simile a fprintf(), ma invece di scrivere il risultato nel flusso di output restituisce una stringa.
Per esempio:
dataset_id = sprintf('octave_l03_sensor_%s', 'a');produce:
octave_l03_sensor_aQuesta funzione è utilizzata nello script per costruire dinamicamente i nomi dei Dataset.
In altri punti compare anche upper(), che converte una stringa in maiuscolo e permette, per esempio, di trasformare il nome del sensore da a ad A nella sua etichetta descrittiva.
4.11 cell() — Lavorare con i cell array
Finora abbiamo utilizzato soprattutto vettori e matrici numeriche.
Octave dispone però anche dei cell array, strutture che permettono di memorizzare elementi di tipo e dimensione differenti.
La funzione:
items = cell(1, 3);crea un cell array con una riga e tre celle inizialmente vuote.
Possiamo assegnare valori alle singole celle:
items{1} = 10;
items{2} = 'Sensor A';
items{3} = [1, 2, 3];
In questo caso il primo elemento è uno scalare, il secondo una stringa e il terzo un vettore.
La differenza fra parentesi tonde e graffe è importante.
items(2)restituisce un cell array contenente la seconda cella.
items{2}restituisce invece il contenuto della cella, cioè la stringa 'Sensor A'.
Nel nostro script utilizziamo:
series_requests = cell(1, n_sensors + 1);per preparare un contenitore con quattro richieste di pubblicazione.
Ciascuna cella conterrà una struttura che descrive un Dataset scientifico.
4.12 struct() — Rappresentare dati con campi nominati
Un’altra struttura fondamentale di Octave è la struct, che consente di associare nomi a valori.
Consideriamo:
sensor = struct( ...
  'name', 'Sensor A', ...
  'unit', 'degC', ...
  'value', 20.5);
Abbiamo creato una struttura con tre campi:
name, che identifica il sensore;unit, che descrive l’unità di misura;value, che contiene il valore numerico.
Per accedere a un campo utilizziamo la notazione con il punto:
sensor.valueIl risultato è:
20.5La funzione struct() è particolarmente importante nell’integrazione con GX-TXT, perché molte API pubbliche accettano argomenti strutturati e restituiscono risultati organizzati in campi nominati.
Nel nostro script, per esempio, un operando numerico destinato all’API GX-TXT viene dichiarato come:
matrix_C = struct( ...
  'kind', 'matrix', ...
  'value', temperature_C);
In questo modo il framework riceve sia il contenuto numerico sia l’indicazione della sua natura matriciale.
Per verificare il tipo e la presenza dei campi, Octave offre anche isstruct() e isfield().
Un esempio:
isstruct(sensor)
isfield(sensor, 'value')
Entrambe le espressioni restituiscono vero.
Queste funzioni sono utilizzate nello script per esaminare il contesto ricevuto da GX-TXT prima di accedere ad alcuni campi opzionali.
4.13 error() e il controllo dell’esecuzione
La funzione error() interrompe l’esecuzione generando un errore con un messaggio descrittivo.
Per esempio:
if (!isfinite(temperature_C(1, 1)))
  error('Invalid temperature measurement.');
endif
La condizione controlla il primo valore della matrice. Se non è finito, lo script viene interrotto.
Nel nostro esperimento error() viene utilizzata soprattutto quando una funzionalità pubblica richiesta non è disponibile.
L’obiettivo è evitare che uno script prosegua utilizzando un comportamento diverso da quello previsto o produca risultati la cui elaborazione non è stata completata correttamente.
Nello script compaiono anche strutture if e for, utilizzate per controllare l’esecuzione e preparare le richieste di pubblicazione.
Non le approfondiremo qui: condizioni, cicli e funzioni costituiscono l’argomento principale della Lezione 04. Per ora è sufficiente sapere che if esegue un blocco quando una condizione è soddisfatta, mentre for permette di ripetere un blocco per una sequenza di valori.
Con queste funzioni abbiamo completato gli strumenti nativi necessari a comprendere lo script.
Possiamo ora introdurre le API pubbliche di GX-TXT, osservando come il framework utilizza e restituisce valori numerici strutturati.
5. Utilizzare le API pubbliche GX-TXT da GNU Octave
Nelle sezioni precedenti abbiamo utilizzato GNU Octave per organizzare ed elaborare direttamente i dati sperimentali.
Ora affrontiamo la seconda componente del corso: l’integrazione con GX-TXT.
Lo scopo non è sostituire le normali funzioni del linguaggio, ma comprendere come uno script Octave possa utilizzare i servizi pubblici del framework per eseguire elaborazioni, gestire dati scientifici e pubblicare risultati all’interno della Session.
In questa lezione utilizzeremo tre interfacce pubbliche:
- OCTAVE_SCRIPT_BRIDGE_API_v1, per comunicare con il framework.
- NUMERIC_API_v1, per effettuare operazioni numeriche attraverso il servizio Numeric.
- DATASET_PUBLICATION_API_v2, per pubblicare Dataset scientifici gestiti da GX-TXT.
Le firme e i contratti riportati di seguito sono stati verificati sui sorgenti GitHub di GX-TXT 0.9.8.10-dev-111, commit 4daf135e49378eff1f413310bc17cf32f1928c44.
5.1 Perché utilizzare il GX-TXT Script Bridge
GNU Octave dispone già di numerose funzioni matematiche e scientifiche.
Tuttavia, un programma eseguito all’interno di GX-TXT deve anche poter interagire con il framework senza accedere direttamente alle sue strutture interne.
Per questo scopo viene utilizzato lo Script Bridge, un’interfaccia pubblica attraverso cui uno script può individuare le API disponibili e invocarne le operazioni registrate.
Il Bridge distingue il codice scritto dall’utente dai servizi del framework e consente di scambiare valori strutturati, comprese matrici, vettori, celle e strutture Octave.
Non fornisce un accesso indiscriminato alle funzioni interne di GX-TXT: gli script possono richiamare soltanto le operazioni pubbliche registrate ed esposte per l’esecuzione.
Nel nostro caso, il ciclo di vita del Bridge è gestito automaticamente dallo Script Runner.
Non dobbiamo quindi avviare o arrestare manualmente il collegamento.
Questo è un principio importante per tutto il corso: lo script utilizza il framework attraverso le interfacce pubbliche, lasciando al CORE la gestione delle proprie risorse e dei propri servizi.
5.2 gxtxt_context() — Conoscere il contesto di esecuzione
La prima funzione pubblica utilizzata è:
context = gxtxt_context();La funzione restituisce una struttura contenente informazioni sul contesto in cui lo script è in esecuzione.
Tra i campi pubblici possono comparire l’identità del modulo, l’identificativo dell’esecuzione, il nome dello script, la sua impronta SHA-256 e i binding degli input scientifici.
Lo script verifica se è disponibile il nome della registrazione:
if (isstruct(context) && isfield(context, 'script_name'))
  fprintf('Registered script: %s\n', context.script_name);
endif
La verifica impedisce di accedere direttamente a un campo che potrebbe non essere presente.
Nel nostro collaudo, il framework ha restituito il nome dello script registrato e lo ha riportato nel log di esecuzione.
Scopo didattico: imparare a interrogare il contesto pubblico di esecuzione, anziché ricostruirlo leggendo configurazioni o percorsi interni.
5.3 gxtxt_api_require() — Dichiarare le dipendenze pubbliche
Uno script scientifico deve conoscere quali servizi sono necessari per il proprio funzionamento.
Nel nostro esperimento il modulo numerico è obbligatorio.
Lo dichiariamo con:
gxtxt_api_require('NUMERIC_API_v1@1:math.numeric');La dichiarazione specifica:
| Elemento | Significato |
|---|---|
NUMERIC_API_v1 | Identificativo dell’API pubblica |
@1 | Versione richiesta dell’API |
math.numeric | Identità del provider |
Questa notazione permette di richiedere una precisa interfaccia pubblica e il relativo provider.
È importante distinguere la versione dell’API dalla versione generale del programma: GX-TXT può evolversi mantenendo stabile una determinata API pubblica.
Analogamente, per la pubblicazione dei Dataset utilizziamo:
gxtxt_api_require('DATASET_PUBLICATION_API_v2@2:dataset_publication');Questa richiesta viene eseguita soltanto se la pubblicazione è abilitata.
L’uso di gxtxt_api_require() ci consente di individuare immediatamente una dipendenza mancante, prima di arrivare alle operazioni scientifiche che la utilizzano.
5.4 gxtxt_api_has_operation() — Verificare una funzionalità specifica
La presenza di un’API non implica necessariamente che ogni sua operazione sia disponibile attraverso lo Script Bridge nella configurazione corrente.
Per questo GX-TXT mette a disposizione:
gxtxt_api_has_operation(api_id, operation)La funzione restituisce un valore logico che indica se l’operazione richiesta è esposta e disponibile allo script.
Nel nostro caso controlliamo:
gxtxt_api_has_operation('NUMERIC_API_v1', 'array_binary')e:
gxtxt_api_has_operation('NUMERIC_API_v1', 'array_reduce')Lo script esegue questi controlli prima di iniziare a richiamare il servizio numerico.
La verifica non dimostra che qualsiasi insieme di argomenti produrrà un risultato valido: indica che quella specifica operazione è registrata e richiamabile.
La validazione degli argomenti avverrà quando la invocheremo.
Questo controllo preliminare è chiamato spesso preflight ed è utile per rendere più chiari gli eventuali problemi di compatibilità.
5.5 gxtxt_api_call() — Invocare un servizio pubblico
La funzione principale per comunicare con GX-TXT è:
result = gxtxt_api_call(api_id, operation, args);I tre argomenti hanno ruoli distinti.
api_id identifica l’interfaccia pubblica da utilizzare.
operation identifica la funzione esposta dall’API.
args contiene gli argomenti posizionali dell’operazione, organizzati in un cell array Octave.
Per esempio:
result = gxtxt_api_call( ...
  'NUMERIC_API_v1', ...
  'array_binary', ...
  {'add', matrix_C, kelvin_offset});
In questa chiamata:
- selezioniamo il servizio
NUMERIC_API_v1; - richiediamo l’operazione
array_binary; - specifichiamo l’azione matematica
'add'; - forniamo i due operandi
matrix_Cekelvin_offset.
Il risultato viene restituito a Octave come una struttura, secondo il contratto dell’operazione chiamata.
Il Bridge non richiede allo script di conoscere i dettagli con cui il CORE implementa la funzione.
5.6 Rappresentare gli operandi numerici
Prima di eseguire un calcolo attraverso NUMERIC_API_v1, dobbiamo preparare gli operandi nel formato previsto dall’API.
Per le operazioni generiche sugli array, il contratto utilizzato nello script prevede una struttura con almeno due campi:
kind, che identifica la natura dell’operando;value, che contiene il suo valore numerico.
I tipi di operando ammessi da queste operazioni comprendono scalar, vector e matrix.
Nel nostro esperimento creiamo:
matrix_C = struct( ...
  'kind', 'matrix', ...
  'value', temperature_C);
Il campo kind dichiara che stiamo fornendo una matrice, mentre value contiene le 18 temperature in gradi Celsius.
Prepariamo quindi uno scalare:
kelvin_offset = struct( ...
  'kind', 'scalar', ...
  'value', 273.15);
Questa struttura rappresenta il valore da aggiungere a ciascuna temperatura per ottenere il corrispondente valore in kelvin.
L’operazione numerica resta distinta dal significato fisico del calcolo: il framework esegue l’addizione richiesta, mentre lo script stabilisce che il numero 273.15 rappresenta l’offset della conversione Celsius–kelvin.
5.7 NUMERIC_API_v1.array_binary — Operazioni tra array
L’operazione array_binary permette di eseguire diverse operazioni matematiche su coppie di operandi numerici.
Tra le azioni documentate troviamo:
| Azione | Scopo |
|---|---|
add | Addizione |
subtract | Sottrazione |
multiply | Moltiplicazione elemento per elemento |
divide | Divisione elemento per elemento |
power | Elevamento a potenza elemento per elemento |
minimum | Minimo tra elementi corrispondenti |
maximum | Massimo tra elementi corrispondenti |
Queste operazioni supportano l’espansione di uno scalare rispetto a un array.
Due operandi non scalari, invece, devono rispettare i vincoli dimensionali previsti dal contratto.
Nel nostro script utilizziamo l’addizione per convertire tutte le temperature:
kelvin_result = gxtxt_api_call( ...
  'NUMERIC_API_v1', 'array_binary', ...
  {'add', matrix_C, kelvin_offset});

temperature_K = kelvin_result.values;
Il primo comando richiede al servizio Numeric di aggiungere 273,15 a ogni elemento della matrice.
Il secondo estrae il campo values dalla struttura restituita.
La matrice risultante mantiene le dimensioni 6 × 3:
292.95   293.25   293.05
293.45   293.55   293.35
293.95   294.05   293.75
294.25   294.45   294.15
294.15   294.35   294.05
293.75   293.95   293.65
Questo risultato coincide con quello ottenibile attraverso l’operazione nativa Octave:
temperature_C + 273.15Ma le due istruzioni non hanno lo stesso ruolo architetturale.
La prima utilizza un servizio numerico pubblico di GX-TXT attraverso un contratto documentato.
La seconda è una normale operazione eseguita direttamente dal linguaggio Octave.
Nello sviluppo di applicazioni integrate nel framework è importante sapere quale livello sta eseguendo il calcolo.
Utilizziamo poi la sottrazione:
reference_operand = struct( ...
  'kind', 'scalar', ...
  'value', reference_C);

deviation_result = gxtxt_api_call( ...
  'NUMERIC_API_v1', 'array_binary', ...
  {'subtract', matrix_C, reference_operand});

deviation_C = deviation_result.values;
In questo caso otteniamo le differenze rispetto alla temperatura di riferimento di 20 °C.
Per il sensore B al minuto 10, il risultato è:
0.90 °CQuesta grandezza è una differenza di temperatura, non una temperatura assoluta.
Le operazioni array_binary non effettuano automaticamente conversioni di unità fisiche basate sui nomi delle variabili Octave. La corretta interpretazione dei risultati deve essere mantenuta esplicitamente nel codice e nei metadati dei Dataset pubblicati.
5.8 NUMERIC_API_v1.array_reduce — Riduzioni lungo gli assi
Una delle funzionalità più importanti delle API numeriche è la possibilità di ridurre una matrice lungo una dimensione scelta.
Per riduzione intendiamo un’operazione che combina più elementi per ottenere un insieme più piccolo di risultati.
Esempi comuni sono somma, media, minimo e massimo.
L’operazione pubblica utilizzata è:
result = gxtxt_api_call( ...
  'NUMERIC_API_v1', ...
  'array_reduce', ...
  {action, operand, options});
Il parametro action indica il tipo di riduzione.
operand contiene l’array numerico.
options specifica le opzioni previste dal contratto, tra cui l’asse di riduzione.
Per gli array bidimensionali utilizzati nella lezione, possiamo scegliere:
| Asse | Significato |
|---|---|
axis = 0 | Riduce tutti gli elementi a un risultato globale |
axis = 1 | Riduce lungo le righe, producendo un risultato per colonna |
axis = 2 | Riduce lungo le colonne, producendo un risultato per riga |
La numerazione degli assi segue il contratto di NUMERIC_API_v1, che include il valore speciale 0 per la riduzione globale.
Questa convenzione va distinta dalla normale indicizzazione Octave, che inizia da 1.
Media temporale dei sensori
Per calcolare la media di ciascuna colonna utilizziamo:
sensor_mean_result = gxtxt_api_call( ...
  'NUMERIC_API_v1', 'array_reduce', ...
  {'mean', matrix_C, struct('axis', 1)});
La struttura restituita contiene i risultati numerici nel campo values.
Lo script li dispone come vettore riga:
sensor_mean_C = sensor_mean_result.values(:).';Otteniamo:
20.6000 20.7833 20.5167Abbiamo quindi una media per ciascun sensore.
Media tra i sensori a ogni istante
Per ottenere invece una media per ogni riga:
time_mean_result = gxtxt_api_call( ...
  'NUMERIC_API_v1', 'array_reduce', ...
  {'mean', matrix_C, struct('axis', 2)});
Il risultato viene trasformato in un vettore colonna:
time_mean_C = time_mean_result.values(:);Otteniamo sei valori, uno per ciascun istante temporale.
La scelta dell’asse non è soltanto una questione di sintassi: determina quali osservazioni vengono combinate e quindi il significato del risultato.
Massimo globale
Per determinare il valore massimo dell’intera matrice:
maximum_result = gxtxt_api_call( ...
  'NUMERIC_API_v1', 'array_reduce', ...
  {'maximum', matrix_C, struct('axis', 0)});

maximum_C = maximum_result.values;
Otteniamo:
21.30 °CLa posizione del massimo viene poi individuata con la funzione nativa find(), come spiegato nella Sezione 4.
È utile sottolineare che il risultato completo di array_reduce può includere anche informazioni sulla riduzione eseguita, come l’azione, l’asse richiesto, la forma dell’array originale e i conteggi delle osservazioni utilizzate.
Il campo values contiene i risultati numerici; gli altri campi permettono ai servizi del framework di mantenere un resoconto più esplicito dell’operazione.
5.9 Verifica indipendente dei risultati numerici
Una caratteristica importante dello script è che non si limita ad accettare i risultati forniti dall’API.
Li confronta con gli equivalenti ottenuti tramite le funzioni native di Octave.
Per esempio:
assert(max(abs(sensor_mean_C - mean(temperature_C, 1))) < 1e-10);Qui stiamo confrontando:
- la media calcolata attraverso
NUMERIC_API_v1; - la media calcolata attraverso la funzione nativa
mean().
Se la differenza massima supera la tolleranza stabilita, assert() interrompe l’esecuzione.
Lo script effettua controlli analoghi per la media per istante e per il massimo globale.
Nel collaudo effettuato all’interno di GX-TXT, tutti questi controlli sono stati superati.
Il log termina infatti con il messaggio:
Lesson 03 numerical checks: PASSED.
GX-TXT didactic experiment completed.
Questa verifica non dimostra che ogni operazione Numeric funzionerà correttamente su qualsiasi dato, ma conferma che, per il nostro esperimento e per gli input scelti, il servizio GX-TXT e le funzioni native Octave restituiscono risultati coerenti entro le tolleranze adottate.
5.10 DATASET_PUBLICATION_API_v2 — Pubblicare i risultati nella Session
Finora i valori elaborati esistono come variabili in memoria all’interno del processo Octave.
Per renderli disponibili agli altri componenti di GX-TXT dobbiamo pubblicarli come Dataset scientifici.
A questo scopo utilizziamo DATASET_PUBLICATION_API_v2.
Questa API si occupa della pubblicazione attraverso il sistema gestito dal framework, con identità dei Dataset, descrittori delle variabili, scelta del backend di memorizzazione, validazione e aggiornamento del registro della Session.
Il nostro script non deve costruire manualmente percorsi di destinazione, modificare il Dataset Registry o scrivere direttamente file interni per registrare nuovi Dataset.
È il framework a gestire questi aspetti.
Per l’esperimento utilizziamo l’operazione:
gxtxt_api_call( ...
  'DATASET_PUBLICATION_API_v2', ...
  'publish_series_batch', ...
  {batch_request});
L’operazione permette di pubblicare un gruppo di serie scientifiche X/Y attraverso una transazione atomica.
Per comprenderne il funzionamento dobbiamo esaminare prima la struttura delle richieste.
5.11 Costruire una richiesta di pubblicazione
Ogni sensore deve produrre un Dataset contenente una variabile temporale e una variabile di temperatura.
Per questo definiamo le informazioni scientifiche che descrivono ciascuna serie.
La struttura contiene campi fondamentali come:
| Campo | Significato |
|---|---|
dataset_id | Identificativo stabile del Dataset |
contract | Contratto dei dati pubblicati |
storage | Backend di memorizzazione richiesto |
x_values | Valori della variabile X |
y_values | Valori della variabile Y |
x_variable | Descrittore scientifico della variabile X |
y_variable | Descrittore scientifico della variabile Y |
notes | Note descrittive |
Nel nostro caso il contratto è table.generic, perché stiamo pubblicando normali serie tabellari di misure.
Lo script richiede esplicitamente storage = 'csv', una scelta adeguata alle piccole serie utilizzate nell’esperimento.
Per applicazioni più grandi potremmo valutare il sistema di selezione automatica del backend o i servizi di scrittura multidimensionale, ma non sono necessari per questa lezione.
Identità delle variabili
Ogni Dataset contiene due variabili con identità distinte.
Il descrittore temporale è simile a:
x_variable = struct( ...
  'variable_id', 'time', ...
  'name', 'time_min', ...
  'display_label', 'Elapsed time', ...
  'unit', 'min', ...
  'semantic_role', 'time');
Il campo variable_id fornisce l’identificativo logico della variabile.
name contiene il nome scientifico o tecnico associato.
display_label specifica una descrizione destinata alla presentazione.
unit definisce l’unità di misura.
semantic_role dichiara il ruolo scientifico della variabile, in questo caso il tempo.
Per le temperature utilizziamo un descrittore analogo, dichiarando l’unità K e il ruolo temperature.
Queste informazioni non sono semplici etichette decorative.
Permettono ai servizi che leggono il Dataset di conoscere l’identità delle variabili e il loro contesto scientifico senza dover dedurre tali informazioni dal nome delle colonne o dal percorso fisico del file.
L’identità logica rimane così distinta dalla rappresentazione utilizzata per conservare i valori.
5.12 Preparare quattro Dataset
Per pubblicare i risultati dei tre sensori prepariamo una sequenza di richieste.
Lo script crea un cell array:
series_requests = cell(1, n_sensors + 1);Poiché i sensori sono tre, vengono riservate quattro celle.
Le prime tre corrispondono ai sensori A, B e C.
La quarta sarà destinata alla temperatura media aritmetica.
Lo script prepara i nomi dei sensori:
sensor_names = {'a', 'b', 'c'};e costruisce gli identificativi dei Dataset con sprintf().
Le serie dei tre sensori vengono estratte dalle rispettive colonne della matrice temperature_K.
Per esempio, la colonna del sensore A è:
temperature_K(:, 1)e contiene sei valori in kelvin, uno per ogni istante temporale.
Il ciclo for presente nello script ripete la preparazione delle richieste per tutti e tre i sensori.
Questo è un primo esempio di combinazione tra programmazione Octave e costruzione di oggetti destinati alle API pubbliche.
Il funzionamento generale dei cicli sarà approfondito nella Lezione 04.
5.13 Preparare il Dataset della temperatura media
Il quarto Dataset contiene la media aritmetica delle tre temperature a ciascun istante.
Abbiamo già calcolato questa grandezza in gradi Celsius tramite l’operazione array_reduce con axis = 2.
Prima della pubblicazione la convertiamo in kelvin:
time_mean_K = time_mean_C + 273.15;La variabile scientifica corrispondente viene dichiarata con identificativo:
temperature_meane unità:
KIl Dataset risultante ha identificativo:
octave_l03_meanÈ importante osservare che questo Dataset contiene la media aritmetica tra i tre sensori, con contributi uguali per ciascuno.
Non contiene la media pesata calcolata precedentemente come esempio di moltiplicazione matrice-vettore.
Nella pubblicazione scientifica, distinguere grandezze apparentemente simili ma definite in modo diverso è fondamentale per evitare interpretazioni errate dei risultati.
5.14 Eseguire la pubblicazione atomica
Una volta preparate le quattro richieste, lo script le inserisce in una struttura:
batch_request = struct();
batch_request.series = series_requests;
Quindi richiama l’API:
publication = gxtxt_api_call( ...
  'DATASET_PUBLICATION_API_v2', ...
  'publish_series_batch', ...
  {batch_request});
Il servizio di pubblicazione riceve le richieste e ne gestisce la validazione e la creazione attraverso le procedure previste dal framework.
L’operazione batch è progettata per essere atomica: le richieste vengono gestite come una singola transazione, evitando che un errore di pubblicazione lasci registrata soltanto una parte dei nuovi Dataset.
L’API restituisce un resoconto della pubblicazione, contenente tra gli altri campi il numero di output e gli identificativi dei Dataset registrati.
Lo script verifica:
assert(publication.output_count == n_sensors + 1);Nel nostro esperimento il valore atteso è 4.
Successivamente, gli identificativi vengono riportati nel log di esecuzione.
Il risultato del collaudo è stato:
Published 4 managed Datasets in one atomic batch.

Dataset: octave_l03_sensor_a
Dataset: octave_l03_sensor_b
Dataset: octave_l03_sensor_c
Dataset: octave_l03_mean
I quattro Dataset sono stati effettivamente registrati nella Session GX-TXT.
L’operazione di pubblicazione, per impostazione predefinita, è di tipo create-only: se un identificativo è già presente, una nuova creazione con lo stesso ID non viene considerata automaticamente un aggiornamento autorizzato.
Per ripetere l’esperimento pubblicando nuovi Dataset nella stessa Session, occorre pertanto scegliere identificativi differenti oppure utilizzare esplicitamente un flusso di sostituzione autorizzato dal contratto pubblico, che non affrontiamo in questa lezione.
5.15 Perché la pubblicazione è separata dal calcolo
A questo punto possiamo osservare l’architettura complessiva dell’esperimento.
La matrice iniziale viene costruita e manipolata tramite GNU Octave.
Le operazioni numeriche selezionate vengono eseguite attraverso il servizio pubblico Numeric.
I risultati da conservare vengono infine registrati utilizzando Dataset Publication API v2.
Questa separazione presenta diversi vantaggi.
Chiarezza del codice. Possiamo distinguere le istruzioni che preparano i dati, quelle che li elaborano e quelle che pubblicano i risultati.
Riproducibilità. Lo script contiene i dati sintetici e le operazioni necessarie a ricostruire l’elaborazione.
Identità scientifica. I risultati pubblicati utilizzano identificativi logici, variabili e descrittori gestiti dal framework.
Gestione delle risorse. Il programma non deve conoscere l’organizzazione interna delle directory o manipolare direttamente i file del Dataset Registry.
Verificabilità. Possiamo controllare i risultati numerici prima di procedere alla pubblicazione e verificare successivamente i Dataset registrati.
È questa la metodologia che adotteremo progressivamente nelle applicazioni più avanzate del corso.
5.16 Il risultato del collaudo reale
Lo script originale della Lezione 03 è stato eseguito all’interno dello Script Workspace di GX-TXT.
Il Job è terminato con stato COMPLETED, codice di uscita 0 e senza errori registrati.
Le verifiche numeriche sono state superate e la pubblicazione dei quattro Dataset è stata confermata dal framework.
I risultati comprendono:
| Risultato | Valore |
|---|---|
| Media del sensore A | 20,600 °C |
| Media del sensore B | 20,783 °C |
| Media del sensore C | 20,517 °C |
| Temperatura massima | 21,300 °C |
| Istante del massimo | 15 min |
| Sensore del massimo | B |
| Dataset pubblicati | 4 |
I Dataset sono stati successivamente consultati nell’interfaccia GX-TXT e utilizzati per produrre le visualizzazioni scientifiche che accompagneranno l’articolo.
Lo script non crea direttamente le immagini dei grafici: pubblica i Dataset che possono poi essere rappresentati attraverso gli strumenti grafici del framework.
Questo completa il percorso che ci eravamo prefissati per la lezione: partire da una matrice Octave, eseguire operazioni scientifiche, verificare i risultati e renderli disponibili attraverso le API pubbliche GX-TXT.
5.17 Riferimenti alle API utilizzate
La lezione utilizza i seguenti contratti pubblici, verificati sul repository ufficiale GX-TXT al commit 4daf135e49378eff1f413310bc17cf32f1928c44:
Octave Script Bridge API v1
Documentazione ufficiale su GitHub
Descrive il collegamento tra GNU Octave e i servizi pubblici GX-TXT, le funzioni di discovery, il contesto di esecuzione e le modalità di invocazione.
Numeric API v1
Documentazione ufficiale su GitHub
Definisce le operazioni matematiche pubbliche, comprese le operazioni sugli array e le riduzioni numeriche.
Dataset Publication API v2
Documentazione ufficiale su GitHub
Definisce la creazione, la validazione e la pubblicazione gestita dei Dataset scientifici.
Versione del framework utilizzata nel collaudo: GX-TXT 0.9.8.10-dev-111.
Linguaggio: GNU Octave.
Script: GXTXT_Octave_L03.m.
Licenza del codice: GNU GPL v3 o successiva.
6. Lo script completo della Lezione 03
Abbiamo imparato a rappresentare i dati sperimentali attraverso vettori e matrici, a utilizzare le funzioni native di GNU Octave e a richiamare le API pubbliche di GX-TXT.
Possiamo ora riunire questi elementi in un programma completo.
Lo script che presentiamo realizza un esperimento simulato con tre sensori di temperatura e sei istanti di acquisizione. Elabora le misure, esegue controlli numerici e pubblica quattro Dataset nella Session GX-TXT.
Il codice è stato eseguito e collaudato con successo utilizzando GX-TXT 0.9.8.10-dev-111.
6.1 Preparazione dello script
Per riprodurre l’esperimento:
- Aprire GX-TXT e creare o selezionare una Session.
- Aprire Octave Script Workspace.
- Creare un nuovo script Octave.
- Copiare integralmente il codice seguente nell’editor.
- Registrarlo con il nome
GXTXT_Octave_L03.m. - Avviare l’esecuzione attraverso lo Script Runner.
Non occorre importare dati esterni: tutte le misure sono già definite nello script.
La pubblicazione dei Dataset è attiva per impostazione predefinita e utilizza quattro identificativi fissi. È quindi consigliabile eseguire lo script in una Session che non contenga già questi Dataset.
6.2 Codice sorgente completo
% SPDX-License-Identifier: GPL-3.0-or-later
%
% GX-TXT GNU Octave Course - Lesson 03
% Vectors, matrices, indexing, and vectorized temperature measurements.
%
% Official source: https://github.com/giuxlab-hub/GX-TXT
% GX-TXT reference: 0.9.8.10-dev-111
% Branch: main
% Reference commit: 4daf135e49378eff1f413310bc17cf32f1928c44
% Source verification date: 2026-10-23
%
% Public API references:
% docs/api/OCTAVE_SCRIPT_BRIDGE_API_v1.md
% plugins/modules/math.numeric/NUMERIC_API_v1.md
% docs/api/DATASET_PUBLICATION_API_v2.md
%
% Run inside the GX-TXT Octave Script Workspace in a disposable Session.
% The GX-TXT runner manages the Script Bridge lifecycle.
% Do not call the internal bridge start/stop functions.
%
% The experiment is synthetic, deterministic, and requires no source files.
% Rows represent observation times; columns represent temperature sensors.
%
% IMPORTANT: Publication is create-only by default. Run this script once per
% Session, or change DATASET_PREFIX before another run in the same Session.
% No script-managed files, private directories, or CORE internals are used.

DATASET_PREFIX = 'octave_l03';
PUBLISH_DATASETS = true;

fprintf('\nGX-TXT - GNU Octave Lesson 03: Vectors and Matrices\n');
fprintf('===================================================\n');

% -------------------------------------------------------------------------
% 1. Inspect the GX-TXT execution context and require public APIs.
% -------------------------------------------------------------------------
% gxtxt_context() returns the script's public execution metadata.
% gxtxt_api_require() verifies an API's identity and provider version.
% gxtxt_api_has_operation() verifies that an operation is script-callable.
% gxtxt_api_call() invokes only an operation registered with the public bridge.

context = gxtxt_context();
if (isstruct(context) && isfield(context, 'script_name'))
  fprintf('Registered script: %s\n', context.script_name);
endif

gxtxt_api_require('NUMERIC_API_v1@1:math.numeric');

if (PUBLISH_DATASETS)
  gxtxt_api_require('DATASET_PUBLICATION_API_v2@2:dataset_publication');
endif

numeric_ops = {'array_binary', 'array_reduce'};
for op_index = 1:numel(numeric_ops)
  if (!gxtxt_api_has_operation('NUMERIC_API_v1', numeric_ops{op_index}))
    error('Missing public numerical operation: %s', numeric_ops{op_index});
  endif
endfor

if (PUBLISH_DATASETS)
  if (!gxtxt_api_has_operation('DATASET_PUBLICATION_API_v2', ...
                               'publish_series_batch'))
    error('The public Dataset batch-publication operation is unavailable.');
  endif
endif

fprintf('Public API preflight: passed.\n');

% -------------------------------------------------------------------------
% 2. Create a row vector, a column vector, and a measurement matrix.
% -------------------------------------------------------------------------
% Row vector: measurements written horizontally with commas or spaces.
% Column vector: observations written vertically with semicolons.
% Octave uses one-based indexing: the first element has index 1.

sensor_ids = [1, 2, 3];
time_min = [0; 5; 10; 15; 20; 25];

% Temperature matrix in degrees Celsius.
% Each row is one observation time.
% Column 1 = Sensor A; column 2 = Sensor B; column 3 = Sensor C.
temperature_C = [
  19.8, 20.1, 19.9;
  20.3, 20.4, 20.2;
  20.8, 20.9, 20.6;
  21.1, 21.3, 21.0;
  21.0, 21.2, 20.9;
  20.6, 20.8, 20.5
];

n_times = rows(temperature_C);
n_sensors = columns(temperature_C);

assert(isequal(size(temperature_C), [numel(time_min), numel(sensor_ids)]));
assert(all(isfinite(temperature_C(:))));
assert(all(diff(time_min) > 0));

fprintf('\n[1] Array shapes and indexing\n');
fprintf('Time vector: %d x %d\n', size(time_min, 1), size(time_min, 2));
fprintf('Sensor vector: %d x %d\n', size(sensor_ids, 1), size(sensor_ids, 2));
fprintf('Temperature matrix: %d x %d (%d elements)\n', ...
        n_times, n_sensors, numel(temperature_C));

% Extract a single element, an entire row, and an entire column.
sample_time_10_sensor_B = temperature_C(3, 2);
measurements_at_10_min = temperature_C(3, :);
sensor_B_series = temperature_C(:, 2);
first_three_times = temperature_C(1:3, :);
last_sensor_series = temperature_C(:, end);

fprintf('Sensor B at 10 min: %.2f degC\n', sample_time_10_sensor_B);
fprintf('Readings at 10 min (degC): '); disp(measurements_at_10_min);
fprintf('All Sensor B readings (degC):\n'); disp(sensor_B_series);
fprintf('First three time rows:\n'); disp(first_three_times);
assert(isequal(last_sensor_series, temperature_C(:, 3)));

% Non-conjugating transpose (.') changes orientation without conjugation.
sensor_ids_column = sensor_ids.';
assert(isequal(size(sensor_ids_column), [3, 1]));

% -------------------------------------------------------------------------
% 3. Compare element-wise arithmetic and matrix multiplication.
% -------------------------------------------------------------------------
% .^ applies a power to each element.  ^ is matrix exponentiation and
% requires a square matrix, which this measurement matrix is not.
% ./ divides corresponding elements; * performs matrix multiplication.

temperature_change_C = temperature_C(2:end, :) - ...
                       temperature_C(1:end-1, :);
step_min = diff(time_min);
step_matrix = step_min * ones(1, n_sensors);
rate_C_per_min = temperature_change_C ./ step_matrix;

% A weighted average is a matrix-vector product: (6 x 3) * (3 x 1).
sensor_weights = [0.25; 0.50; 0.25];
assert(abs(sum(sensor_weights) - 1) < 1e-12);
weighted_mean_C = temperature_C * sensor_weights;

% Element-wise operations are also useful for normalizing each sensor.
reference_C = 20.0;
normalized_ratio = temperature_C ./ reference_C;

fprintf('\n[2] Matrix and element-wise operations\n');
fprintf('Temperature rates in degC/min (five intervals x three sensors):\n');
disp(rate_C_per_min);
fprintf('Weighted temperature at 10 min: %.4f degC\n', weighted_mean_C(3));
fprintf('Normalized Sensor A at 0 min: %.4f\n', normalized_ratio(1, 1));

% -------------------------------------------------------------------------
% 4. Use GX-TXT NUMERIC_API_v1 for calculations on an entire matrix.
% -------------------------------------------------------------------------
% A public numerical operand is a struct with 'kind' and 'value'.
% An operand kind can be scalar, vector, or matrix.
% array_binary('add', ...) performs element-wise addition and scalar
% expansion using the framework's verified numerical service.

matrix_C = struct('kind', 'matrix', 'value', temperature_C);
kelvin_offset = struct('kind', 'scalar', 'value', 273.15);

kelvin_result = gxtxt_api_call( ...
  'NUMERIC_API_v1', 'array_binary', ...
  {'add', matrix_C, kelvin_offset});

temperature_K = kelvin_result.values;

assert(isequal(size(temperature_K), size(temperature_C)));
assert(max(abs(temperature_K(:) - (temperature_C(:) + 273.15))) < 1e-10);

% A second public binary operation computes the deviation from a reference.
reference_operand = struct('kind', 'scalar', 'value', reference_C);
deviation_result = gxtxt_api_call( ...
  'NUMERIC_API_v1', 'array_binary', ...
  {'subtract', matrix_C, reference_operand});
deviation_C = deviation_result.values;

fprintf('\n[3] GX-TXT numerical matrix operations\n');
fprintf('All temperatures converted to kelvin:\n');
disp(temperature_K);
fprintf('Deviation of Sensor B at 10 min: %.2f degC\n', deviation_C(3, 2));

% -------------------------------------------------------------------------
% 5. Reduce along explicit axes through the public NUMERIC API.
% -------------------------------------------------------------------------
% axis = 1: reduce the time dimension -> one mean per sensor.
% axis = 2: reduce the sensor dimension -> one mean per time step.
% axis = 0: reduce all elements -> one scalar.
% Each API result contains a 'values' field and reduction metadata.

sensor_mean_result = gxtxt_api_call( ...
  'NUMERIC_API_v1', 'array_reduce', ...
  {'mean', matrix_C, struct('axis', 1)});

time_mean_result = gxtxt_api_call( ...
  'NUMERIC_API_v1', 'array_reduce', ...
  {'mean', matrix_C, struct('axis', 2)});

maximum_result = gxtxt_api_call( ...
  'NUMERIC_API_v1', 'array_reduce', ...
  {'maximum', matrix_C, struct('axis', 0)});

sensor_mean_C = sensor_mean_result.values(:).';
time_mean_C = time_mean_result.values(:);
maximum_C = maximum_result.values;

% Independently validate GX-TXT's answers with native Octave operations.
assert(numel(sensor_mean_C) == n_sensors);
assert(numel(time_mean_C) == n_times);
assert(max(abs(sensor_mean_C - mean(temperature_C, 1))) < 1e-10);
assert(max(abs(time_mean_C - mean(temperature_C, 2))) < 1e-10);
assert(abs(maximum_C - max(temperature_C(:))) < 1e-10);

[max_row, max_col] = find(temperature_C == maximum_C, 1, 'first');

fprintf('\n[4] Statistics and maximum measurement\n');
fprintf('Sensor averages (degC): '); disp(sensor_mean_C);
fprintf('Average by time step (degC):\n'); disp(time_mean_C);
fprintf('Maximum: %.2f degC at t=%.0f min, Sensor %d\n', ...
        maximum_C, time_min(max_row), sensor_ids(max_col));

% -------------------------------------------------------------------------
% 6. Publish four independent time/temperature series atomically.
% -------------------------------------------------------------------------
% Dataset Publication API v2 is responsible for storage, stable Dataset IDs,
% variables, units, provenance, rollback, and Session registration.
% publish_series_batch() uses one reviewed, atomic publication transaction.
% The script does not choose a filesystem path or directly write CSV/HDF5.
%
% The first three Datasets contain the sensor measurements in kelvin.
% The fourth contains the mean across sensors in kelvin.
% The matrix itself remains in memory and is taught above as an Octave array.

if (PUBLISH_DATASETS)
  series_requests = cell(1, n_sensors + 1);
  sensor_names = {'a', 'b', 'c'};

  for sensor_index = 1:n_sensors
    dataset_id = sprintf('%s_sensor_%s', DATASET_PREFIX, ...
                         sensor_names{sensor_index});

    series_requests{sensor_index} = struct( ...
      'dataset_id', dataset_id, ...
      'contract', 'table.generic', ...
      'storage', 'csv', ...
      'x_values', time_min, ...
      'y_values', temperature_K(:, sensor_index), ...
      'x_variable', struct( ...
        'variable_id', 'time', 'name', 'time_min', ...
        'display_label', 'Elapsed time', 'unit', 'min', ...
        'semantic_role', 'time'), ...
      'y_variable', struct( ...
        'variable_id', 'temperature', 'name', 'temperature_K', ...
        'display_label', sprintf('Temperature - Sensor %s', ...
                                 upper(sensor_names{sensor_index})), ...
        'unit', 'K', 'semantic_role', 'temperature'), ...
      'notes', 'Synthetic Lesson 03 temperature measurements');
  endfor

  % Convert the time-step means from Celsius to kelvin for publication.
  time_mean_K = time_mean_C + 273.15;

  series_requests{n_sensors + 1} = struct( ...
    'dataset_id', [DATASET_PREFIX '_mean'], ...
    'contract', 'table.generic', ...
    'storage', 'csv', ...
    'x_values', time_min, ...
    'y_values', time_mean_K, ...
    'x_variable', struct( ...
      'variable_id', 'time', 'name', 'time_min', ...
      'display_label', 'Elapsed time', 'unit', 'min', ...
      'semantic_role', 'time'), ...
    'y_variable', struct( ...
      'variable_id', 'temperature_mean', 'name', 'temperature_mean_K', ...
      'display_label', 'Mean temperature of three sensors', ...
      'unit', 'K', 'semantic_role', 'temperature'), ...
    'notes', 'Arithmetic mean at each observation time; synthetic data');

  batch_request = struct();
  batch_request.series = series_requests;

  publication = gxtxt_api_call( ...
    'DATASET_PUBLICATION_API_v2', 'publish_series_batch', {batch_request});

  assert(publication.output_count == n_sensors + 1);

  fprintf('\n[5] Canonical GX-TXT Dataset publication\n');
  fprintf('Published %d managed Datasets in one atomic batch.\n', ...
          publication.output_count);
  for dataset_index = 1:numel(publication.dataset_ids)
    fprintf('Dataset: %s\n', publication.dataset_ids{dataset_index});
  endfor
else
  fprintf('\n[5] Dataset publication disabled by PUBLISH_DATASETS.\n');
endif

fprintf('\nLesson 03 numerical checks: PASSED.\n');
fprintf('GX-TXT didactic experiment completed.\n');
7. Come funziona lo script: dall’acquisizione simulata alla pubblicazione
Il programma segue una sequenza precisa di operazioni. Possiamo distinguere sei fasi principali, che corrispondono ai sei blocchi numerati nei commenti del codice.
7.1 Inizializzazione e verifica dell’ambiente
All’inizio dello script definiamo due variabili di configurazione:
DATASET_PREFIX = 'octave_l03';
PUBLISH_DATASETS = true;
La prima stabilisce la parte iniziale degli identificativi dei Dataset. La seconda abilita o disabilita la pubblicazione dei risultati.
Il programma interroga quindi gxtxt_context() per ottenere informazioni sul proprio ambiente di esecuzione.
Successivamente richiede la disponibilità delle due API pubbliche necessarie: NUMERIC_API_v1 e DATASET_PUBLICATION_API_v2.
Prima di procedere verifica inoltre che le operazioni array_binary, array_reduce e publish_series_batch siano effettivamente disponibili.
Se manca una funzionalità necessaria, lo script si interrompe con un messaggio diagnostico. In questo modo non avvia un’elaborazione che non potrebbe completare correttamente.
7.2 Costruzione della matrice sperimentale
Il secondo blocco definisce il vettore temporale e la matrice delle temperature.
Il vettore time_min contiene sei istanti, da 0 a 25 minuti.
La matrice temperature_C contiene 18 misure: sei per ciascuno dei tre sensori.
Il programma verifica che le dimensioni delle strutture siano coerenti, che i valori delle temperature siano finiti e che gli istanti temporali siano strettamente crescenti.
Esegue inoltre alcune operazioni di indicizzazione per estrarre singoli valori, righe, colonne e intervalli della matrice.
Questa fase dimostra come Octave possa rappresentare i dati sperimentali mantenendo una corrispondenza precisa tra tempo e sensore.
7.3 Elaborazione diretta in GNU Octave
Il terzo blocco esegue le prime elaborazioni numeriche senza ricorrere alle API del framework.
Calcola le differenze tra acquisizioni successive e le divide per gli intervalli temporali, ottenendo le velocità medie di variazione della temperatura in °C/min.
Successivamente costruisce un vettore di pesi e lo moltiplica per la matrice delle temperature.
Questa singola moltiplicazione matrice-vettore fornisce sei medie pesate, una per ciascun istante temporale.
Infine calcola un rapporto numerico rispetto al valore di riferimento di 20 °C. Come spiegato nella Sezione 3, questo ultimo calcolo è un esercizio numerico, non una normalizzazione termodinamica delle temperature assolute.
7.4 Elaborazione attraverso NUMERIC_API_v1
Nel quarto blocco lo script prepara gli operandi numerici come strutture Octave contenenti il tipo di dato e il valore.
Attraverso array_binary richiede al servizio Numeric di sommare 273,15 a tutti gli elementi della matrice delle temperature.
Ottiene così una nuova matrice in kelvin, mantenendo la stessa organizzazione in sei righe e tre colonne.
Utilizza poi una seconda chiamata per calcolare la differenza tra ciascuna temperatura e il valore di riferimento.
Il programma verifica che la conversione ottenuta tramite GX-TXT coincida, entro una tolleranza stabilita, con quella calcolata direttamente da Octave.
7.5 Riduzioni statistiche e controllo dei risultati
Il quinto blocco utilizza array_reduce per eseguire tre operazioni distinte sulla matrice.
La prima calcola la media temporale di ciascun sensore.
La seconda determina la media aritmetica dei tre sensori a ciascun istante.
La terza individua la temperatura massima dell’intera matrice.
I risultati vengono verificati utilizzando le funzioni native mean() e max().
Il programma identifica inoltre l’istante temporale e il sensore corrispondenti al valore massimo.
Questa fase illustra un principio importante della programmazione scientifica: non basta ottenere un risultato numerico, ma occorre anche verificarne la coerenza rispetto a un metodo di riferimento.
7.6 Pubblicazione dei quattro Dataset
L’ultimo blocco trasforma i risultati selezionati in quattro serie scientifiche.
Le prime tre contengono le temperature in kelvin dei sensori A, B e C, ciascuna associata al vettore dei tempi.
Il quarto Dataset contiene la media aritmetica delle temperature dei tre sensori, anch’essa espressa in kelvin.
Ogni richiesta include un identificativo, il contratto table.generic, le variabili scientifiche, le unità di misura e le informazioni descrittive.
Lo script raccoglie le richieste in una struttura e le invia a DATASET_PUBLICATION_API_v2, utilizzando l’operazione publish_series_batch.
La pubblicazione è gestita dal framework in una transazione atomica.
I Dataset creati sono:
| Dataset | Contenuto |
|---|---|
octave_l03_sensor_a | Temperature del sensore A |
octave_l03_sensor_b | Temperature del sensore B |
octave_l03_sensor_c | Temperature del sensore C |
octave_l03_mean | Media aritmetica dei tre sensori |
Ciascun Dataset contiene sei osservazioni temporali.
La media pesata calcolata in precedenza non viene pubblicata: rimane una variabile Octave utilizzata per illustrare il prodotto matrice-vettore.
7.7 Risultato complessivo
Al termine dell’elaborazione, lo script verifica che il numero dei Dataset pubblicati sia esattamente quattro.
Se tutti i controlli sono stati superati, visualizza:
Lesson 03 numerical checks: PASSED.
GX-TXT didactic experiment completed.
Questi messaggi sono stati effettivamente ottenuti durante il collaudo della Lezione 03.
Abbiamo quindi costruito un esperimento riproducibile nel quale GNU Octave si occupa della rappresentazione e dell’elaborazione matriciale dei dati, mentre GX-TXT mette a disposizione servizi numerici pubblici e un sistema gestito di pubblicazione scientifica.
Nella prossima sezione documenteremo l’esecuzione reale dello script all’interno di GX-TXT e analizzeremo i quattro Dataset prodotti.
8. Esecuzione pratica in GX-TXT e verifica dei risultati
Dopo aver analizzato il codice e il funzionamento delle API pubbliche, possiamo osservare ciò che accade quando eseguiamo realmente lo script all’interno di GX-TXT.
L’esperimento è stato collaudato utilizzando GX-TXT 0.9.8.10-dev-111 e GNU Octave 10.0.
L’esecuzione si è conclusa correttamente, tutte le verifiche numeriche sono state superate e i quattro Dataset previsti sono stati pubblicati nella Session.
In questa sezione ripercorreremo le operazioni eseguite e analizzeremo i risultati attraverso l’interfaccia del framework.
8.1 Importazione dello script nello Script Workspace
Il primo passaggio consiste nel registrare il programma all’interno di GX-TXT.
Dopo aver aperto la Session destinata all’esperimento, accediamo a Octave Script Workspace.
Qui possiamo creare un nuovo script, incollare il codice della Sezione 6 e salvarlo nel registro degli script della Session.
Per il nostro esperimento abbiamo utilizzato il seguente nome:
Lesson 03 — Vectors and Matrices: Temperature Measurements
Il suo identificativo registrato è:
session:GXTXT_Octave_L03.m
Questo identificativo permette al framework di distinguere lo script da altri programmi registrati.
Nello Script Workspace possiamo osservare il codice sorgente, il nome dello script, la descrizione e il relativo identificativo.
La registrazione è importante anche per la riproducibilità: GX-TXT conserva una revisione del codice e, al momento dell’esecuzione, utilizza una copia identificata tramite un’impronta SHA-256.
In questo modo il sistema può associare il Job al sorgente effettivamente eseguito.
Il programma utilizza esclusivamente le API pubbliche del framework e non richiede la lettura diretta delle directory interne di GX-TXT.
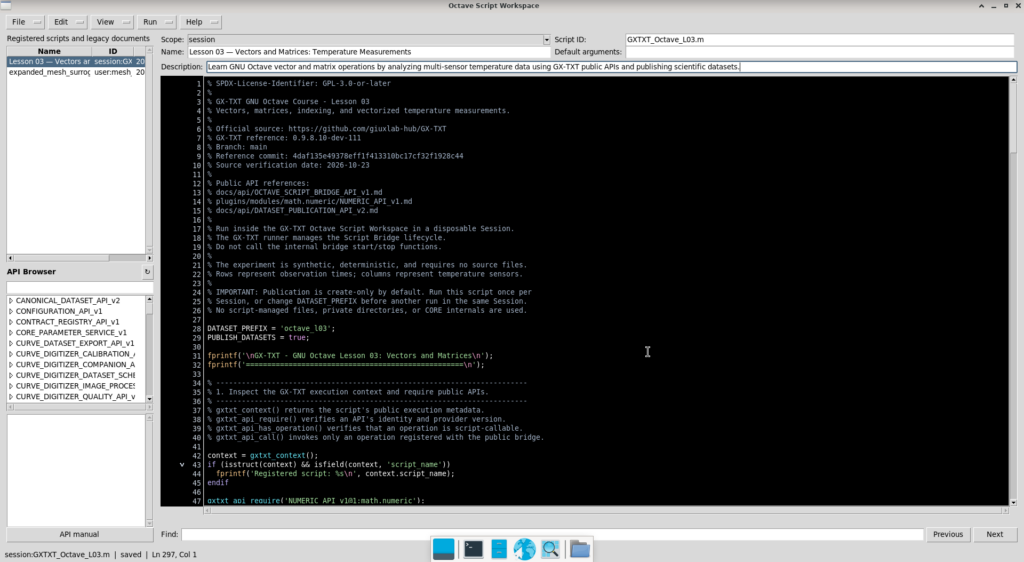
8.2 Avvio dello script e monitoraggio del Job
Una volta registrato lo script, possiamo avviarne l’esecuzione attraverso lo Script Runner.
GX-TXT esegue il programma come un Job supervisionato.
Questo significa che l’esecuzione viene gestita dal framework, anziché essere trattata come un semplice comando Octave avviato manualmente in un terminale.
La finestra Script Jobs permette di osservare lo stato delle esecuzioni e di accedere ai relativi dettagli.
Durante il nostro collaudo, lo script è apparso inizialmente con lo stato:
RUNNING
Questo indica che il processo Octave era ancora in esecuzione.
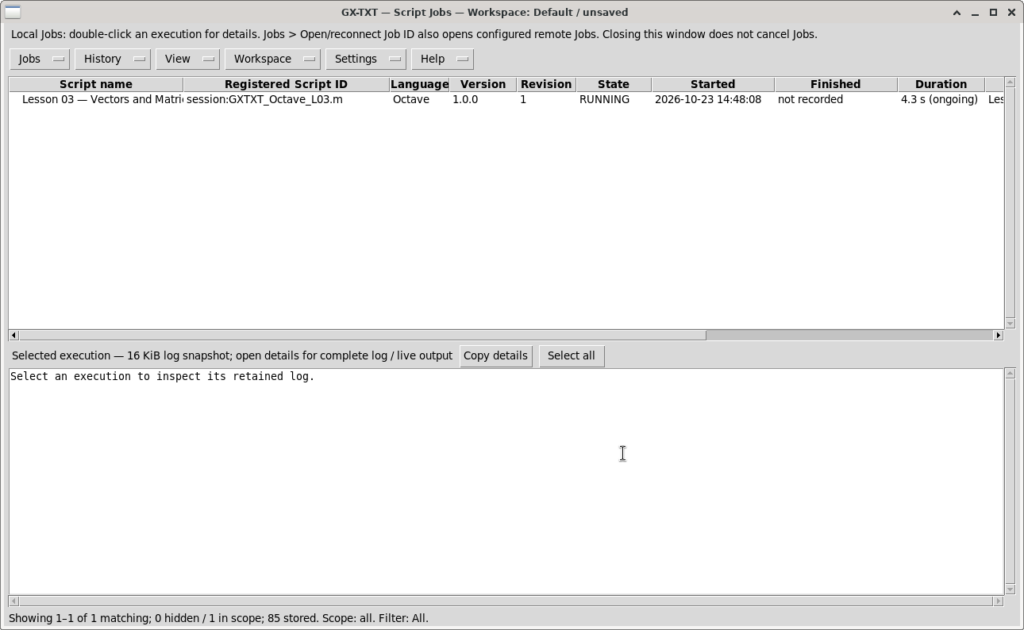
Al termine, il sistema ha registrato:
| Informazione | Risultato |
|---|---|
| Stato finale | COMPLETED |
| Linguaggio | GNU Octave 10.0 |
| Tempo di esecuzione | 10,7 secondi |
| Codice di uscita | 0 |
| Errori registrati | Nessuno |
| Dataset pubblicati | 4 |
Il codice di uscita 0 indica che il processo è terminato correttamente.
Il sistema conserva inoltre informazioni quali il momento di avvio, la durata, l’identità dello script, la revisione utilizzata e il log dell’esecuzione.
Non dobbiamo interpretare il tempo di 10,7 secondi come il tempo necessario alle sole operazioni matriciali: comprende anche la preparazione e la supervisione del Job, l’inizializzazione dell’ambiente, le comunicazioni con il framework e la pubblicazione dei Dataset.
È quindi un tempo relativo all’esecuzione completa dell’esperimento, non una misura delle prestazioni dei singoli algoritmi.
8.3 Leggere e interpretare il log di esecuzione
Terminato il Job, possiamo aprirne i dettagli ed esaminare il log prodotto da GNU Octave.
Il nostro script organizza l’output in blocchi numerati, corrispondenti alle principali fasi dell’elaborazione.
Il primo blocco conferma che le API pubbliche necessarie sono disponibili:
GX-TXT - GNU Octave Lesson 03: Vectors and Matrices
===================================================
Registered script: Lesson 03 — Vectors and Matrices: Temperature Measurements
Public API preflight: passed.
Successivamente vengono riportate le dimensioni degli array:
[1] Array shapes and indexing
Time vector: 6 x 1
Sensor vector: 1 x 3
Temperature matrix: 6 x 3 (18 elements)
Sensor B at 10 min: 20.90 degC
Questi risultati confermano la struttura dei dati discussa nella Sezione 2.
Il vettore temporale contiene sei elementi disposti verticalmente, quello dei sensori ne contiene tre disposti orizzontalmente e la matrice delle temperature contiene 18 elementi.
Il secondo blocco presenta le velocità medie di variazione della temperatura nei cinque intervalli temporali:
[2] Matrix and element-wise operations
Temperature rates in degC/min (five intervals x three sensors):
   0.100000   0.060000   0.060000
   0.100000   0.100000   0.080000
   0.060000   0.080000   0.080000
  -0.020000  -0.020000  -0.020000
  -0.080000  -0.080000  -0.080000
La matrice risultante ha cinque righe e tre colonne.
I valori positivi indicano gli intervalli di riscaldamento, mentre quelli negativi indicano gli intervalli di raffreddamento.
Il terzo blocco conferma la conversione delle temperature in kelvin attraverso NUMERIC_API_v1.
Nel quarto blocco troviamo i risultati statistici:
[4] Statistics and maximum measurement
Sensor averages (degC):    20.600   20.783   20.517

Average by time step (degC):
   19.933
   20.300
   20.767
   21.133
   21.033
   20.633

Maximum: 21.30 degC at t=15 min, Sensor 2
Il sensore B presenta la temperatura media più elevata, mentre il sensore C registra la media più bassa.
La temperatura massima dell’intero esperimento è pari a 21,30 °C, registrata dal sensore B dopo 15 minuti.
Il log conferma infine la pubblicazione dei Dataset:
[5] Canonical GX-TXT Dataset publication
Published 4 managed Datasets in one atomic batch.

Dataset: octave_l03_sensor_a
Dataset: octave_l03_sensor_b
Dataset: octave_l03_sensor_c
Dataset: octave_l03_mean

Lesson 03 numerical checks: PASSED.
GX-TXT didactic experiment completed.
Gli ultimi due messaggi indicano che lo script ha superato i propri controlli numerici e ha raggiunto la fine dell’esecuzione senza errori.
8.4 Individuare i Dataset nella Session
Dopo il completamento del Job possiamo tornare alla finestra principale di GX-TXT.
Apriamo la scheda Dataset, nella quale il framework presenta i Dataset disponibili nella Session.
Nel nostro esperimento i quattro nuovi Dataset sono raggruppati sotto il modulo produttore analysis.octave_script.
Questa organizzazione permette di riconoscere che i dati sono stati pubblicati attraverso l’esecuzione di uno script Octave.
I Dataset presenti sono:
| Identificativo | Variabile X | Variabile Y |
|---|---|---|
octave_l03_sensor_a | Tempo (min) | Temperatura A (K) |
octave_l03_sensor_b | Tempo (min) | Temperatura B (K) |
octave_l03_sensor_c | Tempo (min) | Temperatura C (K) |
octave_l03_mean | Tempo (min) | Temperatura media (K) |
Selezionando uno dei Dataset possiamo accedere alle sue informazioni e utilizzare la scheda Preview per visualizzare i dati scientifici.
Per questo esperimento scegliamo il tempo come variabile X e la temperatura come variabile Y.
Il framework può quindi rappresentare la relazione tra le due grandezze, utilizzando i valori pubblicati dallo script.
È importante comprendere che lo script non genera direttamente quattro immagini di grafici.
Il programma crea quattro Dataset attraverso DATASET_PUBLICATION_API_v2. Le curve mostrate nelle schermate sono invece visualizzazioni prodotte successivamente dall’interfaccia Dataset Preview di GX-TXT.
Questa distinzione riflette la separazione tra il calcolo scientifico, la conservazione dei risultati e la loro rappresentazione grafica.
8.5 Analisi grafica dei quattro Dataset
Le quattro visualizzazioni permettono di osservare l’andamento temporale delle temperature e di confrontare il comportamento dei sensori.
Tutte utilizzano il tempo trascorso, espresso in minuti, sull’asse orizzontale e la temperatura, espressa in kelvin, sull’asse verticale.
Le temperature sono rappresentate in kelvin perché questo è il formato numerico scelto per la pubblicazione dei Dataset.
Sensore A
La curva del sensore A parte da 292,95 K, corrispondenti a 19,8 °C.
Nei primi quindici minuti la temperatura aumenta progressivamente fino a raggiungere 294,25 K, equivalenti a 21,1 °C.
Successivamente diminuisce e raggiunge 293,75 K al minuto 25.
La curva evidenzia quindi una prima fase di riscaldamento e una seconda fase di raffreddamento.
Sensore B
Il sensore B registra temperature leggermente superiori a quelle degli altri sensori durante tutto l’esperimento.
La temperatura iniziale è 293,25 K, corrispondenti a 20,1 °C.
Il valore massimo è 294,45 K, pari a 21,3 °C, raggiunto al minuto 15.
Questa è anche la temperatura massima rilevata nell’intero insieme delle 18 misure.
Il sensore B mostra quindi un andamento simile agli altri due, ma con valori sistematicamente più elevati.
Sensore C
Il sensore C parte da 293,05 K, corrispondenti a 19,9 °C.
La temperatura aumenta fino a 294,15 K, pari a 21,0 °C, al minuto 15.
Successivamente diminuisce, raggiungendo 293,65 K al minuto 25.
Anche questa curva presenta il medesimo andamento generale, ma con valori medi inferiori a quelli degli altri sensori.
Temperatura media dei tre sensori
Il quarto Dataset contiene la media aritmetica delle tre temperature a ciascun istante temporale.
Questa curva permette di descrivere l’evoluzione media del sistema, riducendo le tre serie a una sola.
| Tempo (min) | Temperatura media (K) |
|---|---|
| 0 | 293,083 |
| 5 | 293,450 |
| 10 | 293,917 |
| 15 | 294,283 |
| 20 | 294,183 |
| 25 | 293,783 |
Anche la curva media raggiunge il proprio massimo al minuto 15.
Il massimo della curva media è però inferiore al massimo registrato dal sensore B, perché rappresenta la media dei tre valori misurati in quel momento.
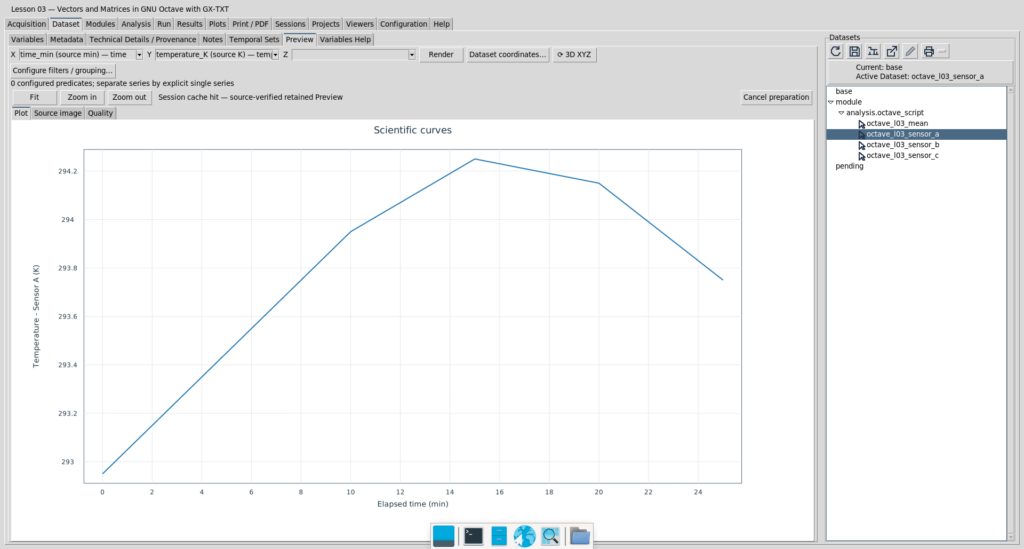
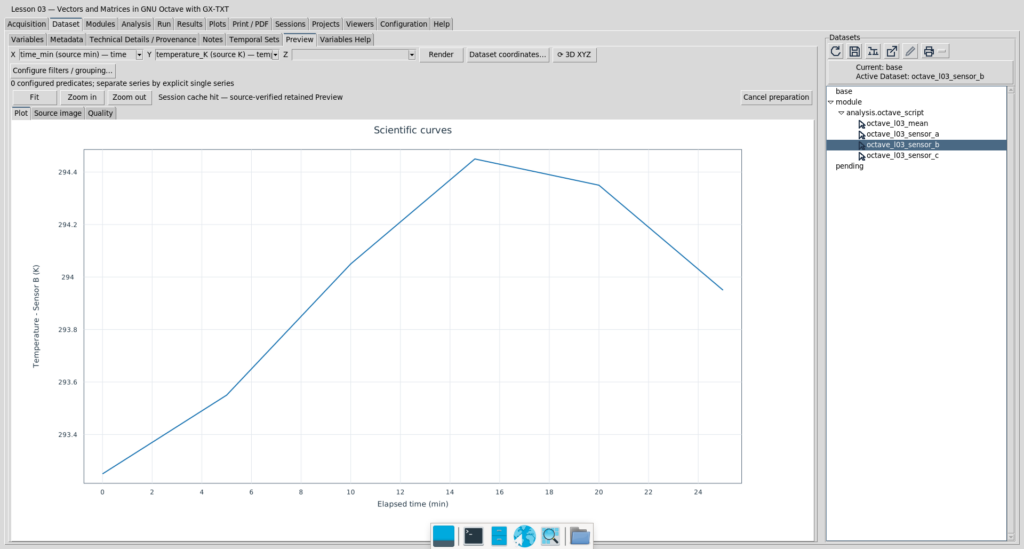
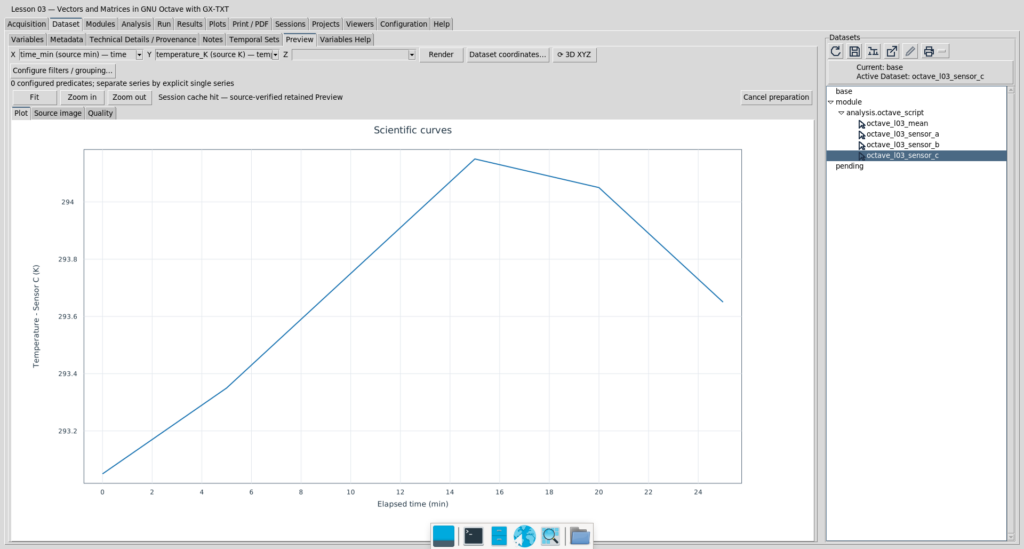
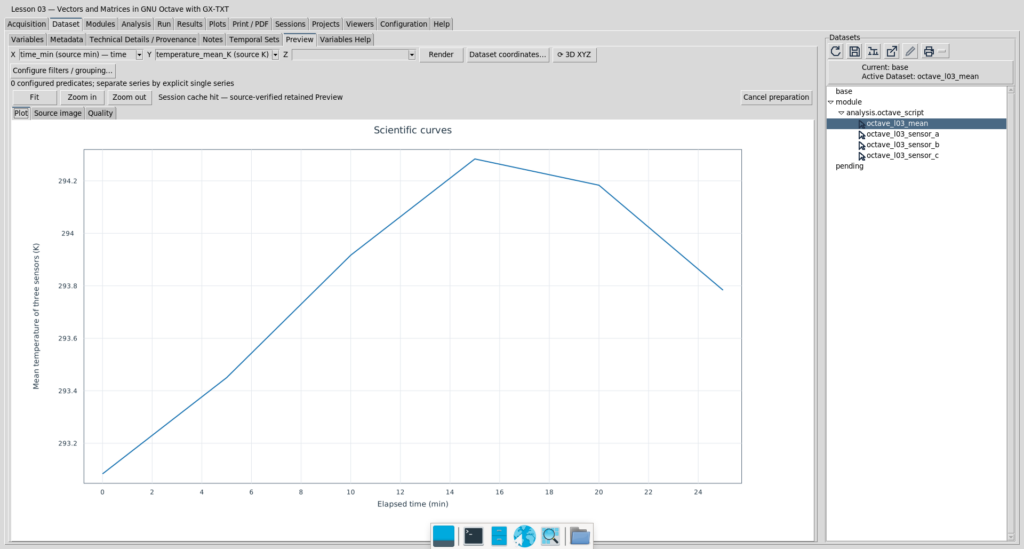
Un’altra osservazione riguarda la scala verticale delle visualizzazioni.
Il sistema di anteprima può adattare automaticamente i limiti dell’asse Y ai valori presenti nel singolo Dataset.
Di conseguenza, due curve visualizzate separatamente possono apparire molto simili anche quando hanno intervalli di temperatura differenti.
Per confrontare quantitativamente i sensori è necessario considerare i valori degli assi e non soltanto la forma apparente delle curve.
8.6 Interpretazione scientifica dei risultati
L’esperimento mostra un comportamento coerente tra i tre sensori.
Tutti registrano una temperatura crescente durante i primi quindici minuti e decrescente durante i dieci minuti successivi.
Il massimo si verifica nello stesso istante per tutti e tre i sensori.
Le differenze tra le temperature misurate non modificano l’andamento generale, ma evidenziano livelli termici leggermente differenti.
In un esperimento reale, queste differenze potrebbero dipendere dalla posizione dei sensori, dalla distribuzione della temperatura nel sistema, dalle caratteristiche degli strumenti o dalle rispettive calibrazioni.
Nel nostro caso, tuttavia, i dati sono sintetici: non possiamo attribuire le differenze osservate a una causa fisica specifica.
L’obiettivo dell’esperimento non è interpretare un processo termico reale, ma dimostrare come organizzare correttamente misure multiple, applicare elaborazioni matriciali e ottenere risultati verificabili attraverso GNU Octave e GX-TXT.
Un aspetto particolarmente importante è la continuità tra il dato numerico e la sua rappresentazione.
Le curve non derivano da una trascrizione manuale dei risultati del log: sono generate dall’interfaccia a partire dai Dataset che GX-TXT ha registrato nella Session.
Questo dimostra il corretto completamento dell’intero flusso di lavoro, dalla definizione delle matrici fino alla disponibilità dei risultati nell’ambiente scientifico.
8.7 Risultato del collaudo
Il collaudo della Lezione 03 ha confermato il funzionamento di tutte le componenti necessarie all’esperimento.
Le operazioni sui vettori e sulle matrici sono state eseguite correttamente da GNU Octave.
Le chiamate pubbliche a NUMERIC_API_v1 hanno restituito risultati coerenti con i calcoli di verifica.
La pubblicazione attraverso DATASET_PUBLICATION_API_v2 ha registrato i quattro Dataset previsti.
Infine, i Dataset sono risultati consultabili nel sistema di anteprima scientifica di GX-TXT.
La verifica è quindi positiva sia dal punto di vista numerico sia per quanto riguarda l’integrazione tra lo script e il framework.
Abbiamo così completato la parte sperimentale della Lezione 03, passando dall’organizzazione delle misure alla loro elaborazione, validazione e visualizzazione.