

Pubblicazione di una serie derivata
Corso Python scientifico in GX-TXT · Modulo 4 · Lezione 23
Una trasformazione scientifica dovrebbe produrre un risultato distinguibile dai dati di partenza e accompagnato da informazioni sulla sua origine. In questa lezione convertiamo una serie sintetica da millivolt a volt, la pubblichiamo come nuovo Dataset canonico e la rileggiamo tramite l’API pubblica.
Obiettivi: distinguere dato sorgente e derivato; applicare una conversione dichiarata; pubblicare una serie con identità e unità proprie; confrontare i valori riletti con quelli attesi.
Prerequisiti: conversioni della lezione 16, identità Dataset e lettura delle lezioni 19–21.
Perché creare un nuovo Dataset
Un risultato in memoria esiste soltanto durante l’esecuzione dello script; un file scritto su disco non è automaticamente un Dataset registrato nella Session. La pubblicazione attraverso un’API GX-TXT crea un’identità e uno schema che altri strumenti della Session possono utilizzare.
Conservare il Dataset sorgente e pubblicare un derivato separato rende più chiara la relazione fra input e output. Occorre inoltre descrivere la trasformazione: un’etichetta diversa non dimostra che i valori siano stati convertiti correttamente.
Trasformazione proposta
Partiamo dalla serie sintetica
corso_python_serie_sintetica: tempi
[0.0, 0.5, 1.0, 1.5] s e segnali
[1.2, 1.5, 1.3, 1.6] mV. Sono valori inventati, non misure
sperimentali, senza incertezza assegnata. La conversione proporzionale
è:
segnale in V = segnale in mV / 1000I valori attesi sono [0.0012, 0.0015, 0.0013, 0.0016] V.
Il tempo rimane espresso in secondi e associato alla stessa riga. Nella
lezione 16 abbiamo confrontato la conversione con il registro delle
unità; qui ci concentriamo sulla pubblicazione del risultato.
publish_series e
provenienza
DATASET_PUBLICATION_API_v2/publish_series riceve una
richiesta con ID del nuovo Dataset, contratto, valori X e Y e
descrittori delle variabili. Nell’esempio l’ascissa è tempo
in s, l’ordinata è segnale_v in V
e il campo source_dataset_ids indica il Dataset sorgente.
La stringa provenance descrive la divisione per 1000 e la
natura sintetica dei dati.
La richiesta usa replace_owned=True: una nuova
esecuzione può sostituire il Dataset derivato solo se le regole del
provider autorizzano quel produttore. Non usare questa opzione per
sovrascrivere un Dataset di proprietà diversa; in caso di conflitto
scegli un ID libero. La pubblicazione non modifica intenzionalmente il
Dataset sorgente.
Codice completo
import numpy as np
from gxtxt import gxtxt_api_call, gxtxt_api_require

gxtxt_api_require("CANONICAL_DATASET_API_v2@2")
gxtxt_api_require("DATASET_PUBLICATION_API_v2@2")
sorgente = "corso_python_serie_sintetica"
derivato = "corso_python_serie_volt"
b = gxtxt_api_call("CANONICAL_DATASET_API_v2", "read_range", [sorgente, ["tempo", "segnale"], 0, 4])
tempo = np.asarray(b["tempo"]["values"]).reshape(-1)
segnale_mv = np.asarray(b["segnale"]["values"]).reshape(-1)
segnale_v = segnale_mv / 1000.0
richiesta = {"dataset_id": derivato, "contract": "table.generic", "storage": "csv", "replace_owned": True,
    "x_values": tempo, "y_values": segnale_v,
    "x_variable": {"variable_id": "tempo", "name": "tempo", "unit": "s", "semantic_role": "time"},
    "y_variable": {"variable_id": "segnale_v", "name": "segnale_v", "unit": "V", "semantic_role": "voltage"},
    "source_dataset_ids": [sorgente], "provenance": "Serie sintetica: conversione da mV a V, divisione per 1000"}
gxtxt_api_call("DATASET_PUBLICATION_API_v2", "publish_series", [richiesta])
rilettura = gxtxt_api_call("CANONICAL_DATASET_API_v2", "read_range", [derivato, ["segnale_v"], 0, 4])
valori = np.asarray(rilettura["segnale_v"]["values"]).reshape(-1)
print("Sorgente (mV):", segnale_mv)
print("Serie pubblicata (V):", valori)
print("Confronto con conversione:", np.allclose(valori, segnale_v, rtol=1e-12, atol=1e-15))
Lo script conosce la forma a colonna e il numero di righe della serie
di partenza; un programma generico deve controllare schema, lunghezza e
unità prima di trasformare i dati. np.allclose confronta i
valori con tolleranze esplicite, qui scelte per il piccolo esempio
numerico: non sono un’incertezza sperimentale.
La rilettura del derivato usa l’API canonica, quindi controlla ciò che GX-TXT ha pubblicato invece di limitarsi all’array in memoria. Per un caso reale verifica anche metadati, selezione, unità e completezza dell’insieme.
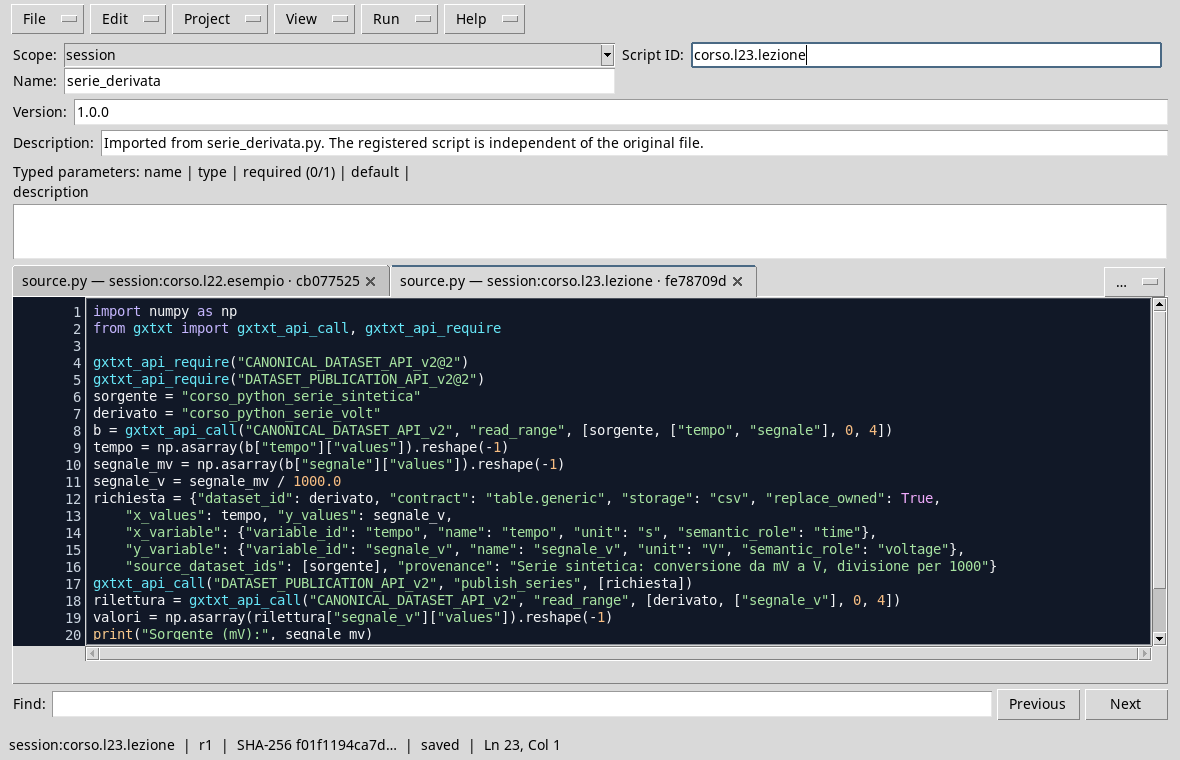
Lo script legge la sorgente, converte e pubblica una nuova serie.
Esecuzione
- Apri la Session con
corso_python_serie_sinteticae il Viewer Python Scripts. - Importa
serie_derivata.py, assegna nome e Script ID nello scopesession, quindi salva. - Apri il Runner e premi Run Job.
- Confronta i valori della serie pubblicata con quelli attesi in volt
e controlla che il confronto stampato sia
True. Il Dataset derivato ha IDcorso_python_serie_volt.
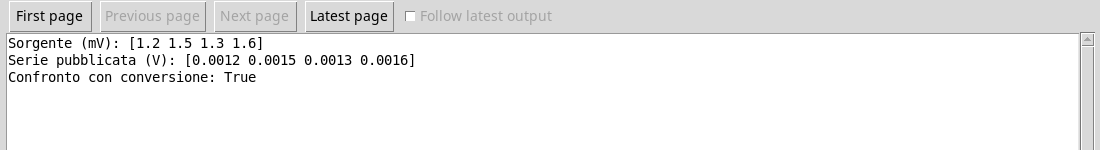
La serie riletta contiene i valori convertiti e concorda con il calcolo per le tolleranze scelte.
Errore comune
Pubblicare gli stessi numeri cambiando soltanto l’unità da
mV a V moltiplicherebbe il valore fisico per
mille. Una conversione richiede sia la trasformazione dei valori sia
metadati coerenti. Anche una funzione di conversione corretta va
applicata alle variabili e agli assi giusti.
Esercizio
Una lettura sintetica di 2.5 mV viene convertita in
volt. Qual è il valore numerico? Quale informazione dovresti conservare
insieme alla serie derivata?
Soluzione ragionata
2.5 / 1000 = 0.0025 V. Conserva almeno l’identità della
sorgente, l’operazione e le unità di partenza e arrivo; per misure reali
conserva anche incertezza, metodo e altre informazioni necessarie alla
loro interpretazione.
Nella prossima lezione approfondiremo il writer strutturato e l’annullamento di una pubblicazione incompleta.