

Writer strutturato e transazioni
Corso Python scientifico in GX-TXT · Modulo 4 · Lezione 24
La pubblicazione di dati strutturati può richiedere più passaggi: dichiarare dimensioni e variabili, scrivere valori e concludere l’operazione. In questa lezione usiamo il writer pubblico di GX-TXT per creare un Dataset sintetico con due variabili e osserviamo l’annullamento di una seconda pubblicazione incompleta.
Obiettivi: comprendere begin,
dichiarazione dello schema, write_variable,
finalize e abort; distinguere un Dataset
completo da un tentativo annullato; rileggere i valori pubblicati.
Prerequisiti: Dataset e variabili delle lezioni 19–23, eccezioni e funzioni Python.
Una pubblicazione in più passi
Un writer è l’oggetto gestito usato per preparare e
scrivere un Dataset. Con DATASET_PUBLICATION_API_v2 il
percorso dell’esempio è:
begin: prepara il writer per una definizione di Dataset.declare_dimension: dichiara una dimensione e la sua lunghezza.declare_variable: associa a ogni variabile tipo, rango, dimensioni e unità.write_variable: scrive i valori delle variabili dichiarate.finalize: conclude la pubblicazione.abort: annulla un writer che non deve essere concluso.
Queste operazioni lavorano attraverso il provider pubblico: lo script non modifica direttamente il registro della Session. Una transazione serve a evitare che una sequenza incompleta venga presentata come una pubblicazione completa. Le garanzie esatte e le condizioni di errore dipendono dal contratto e dall’operazione documentati.
Dati e schema dell’esempio
Creiamo corso_python_writer_sintetico con tre campioni.
La variabile tempo contiene [0.0, 0.5, 1.0] s;
segnale contiene [1.2, 1.5, 1.3] mV. Entrambe
sono float64, rango 1, associate alla dimensione
campione di lunghezza 3. I dati sono sintetici, non misure
sperimentali e non hanno incertezza assegnata.
Il ruolo coordinate segnala la variabile temporale;
data segnala il contenuto del segnale. Tipo, forma, unità e
ruolo devono essere coerenti con i valori e con il significato
scientifico. La forma passata alla scrittura è [3] per
ciascuna variabile.
Gestire il writer
Il blocco try contiene dichiarazioni, scritture e
finalize. Se una di queste operazioni solleva un’eccezione,
il gestore chiede abort e poi usa raise per
propagare l’errore. Non trasforma un fallimento in un messaggio di
successo. Nelle applicazioni reali occorre anche considerare il caso in
cui la pulizia stessa fallisca, conservando il messaggio dell’errore
originale.
Dopo la pubblicazione completa, apriamo un secondo writer per
corso_python_writer_annullato, dichiariamo una dimensione e
chiamiamo intenzionalmente abort senza scrivere né
finalizzare. Poi chiediamo il catalogo: nell’esecuzione mostrata l’ID
annullato non è presente. Questo è un esempio controllato di
annullamento, non una prova di tutti i possibili guasti o
interruzioni.
L’opzione replace_owned=True sulla definizione completa
consente la sostituzione solo quando autorizzata dalle regole del
provider per il produttore. Non sostituire Dataset di proprietà diversa:
usa una Session dedicata e ID liberi se necessario.
Codice completo
import numpy as np
from gxtxt import gxtxt_api_call, gxtxt_api_require

gxtxt_api_require("CANONICAL_DATASET_API_v2@2")
gxtxt_api_require("DATASET_PUBLICATION_API_v2@2")
api = "DATASET_PUBLICATION_API_v2"
dataset = "corso_python_writer_sintetico"
definizione = {"dataset_id": dataset, "contract": "table.generic", "storage": "hdf5", "replace_owned": True, "provenance": "Dati sintetici didattici"}
writer = gxtxt_api_call(api, "begin", [definizione])
try:
    gxtxt_api_call(api, "declare_dimension", [writer, "campione", 3, {"extendible": 0}])
    schema_t = {"dtype": "float64", "rank": 1, "dimension_ids": "campione", "unit": "s", "coordinate_role": "coordinate"}
    schema_y = {"dtype": "float64", "rank": 1, "dimension_ids": "campione", "unit": "mV", "coordinate_role": "data"}
    gxtxt_api_call(api, "declare_variable", [writer, "tempo", schema_t])
    gxtxt_api_call(api, "declare_variable", [writer, "segnale", schema_y])
    gxtxt_api_call(api, "write_variable", [writer, "tempo", np.array([0.0, 0.5, 1.0]), [3]])
    gxtxt_api_call(api, "write_variable", [writer, "segnale", np.array([1.2, 1.5, 1.3]), [3]])
    risultato = gxtxt_api_call(api, "finalize", [writer])
except Exception:
    gxtxt_api_call(api, "abort", [writer])
    raise
print("Dataset completo:", risultato.get("dataset_id"))
prova = "corso_python_writer_annullato"
temporaneo = gxtxt_api_call(api, "begin", [{"dataset_id": prova, "contract": "table.generic", "storage": "hdf5"}])
gxtxt_api_call(api, "declare_dimension", [temporaneo, "campione", 3, {"extendible": 0}])
gxtxt_api_call(api, "abort", [temporaneo])
catalogo = gxtxt_api_call("CANONICAL_DATASET_API_v2", "list", [])
print("Dataset annullato presente:", prova in catalogo)
letto = gxtxt_api_call("CANONICAL_DATASET_API_v2", "read_range", [dataset, ["tempo", "segnale"], 0, 3])
print("Tempo (s):", letto["tempo"]["values"].reshape(-1))
print("Segnale (mV):", letto["segnale"]["values"].reshape(-1))
La rilettura usa CANONICAL_DATASET_API_v2/read_range:
così confrontiamo i valori pubblicati con quelli scritti. La
trasformazione reshape(-1) è appropriata per queste due
variabili monodimensionali lette come colonne; non applicarla senza
verificare il significato della forma in un Dataset
multidimensionale.
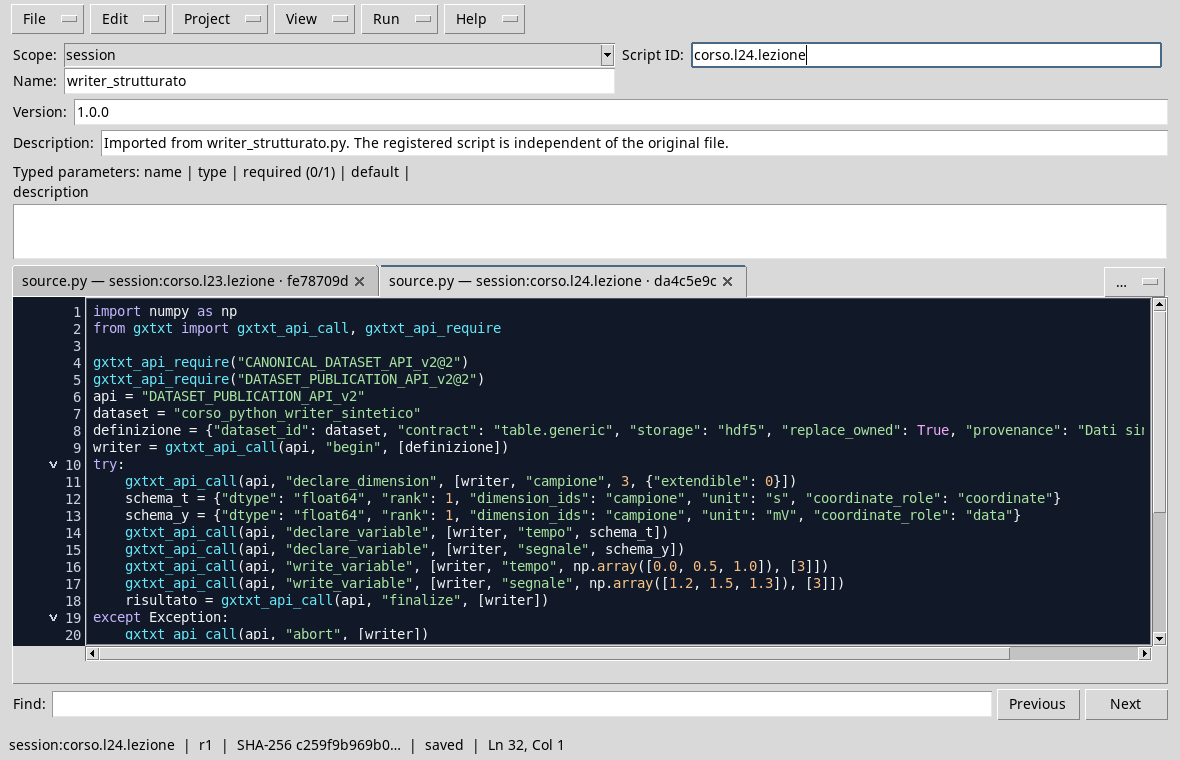
Il writer dichiara schema e valori prima di concludere la pubblicazione.
Esecuzione e controllo
- Apri una Session dedicata e il Viewer Python Scripts.
- Importa
writer_strutturato.py, assegna nome e Script ID nello scopesession, quindi salva. - Apri il Runner e premi Run Job.
- Controlla che l’output indichi il Dataset completo,
Dataset annullato presente: Falsee le due serie di tre valori attese.
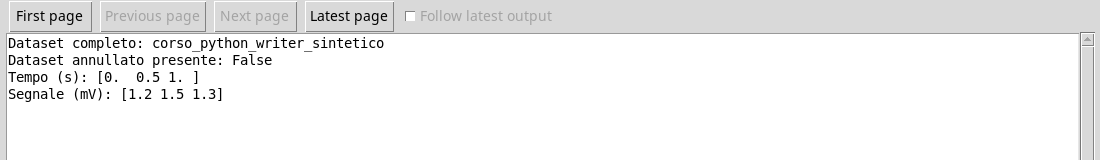
Il Dataset completo è leggibile; il tentativo annullato non compare nel catalogo mostrato.
Errore comune
Dichiarare una dimensione di tre elementi e scriverne un numero diverso non è una semplice differenza di etichetta: lo schema e i dati sarebbero incoerenti. Verifica forma, tipo e unità prima della scrittura e non dichiarare conclusa la pubblicazione quando una delle operazioni necessarie è fallita.
Esercizio
Per pubblicare quattro campioni invece di tre, quali parti dell’esempio devono cambiare? Quale controllo useresti dopo la pubblicazione?
Soluzione ragionata
Occorre dichiarare la dimensione campione con lunghezza
4, fornire quattro valori coerenti per ciascuna variabile e indicare la
forma [4] alle scritture. Dopo finalize,
rileggi quattro righe con l’API canonica e confronta valori, unità e
schema con quelli previsti. I dati devono restare chiaramente
identificati come sintetici se inventati.
Nel prossimo modulo useremo API numeriche per trasformazioni e modelli.