

Output, salvataggi e ripetibilità verificata
Corso Python scientifico in GX-TXT · Modulo 7 · Lezione 42
Un’analisi ripetibile richiede di sapere quali dati, codice, parametri e ambiente hanno prodotto un risultato. In questa lezione generiamo campioni sintetici con un seed dichiarato, scriviamo un CSV e confrontiamo due esecuzioni.
Obiettivi
- Usare un generatore NumPy con seed esplicito.
- Scrivere e chiudere un file con un context manager.
- Pubblicare il file attraverso l’API di GX-TXT.
- Confrontare le impronte dei file e distinguere pubblicazione e salvataggio della Sessione.
Esecuzione
Nella Sessione corso_python, importa ripetibilita.py, salva lo script e
avvialo due volte con Run → Open Script Runner → Run
Job. Il Dataset di output appartiene allo script;
replace_owned consente alla stessa sorgente autorizzata di
sostituire il proprio output. Non usare questa opzione per presumere di
poter sovrascrivere dati altrui.
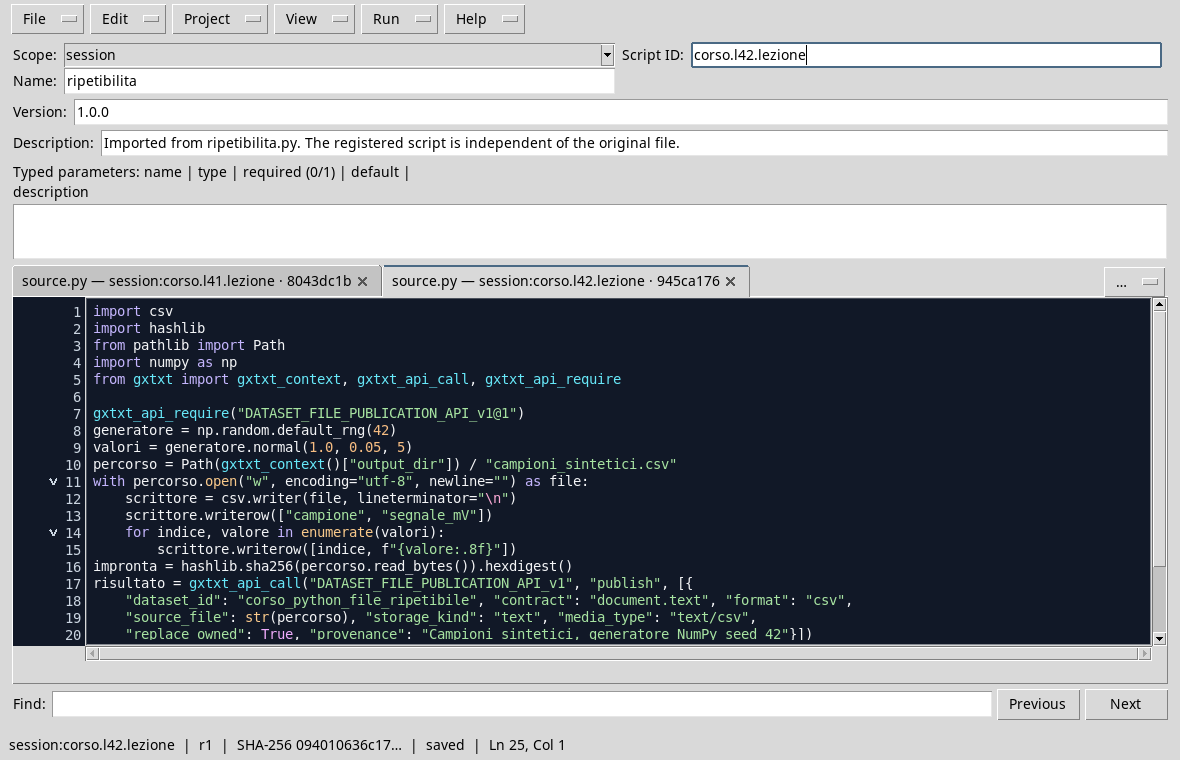
import csv
import hashlib
from pathlib import Path
import numpy as np
from gxtxt import gxtxt_context, gxtxt_api_call, gxtxt_api_require

gxtxt_api_require("DATASET_FILE_PUBLICATION_API_v1@1")
generatore = np.random.default_rng(42)
valori = generatore.normal(1.0, 0.05, 5)
percorso = Path(gxtxt_context()["output_dir"]) / "campioni_sintetici.csv"
with percorso.open("w", encoding="utf-8", newline="") as file:
    scrittore = csv.writer(file, lineterminator="\n")
    scrittore.writerow(["campione", "segnale_mV"])
    for indice, valore in enumerate(valori):
        scrittore.writerow([indice, f"{valore:.8f}"])
impronta = hashlib.sha256(percorso.read_bytes()).hexdigest()
risultato = gxtxt_api_call("DATASET_FILE_PUBLICATION_API_v1", "publish", [{
    "dataset_id": "corso_python_file_ripetibile", "contract": "document.text", "format": "csv",
    "source_file": str(percorso), "storage_kind": "text", "media_type": "text/csv",
    "replace_owned": True, "provenance": "Campioni sintetici, generatore NumPy seed 42"}])
print("Seed:", 42)
print("Valori sintetici (mV):", np.round(valori, 8))
print("SHA-256 file:", impronta)
print("Dataset:", risultato.get("dataset_id"))
default_rng(42) crea un generatore inizializzato con il
seed 42. I cinque valori sono sintetici, con unità dichiarata mV. Il
blocco with chiude il file anche se si verifica
un’eccezione; soltanto dopo la chiusura calcoliamo l’impronta SHA-256
dei byte e chiediamo la pubblicazione come documento CSV gestito.
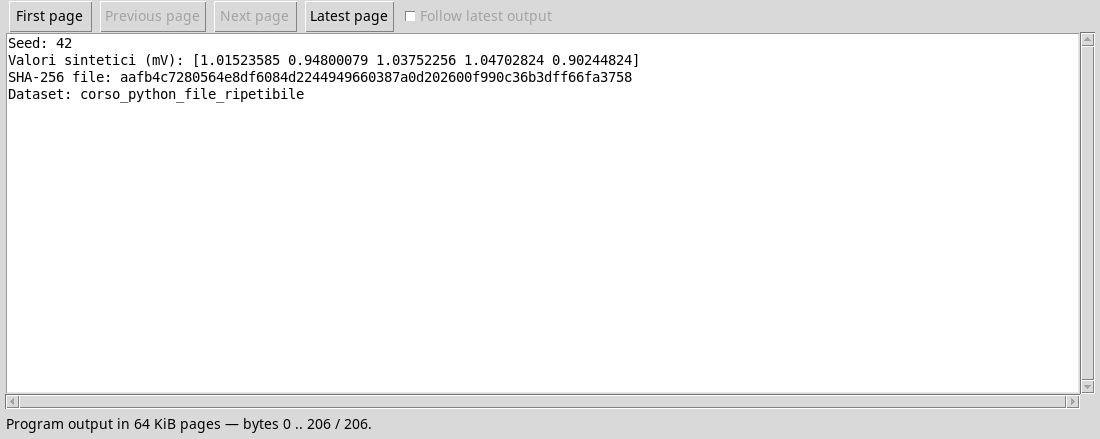
Nelle due esecuzioni effettuate nello stesso ambiente, i valori stampati e l’impronta del CSV coincidono. Questo prova l’uguaglianza dei file prodotti in queste due prove; non dimostra automaticamente che qualsiasi versione futura di librerie o ambiente produca gli stessi byte. Il formato numerico e il terminatore di riga sono esplicitati per ridurre differenze di serializzazione.
File, pubblicazione e Sessione
Il file generato nella directory di output del Job e il Dataset pubblicato hanno ruoli diversi. L’API restituisce l’identità della pubblicazione; la presenza di un file locale, da sola, non prova che la pubblicazione sia riuscita. Allo stesso modo, non dimostra che ogni modifica della Sessione sia stata salvata: verifica lo stato e usa le funzioni di salvataggio previste dal contesto.
Per una procedura ripetibile documenta versione dello script, seed, input, parametri, unità, versione delle librerie e identità dell’output. I dati sintetici dell’esempio non sono misure sperimentali.
Esercizio
- Perché il seed è dichiarato nello script?
- Due impronte uguali in queste prove che cosa permettono di concludere?
- Un CSV presente nella cartella del Job dimostra che la Sessione intera sia salvata?
Soluzione ragionata
- Permette di riprodurre la sequenza nello stesso contesto e di documentare l’inizializzazione del generatore.
- Che i file confrontati hanno la stessa impronta; insieme al confronto dei contenuti, fornisce evidenza che siano identici per quelle esecuzioni.
- No. File di output, pubblicazione del Dataset e persistenza della Sessione sono passaggi distinti.
Nel modulo successivo approfondiremo statistica e incertezza.