

Test d’ipotesi, bootstrap e limiti inferenziali
Corso Python scientifico in GX-TXT · Modulo 8 · Lezione 45
Un test statistico valuta quanto un risultato sia compatibile con un modello e un’ipotesi specificati. Il bootstrap usa ricampionamenti dei dati disponibili per esplorare la variabilità di una stima. Qui applichiamo entrambi a due piccoli gruppi sintetici.
Obiettivi
- Formulare una differenza di medie e un’ipotesi nulla.
- Eseguire un test di Welch bilaterale nell’API numerica.
- Generare un intervallo bootstrap percentile con seed esplicito.
- Interpretare i risultati senza attribuire al p-value significati impropri.
Due gruppi sintetici
I gruppi A e B contengono cinque valori ciascuno in mV, costruiti per
l’esercizio. Consideriamo la differenza media(A) - media(B)
e l’ipotesi nulla di differenza fra medie pari a zero. Il test di Welch
non richiede di assumere varianze uguali fra gruppi; richiede comunque
ipotesi sul campionamento e sull’adeguatezza del modello. Per
l’esercizio trattiamo i gruppi come indipendenti.
Esecuzione
Nella Sessione corso_python, importa test_bootstrap.py, salva lo script
ed eseguilo nel Runner.
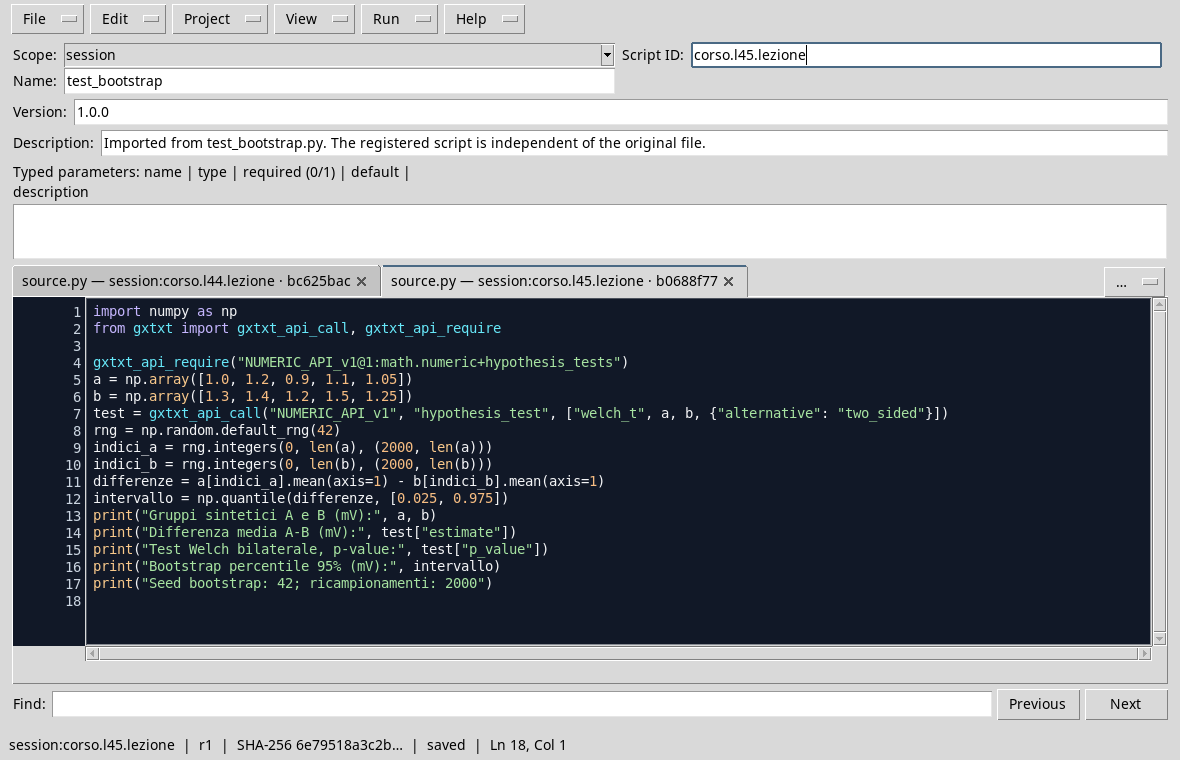
import numpy as np
from gxtxt import gxtxt_api_call, gxtxt_api_require

gxtxt_api_require("NUMERIC_API_v1@1:math.numeric+hypothesis_tests")
a = np.array([1.0, 1.2, 0.9, 1.1, 1.05])
b = np.array([1.3, 1.4, 1.2, 1.5, 1.25])
test = gxtxt_api_call("NUMERIC_API_v1", "hypothesis_test", ["welch_t", a, b, {"alternative": "two_sided"}])
rng = np.random.default_rng(42)
indici_a = rng.integers(0, len(a), (2000, len(a)))
indici_b = rng.integers(0, len(b), (2000, len(b)))
differenze = a[indici_a].mean(axis=1) - b[indici_b].mean(axis=1)
intervallo = np.quantile(differenze, [0.025, 0.975])
print("Gruppi sintetici A e B (mV):", a, b)
print("Differenza media A-B (mV):", test["estimate"])
print("Test Welch bilaterale, p-value:", test["p_value"])
print("Bootstrap percentile 95% (mV):", intervallo)
print("Seed bootstrap: 42; ricampionamenti: 2000")
L’API hypothesis_test esegue il test bilaterale
welch_t. Il bootstrap è calcolato localmente con NumPy: per
ciascuno dei 2000 ricampionamenti estrae con reinserimento indici
all’interno di ciascun gruppo, calcola le due medie e ne salva la
differenza. I percentili 2,5% e 97,5% della distribuzione così ottenuta
formano l’intervallo percentile mostrato. Il seed 42 rende ripetibile
questa specifica simulazione nello stesso contesto.
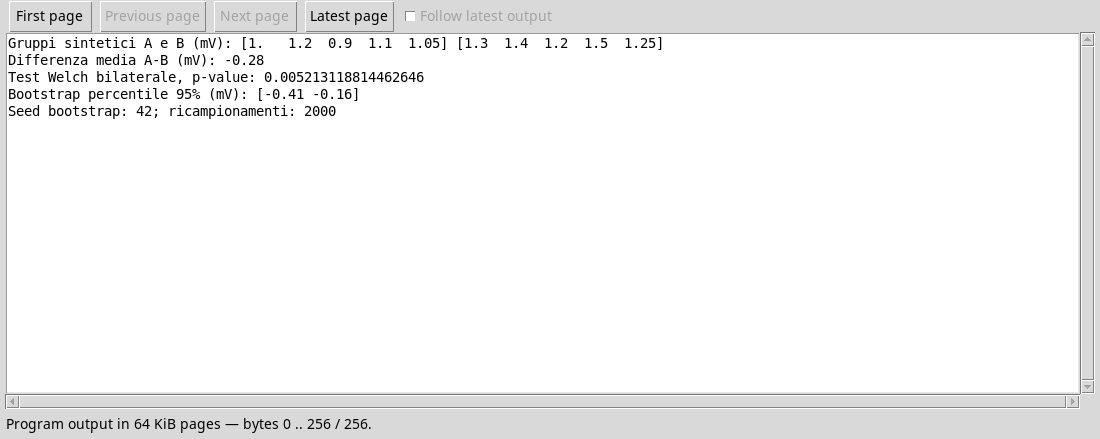
La differenza osservata A − B è -0,28 mV. Il p-value del
test è circa 0,0052; l’intervallo bootstrap percentile
mostrato è circa [-0,41, -0,16] mV. Si tratta di metodi
diversi: il test e l’intervallo bootstrap non sono la stessa procedura e
si basano su ipotesi. Con campioni così piccoli il bootstrap può essere
instabile e non corregge automaticamente campionamenti non
rappresentativi o dipendenze.
Interpretazione corretta
Il p-value è la probabilità, sotto l’ipotesi nulla e le altre assunzioni del test, di ottenere una statistica almeno altrettanto estrema secondo la regola del test. Non è la probabilità che l’ipotesi nulla sia vera, né misura da solo l’importanza pratica della differenza. L’intervallo va interpretato nel contesto della procedura e delle sue ipotesi; non dimostra una causa. In uno studio reale occorre considerare disegno, indipendenza, dimensione del campione, incertezze e possibili confronti multipli.
Esercizio
- Quale differenza è stata calcolata: A − B o B − A?
- Che cosa rimane fissato nei ricampionamenti bootstrap di questo esempio?
- Un p-value di 0,0052 è la probabilità che l’ipotesi nulla sia vera?
Soluzione ragionata
- A − B, pari a
-0,28 mVnei dati scelti. - La dimensione di ciascun gruppo; gli indici sono estratti con reinserimento separatamente nei due gruppi.
- No: il p-value è calcolato assumendo l’ipotesi nulla e il modello del test.
Nella prossima lezione useremo il Curve Fitter su un Dataset pubblicato.