

Interpretazione statistica e rapporto scientifico
Corso Python scientifico in GX-TXT · Modulo 8 · Lezione 48
Un rapporto scientifico deve permettere a chi legge di distinguere dati, stime, incertezze e interpretazioni. In questa lezione costruiamo un breve rapporto didattico a partire da una regressione eseguita nel Runner.
Obiettivi
- Identificare sorgente, modello e unità.
- Riportare parametri e residui senza inventare campi non disponibili.
- Distinguere una soluzione numerica da una conclusione scientifica.
- Dichiarare limiti e ipotesi dell’esempio.
Dati e modello
Usiamo corso_python_seconda_serie, una serie di quattro
punti sintetici costruita sulla retta
segnale = 1 + 0,2 × tempo. Il tempo è in secondi e il
segnale in millivolt. L’esempio non rappresenta un esperimento.
Nella Sessione corso_python, importa rapporto.py, salvalo ed eseguilo nel
Runner.
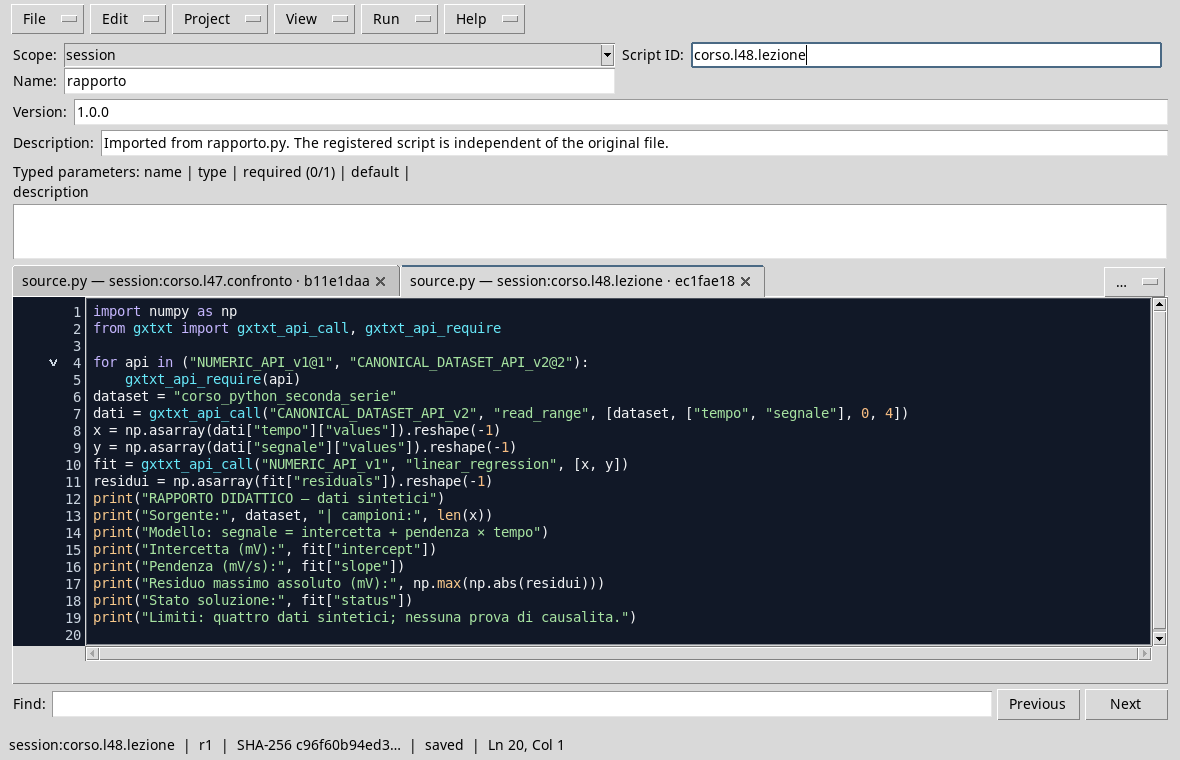
import numpy as np
from gxtxt import gxtxt_api_call, gxtxt_api_require

for api in ("NUMERIC_API_v1@1", "CANONICAL_DATASET_API_v2@2"):
    gxtxt_api_require(api)
dataset = "corso_python_seconda_serie"
dati = gxtxt_api_call("CANONICAL_DATASET_API_v2", "read_range", [dataset, ["tempo", "segnale"], 0, 4])
x = np.asarray(dati["tempo"]["values"]).reshape(-1)
y = np.asarray(dati["segnale"]["values"]).reshape(-1)
fit = gxtxt_api_call("NUMERIC_API_v1", "linear_regression", [x, y])
residui = np.asarray(fit["residuals"]).reshape(-1)
print("RAPPORTO DIDATTICO — dati sintetici")
print("Sorgente:", dataset, "| campioni:", len(x))
print("Modello: segnale = intercetta + pendenza × tempo")
print("Intercetta (mV):", fit["intercept"])
print("Pendenza (mV/s):", fit["slope"])
print("Residuo massimo assoluto (mV):", np.max(np.abs(residui)))
print("Stato soluzione:", fit["status"])
print("Limiti: quattro dati sintetici; nessuna prova di causalita.")
Lo script legge i dati canonici, esegue
linear_regression e riassume i campi effettivamente
restituiti. L’identità del Dataset e il numero di campioni rendono
riconoscibile la sorgente; i nomi degli assi e le unità spiegano le
dimensioni dei parametri.
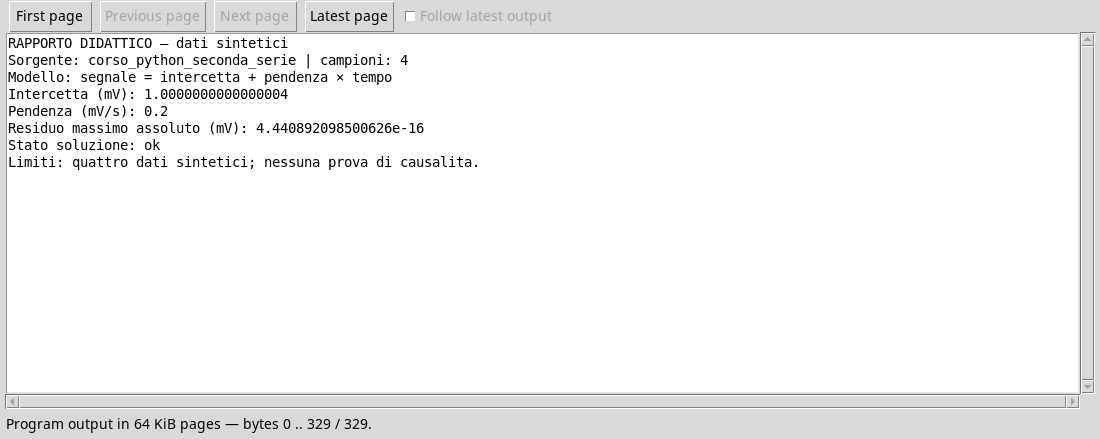
La stima dell’intercetta è circa 1 mV; la pendenza è
0,2 mV/s. Il massimo residuo assoluto è dell’ordine di
10⁻¹⁶ mV, compatibile con le differenze numeriche di un
esempio costruito esattamente sulla retta. Lo stato ok
riguarda la soluzione numerica: non prova che il modello sia fisicamente
valido o che una variabile causi l’altra.
Incertezza e semantica
Un rapporto più completo può includere incertezze dei parametri, correlazioni e intervalli, ma soltanto quando il metodo e le ipotesi li rendono disponibili e interpretabili. Non sostituire un campo non disponibile con zero. Il Curve Fitter della lezione 46 mostra, per esempio, che un intervallo può essere indicato come non disponibile in assenza delle ipotesi richieste. Le API di semantica statistica aiutano a conservare il significato dei risultati: non calcolano nuove misure e non eliminano la necessità di verificare il modello.
In un rapporto destinato ad altri, aggiungi versione del codice e del software, parametri, provenienza e identità del risultato, metodo, convenzioni e limiti. Una figura deve avere una didascalia coerente con i dati effettivamente mostrati.
Esercizio
- Quali sono le unità dei due parametri?
- Che cosa indica il residuo massimo quasi nullo in questo esempio?
- Puoi ricavare un rapporto di causalità dallo stato
okdel solver?
Soluzione ragionata
- Intercetta in mV, pendenza in mV/s.
- Che la retta prevista riproduce molto bene questi punti sintetici; essi sono stati costruiti sulla retta.
- No. Lo stato riguarda la soluzione numerica, mentre una conclusione causale richiede un disegno e ipotesi appropriati.
Il modulo successivo organizzerà gli script in progetti Python manutenibili.