

Riproducibilità e preparazione alla pubblicazione
Corso Python scientifico in GX-TXT · Modulo 10 · Lezione 60
Concludiamo lo studio sintetico verificando che i Dataset pubblicati corrispondano al protocollo e raccogliendo i materiali necessari a spiegare e ripetere l’analisi.
Obiettivi
- Rigenerare in memoria i valori attesi dal protocollo.
- Confrontarli con i Dataset canonici pubblicati.
- Distinguere verifica dei dati, ripetizione dei fit e pubblicazione del corso.
- Organizzare sorgenti, figure e metadati editoriali.
Verifica dei dati
Importa verifica_finale.py
nella Sessione corso_python, dopo aver eseguito la lezione
56. Salvalo ed eseguilo nel Runner.
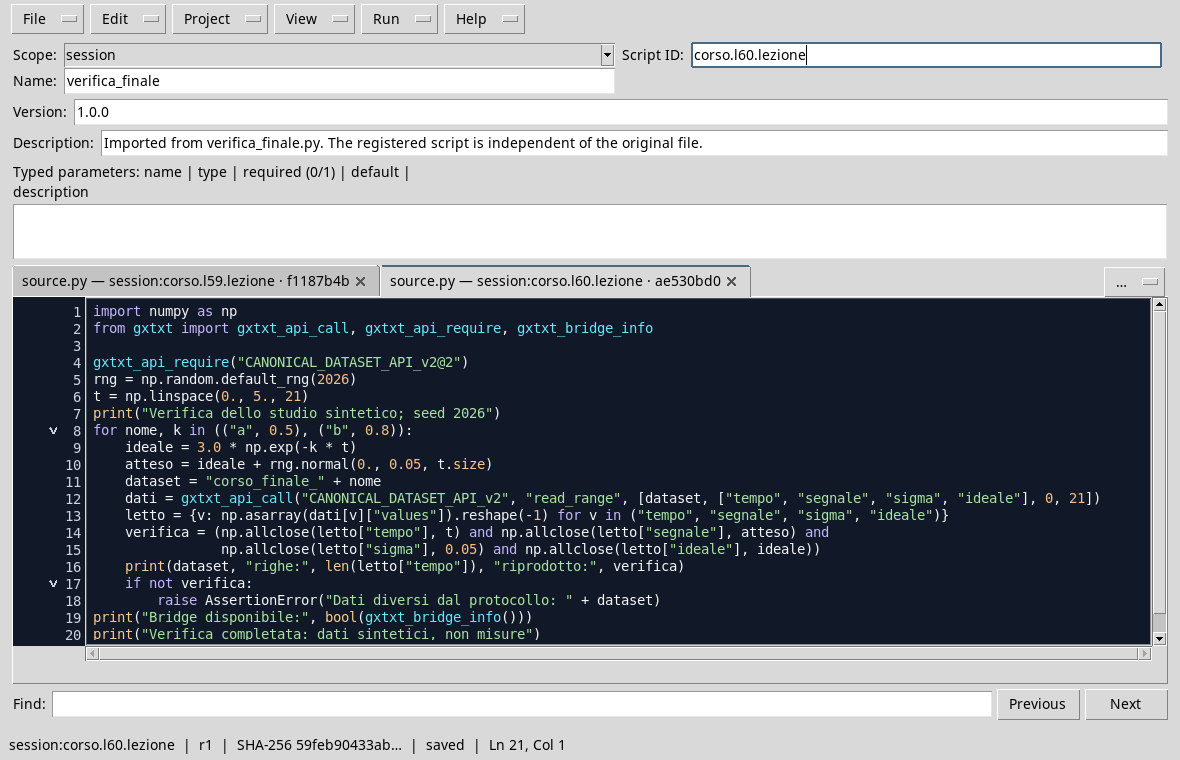
import numpy as np
from gxtxt import gxtxt_api_call, gxtxt_api_require, gxtxt_bridge_info

gxtxt_api_require("CANONICAL_DATASET_API_v2@2")
rng = np.random.default_rng(2026)
t = np.linspace(0., 5., 21)
print("Verifica dello studio sintetico; seed 2026")
for nome, k in (("a", 0.5), ("b", 0.8)):
    ideale = 3.0 * np.exp(-k * t)
    atteso = ideale + rng.normal(0., 0.05, t.size)
    dataset = "corso_finale_" + nome
    dati = gxtxt_api_call("CANONICAL_DATASET_API_v2", "read_range", [dataset, ["tempo", "segnale", "sigma", "ideale"], 0, 21])
    letto = {v: np.asarray(dati[v]["values"]).reshape(-1) for v in ("tempo", "segnale", "sigma", "ideale")}
    verifica = (np.allclose(letto["tempo"], t) and np.allclose(letto["segnale"], atteso) and
                np.allclose(letto["sigma"], 0.05) and np.allclose(letto["ideale"], ideale))
    print(dataset, "righe:", len(letto["tempo"]), "riprodotto:", verifica)
    if not verifica:
        raise AssertionError("Dati diversi dal protocollo: " + dataset)
print("Bridge disponibile:", bool(gxtxt_bridge_info()))
print("Verifica completata: dati sintetici, non misure")
Il programma ricrea i tempi, i segnali ideali e i due insiemi di
rumore nello stesso ordine e con lo stesso seed della lezione 56. Poi
rilegge i Dataset e confronta tempo, segnale, sigma e ideale con
np.allclose.
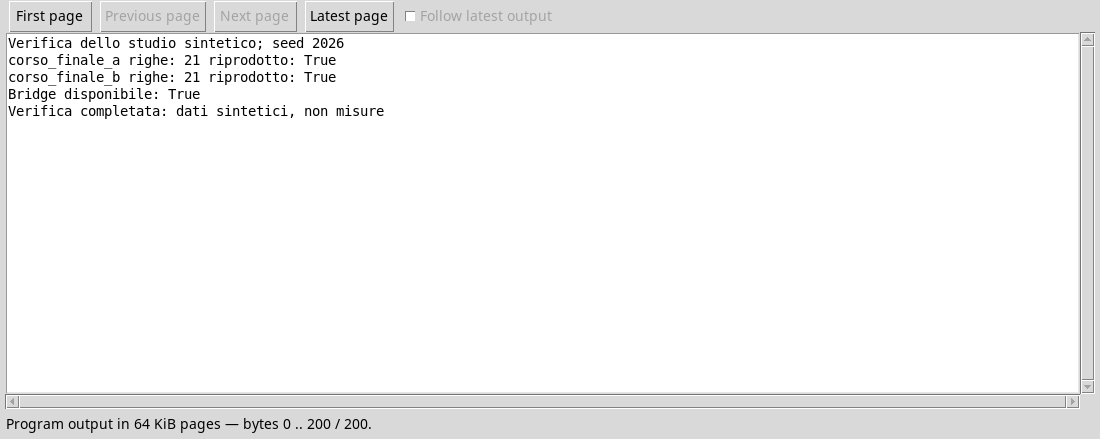
Entrambi i Dataset mostrano 21 righe e riprodotto: True
nell’ambiente utilizzato. È una verifica numerica con tolleranza dei
dati pubblicati; non è una prova di identità byte per byte né
sostituisce la ripetizione del fit e del grafico. Per ripercorrere
l’intera analisi, esegui nell’ordine il protocollo, la generazione, la
preparazione, il fit e il grafico delle lezioni 55–59, rispettando le
regole di proprietà e gli ID di output.
Preparare i materiali per il blog
Per ogni lezione conserva il testo italiano, i file Python, le immagini reali ritagliate, le didascalie e i link relativi. Per lo studio finale includi la dichiarazione che i dati sono sintetici, seed, unità, modello, parametri, risultati, limiti e versioni del software. Titolo, descrizione e struttura delle sezioni possono essere adattati al formato editoriale del blog senza alterare i risultati scientifici.
Una pagina HTML consultabile e un pacchetto di contenuti per l’importazione sono artefatti distinti dalla pubblicazione online. Prima della pubblicazione verifica immagini, link e leggibilità nel contesto del sito. Le eventuali traduzioni future devono mantenere unità e significato delle conclusioni.
Esercizio
- Quali quattro variabili vengono confrontate per ciascun Dataset?
- Che cosa garantisce
allclosein questo esempio? - Perché bisogna mantenere la dicitura «dati sintetici» anche nella versione pubblicata?
Soluzione ragionata
- Tempo, segnale, sigma e ideale.
- Che i valori confrontati coincidono entro le tolleranze usate, non che i file siano identici byte per byte.
- Per non presentare una simulazione come un esperimento o una misura reale.