

Indicizzazione e slice di array
Corso Python scientifico in GX-TXT · Modulo 3 · Lezione 14
La forma di un array ci dice quanti assi possiede. In questa lezione selezioniamo righe e colonne di una tabella NumPy, conservando la corrispondenza fra tempi e segnali letti da GX-TXT.
Obiettivi: indicizzare array bidimensionali; usare slice e comprendere gli assi; distinguere viste e copie; riconoscere i rischi di una modifica di forma non motivata.
Prerequisiti: liste e slicing della lezione 4;
ndarray, shape e dtype della
lezione 13; Dataset sintetico della lezione 9.
Righe, colonne e indici
Considera una tabella con quattro righe e due colonne. La prima
colonna contiene il tempo, la seconda il segnale. In NumPy
tabella[1, 0] seleziona la seconda riga e la prima colonna:
gli indici partono da zero. tabella[:, 0] seleziona la
prima colonna per tutte le righe; tabella[1:3, :] seleziona
le righe di indice 1 e 2 e tutte le colonne.
Il limite finale della slice è escluso. Per i dati sintetici del corso, le due righe centrali associano 0,5 s a 1,5 mV e 1,0 s a 1,3 mV. Sono valori inventati, non misure, e non hanno un’incertezza assegnata. Selezionare le stesse righe da entrambe le colonne mantiene la corrispondenza fra tempo e segnale.
Forma del risultato
Un array (4, 2) ha quattro righe e due colonne.
tabella[1:3, :] ha forma (2, 2). Selezionando
tabella[:, 0], NumPy produce normalmente un array
monodimensionale di forma (4,);
tabella[:, 0:1] conserva invece una colonna bidimensionale
di forma (4, 1). I valori possono essere gli stessi, ma la
forma influenza le operazioni successive.
Un asse è una direzione della struttura: in questa tabella l’asse 0 attraversa le righe e l’asse 1 le colonne. Non dedurre il significato fisico degli assi dalla sola forma: qui il significato deriva dai metadati e dal modo esplicito in cui costruiamo la tabella.
Viste e copie
Una slice NumPy semplice è spesso una vista: un
altro oggetto che condivide la memoria dei dati originali. Modificare la
vista può quindi modificare anche l’array di partenza.
np.shares_memory(tabella, centrali) permette di controllare
la condivisione nell’esempio; centrali.copy() crea una
copia dei dati dell’array selezionato.
L’indicizzazione avanzata con liste di indici o maschere booleane segue regole diverse e generalmente produce una copia. Le maschere saranno trattate nella prossima lezione. Prima di modificare un sottoinsieme di dati scientifici, decidi se vuoi cambiare l’originale o lavorare su una copia e conserva la provenienza.
reshape e valori
mancanti
reshape propone una nuova forma compatibile con il
numero di elementi: per esempio, quattro elementi possono avere forma
(4, 1) o (2, 2). La compatibilità numerica
della forma non garantisce che il cambiamento abbia senso scientifico.
Non trasformare una sequenza di tempi e segnali in una matrice diversa
solo per soddisfare un’operazione senza spiegare cosa rappresentano i
nuovi assi. A seconda della disposizione dei dati, reshape
può restituire una vista o richiedere una copia.
I valori mancanti richiedono attenzione: un NaN e una
maschera di celle mancanti non sono necessariamente la stessa cosa.
L’API può fornire metadati o maschere aggiuntive; seleziona dati e
maschere in modo coerente. La serie sintetica di questa lezione non
contiene celle mancanti intenzionali.
Esempio con GX-TXT
CANONICAL_DATASET_API_v2/read_range riceve
l’identificativo Dataset, gli ID delle variabili, l’indice iniziale e il
numero di righe. Leggiamo tempo e segnale per
le prime quattro righe. np.column_stack((tempo, segnale))
costruisce la tabella a due colonne; poi selezioniamo entrambe le
colonne per le due righe centrali.
Codice completo
import numpy as np
from gxtxt import gxtxt_api_call, gxtxt_api_require

gxtxt_api_require("CANONICAL_DATASET_API_v2@2")
b = gxtxt_api_call("CANONICAL_DATASET_API_v2", "read_range", ["corso_python_serie_sintetica", ["tempo", "segnale"], 0, 4])
tempo = np.asarray(b["tempo"]["values"])
segnale = np.asarray(b["segnale"]["values"])
tabella = np.column_stack((tempo, segnale))
centrali = tabella[1:3, :]
print("Tabella tempo (s), segnale (mV):\n", tabella)
print("Shape:", tabella.shape)
print("Righe centrali:\n", centrali)
print("Tempo centrale:", centrali[:, 0])
print("Segnale centrale:", centrali[:, 1])
print("Vista condivisa:", np.shares_memory(tabella, centrali))
Il codice richiede quattro righe già presenti nella Session; un
programma generale deve leggere i metadati prima di stabilire
l’intervallo. column_stack qui riceve due colonne
corrispondenti riga per riga: non basta che abbiano la stessa lunghezza
se provengono da acquisizioni non allineate.
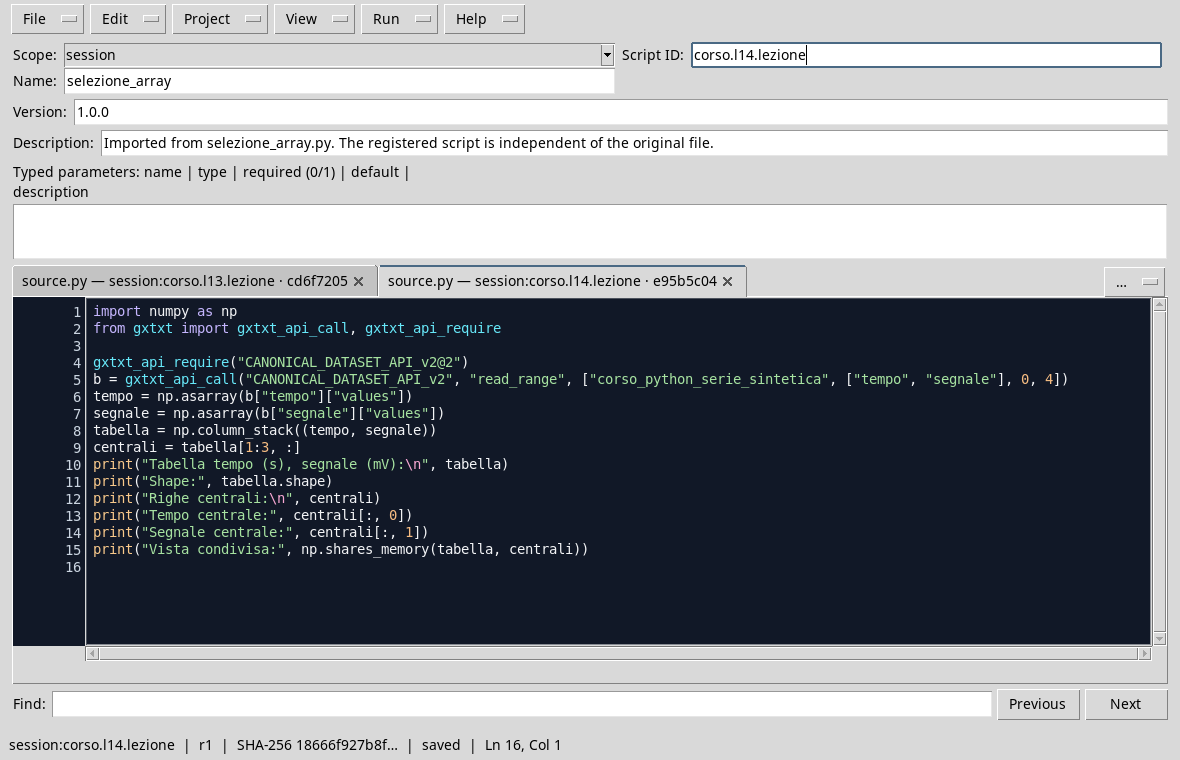
L’editor mostra la lettura pubblica e la selezione delle righe centrali.
Esecuzione e controllo
- Apri la Session con il Dataset sintetico della lezione 9 e il Viewer Python Scripts.
- Importa
selezione_array.py, assegna nome e Script ID nello scopesessione salva. - Avvia il Runner e premi Run Job. Apri l’output dopo il completamento.
- Controlla
shape (4, 2), le coppie centrali(0.5, 1.5)e(1.0, 1.3)e il risultatoTruedishares_memoryper questa slice.
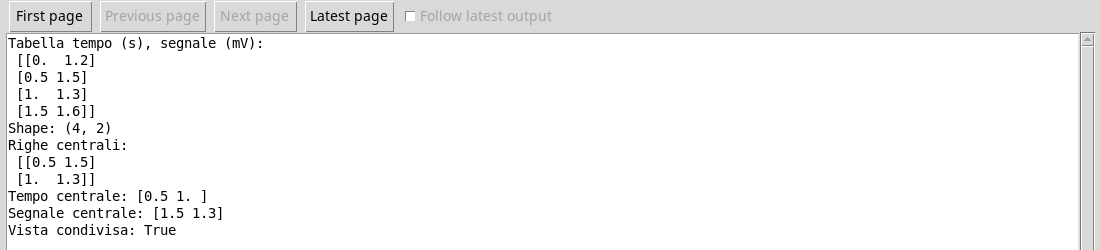
Tempo e segnale rimangono associati nelle due righe selezionate.
Errore comune
Selezionare i tempi con tempo[1:3] e i segnali con
segnale[2:4] produce due insiemi della stessa lunghezza ma
sfalsati di una riga. Una forma compatibile non prova che le coppie
siano corrette: verifica sempre gli indici e la relazione fra coordinate
e valori.
Esercizio
Per una tabella (4, 2), scrivi la selezione delle prime
tre righe mantenendo entrambe le colonne. Quale forma ha il risultato?
Come ottieni una copia indipendente?
Soluzione ragionata
selezione = tabella[:3, :] ha forma (3, 2).
Per una copia indipendente dei dati usa
copia = tabella[:3, :].copy(). La selezione semplice può
condividere memoria con la tabella originale; la copia esplicita evita
che una sua modifica alteri la tabella tramite quella memoria
condivisa.
Nella prossima lezione selezioneremo valori in base a maschere booleane.