
Lezione 02 — Variabili, tipi di dati e operatori in GNU Octave con GX-TXT
Nella prima lezione del nostro corso abbiamo iniziato a conoscere GNU Octave e il suo utilizzo all’interno del framework scientifico GX-TXT. Abbiamo visto come un semplice script possa eseguire calcoli numerici e interagire con i servizi messi a disposizione dall’ambiente.
In questa seconda lezione approfondiremo alcuni degli elementi fondamentali di qualsiasi linguaggio di programmazione: le variabili, i tipi di dati e gli operatori aritmetici. Si tratta di concetti apparentemente semplici, ma indispensabili per comprendere come vengono rappresentate ed elaborate le informazioni durante un calcolo scientifico.
Per imparare a utilizzarli realizzeremo una piccola calcolatrice scientifica, capace di eseguire operazioni aritmetiche, lavorare con vettori e numeri complessi, confrontare risultati e riconoscere alcune condizioni di errore.
L’esercizio ci offrirà inoltre l’opportunità di introdurre importanti strumenti di programmazione GNU Octave, come printf(), assert(), struct(), abs() e le istruzioni try e catch. Ne esamineremo progressivamente il funzionamento, la sintassi e l’utilizzo pratico, spiegando anche gli operatori e le altre istruzioni presenti nello script.
Ma non ci limiteremo alle funzionalità native di Octave. Una parte importante della lezione sarà dedicata all’integrazione con le API pubbliche di GX-TXT, attraverso le quali il nostro script potrà richiamare i servizi numerici del framework. Confronteremo alcune operazioni eseguite direttamente in Octave con quelle ottenute mediante NUMERIC_API_v1, per comprendere il ruolo dello Script Bridge e il funzionamento delle chiamate alle API.
L’esperimento è stato realizzato e collaudato con GX-TXT 0.9.8.10-dev-109, utilizzando esclusivamente le interfacce pubbliche documentate nei sorgenti GitHub. Tutti i controlli previsti sono stati superati, compresa la gestione di una divisione per zero.
Come nelle altre lezioni del corso, procederemo gradualmente: partiremo dai concetti teorici, analizzeremo il codice e infine esamineremo l’esecuzione dello script e i risultati ottenuti all’interno di GX-TXT.
Variabili e tipi di dati in GNU Octave
Uno dei primi concetti da comprendere quando si impara a programmare è quello di variabile.
Una variabile è un nome al quale associamo un valore che può essere utilizzato, elaborato e modificato durante l’esecuzione di un programma. In ambito scientifico, le variabili possono rappresentare misure sperimentali, costanti fisiche, risultati intermedi di un calcolo oppure insiemi di dati.
In GNU Octave non è necessario dichiarare preventivamente il tipo di una variabile. È sufficiente assegnarle un valore utilizzando l’operatore =.
Per esempio:
a = 12;
b = 5;
Con queste due istruzioni abbiamo creato le variabili a e b, assegnando loro rispettivamente i valori numerici 12 e 5.
Osserviamo alcuni aspetti della sintassi:
aebsono i nomi delle variabili. Octave distingue tra lettere maiuscole e minuscole:aeAidentificano due variabili differenti.=è l’operatore di assegnazione. Il suo compito è memorizzare nella variabile a sinistra il valore dell’espressione a destra. Non deve essere confuso con==, utilizzato per confrontare due valori.;è il punto e virgola. Inserito alla fine dell’istruzione, impedisce la visualizzazione automatica del risultato nella console, senza modificare il valore assegnato.
Le variabili possono essere utilizzate in operazioni successive e possono assumere nuovi valori durante l’esecuzione dello script.
I principali tipi di dati
Octave dispone di diversi tipi di dati. Per cominciare, esamineremo quelli utilizzati nel nostro esperimento: numeri in virgola mobile, interi, valori logici, sequenze di caratteri e numeri complessi.
Nel nostro script troviamo le seguenti istruzioni:
a = 12;
b = 5;

integer_value = int16(7);
logical_value = logical(1);
text_value = 'Scientific calculator';
complex_value = complex(3, 4);
Analizziamole singolarmente.
Numeri in virgola mobile (double)
Le variabili a e b contengono numeri che Octave rappresenta, per impostazione predefinita, mediante il tipo double.
Questo formato utilizza normalmente 64 bit secondo lo standard IEEE 754 e permette di rappresentare sia numeri interi sia numeri con una parte frazionaria.
Ad esempio, 12, 3.14159 e 0.001 possono essere rappresentati come valori double.
È importante osservare che il valore 12, pur essendo matematicamente un numero intero, non appartiene automaticamente a un tipo intero come int16: la sua classe predefinita è double.
Numeri interi (int16)
L’istruzione:
integer_value = int16(7);crea un valore intero con segno rappresentato mediante 16 bit.
Il tipo int16 può rappresentare numeri compresi tra -32768 e 32767. A differenza di double, non rappresenta valori frazionari.
Octave dispone anche di altri tipi interi, come int8, int32, int64 e le corrispondenti versioni senza segno (uint8, uint16 e così via).
Valori logici (logical)
L’istruzione:
logical_value = logical(1);produce un valore logico vero.
Un dato logico può assumere due stati: true (vero) oppure false (falso). La funzione logical() permette di convertire un valore nel corrispondente valore logico.
I valori logici vengono utilizzati soprattutto per controllare il flusso di esecuzione di un programma, per esempio nelle istruzioni if, e per verificare condizioni matematiche.
Testo (char)
L’istruzione:
text_value = 'Scientific calculator';assegna alla variabile una sequenza di caratteri.
In questo caso gli apici singoli identificano un vettore di caratteri, appartenente alla classe char.
Questa rappresentazione è particolarmente utile per messaggi, etichette, nomi e altri elementi testuali. Nelle lezioni successive incontreremo anche le differenze tra le varie rappresentazioni del testo e gli array di celle.
Numeri complessi
GNU Octave supporta nativamente i numeri complessi, particolarmente importanti nello studio dei circuiti elettrici, dei segnali e dei sistemi dinamici.
Nel nostro script utilizziamo:
complex_value = complex(3, 4);La funzione complex() costruisce un numero complesso a partire dalla parte reale e dalla parte immaginaria.
Il risultato è:
\[ z = 3 + 4i \]dove i è l’unità immaginaria, definita dalla relazione:
\[i^2 = -1\]
Un particolare interessante è che un numero complesso può appartenere alla classe double, proprio come un normale numero reale. Questo perché la classe indica il formato numerico utilizzato, mentre la presenza di una parte immaginaria è una caratteristica del valore.
Come riconoscere il tipo di una variabile
Per conoscere la classe di una variabile possiamo utilizzare la funzione nativa class().
Ad esempio:
class(a)
class(integer_value)
class(logical_value)
class(text_value)
class(complex_value)
Il risultato sarà rispettivamente:
double
int16
logical
char
double
Possiamo inoltre verificare alcune proprietà dei valori utilizzando funzioni come isnumeric(), islogical(), ischar() e isreal().
Per esempio:
isreal(complex_value)restituisce false, perché il nostro numero complesso possiede una parte immaginaria diversa da zero.
Questa distinzione fra classe del dato e proprietà del suo valore è importante: due variabili della stessa classe possono contenere dati con caratteristiche matematiche differenti.
Visualizzare i valori durante l’esecuzione
Nel nostro script, per visualizzare le variabili insieme alla loro classe, utilizziamo fprintf().
Un esempio è:
fprintf('Variable a = %.12g (class: %s)\n', a, class(a));Questa istruzione produce:
Variable a = 12 (class: double)Il primo argomento contiene il formato del messaggio; gli argomenti successivi forniscono i valori che verranno inseriti nelle posizioni indicate dai segnaposto.
In particolare, %.12g permette di rappresentare un valore numerico con fino a 12 cifre significative, %s inserisce una sequenza di caratteri e \n provoca il passaggio alla riga successiva.
GNU Octave dispone anche della funzione printf(), con un funzionamento molto simile per la stampa sullo standard output.
Approfondiremo entrambe le funzioni quando analizzeremo le istruzioni utilizzate per visualizzare e verificare i risultati del nostro esperimento.
Perché questa distinzione è importante in GX-TXT
I tipi di dati che abbiamo appena esaminato appartengono a GNU Octave e non richiedono alcuna API specifica di GX-TXT.
Quando però utilizzeremo i servizi numerici del framework, incontreremo un secondo livello di descrizione dei dati: le strutture tipizzate utilizzate dalle API pubbliche.
Per esempio, vedremo come una variabile numerica possa essere rappresentata mediante una struttura che specifica esplicitamente se il dato è uno scalare, un vettore o una matrice.
Comprendere la differenza tra i tipi nativi di Octave e le strutture utilizzate per comunicare con GX-TXT sarà fondamentale per interpretare correttamente le chiamate al servizio NUMERIC_API_v1.
Prima di affrontare questa integrazione, dobbiamo però imparare a eseguire i calcoli direttamente con Octave.
Nella prossima sezione esamineremo quindi gli operatori aritmetici, la precedenza delle operazioni e l’utilizzo delle parentesi, partendo dalle variabili a = 12 e b = 5 già definite.
GNU Octave e MATLAB: cosa hanno in comune e cosa cambia
Approfondimento — GNU Octave e MATLAB: similitudini e differenze
GNU Octave e MATLAB condividono gran parte della sintassi e del modello di programmazione. Octave è stato sviluppato con particolare attenzione alla compatibilità con MATLAB, rendendo relativamente semplice trasferire molti script numerici da un ambiente all’altro.
Le principali similitudini
In entrambi i linguaggi:
- Le variabili vengono create mediante assegnazione, senza dichiararne preventivamente il tipo.
- I valori numerici sono normalmente rappresentati come
double. - Sono disponibili tipi come
int16,logical,chare numeri complessi. - Le funzioni
class(),isnumeric(),isreal(),complex()eabs()hanno funzionalità sostanzialmente equivalenti. - Il punto e virgola
;sopprime la visualizzazione automatica dei risultati. - I nomi delle variabili distinguono maiuscole e minuscole.
Per esempio, il seguente codice funziona in entrambi gli ambienti:
a = 12;
b = int16(7);
z = complex(3, 4);

class(a)
class(b)
abs(z)
Le differenze da conoscere
- Stringhe: in GNU Octave le virgolette doppie producono generalmente un array di caratteri
char; nelle versioni moderne di MATLAB producono un oggettostring. Gli apici singoli identificano invece arraycharin entrambi. - Commenti: Octave accetta sia
%sia#; MATLAB utilizza%. - Strutture di controllo: Octave supporta terminatori specifici come
endifeend_try_catch, mentre MATLAB utilizzaend. - Stampa formattata: Octave dispone di
printf()efprintf(); MATLAB utilizza principalmentefprintf(). - Licenza: GNU Octave è software libero distribuito sotto GNU GPL; MATLAB è un prodotto commerciale proprietario.
Consideriamo questa istruzione:
text = "Scientific calculator";
class(text)
In GNU Octave il risultato è char, mentre nelle versioni moderne di MATLAB è string.
Questa distinzione può influenzare le operazioni sul testo e il passaggio degli argomenti alle funzioni. Per mantenere la compatibilità fra i due ambienti, l’utilizzo degli apici singoli per i vettori di caratteri rappresenta generalmente una scelta sicura.
E per gli script GX-TXT?
Gli script del nostro corso sono scritti in GNU Octave, ma utilizzano anche API pubbliche specifiche di GX-TXT.
Le istruzioni native, come le operazioni aritmetiche, struct(), assert() e abs(), sono in larga parte trasferibili a MATLAB. Le funzioni del framework, come gxtxt_api_call() e gxtxt_api_require(), richiedono invece l’ambiente GX-TXT e il relativo Script Bridge.
In sintesi: imparare GNU Octave significa acquisire competenze direttamente applicabili anche a MATLAB. Le differenze esistono, soprattutto nella gestione del testo, in alcune estensioni sintattiche e nelle librerie disponibili, ma la base della programmazione numerica è ampiamente condivisa.
Riferimenti: GNU Octave — Strings | MATLAB — Character and String Arrays
Operatori aritmetici e precedenza delle operazioni in GNU Octave
Dopo aver imparato a creare variabili e riconoscerne i tipi, possiamo cominciare a utilizzarle per eseguire calcoli matematici.
GNU Octave mette a disposizione gli operatori aritmetici comunemente utilizzati in matematica, con una sintassi molto simile a quella di MATLAB. Possiamo eseguire addizioni, sottrazioni, moltiplicazioni, divisioni ed elevamenti a potenza, combinando più operazioni all’interno della stessa espressione.
Gli operatori aritmetici fondamentali
Riprendiamo le due variabili già definite:
a = 12;
b = 5;
Con queste variabili possiamo utilizzare i seguenti operatori:
| Operatore | Operazione | Esempio | Risultato |
|---|---|---|---|
+ | Addizione | a + b | 17 |
- | Sottrazione | a - b | 7 |
* | Moltiplicazione | a * b | 60 |
/ | Divisione | a / b | 2.4 |
^ | Elevamento a potenza | a ^ b | 248832 |
Nel nostro script eseguiamo queste operazioni e memorizziamo i risultati in nuove variabili:
native_add = a + b;
native_subtract = a - b;
native_multiply = a * b;
native_divide = a / b;
native_power = a ^ b;
Ogni istruzione viene valutata da Octave e il risultato viene assegnato alla variabile indicata a sinistra dell’operatore =.
È importante sottolineare che il risultato di un’operazione non modifica automaticamente i valori delle variabili di partenza.
Per esempio, dopo l’istruzione:
native_add = a + b;le variabili a e b continuano a contenere rispettivamente 12 e 5, mentre native_add contiene 17.
Se invece scrivessimo:
a = a + b;il valore di a diventerebbe 17. L’espressione a destra viene calcolata utilizzando i valori correnti delle variabili, dopodiché il risultato viene assegnato alla variabile a sinistra.
La precedenza degli operatori
Quando un’espressione contiene più operazioni, Octave deve stabilire in quale ordine eseguirle.
Come nella matematica tradizionale, non tutte le operazioni hanno la stessa precedenza.
Per le espressioni aritmetiche elementari possiamo ricordare questo ordine:
- Espressioni racchiuse tra parentesi.
- Elevamento a potenza.
- Moltiplicazioni e divisioni.
- Addizioni e sottrazioni.
Gli operatori con la stessa precedenza seguono le regole di associatività previste dal linguaggio.
Consideriamo l’espressione presente nel nostro script:
\[ \mathrm{precedence\_result} = a + b^{2} \]Octave esegue prima l’elevamento a potenza:
b ^ 2produce 25.a + 25produce 37.
Pertanto la variabile precedence_result assume il valore 37.
Utilizzare le parentesi per modificare l’ordine dei calcoli
Le parentesi permettono di modificare esplicitamente l’ordine di valutazione di un’espressione.
Nel nostro script troviamo anche:
parentheses_result = (a + b) ^ 2;In questo caso Octave calcola prima la somma racchiusa tra parentesi:
a + bproduce 17.17 ^ 2produce 289.
Il risultato è quindi completamente diverso da quello dell’espressione precedente.
| Espressione | Risultato |
|---|---|
a + b ^ 2 | 37 |
(a + b) ^ 2 | 289 |
Questo semplice esempio dimostra quanto sia importante utilizzare correttamente le parentesi, soprattutto quando si traducono formule matematiche in codice.
Nel calcolo scientifico è spesso consigliabile inserirle anche quando non sono strettamente necessarie, per rendere più evidente il significato dell’espressione e ridurre il rischio di errori.
La divisione e la precisione numerica
Consideriamo ora:
native_divide = a / b;Il risultato matematico è 2.4.
Octave rappresenta normalmente i risultati numerici utilizzando il formato double, basato sull’aritmetica binaria in virgola mobile.
Questo significa che alcuni numeri decimali, tra cui 2.4, non possono essere rappresentati esattamente mediante un numero finito di cifre binarie.
Nella maggior parte dei calcoli tale approssimazione è trascurabile, ma diventa importante quando dobbiamo confrontare risultati numerici oppure verificare automaticamente l’esito di un esperimento.
Per questo motivo, nello script utilizziamo un controllo come:
assert(abs(native_divide - 2.4) < 1e-12);L’istruzione verifica che la differenza assoluta tra il risultato calcolato e quello atteso sia inferiore a una tolleranza prefissata.
Approfondiremo il funzionamento di assert() e abs() nella sezione dedicata alla verifica dei risultati.
Un primo passo verso il calcolo scientifico
Gli operatori appena descritti funzionano sui valori scalari, cioè su singoli numeri.
GNU Octave, però, è stato progettato soprattutto per lavorare con vettori e matrici. In questi casi dobbiamo distinguere tra le normali operazioni algebriche e quelle eseguite elemento per elemento.
Questa distinzione è particolarmente importante perché gli operatori *, / e ^ possono assumere un significato matriciale, mentre .*, ./ e .^ indicano esplicitamente operazioni elemento per elemento.
Nel prossimo capitolo introdurremo questi operatori attraverso un semplice vettore numerico, preparando il terreno per lo studio più approfondito di vettori e matrici previsto nella Lezione 03.
Vettori e operatori elemento per elemento in GNU Octave
Finora abbiamo utilizzato variabili contenenti singoli valori numerici, chiamati scalari. Tuttavia, uno dei principali punti di forza di GNU Octave è la possibilità di lavorare direttamente con insiemi di numeri organizzati in vettori e matrici.
Questa caratteristica è particolarmente utile nel calcolo scientifico, dove spesso dobbiamo elaborare numerose misure sperimentali, campioni di un segnale oppure risultati di una simulazione.
Invece di eseguire la stessa operazione separatamente su ogni valore, Octave permette di applicarla a tutti gli elementi di un vettore attraverso un’unica istruzione.
Che cos’è un vettore?
Un vettore è un insieme ordinato di elementi numerici.
In GNU Octave possiamo creare due tipi fondamentali di vettori: vettori riga e vettori colonna.
Consideriamo queste istruzioni:
row_vector = [2, 4, 6];
column_vector = [2; 4; 6];
Nel primo caso gli elementi sono separati da virgole e formano un vettore riga:
2 4 6Nel secondo caso gli elementi sono separati da punti e virgola e formano un vettore colonna:
2
4
6Le parentesi quadre [] sono utilizzate per costruire array numerici. All’interno delle parentesi, le virgole o gli spazi separano gli elementi sulla stessa riga, mentre il punto e virgola introduce una nuova riga.
Il vettore riga ha dimensioni 1×3, mentre il vettore colonna ha dimensioni 3×1.
Questa distinzione diventerà fondamentale quando affronteremo l’algebra matriciale nella Lezione 03.
Il vettore utilizzato nel nostro esperimento
Nel nostro script abbiamo definito il seguente vettore:
v = [2; 4; 6];Contiene tre elementi, disposti verticalmente.
Vogliamo moltiplicare ogni elemento per il valore scalare 3.
Matematicamente, il calcolo corrisponde a:
2 × 3 = 6
4 × 3 = 12
6 × 3 = 18
Potremmo eseguire tre operazioni separate, ma Octave permette di ottenere lo stesso risultato con una sola istruzione:
result = v .* 3;Il risultato sarà:
   6
  12
  18
L’operatore .* indica una moltiplicazione elemento per elemento (element-wise multiplication).
Il numero 3 viene applicato a ciascun elemento del vettore, conservandone la forma originale.
Gli operatori elemento per elemento
In GNU Octave il punto che precede alcuni operatori aritmetici ha un significato preciso.
| Operatore | Significato | Esempio |
|---|---|---|
.* | Moltiplicazione elemento per elemento | v .* 3 |
./ | Divisione elemento per elemento | v ./ 2 |
.^ | Elevamento a potenza elemento per elemento | v .^ 2 |
Consideriamo, per esempio:
v = [2; 4; 6];

result_multiply = v .* 3;
result_divide = v ./ 2;
result_power = v .^ 2;
Otteniamo:
| Elemento originale | v .* 3 | v ./ 2 | v .^ 2 |
|---|---|---|---|
| 2 | 6 | 1 | 4 |
| 4 | 12 | 2 | 16 |
| 6 | 18 | 3 | 36 |
In tutti e tre i casi Octave applica l’operazione individualmente agli elementi del vettore.
Differenza tra operatori matriciali ed elemento per elemento
È importante comprendere che * e .* non sono sempre equivalenti.
L’operatore * rappresenta la moltiplicazione matriciale, mentre .* esegue la moltiplicazione elemento per elemento.
Quando uno degli operandi è uno scalare, come nell’espressione:
v * 3il risultato coincide con:
v .* 3Questo accade perché moltiplicare una matrice o un vettore per uno scalare equivale a moltiplicarne ogni elemento.
La differenza emerge quando entrambi gli operandi sono array.
Consideriamo:
a = [1, 2];
b = [3, 4];

result = a .* b;
Il risultato sarà:
3 8Ogni elemento di a viene moltiplicato per l’elemento corrispondente di b.
L’espressione:
a * binvece non è valida, perché entrambi sono vettori riga di dimensioni 1×2 e le loro dimensioni non sono compatibili con la moltiplicazione matriciale.
La stessa distinzione vale per le potenze.
Nel nostro esempio:
v .^ 2eleva al quadrato ciascuno dei tre elementi.
Scrivere:
v ^ 2non produce lo stesso risultato: l’operatore ^ richiede, per un elevamento a potenza matriciale con esponente 2, una matrice quadrata.
Il nostro vettore è 3×1 e quindi non soddisfa questo requisito.
Anche / e ./ hanno significati diversi nel caso generale: / è un operatore di divisione matriciale destra, mentre ./ divide gli elementi corrispondenti, o ciascun elemento per uno scalare.
Per le operazioni su dati sperimentali, nelle quali vogliamo applicare una formula indipendentemente a ciascuna osservazione, gli operatori elemento per elemento sono particolarmente importanti.
Come conoscere le dimensioni di un vettore
GNU Octave mette a disposizione alcune funzioni per esaminare la struttura dei dati numerici.
La funzione size() restituisce le dimensioni di un array.
Per esempio:
v = [2; 4; 6];

dimensions = size(v);
La variabile dimensions conterrà:
3 1Questo significa che il vettore contiene tre righe e una colonna.
Possiamo anche richiedere una dimensione specifica:
rows = size(v, 1);
columns = size(v, 2);
In questo caso rows sarà uguale a 3 e columns sarà uguale a 1.
Un’altra funzione utile è numel(), che restituisce il numero totale di elementi:
count = numel(v);Il risultato sarà 3.
La differenza è quindi semplice: size() descrive la forma dell’array, mentre numel() ne conta gli elementi.
Una matrice 2×3, per esempio, avrebbe dimensioni [2, 3] e conterrebbe 6 elementi.
Perché preferire le operazioni vettoriali?
Supponiamo di avere acquisito mille valori di tensione e di volerli convertire da millivolt a volt.
Utilizzando un vettore, possiamo scrivere semplicemente:
voltage_v = voltage_mv ./ 1000;Octave applicherà la conversione a tutti gli elementi.
Non occorre scrivere un ciclo per elaborare separatamente ciascun valore.
Questo modo di programmare prende il nome di vettorializzazione (vectorization) ed è uno degli aspetti più caratteristici di GNU Octave e MATLAB.
Oltre a rendere il codice più compatto e leggibile, la vettorializzazione permette spesso di sfruttare implementazioni numeriche ottimizzate.
Naturalmente non significa che i cicli siano inutili: in molte applicazioni scientifiche rimangono necessari. Impareremo a utilizzarli nelle prossime lezioni.
Vettori e API numeriche di GX-TXT
Quanto abbiamo visto finora utilizza esclusivamente le funzionalità native di GNU Octave.
Quando chiameremo i servizi numerici pubblici di GX-TXT, dovremo comunicare al framework anche la natura del dato che stiamo trasmettendo.
Per esempio, un vettore potrà essere rappresentato attraverso una struttura contenente il tipo di operando e i valori numerici:
operand = struct('kind', 'vector', 'value', [2; 4; 6]);In questo caso kind identifica la forma dell’operando richiesta dal contratto API, mentre value contiene i dati numerici.
Questa struttura non modifica la natura dei valori in Octave: costituisce semplicemente una rappresentazione esplicita utilizzata per comunicare con il servizio pubblico NUMERIC_API_v1.
Il framework può così distinguere, secondo il contratto dell’operazione, uno scalare da un vettore o una matrice.
Non confondiamo quindi il tipo numerico nativo di Octave con il campo kind utilizzato dalle API GX-TXT: i due elementi descrivono aspetti differenti dei dati.
Approfondiremo il funzionamento di struct() e delle chiamate alle API pubbliche in una sezione dedicata.
Prima, però, dobbiamo imparare a visualizzare correttamente i risultati dei calcoli e soprattutto a verificare che siano quelli attesi.
Nel prossimo capitolo introdurremo quindi le funzioni printf(), fprintf(), assert() e abs(), che nel nostro script svolgono un ruolo fondamentale nella presentazione dei risultati e nel controllo automatico della loro correttezza.
Vettori e matrici: significato matematico e differenza tra prodotto matriciale ed elemento per elemento
In matematica, vettori e matrici sono strumenti fondamentali dell’algebra lineare. Permettono di rappresentare e manipolare insiemi di numeri attraverso operazioni definite da regole precise.
Scalari, vettori e matrici
Uno scalare è un singolo valore numerico, per esempio 5 o 3,14.
Un vettore è un insieme ordinato di componenti. Possiamo rappresentarlo come vettore colonna:
\[ \mathbf{v} = \begin{bmatrix} 2\\ 4\\ 6 \end{bmatrix} \]Oppure come vettore riga:
\[ \mathbf{v}^{T} = \begin{bmatrix} 2 & 4 & 6 \end{bmatrix} \]Il simbolo \(T\) indica la trasposizione, cioè lo scambio tra righe e colonne.
Una matrice è un insieme rettangolare di elementi organizzati in righe e colonne. Per esempio:
\[ A = \begin{bmatrix} 1 & 2\\ 3 & 4 \end{bmatrix} \]Questa matrice ha dimensioni \(2 \times 2\): due righe e due colonne. In generale, una matrice \(A\) con \(m\) righe e \(n\) colonne si indica con \(A \in \mathbb{R}^{m \times n}\), quando tutti gli elementi sono numeri reali.
Prodotto scalare e prodotto tra matrici
Il prodotto scalare tra due vettori reali della stessa dimensione consiste nel moltiplicare le componenti corrispondenti e sommarne i risultati.
\[ \mathbf{a}\cdot\mathbf{b} = \sum_{i=1}^{n} a_i b_i \]Per esempio:
\[ \begin{bmatrix} 1 & 2 & 3 \end{bmatrix} \begin{bmatrix} 4\\ 5\\ 6 \end{bmatrix} = 1\cdot4+2\cdot5+3\cdot6=32 \]Il prodotto tra due matrici generalizza questo principio. Se \(A\) ha dimensioni \(m \times n\), la matrice \(B\) deve avere \(n\) righe perché il prodotto \(AB\) sia definito.
Ogni elemento della matrice risultante si calcola come:
\[ (AB)_{ij} = \sum_{k=1}^{n} A_{ik} B_{kj} \]Consideriamo due matrici:
\[ A = \begin{bmatrix} 1 & 2\\ 3 & 4 \end{bmatrix}, \qquad B = \begin{bmatrix} 5 & 6\\ 7 & 8 \end{bmatrix} \]Il loro prodotto matriciale è:
\[ AB = \begin{bmatrix} 19 & 22\\ 43 & 50 \end{bmatrix} \]In GNU Octave questa operazione si scrive semplicemente A * B.
Prodotto elemento per elemento: il prodotto di Hadamard
Esiste un’altra operazione, chiamata prodotto di Hadamard, che consiste nel moltiplicare gli elementi delle due matrici nelle posizioni corrispondenti.
\[ (A \circ B)_{ij}=A_{ij}B_{ij} \]Applicando questa operazione alle matrici precedenti otteniamo:
\[ A \circ B = \begin{bmatrix} 5 & 12\\ 21 & 32 \end{bmatrix} \]In GNU Octave il prodotto di Hadamard si esegue mediante l’operatore .*:
A = [1, 2; 3, 4];
B = [5, 6; 7, 8];

matrix_product = A * B;
elementwise_product = A .* B;
Le due operazioni hanno quindi significati matematici differenti e producono risultati diversi.
Perché anche le potenze sono differenti?
La distinzione vale anche per l’elevamento a potenza.
La potenza matriciale \(A^2\) significa moltiplicare la matrice per sé stessa:
\[ A^2 = AA = \begin{bmatrix} 7 & 10\\ 15 & 22 \end{bmatrix} \]La potenza elemento per elemento, invece, eleva al quadrato ciascun elemento:
\[ A^{\circ 2} = \begin{bmatrix} 1 & 4\\ 9 & 16 \end{bmatrix} \]In Octave si utilizzano rispettivamente A ^ 2 e A .^ 2.
Perché è importante nel calcolo scientifico?
In una simulazione numerica, il prodotto matriciale può descrivere trasformazioni geometriche, sistemi di equazioni o relazioni tra grandezze fisiche. Le operazioni elemento per elemento sono invece particolarmente utili quando vogliamo applicare una formula indipendentemente a ogni campione sperimentale.
Per esempio, se un vettore contiene valori di tensione misurati in millivolt, possiamo convertirli tutti in volt mediante:
voltage_v = voltage_mv ./ 1000;Da ricordare: in GNU Octave il punto davanti a un operatore non è un dettaglio sintattico. Distingue operazioni elemento per elemento da operazioni algebriche che possono coinvolgere l’intera struttura della matrice.
Nelle prossime lezioni approfondiremo l’algebra lineare, le trasformazioni matriciali e il loro impiego nelle applicazioni scientifiche.
Visualizzazione dei risultati e verifica automatica dei calcoli
Quando scriviamo un programma scientifico non è sufficiente eseguire correttamente le operazioni matematiche. Dobbiamo anche essere in grado di visualizzare i risultati, interpretarli e verificare che corrispondano a quelli attesi.
Un programma che termina senza segnalare errori non garantisce necessariamente che i suoi risultati siano corretti. Un errore nella formula, nell’ordine delle operazioni oppure nella gestione dei dati può produrre valori numericamente validi ma scientificamente sbagliati.
Per questo motivo, nel nostro script utilizziamo due strumenti fondamentali di GNU Octave:
- Le funzioni
printf()efprintf(), per visualizzare informazioni e risultati. - La funzione
assert(), per verificare automaticamente che determinate condizioni siano soddisfatte.
Vedremo inoltre come utilizzare abs() per calcolare valori assoluti e moduli di numeri complessi, ma anche per confrontare risultati numerici tenendo conto della precisione dei calcoli.
Visualizzare i risultati con printf() e fprintf()
GNU Octave mette a disposizione diverse funzioni per mostrare il contenuto delle variabili. Tra queste troviamo disp(), printf() e fprintf().
La funzione disp() è la più semplice: visualizza un valore senza richiedere particolari istruzioni di formattazione.
Per esempio:
a = 12;
disp(a);
produce:
12Quando però vogliamo accompagnare un valore con un messaggio esplicativo oppure controllare il numero di cifre visualizzate, è preferibile utilizzare una funzione di stampa formattata.
La sintassi di printf() è:
printf(format, value1, value2, ...);Il primo argomento specifica il testo e le regole di formattazione. Gli argomenti successivi contengono i valori da inserire nel messaggio.
Per esempio:
a = 12;
b = 5;

printf('The sum of %g and %g is %g\n', a, b, a + b);
Il risultato sarà:
The sum of 12 and 5 is 17Nel testo sono presenti tre segnaposto %g, che vengono sostituiti, nell’ordine, dai valori forniti dopo la stringa di formato.
La sequenza \n indica il carattere di nuova riga (newline) e permette di proseguire la visualizzazione sulla riga successiva.
La funzione fprintf()
Nel nostro script utilizziamo principalmente fprintf().
La sintassi generale è:
fprintf(format, value1, value2, ...);Per la stampa sullo standard output, fprintf() e printf() svolgono sostanzialmente la stessa funzione.
La differenza è che fprintf() permette anche di specificare un identificatore di file o stream come primo argomento, rendendola adatta anche alla scrittura formattata su file.
Nel nostro esperimento la utilizziamo esclusivamente per visualizzare risultati. Non apriamo né scriviamo file direttamente.
Consideriamo questa istruzione, tratta dallo script:
fprintf('Variable a = %.12g (class: %s)\n', a, class(a));L’output prodotto è:
Variable a = 12 (class: double)Esaminiamo gli elementi che compongono l’istruzione.
La stringa di formato
Il testo racchiuso tra apici singoli stabilisce come apparirà il messaggio.
Al suo interno possiamo inserire testo ordinario, caratteri speciali e segnaposto che verranno sostituiti dai valori delle variabili.
Il segnaposto %.12g
La lettera g indica un formato numerico generale, che seleziona una rappresentazione decimale o scientifica in funzione del valore da visualizzare.
Il numero .12 richiede fino a 12 cifre significative nella rappresentazione del numero.
Questo formato è particolarmente utile quando lavoriamo con risultati scientifici di grandezze differenti.
Il segnaposto %s
Questo segnaposto viene utilizzato per inserire una sequenza di caratteri.
Nel nostro esempio, la funzione class(a) restituisce il nome della classe della variabile a, che viene inserito nel messaggio.
Il carattere \n
Indica una nuova riga.
Senza questa sequenza, i messaggi successivi potrebbero essere visualizzati uno di seguito all’altro sulla stessa riga.
I principali segnaposto di formattazione
| Segnaposto | Significato | Esempio |
|---|---|---|
%d | Numero intero in formato decimale | 12 |
%f | Numero in virgola mobile, formato decimale | 2.400000 |
%.2f | Numero con due cifre dopo il separatore decimale | 2.40 |
%e | Notazione scientifica | 2.400000e+00 |
%g | Formato numerico generale | 2.4 |
%.12g | Formato generale con 12 cifre significative | 2.4 |
%s | Sequenza di caratteri | double |
%% | Carattere percentuale letterale | % |
È importante comprendere che la formattazione modifica soltanto il modo in cui un numero viene visualizzato, non il valore numerico memorizzato nella variabile.
Per esempio:
x = 2.4;

fprintf('%.2f\n', x);
fprintf('%.8f\n', x);
fprintf('%.12g\n', x);
Le tre istruzioni visualizzeranno rappresentazioni differenti dello stesso valore.
Il contenuto di x non cambia.
Visualizzare i risultati del nostro esperimento
Nel nostro script troviamo:
fprintf('E01: a + b = %.12g\n', native_add);
fprintf('E02: a - b = %.12g\n', native_subtract);
fprintf('E03: a * b = %.12g\n', native_multiply);
fprintf('E04: a / b = %.12g\n', native_divide);
fprintf('E05: a ^ b = %.12g\n', native_power);
Le istruzioni producono un resoconto leggibile dei calcoli:
E01: a + b = 17
E02: a - b = 7
E03: a * b = 60
E04: a / b = 2.4
E05: a ^ b = 248832
Le sigle E01, E02 e così via identificano le singole prove sperimentali.
Questa organizzazione è utile perché permette di confrontare facilmente i risultati dello script con quelli previsti dal protocollo di verifica.
In GX-TXT i messaggi scritti sullo standard output vengono raccolti dal sistema di esecuzione degli script e possono essere consultati attraverso il pannello Program output dei risultati del Job.
Non abbiamo quindi bisogno di produrre autonomamente file di log: il framework gestisce la raccolta dell’output dell’esecuzione.
Verificare automaticamente i risultati con assert()
La visualizzazione dei risultati permette a chi legge di controllarli, ma non è sufficiente per costruire programmi scientifici affidabili.
Un approccio migliore consiste nel far eseguire al programma stesso alcune verifiche.
GNU Octave mette a disposizione la funzione assert(), utilizzata per controllare che una condizione sia vera.
La forma più semplice è:
assert(condition);Se la condizione è vera, l’esecuzione prosegue normalmente.
Se invece è falsa, Octave genera un errore.
Consideriamo questo esempio:
a = 12;
b = 5;

result = a + b;

assert(result == 17);
L’operatore == verifica l’uguaglianza tra il risultato e il valore atteso.
Poiché 12 + 5 è uguale a 17, il controllo viene superato.
Se scrivessimo invece:
assert(result == 18);Octave segnalerebbe il fallimento della verifica.
Questo comportamento è intenzionale: il controllo deve evidenziare immediatamente una condizione non soddisfatta.
Nel nostro script utilizziamo assert() per verificare tutti i principali risultati numerici.
Per esempio:
assert(native_add == 17);
assert(native_subtract == 7);
assert(native_multiply == 60);
assert(native_power == 248832);
Queste istruzioni costituiscono un primo esempio di test automatici, una tecnica ampiamente utilizzata nello sviluppo di software scientifico.
Perché non sempre possiamo confrontare due numeri con ==
I numeri in virgola mobile vengono rappresentati mediante un numero finito di cifre binarie.
Di conseguenza, molte quantità decimali non possono essere memorizzate esattamente.
Questo può produrre piccole differenze tra un risultato calcolato e quello teoricamente atteso.
Per confrontare risultati approssimati è quindi spesso preferibile utilizzare una tolleranza numerica.
Nel nostro script troviamo:
assert(abs(native_divide - 2.4) < 1e-12);Questa istruzione contiene diversi elementi importanti.
Per prima cosa viene calcolata la differenza:
native_divide - 2.4Successivamente viene applicata la funzione abs(), che restituisce il valore assoluto della differenza.
Infine, il risultato viene confrontato con la tolleranza 1e-12, equivalente a 0,000000000001.
Il controllo viene superato quando:
\[ |x_{\mathrm{calcolato}} – x_{\mathrm{atteso}}| < \varepsilon \]dove \(\varepsilon\) rappresenta la tolleranza scelta.
Nel nostro caso:
\[ \varepsilon = 10^{-12} \]Questo tipo di confronto viene chiamato confronto con tolleranza assoluta.
È adatto agli esempi numerici semplici che stiamo utilizzando, ma non è una regola universale: per valori molto grandi o molto piccoli, oppure per grandezze con differenti scale, possono essere preferibili tolleranze relative o combinate.
La scelta della tolleranza deve dipendere dalla precisione numerica richiesta e dal significato scientifico del calcolo.
La funzione abs(): valore assoluto e modulo complesso
La funzione abs() è disponibile nativamente in GNU Octave e possiede due applicazioni particolarmente importanti.
Valore assoluto di un numero reale
Per un numero reale, abs() restituisce il valore senza segno.
abs(-7)restituisce:
7Matematicamente, il valore assoluto rappresenta la distanza del numero dallo zero sulla retta reale.
Modulo di un numero complesso
Nel caso di un numero complesso, abs() restituisce il modulo, cioè la sua distanza dall’origine del piano complesso.
Consideriamo il numero già introdotto:
z = complex(3, 4);Per un numero complesso \(z = a + bi\), il modulo è definito dalla relazione:
\[ |z| = \sqrt{a^2 + b^2} \]Nel nostro esempio:
\[ |3+4i| = \sqrt{3^2 + 4^2} = \sqrt{25} = 5 \]In GNU Octave possiamo scrivere:
complex_magnitude = abs(z);Il risultato è 5.
Nel nostro script il controllo corrispondente è:
assert(abs(complex_magnitude - 5) < 1e-12);Osserviamo che abs() viene utilizzata due volte con scopi differenti: prima per calcolare il modulo del numero complesso, poi per verificare la differenza assoluta rispetto al risultato atteso.
La stessa funzione si adatta quindi alla natura del dato numerico che riceve.
Verificare vettori e array
Finora abbiamo utilizzato assert() per verificare risultati scalari, ma possiamo applicare lo stesso principio anche agli array.
Nel nostro esperimento troviamo:
assert(isequal(size(v), [3, 1]));
assert(isequal(vector_times_three, [6; 12; 18]));
La prima istruzione controlla le dimensioni del vettore.
La seconda verifica che tutti gli elementi del risultato corrispondano a quelli attesi, mantenendo anche la stessa forma.
La funzione isequal() restituisce un valore logico che indica se gli argomenti confrontati sono uguali.
Per confrontare invece due insiemi di risultati in virgola mobile, utilizziamo:
assert(all(abs(api_values - native_values) < 1e-12));Esaminiamo il funzionamento di questa istruzione:
api_values - native_valuescalcola le differenze tra gli elementi corrispondenti.abs()restituisce il valore assoluto di ciascuna differenza.< 1e-12produce un array di valori logici.all()verifica che tutte le condizioni siano vere.assert()segnala un errore se la verifica complessiva non viene superata.
Questo controllo è particolarmente importante nel nostro esperimento, perché confronta i risultati ottenuti attraverso le API numeriche GX-TXT con quelli calcolati direttamente in Octave.
Dalla visualizzazione alla verifica scientifica
Le funzioni di stampa e di verifica svolgono quindi ruoli differenti ma complementari.
printf() e fprintf() permettono di comunicare i risultati in modo comprensibile.
assert() permette di verificare automaticamente che il programma rispetti determinate condizioni.
abs() consente di lavorare con valori assoluti e moduli complessi, ma anche di costruire confronti numerici con tolleranza.
Insieme, queste funzioni rappresentano un primo passo verso la costruzione di script verificabili e riproducibili.
Nel nostro esperimento, il messaggio finale:
LESSON 02: ALL CHECKS PASSED.viene stampato soltanto dopo che il programma ha superato tutte le verifiche previste, comprese quelle eseguite mediante i servizi numerici GX-TXT e il controllo della divisione per zero.
L’assenza di errori e il completamento corretto del Job ci permettono quindi di documentare un esperimento realmente verificato, pur senza considerare questi test una dimostrazione generale dell’assenza di ogni possibile errore.
Nel prossimo capitolo vedremo come utilizzare struct() e le cell array per organizzare dati strutturati, introducendo gli strumenti necessari per comunicare con le API pubbliche di GX-TXT. Successivamente affronteremo la gestione degli errori mediante try e catch.
Strutture dati e cell array: organizzare le informazioni in GNU Octave
Nei capitoli precedenti abbiamo imparato a lavorare con variabili, scalari, vettori e matrici. Tutti questi strumenti ci permettono di rappresentare ed elaborare dati numerici, ma in un programma scientifico abbiamo spesso bisogno di organizzare informazioni di natura differente.
Pensiamo, per esempio, a una misura sperimentale: oltre al valore numerico potremmo voler conservare il nome della grandezza, l’unità di misura, la data dell’esperimento e altre informazioni descrittive.
GNU Octave mette a disposizione diversi strumenti per organizzare questi dati. In questo capitolo ci concentreremo su due particolarmente importanti:
- Le strutture (
struct), che consentono di associare informazioni a campi identificati da un nome. - Le cell array, che permettono di raccogliere elementi di tipi e dimensioni differenti all’interno di un unico contenitore.
Entrambe vengono utilizzate nel nostro script per comunicare con le API pubbliche di GX-TXT.
Che cos’è una struttura?
Una struttura è un contenitore di dati organizzati in campi, ciascuno identificato da un nome.
A differenza di un normale vettore numerico, una struttura può contenere contemporaneamente numeri, testo, valori logici, vettori e altre strutture.
Consideriamo un semplice esempio:
measurement = struct( ...
    'name', 'Voltage', ...
    'value', 12.5, ...
    'unit', 'V', ...
    'valid', true);
Abbiamo creato una variabile chiamata measurement contenente quattro campi.
| Campo | Valore | Significato |
|---|---|---|
name | 'Voltage' | Nome della grandezza |
value | 12.5 | Valore numerico |
unit | 'V' | Unità di misura |
valid | true | Indicatore logico di validità |
La funzione struct() riceve una sequenza di coppie formate dal nome del campo e dal relativo valore.
La sintassi generale, nel caso di campi con valori scalari, è:
variable = struct('field1', value1, 'field2', value2);I nomi dei campi sono specificati come stringhe di caratteri, mentre i valori possono appartenere a tipi differenti.
Si noti che la struttura dell’esempio è una normale variabile Octave: non abbiamo ancora utilizzato alcuna funzione GX-TXT.
Accedere ai campi di una struttura
Per leggere il contenuto di un campo utilizziamo l’operatore punto (.).
Per esempio:
measurement.name
measurement.value
measurement.unit
measurement.valid
Le istruzioni restituiscono i valori corrispondenti.
Possiamo anche utilizzare un campo all’interno di un’espressione:
double_voltage = measurement.value * 2;Il risultato sarà 25.
Il punto può essere utilizzato anche per modificare un campo già esistente:
measurement.value = 15.0;Dopo questa istruzione, il campo value conterrà 15.0, mentre gli altri campi resteranno invariati.
Possiamo inoltre aggiungere nuovi campi:
measurement.temperature = 25;La struttura contiene ora anche un’informazione relativa alla temperatura.
Questa flessibilità rende le strutture particolarmente utili per rappresentare dati sperimentali e parametri di configurazione.
Verificare una struttura con isstruct() e isfield()
Quando riceviamo una struttura da una funzione, può essere utile verificarne il contenuto prima di utilizzarla.
GNU Octave mette a disposizione la funzione isstruct(), che controlla se un valore appartiene alla classe delle strutture.
Per esempio:
isstruct(measurement)restituisce true.
La funzione isfield() permette invece di verificare la presenza di un campo specifico:
isfield(measurement, 'value')Anche in questo caso il risultato è true.
Se provassimo a verificare un campo inesistente:
isfield(measurement, 'pressure')otterremmo false.
Questi controlli sono particolarmente importanti quando utilizziamo funzioni che restituiscono risultati strutturati, perché permettono di evitare l’accesso a campi che potrebbero non essere disponibili.
Nel nostro script, per esempio, troviamo:
context = gxtxt_context();

if (isfield(context, 'script_name'))
  fprintf('Running script: %s\n', context.script_name);
endif
La funzione pubblica gxtxt_context() restituisce informazioni relative all’esecuzione corrente dello script dentro GX-TXT.
Prima di leggere il campo script_name, verifichiamo che sia presente.
L’istruzione if permette di eseguire la stampa soltanto quando la condizione è soddisfatta.
Il blocco termina con endif, una delle forme sintattiche supportate da GNU Octave.
Che cosa sono le cell array?
Le cell array sono un altro importante tipo di contenitore disponibile in GNU Octave.
Un normale array numerico contiene elementi organizzati in una struttura omogenea. Una cell array, invece, può contenere elementi di tipi differenti, ciascuno conservando la propria natura.
Per esempio:
data = {12.5, 'Voltage', true, [1; 2; 3]};Abbiamo creato una cell array contenente quattro elementi:
- Un numero in virgola mobile.
- Una sequenza di caratteri.
- Un valore logico.
- Un vettore numerico.
La caratteristica fondamentale delle cell array è l’utilizzo delle parentesi graffe {}.
Confrontiamo:
numeric_array = [10, 20, 30];

cell_array = {10, 'Voltage', true};
La prima istruzione crea un array numerico.
La seconda crea un contenitore nel quale ogni cella può avere un tipo differente.
Accedere agli elementi di una cell array
Per accedere agli elementi dobbiamo distinguere due forme di indicizzazione.
Consideriamo:
data = {12.5, 'Voltage', true};Utilizzando le parentesi graffe:
data{1}otteniamo direttamente il contenuto della prima cella, cioè il numero 12.5.
Utilizzando invece le parentesi tonde:
data(1)otteniamo una nuova cell array contenente la prima cella.
La differenza è importante:
data{1}estrae il valore contenuto nella cella.data(1)estrae una porzione della cell array, conservando il contenitore.
Come per gli array numerici, l’indicizzazione in GNU Octave comincia da 1, non da 0.
Questa convenzione è condivisa con MATLAB e rappresenta una differenza rispetto a linguaggi come C e Python, nei quali gli indici degli array iniziano normalmente da zero.
Parentesi quadre, tonde e graffe: tre significati differenti
Ricapitoliamo il significato delle parentesi che abbiamo incontrato.
| Simbolo | Utilizzo principale | Esempio |
|---|---|---|
[] | Costruzione e concatenazione di array | [1, 2, 3] |
() | Chiamate di funzione e indicizzazione | size(v), v(2) |
{} | Costruzione di cell array ed estrazione del loro contenuto | {'add', a, b}, data{1} |
Le parentesi tonde vengono utilizzate anche per raggruppare le espressioni matematiche, modificando l’ordine delle operazioni.
È importante ricordare che la stessa notazione può svolgere funzioni differenti a seconda del contesto.
Strutture e cell array nelle API pubbliche GX-TXT
Possiamo ora comprendere una parte fondamentale del funzionamento del nostro script.
Quando utilizziamo il servizio numerico pubblico NUMERIC_API_v1, dobbiamo rappresentare gli operandi secondo il contratto previsto dall’API.
Consideriamo queste istruzioni effettivamente presenti nel programma:
operand_a = struct('kind', 'scalar', 'value', a);
operand_b = struct('kind', 'scalar', 'value', b);
Le strutture contengono due campi.
Il campo kind indica la forma dell’operando secondo la convenzione dell’API.
Per le operazioni numeriche considerate in questa lezione, i valori ammessi comprendono:
scalar: un singolo valore numerico.vector: un vettore numerico.matrix: una matrice numerica.
Il campo value contiene il dato numerico effettivo.
Nel nostro esempio, operand_a.value contiene 12 e operand_b.value contiene 5.
Dobbiamo distinguere questi campi dalle classi native Octave. Il valore scalar non è una classe come double o int16: è un’informazione richiesta dal contratto della specifica API GX-TXT.
Come vengono utilizzate le cell array nelle chiamate alle API
Consideriamo ora la chiamata utilizzata per eseguire un’addizione attraverso GX-TXT:
api_add = gxtxt_api_call('NUMERIC_API_v1', 'array_binary', ...
                         {'add', operand_a, operand_b});
Questa istruzione contiene diversi elementi, che analizzeremo più approfonditamente nel capitolo dedicato alle API.
Per il momento concentriamoci sul terzo argomento:
{'add', operand_a, operand_b}Si tratta di una cell array contenente tre elementi:
| Posizione | Contenuto | Significato |
|---|---|---|
| 1 | 'add' | Operazione aritmetica richiesta |
| 2 | operand_a | Primo operando strutturato |
| 3 | operand_b | Secondo operando strutturato |
La cell array permette quindi di trasmettere al framework una sequenza ordinata di argomenti, anche quando questi appartengono a tipi differenti.
La funzione gxtxt_api_call() utilizza questa convenzione per inoltrare la richiesta al servizio pubblico registrato.
La sequenza degli argomenti è importante: nel caso di operazioni come la sottrazione o la divisione, invertire i due operandi può produrre un risultato differente.
Recuperare il risultato restituito dall’API
La funzione gxtxt_api_call() restituisce il risultato dell’operazione, che nel nostro caso è una struttura.
Per esempio:
api_add = gxtxt_api_call('NUMERIC_API_v1', 'array_binary', ...
                         {'add', operand_a, operand_b});
Per le operazioni array_binary utilizzate nella lezione, il risultato numerico si trova nel campo pubblico values.
Possiamo quindi scrivere:
result = api_add.values;La variabile result conterrà 17.
Abbiamo così completato un ciclo di comunicazione con GX-TXT:
- Prepariamo i dati utilizzando strutture Octave.
- Organizziamo gli argomenti in una cell array.
- Invochiamo il servizio pubblico attraverso lo Script Bridge.
- Riceviamo una struttura contenente il risultato.
- Estraiamo il dato numerico mediante l’accesso al campo
values.
È importante osservare che non abbiamo avuto bisogno di accedere ai file interni del framework né di chiamare funzioni private del CORE.
L’interazione avviene esclusivamente mediante interfacce pubbliche.
Un esempio con un vettore
Il medesimo meccanismo funziona anche con vettori numerici.
Nel nostro script utilizziamo:
v = [2; 4; 6];

operand_v = struct('kind', 'vector', 'value', v);
operand_three = struct('kind', 'scalar', 'value', 3);

api_vector = gxtxt_api_call('NUMERIC_API_v1', 'array_binary', ...
                            {'multiply', operand_v, operand_three});
Il primo operando è un vettore e il secondo è uno scalare.
Il servizio numerico applica lo scalare ai singoli elementi del vettore secondo le regole di espansione previste dall’API.
Il risultato contenuto in api_vector.values è:
6
12
18
Possiamo confrontarlo con il calcolo nativo:
vector_times_three = v .* 3;Questa operazione, chiamata scalar broadcasting, costituisce un esempio concreto di come GX-TXT possa eseguire elaborazioni numeriche su dati trasmessi da uno script.
Perché strutture e cell array sono importanti?
Le strutture e le cell array non servono soltanto a organizzare meglio il codice.
Nel contesto di GX-TXT costituiscono strumenti fondamentali per comunicare in modo esplicito con le API pubbliche.
Le strutture permettono di associare nomi e significati ai dati. Le cell array permettono di organizzare gli argomenti di una chiamata secondo un ordine definito.
La combinazione di questi strumenti rende possibile costruire interfacce di programmazione nelle quali ogni operazione possiede un contratto documentato.
In questa lezione abbiamo introdotto soltanto le strutture necessarie alle operazioni numeriche elementari. Nelle lezioni successive incontreremo strutture più articolate per rappresentare Dataset, metadata, selezioni e risultati scientifici.
Prima di approfondire tutte le API utilizzate nello script, dobbiamo però esaminare un altro aspetto fondamentale della programmazione: la gestione degli errori.
Nel prossimo capitolo vedremo come utilizzare try e catch per intercettare condizioni anomale e distinguere gli errori previsti dai problemi che devono interrompere l’esecuzione del programma.
Gestione degli errori in GNU Octave: try, catch e controlli preventivi
Quando un programma scientifico esegue un calcolo, non possiamo dare per scontato che tutti i dati siano sempre validi.
Un denominatore potrebbe essere uguale a zero, una matrice potrebbe avere dimensioni incompatibili con un’operazione oppure una funzione potrebbe ricevere un argomento che non soddisfa le condizioni richieste.
In questi casi è importante che il programma sappia riconoscere una condizione anomala e reagire in modo controllato, evitando di produrre risultati scientificamente non validi.
GNU Octave mette a disposizione diversi strumenti per gestire queste situazioni. Nel nostro esperimento utilizziamo principalmente due tecniche:
- Il controllo preventivo, mediante istruzioni condizionali
ifedelse, per evitare operazioni che sappiamo essere problematiche. - La gestione delle eccezioni, mediante
tryecatch, per intercettare gli errori generati durante l’esecuzione.
Vedremo entrambe le tecniche attraverso un esempio concreto: la divisione per zero.
Il controllo preventivo con if ed else
Consideriamo una semplice divisione:
a = 12;
b = 0;

result = a / b;
Dal punto di vista matematico, la divisione per zero non è definita.
GNU Octave, utilizzando l’aritmetica IEEE 754 in virgola mobile, può rappresentare determinate operazioni non finite mediante valori speciali come Inf e NaN.
Tuttavia, la possibilità di rappresentare questi valori non significa che il risultato sia automaticamente accettabile in un’elaborazione scientifica.
Per evitare il problema possiamo controllare il denominatore prima di eseguire la divisione.
Nel nostro script troviamo:
zero_denominator = 0;

if (zero_denominator == 0)
  fprintf('\nDivision-by-zero guard: native division skipped.\n');
else
  unused_result = a / zero_denominator;
endif
Analizziamo le istruzioni.
La condizione if
L’istruzione if permette di eseguire un blocco di codice soltanto quando una condizione risulta vera.
La sintassi generale è:
if (condition)
  % Statements executed when the condition is true.
else
  % Statements executed when the condition is false.
endif
Nel nostro caso la condizione è:
zero_denominator == 0L’operatore == confronta i due valori e restituisce un risultato logico.
Se il denominatore è uguale a zero, Octave esegue il primo blocco, stampando un messaggio informativo.
Se invece il denominatore è diverso da zero, esegue il blocco dopo else, effettuando la divisione.
La parola chiave endif
L’istruzione endif segnala la conclusione della struttura condizionale.
GNU Octave permette anche di utilizzare il terminatore generico end, ma endif rende immediatamente riconoscibile la struttura che viene chiusa.
Questa forma è una delle estensioni sintattiche di Octave rispetto a MATLAB, nel quale si utilizza end.
La differenza tra prevenire un errore e intercettarlo
Il controllo preventivo funziona quando possiamo identificare una condizione non valida prima di eseguire un’operazione.
Non sempre, però, possiamo prevedere tutte le possibili cause di errore.
Una funzione potrebbe generare un’eccezione durante il calcolo, un servizio esterno potrebbe rifiutare una richiesta oppure un’API potrebbe rilevare un problema che il nostro script non è in grado di diagnosticare autonomamente.
In questi casi possiamo utilizzare il meccanismo try e catch.
La struttura try e catch
La sintassi generale di GNU Octave è:
try
  % Operations that may generate an error.
catch err
  % Operations executed if an error occurs.
end_try_catch
Il funzionamento segue una sequenza precisa.
- Octave inizia a eseguire le istruzioni contenute nel blocco
try. - Se non si verificano errori, il blocco
catchviene saltato. - Se un’istruzione genera un errore, l’esecuzione del blocco
trysi interrompe. - Il controllo passa al blocco
catch, dove possiamo analizzare l’errore e decidere come reagire. - Terminato il blocco
catch, il programma può proseguire con le istruzioni successive.
La variabile err contiene informazioni relative all’errore intercettato.
In particolare, il campo err.message contiene il messaggio diagnostico.
Il nome err è una nostra scelta: potremmo utilizzare un altro identificatore valido.
Un esempio elementare di try e catch
Consideriamo questo esempio:
try
  error('An example error occurred.');
catch err
  fprintf('Caught error: %s\n', err.message);
end_try_catch

fprintf('Program execution continues.\n');
La funzione error() genera intenzionalmente un errore.
Poiché l’istruzione si trova all’interno di un blocco try, l’errore viene intercettato da catch.
Il programma visualizza quindi:
Caught error: An example error occurred.
Program execution continues.
Questo esempio dimostra una caratteristica fondamentale: un errore intercettato non deve necessariamente provocare la terminazione dell’intero programma.
Possiamo decidere di registrarlo, gestirlo e proseguire, purché la prosecuzione sia coerente con la validità dei risultati.
Il caso della divisione per zero nelle API GX-TXT
Nel nostro script vogliamo verificare anche il comportamento del servizio numerico pubblico di GX-TXT.
Abbiamo già visto che NUMERIC_API_v1 permette di eseguire operazioni aritmetiche attraverso lo Script Bridge.
Per le operazioni numeriche reali utilizzate in questa lezione, il servizio richiede normalmente input e risultati finiti, salvo esplicite opzioni documentate.
Una divisione per zero, quindi, non deve essere accettata come un normale risultato numerico finito.
Prepariamo un operando contenente il valore zero:
operand_zero = struct('kind', 'scalar', 'value', zero_denominator);Successivamente definiamo una variabile logica:
api_rejected_zero = false;Questa variabile servirà a registrare se la chiamata ha generato un errore.
La prova completa presente nello script è:
api_rejected_zero = false;

try
  invalid_result = gxtxt_api_call('NUMERIC_API_v1', 'array_binary', ...
                                  {'divide', operand_a, operand_zero});
catch err
  api_rejected_zero = true;
  fprintf('Expected GX-TXT numerical error was caught: %s\n', err.message);
end_try_catch
Analizziamo il comportamento del programma.
Prima della chiamata
La variabile api_rejected_zero viene inizializzata a false.
Durante il blocco try
Lo script invoca l’operazione pubblica array_binary, chiedendo di dividere il valore 12 per zero.
La richiesta viene inoltrata al provider numerico tramite gxtxt_api_call().
Quando viene generato l’errore
Il controllo passa al blocco catch.
La variabile api_rejected_zero viene impostata a true, mentre fprintf() visualizza il messaggio diagnostico restituito.
È importante notare che lo script non cerca di correggere automaticamente il risultato né di sostituirlo con un valore arbitrario.
L’operazione non valida viene riconosciuta come tale.
Verificare che l’errore sia stato effettivamente intercettato
Dopo il blocco try e catch, troviamo un controllo aggiuntivo:
if (!api_rejected_zero)
  error('NUMERIC_API_v1 unexpectedly accepted division by zero.');
endif
L’operatore ! rappresenta la negazione logica.
L’espressione:
!api_rejected_zeroè vera quando la variabile api_rejected_zero è falsa.
In altre parole, il controllo genera un errore se la chiamata precedente è terminata senza alcuna eccezione.
Questo ci permette di verificare non soltanto che il programma sappia eseguire operazioni corrette, ma anche che sappia riconoscere determinate condizioni non valide.
Una precisazione sul significato del test
Nel nostro script il blocco catch intercetta qualsiasi errore generato dalla chiamata, non soltanto quello relativo alla divisione per zero.
Pertanto il controllo conferma che la richiesta è stata rifiutata, ma da solo non dimostra che il rifiuto sia avvenuto esattamente per la causa prevista.
In un sistema di test più rigoroso potremmo verificare anche l’identificatore o il messaggio diagnostico dell’eccezione.
Per questa lezione introduttiva conserviamo il test già collaudato e analizziamo separatamente il messaggio effettivamente restituito dal framework.
La funzione error() e la differenza rispetto ad assert()
Abbiamo incontrato due strumenti che possono interrompere l’esecuzione: error() e assert().
La funzione error() permette di generare intenzionalmente un errore, specificando un messaggio diagnostico.
Per esempio:
if (b == 0)
  error('The denominator must not be zero.');
endif
La funzione assert(), invece, serve soprattutto a verificare una condizione che ci aspettiamo sia vera.
Per esempio:
assert(b != 0);Entrambe possono interrompere l’esecuzione del programma, ma vengono normalmente utilizzate con finalità differenti.
| Strumento | Utilizzo principale |
|---|---|
if / else | Controllare il flusso del programma |
error() | Segnalare esplicitamente una condizione non valida |
assert() | Verificare una condizione o un risultato atteso |
try / catch | Intercettare e gestire errori durante l’esecuzione |
La gestione degli errori nell’ambiente GX-TXT
Quando eseguiamo uno script all’interno di GX-TXT, dobbiamo distinguere fra gli errori gestiti direttamente dal programma e quelli che ne impediscono il completamento.
Un errore intercettato da catch può essere trattato come un evento previsto dell’esperimento.
Un errore non gestito, invece, può provocare il fallimento dell’esecuzione e viene riportato dal sistema di gestione dei Job.
GX-TXT mette a disposizione strumenti per consultare lo standard output, lo standard error e i log diagnostici associati all’esecuzione.
Questo comportamento è particolarmente utile nello sviluppo di applicazioni scientifiche: permette di separare i normali risultati numerici dalle informazioni necessarie per individuare problemi e anomalie.
Nel nostro esperimento il controllo della divisione per zero è stato superato e lo script ha raggiunto il messaggio finale:
LESSON 02: ALL CHECKS PASSED.L’esecuzione è terminata correttamente, come abbiamo verificato attraverso la Script Library e il sistema dei Job di GX-TXT dev-109.
Un principio importante per la programmazione scientifica
La gestione delle eccezioni non deve essere utilizzata per nascondere gli errori.
Intercettare un’eccezione ha senso soltanto quando sappiamo come interpretarla e quali conseguenze deve avere sul calcolo.
Se un errore può compromettere la validità dei risultati scientifici, il programma dovrebbe interrompersi oppure segnalare chiaramente che il risultato non è disponibile.
Nel nostro esempio la divisione per zero viene deliberatamente utilizzata come prova di robustezza: non vogliamo ottenere un valore numerico, ma verificare il comportamento del programma di fronte a una richiesta non valida.
Abbiamo così completato l’introduzione ai principali costrutti GNU Octave presenti nel nostro script.
Nel prossimo capitolo potremo concentrarci completamente sulle API pubbliche GX-TXT, studiando lo Script Bridge, la dichiarazione delle dipendenze, la scoperta delle operazioni disponibili e il funzionamento delle chiamate al servizio numerico NUMERIC_API_v1.
Le API pubbliche di GX-TXT: utilizzare i servizi numerici del framework
Finora abbiamo studiato le principali istruzioni GNU Octave utilizzate nel nostro esperimento. Abbiamo imparato a definire variabili, eseguire operazioni matematiche, organizzare dati strutturati, verificare i risultati e gestire le condizioni di errore.
Tutti questi strumenti appartengono al linguaggio GNU Octave e possono essere utilizzati anche indipendentemente da GX-TXT.
È arrivato il momento di esaminare ciò che distingue il nostro esperimento da un normale programma Octave: la possibilità di accedere ai servizi scientifici del framework attraverso le sue API pubbliche.
Nel nostro script utilizziamo due interfacce fondamentali:
OCTAVE_SCRIPT_BRIDGE_API_v1, che consente agli script Octave di scoprire e richiamare le API pubbliche registrate nel framework.NUMERIC_API_v1, che mette a disposizione operazioni matematiche e numeriche attraverso il serviziomath.numeric.
Entrambe sono documentate nei sorgenti pubblici di GX-TXT su GitHub.
Gli esempi di questo capitolo fanno riferimento alla versione GX-TXT 0.9.8.10-dev-109, commit 940b94c4cd3cbe4200f23f3eb5a04c9d836bd3f0, utilizzata per il collaudo dell’esperimento.
Che cos’è un’API?
La sigla API deriva dall’inglese Application Programming Interface, cioè interfaccia di programmazione delle applicazioni.
Un’API definisce un insieme di operazioni attraverso le quali un programma può utilizzare le funzionalità messe a disposizione da un altro componente software.
Nel nostro caso, il programma che effettua la richiesta è uno script GNU Octave, mentre il componente che fornisce il servizio è GX-TXT.
Un’API pubblica stabilisce un contratto che comprende, tra le altre cose, il nome dell’operazione, gli argomenti richiesti, la forma dei risultati e le eventuali condizioni di errore.
Questa separazione è importante perché permette di utilizzare i servizi del framework senza conoscere o modificare la loro implementazione interna.
Il nostro script, per esempio, non deve sapere come math.numeric esegua internamente una divisione: deve soltanto conoscere il contratto pubblico dell’operazione richiesta.
Lo Script Bridge: il collegamento tra Octave e GX-TXT
GX-TXT mette a disposizione un componente denominato Octave Script Bridge.
Il suo compito è permettere agli script eseguiti dal framework di individuare le API disponibili e invocarne le operazioni attraverso un’interfaccia uniforme.
Il meccanismo può essere schematizzato in questo modo:
GNU Octave script
       |
       | gxtxt_api_call(...)
       v
Octave Script Bridge
       |
       | Public API dispatch
       v
GX-TXT public API provider
       |
       | Numerical operation
       v
Result returned to Octave
Il Bridge non sostituisce il linguaggio Octave e non esegue automaticamente ogni operazione matematica attraverso GX-TXT.
Le normali istruzioni come:
result = a + b;continuano a essere elaborate direttamente da Octave.
Quando invece scriviamo:
result = gxtxt_api_call(...);richiediamo esplicitamente un’operazione a uno dei servizi pubblici registrati nel framework.
Il Bridge viene inizializzato e terminato automaticamente dal sistema di esecuzione degli script GX-TXT. Non dobbiamo quindi chiamare direttamente funzioni di inizializzazione, arresto o comunicazione interna.
Conoscere il contesto di esecuzione: gxtxt_context()
La prima chiamata a un’API pubblica presente nel nostro script è:
context = gxtxt_context();La funzione gxtxt_context() restituisce una struttura contenente informazioni relative all’esecuzione corrente.
Il contesto può includere identificatori dello script e del Job, informazioni sull’operazione eseguita, argomenti e riferimenti agli eventuali Dataset associati.
Nel nostro esperimento utilizziamo soltanto il nome dello script:
context = gxtxt_context();

if (isfield(context, 'script_name'))
  fprintf('Running script: %s\n', context.script_name);
endif
La funzione isfield() verifica che la struttura possieda il campo script_name.
Se il campo è presente, ne visualizziamo il contenuto mediante fprintf().
Questo piccolo esempio mostra già una caratteristica interessante: una chiamata alle API GX-TXT restituisce dati che possiamo elaborare utilizzando le normali funzioni Octave.
Non esiste quindi una separazione rigida tra il linguaggio e il framework. I risultati restituiti dalle API diventano variabili Octave utilizzabili nel resto del programma.
Il contesto contiene informazioni logiche sull’esecuzione e non deve essere utilizzato per ricostruire o manipolare i percorsi interni di archiviazione della Session.
Dichiarare le dipendenze: gxtxt_api_require()
Uno script che utilizza un servizio GX-TXT deve assicurarsi che tale servizio sia effettivamente disponibile.
Nel nostro programma troviamo:
gxtxt_api_require('NUMERIC_API_v1@1:math.numeric');Questa istruzione è particolarmente importante.
La funzione gxtxt_api_require() verifica che le dipendenze dichiarate siano soddisfatte nell’ambiente corrente.
Esaminiamo la stringa utilizzata:
| Elemento | Significato |
|---|---|
NUMERIC_API_v1 | Identificatore pubblico dell’API richiesta |
@1 | Versione dell’API richiesta |
math.numeric | Identificatore del provider |
La versione dell’API non deve essere confusa con quella del framework.
Per esempio, NUMERIC_API_v1 identifica un contratto di programmazione, mentre 0.9.8.10-dev-109 identifica la versione di GX-TXT nella quale stiamo eseguendo lo script.
Il provider math.numeric possiede inoltre una propria versione di implementazione, che nella dev-109 utilizzata per questa lezione è 1.63.0.
Questi tre livelli di versionamento svolgono funzioni differenti.
Se la dipendenza dichiarata non è soddisfatta, gxtxt_api_require() genera un errore. In questo modo lo script evita di proseguire utilizzando un servizio assente o incompatibile.
Questa verifica dovrebbe essere eseguita prima di effettuare i calcoli che dipendono dall’API.
Nello Script Workspace 1.7.0 della dev-109 non tutte le informazioni relative alle dipendenze sono modificabili direttamente attraverso l’editor. La Script Library permette tuttavia di consultare le API richieste associate allo script registrato.
Nel nostro esperimento la dipendenza è dichiarata esplicitamente anche nel codice, così che il requisito risulti evidente a chi legge il programma.
Esaminare un’API: gxtxt_api_describe()
Una volta verificata la disponibilità del servizio, possiamo ottenere informazioni sulla sua interfaccia pubblica.
Nel nostro script utilizziamo:
numeric_description = gxtxt_api_describe('NUMERIC_API_v1');La funzione gxtxt_api_describe() restituisce un descrittore dell’API richiesta.
Il descrittore può contenere informazioni come identificatore e versione dell’API, provider, riferimento alla documentazione e descrizioni delle operazioni disponibili.
Queste informazioni comprendono anche indicazioni sugli argomenti e sui risultati delle operazioni pubbliche.
Nel nostro esperimento non analizziamo ancora tutti i campi del descrittore, ma ne controlliamo la struttura:
if (!isstruct(numeric_description))
  error('Unexpected NUMERIC_API_v1 descriptor format.');
endif
La funzione isstruct() verifica che il risultato sia una struttura Octave.
Se il controllo fallisce, generiamo un errore esplicito.
Questa tecnica è utile perché ci permette di individuare immediatamente un risultato che non rispetta la forma attesa.
È importante distinguere fra la disponibilità di un’API e l’esplorazione del suo contratto.
gxtxt_api_require() verifica una dipendenza, mentre gxtxt_api_describe() permette di esaminarne le caratteristiche pubbliche.
Il Bridge mette a disposizione anche altre funzioni di scoperta, come gxtxt_api_list() e gxtxt_api_has(), che non utilizziamo direttamente in questo esperimento.
Verificare la disponibilità delle operazioni: gxtxt_api_has_operation()
Un’API può esporre numerose operazioni differenti.
Il fatto che un’API sia registrata non significa necessariamente che ogni sua operazione sia disponibile attraverso lo Script Bridge nell’ambiente corrente.
Per questo motivo GX-TXT mette a disposizione:
gxtxt_api_has_operation(api_id, operation);La funzione riceve due argomenti: l’identificatore dell’API e il nome dell’operazione che vogliamo verificare.
Restituisce un valore logico che indica se l’operazione è disponibile.
Nel nostro script effettuiamo tre controlli:
if (!gxtxt_api_has_operation('NUMERIC_API_v1', 'array_binary'))
  error('NUMERIC_API_v1 array_binary is not available.');
endif

if (!gxtxt_api_has_operation('NUMERIC_API_v1', 'array_unary'))
  error('NUMERIC_API_v1 array_unary is not available.');
endif

if (!gxtxt_api_has_operation('NUMERIC_API_v1', 'array_compare'))
  error('NUMERIC_API_v1 array_compare is not available.');
endif
Questi controlli verificano la presenza delle tre operazioni che utilizzeremo:
| Operazione | Funzione |
|---|---|
array_binary | Esegue un’operazione su due operandi numerici |
array_unary | Esegue un’operazione su un solo operando |
array_compare | Confronta due operandi numerici |
Se tutte sono disponibili, lo script visualizza:
GX-TXT public numerical API: available.In questo modo distinguiamo la fase di verifica delle dipendenze dalla successiva esecuzione dei calcoli.
La funzione fondamentale: gxtxt_api_call()
La funzione gxtxt_api_call() costituisce il principale punto di accesso alle operazioni pubbliche registrate nello Script Bridge.
La sua sintassi generale è:
result = gxtxt_api_call(api_id, operation, args);Gli argomenti sono tre.
api_id identifica l’API pubblica che vogliamo utilizzare.
operation specifica l’operazione esposta da quell’API.
args contiene una cell array con gli argomenti posizionali richiesti dall’operazione.
La funzione restituisce il risultato secondo il contratto definito dal provider.
Consideriamo la nostra prima addizione eseguita attraverso GX-TXT:
operand_a = struct('kind', 'scalar', 'value', a);
operand_b = struct('kind', 'scalar', 'value', b);

api_add = gxtxt_api_call('NUMERIC_API_v1', 'array_binary', ...
                         {'add', operand_a, operand_b});
Possiamo leggere questa istruzione come una richiesta:
Utilizza l’API numerica pubblica, esegui un’operazione binaria di addizione sui due operandi forniti e restituiscimi il risultato.
Gli operandi sono rappresentati mediante le strutture operand_a e operand_b che abbiamo imparato a costruire nel capitolo precedente.
La cell array contiene invece gli argomenti nell’ordine previsto dal contratto dell’operazione.
Osserviamo anche il simbolo ..., che permette di proseguire un’istruzione sulla riga successiva.
Si tratta di una funzionalità nativa di GNU Octave, particolarmente utile per migliorare la leggibilità delle chiamate con molti argomenti.
Il servizio NUMERIC_API_v1 e le operazioni binarie
L’API NUMERIC_API_v1 è fornita dal servizio numerico math.numeric.
Questo servizio espone numerose funzionalità matematiche, statistiche e numeriche attraverso un’interfaccia pubblica.
Per la nostra calcolatrice utilizziamo soltanto alcune operazioni elementari.
La prima è array_binary.
Il contratto dello Script Bridge prevede:
gxtxt_api_call('NUMERIC_API_v1', 'array_binary', ...
               {operation_name, left_operand, right_operand});
È possibile fornire anche una struttura opzionale contenente le opzioni supportate.
Nel nostro script le operazioni binarie sono:
api_add = gxtxt_api_call('NUMERIC_API_v1', 'array_binary', ...
                         {'add', operand_a, operand_b});

api_subtract = gxtxt_api_call('NUMERIC_API_v1', 'array_binary', ...
                              {'subtract', operand_a, operand_b});

api_multiply = gxtxt_api_call('NUMERIC_API_v1', 'array_binary', ...
                              {'multiply', operand_a, operand_b});

api_divide = gxtxt_api_call('NUMERIC_API_v1', 'array_binary', ...
                            {'divide', operand_a, operand_b});

api_power = gxtxt_api_call('NUMERIC_API_v1', 'array_binary', ...
                           {'power', operand_a, operand_b});
I nomi add, subtract, multiply, divide e power identificano operazioni differenti della stessa interfaccia pubblica.
In questo esempio, gli operandi contengono rispettivamente i valori 12 e 5.
I risultati attesi sono quindi 17, 7, 60, 2.4 e 248832.
Come leggere il risultato restituito dall’API
Le operazioni array_binary restituiscono una struttura contenente il campo pubblico values.
Per esempio:
result = api_add.values;La variabile result contiene 17.
Nel nostro script raccogliamo tutti i risultati in un unico vettore:
api_values = [api_add.values, api_subtract.values, ...
              api_multiply.values, api_divide.values, api_power.values];
Costruiamo inoltre un secondo vettore con i risultati calcolati direttamente in Octave:
native_values = [native_add, native_subtract, native_multiply, ...
                 native_divide, native_power];
A questo punto possiamo effettuare un confronto automatico:
assert(isequal(size(api_values), size(native_values)));
assert(all(abs(api_values - native_values) < 1e-12));
La prima istruzione verifica che i due vettori abbiano le stesse dimensioni.
La seconda controlla che tutti i risultati coincidano entro la tolleranza numerica stabilita.
Quando entrambe le verifiche sono superate, lo script visualizza:
GX-TXT array_binary: 5 results match native Octave.Questo confronto rappresenta uno degli obiettivi fondamentali del nostro esperimento: dimostrare che possiamo richiamare un servizio numerico del framework e verificarne il risultato mediante le funzionalità native di Octave.
Operazioni sui vettori: espansione di uno scalare
Il servizio NUMERIC_API_v1 permette anche di eseguire determinate operazioni tra vettori e scalari.
Consideriamo il vettore già utilizzato:
v = [2; 4; 6];Prepariamo due operandi:
operand_v = struct('kind', 'vector', 'value', v);
operand_three = struct('kind', 'scalar', 'value', 3);
Il primo è identificato come vettore, mentre il secondo è uno scalare.
Possiamo eseguire la moltiplicazione attraverso GX-TXT:
api_vector = gxtxt_api_call('NUMERIC_API_v1', 'array_binary', ...
                            {'multiply', operand_v, operand_three});
Il servizio applica lo scalare a ogni elemento del vettore, secondo le regole di espansione documentate dall’API.
Il risultato è equivalente all’operazione Octave:
vector_times_three = v .* 3;Otteniamo quindi il vettore colonna:
6
12
18
Per verificarlo, lo script esegue:
assert(isequal(size(api_vector.values), size(v)));

assert(all(abs(api_vector.values(:) - vector_times_three(:)) < 1e-12));
La prima istruzione controlla che il risultato conservi le dimensioni del vettore originale.
Nella seconda compare una nuova notazione:
api_vector.values(:)L’espressione (:) permette di considerare tutti gli elementi dell’array come un unico vettore colonna, conservando l’ordine lineare di Octave.
Nel nostro caso i dati sono già organizzati in colonne, ma questa notazione rende esplicito il confronto elemento per elemento.
È importante ricordare che il controllo separato delle dimensioni impedisce di considerare equivalenti risultati che contengono gli stessi numeri ma sono organizzati in forme differenti.
Le operazioni unarie: array_unary
Non tutte le operazioni matematiche richiedono due operandi.
Pensiamo alla radice quadrata, al valore assoluto oppure alle funzioni trigonometriche.
Per queste operazioni il servizio numerico mette a disposizione array_unary.
La forma generale della chiamata è:
result = gxtxt_api_call('NUMERIC_API_v1', 'array_unary', ...
                        {operation_name, operand});
Nel nostro script utilizziamo:
operand_144 = struct('kind', 'scalar', 'value', 144);

api_sqrt = gxtxt_api_call('NUMERIC_API_v1', 'array_unary', ...
                          {'sqrt', operand_144});
L’operazione sqrt calcola la radice quadrata di 144.
Il risultato restituito nel campo values è 12.
Per verificarlo utilizziamo la corrispondente funzione nativa Octave:
assert(abs(api_sqrt.values - sqrt(144)) < 1e-12);La famiglia array_unary comprende diverse altre operazioni, tra cui abs, square, sin, cos, exp e log.
Il contratto numerico stabilisce anche le condizioni sui valori ammessi. Per esempio, le operazioni reali non devono produrre implicitamente risultati complessi quando questi non sono previsti.
Le operazioni di confronto: array_compare
Oltre ai calcoli aritmetici, possiamo chiedere al servizio numerico di confrontare due valori.
Per questo utilizziamo array_compare.
La chiamata segue una struttura simile alle operazioni binarie:
result = gxtxt_api_call('NUMERIC_API_v1', 'array_compare', ...
                        {operation_name, left_operand, right_operand});
Nel nostro esperimento troviamo:
api_comparison = gxtxt_api_call('NUMERIC_API_v1', 'array_compare', ...
                                {'greater_than', operand_a, operand_b});
L’operazione greater_than verifica se il primo operando è maggiore del secondo.
Poiché abbiamo definito a = 12 e b = 5, la condizione è vera.
Il risultato viene confrontato con quello dell’operatore nativo >:
assert(api_comparison.values == (a > b));Le altre operazioni di confronto documentate comprendono equal, not_equal, less_than, less_equal e greater_equal.
Per i confronti numerici il risultato è rappresentato secondo il contratto pubblico dell’API; nel nostro esempio il valore vero corrisponde a 1.
Questa distinzione è utile: un risultato di confronto possiede un significato logico, anche quando viene trasportato o rappresentato numericamente.
Che cosa accade quando un’operazione non è valida?
Le API pubbliche non hanno soltanto il compito di eseguire correttamente i calcoli.
Devono anche verificare che le richieste rispettino i vincoli stabiliti dai rispettivi contratti.
Per esempio, le operazioni numeriche reali di NUMERIC_API_v1 richiedono normalmente valori finiti, salvo diverse opzioni esplicitamente documentate.
Quando nel nostro script chiediamo di dividere 12 per zero, il servizio numerico segnala un errore.
La chiamata è:
invalid_result = gxtxt_api_call('NUMERIC_API_v1', 'array_binary', ...
                                {'divide', operand_a, operand_zero});
Come abbiamo visto nel capitolo precedente, questa istruzione viene eseguita all’interno di un blocco try.
Se l’API genera un errore, catch lo intercetta e il programma registra il comportamento.
È importante osservare che lo Script Bridge non deve trasformare un errore del provider in un risultato numerico apparentemente valido.
La documentazione pubblica distingue errori relativi, per esempio, ad API sconosciute, operazioni inesistenti, argomenti non validi, problemi di trasporto e errori restituiti dal provider.
Il nostro programma non utilizza operazioni private per aggirare questi controlli: rispetta il contratto pubblico e gestisce le eccezioni attraverso i normali strumenti Octave.
API pubbliche e funzioni native: quando usare le une e le altre?
A questo punto potrebbe sorgere una domanda: perché utilizzare una chiamata relativamente articolata come:
api_add = gxtxt_api_call('NUMERIC_API_v1', 'array_binary', ...
                         {'add', operand_a, operand_b});
quando Octave permette semplicemente di scrivere:
native_add = a + b;Per una normale addizione tra due scalari non esiste alcuna necessità pratica di ricorrere al framework.
Lo scopo del nostro esperimento è didattico: imparare come funzionano le chiamate alle API pubbliche prima di utilizzarle per operazioni scientifiche più articolate.
Nelle lezioni successive affronteremo servizi che aggiungono funzionalità proprie di GX-TXT, come l’accesso ai Dataset canonici, la gestione delle variabili scientifiche, la pubblicazione dei risultati e la generazione di grafici.
In questi casi l’impiego delle API pubbliche non sarà soltanto un esercizio: sarà il modo corretto per integrare i nostri script nell’ambiente scientifico del framework.
La distinzione fondamentale è quindi questa:
- Le funzioni native GNU Octave rappresentano gli strumenti generali del linguaggio.
- Le API pubbliche GX-TXT permettono di utilizzare servizi e risorse gestiti dal framework attraverso contratti documentati.
I due livelli sono complementari.
Riepilogo delle API utilizzate nella Lezione 02
| Funzione / operazione | Scopo |
|---|---|
gxtxt_context() | Recuperare il contesto di esecuzione |
gxtxt_api_require() | Verificare le dipendenze pubbliche richieste |
gxtxt_api_describe() | Consultare il descrittore pubblico di un’API |
gxtxt_api_has_operation() | Verificare che una specifica operazione sia disponibile |
gxtxt_api_call() | Eseguire operazioni attraverso lo Script Bridge |
array_binary | Operazioni aritmetiche tra due operandi |
array_unary | Operazioni matematiche su un operando |
array_compare | Confronti tra operandi numerici |
Nel corso della lezione abbiamo utilizzato esclusivamente le funzioni esposte dal Bridge e le operazioni pubbliche del servizio numerico.
Non abbiamo modificato il CORE, acceduto ai registri interni, letto file privati o scritto direttamente nelle directory del framework.
Questo principio sarà mantenuto per tutti gli esperimenti successivi del corso.
Riferimenti alla documentazione ufficiale
Per studiare direttamente i contratti delle API utilizzate possiamo consultare i seguenti documenti pubblici nel repository GitHub, riferiti al commit utilizzato per il collaudo:
- Octave Script Bridge API v1 — documentazione delle funzioni di scoperta, delle chiamate e dei contratti di comunicazione.
- NUMERIC_API_v1 — documentazione delle operazioni numeriche e dei relativi argomenti.
- Configurazione pubblica di math.numeric — identificatore, versione e capacità dichiarate dal provider.
Questi riferimenti permettono di distinguere le caratteristiche effettivamente documentate della dev-109 da eventuali modifiche introdotte nelle versioni successive.
Abbiamo ora tutti gli elementi necessari per comprendere il funzionamento del nostro script.
Nel prossimo capitolo passeremo all’esecuzione pratica dentro GX-TXT, mostrando come registrare lo script, esaminarne le dipendenze attraverso la Script Library, consultare l’API Browser e verificare i risultati del Job.
Utilizzeremo le schermate acquisite durante il collaudo reale della Lezione 02, distinguendo il funzionamento delle API dalle caratteristiche specifiche dell’interfaccia Octave Script Workspace 1.7.0.
Eseguire lo script in GX-TXT: Script Workspace, Script Library e risultati
Dopo aver analizzato le istruzioni GNU Octave e le API pubbliche utilizzate dalla nostra calcolatrice scientifica, possiamo finalmente eseguire l’esperimento all’interno di GX-TXT.
In questa parte della lezione vedremo come inserire lo script nell’ambiente di lavoro, registrarlo nella libreria del framework, verificarne le dipendenze e avviarne l’esecuzione.
Esamineremo inoltre gli strumenti messi a disposizione da GX-TXT per consultare i risultati numerici, i messaggi diagnostici e le informazioni relative al processo eseguito.
Le schermate presentate sono state acquisite durante il collaudo reale della Lezione 02 con GX-TXT 0.9.8.10-dev-109, utilizzando l’Octave Script Workspace versione 1.7.0.
È importante ricordare che GX-TXT è un progetto in evoluzione: nelle versioni successive l’organizzazione delle finestre e alcune funzionalità dell’interfaccia potrebbero cambiare. I concetti relativi alle API pubbliche, invece, fanno riferimento ai contratti documentati nel repository GitHub.
Preparare lo script nell’Octave Script Workspace
Il primo passo consiste nell’aprire l’Octave Script Workspace, l’ambiente dedicato alla creazione e alla modifica degli script GNU Octave.
Il Workspace mette a disposizione un editor di codice con evidenziazione della sintassi, numerazione delle righe e strumenti per lavorare con gli script.
Per la nostra esercitazione utilizziamo il file:
GXTXT_Octave_L02.m
Lo script è commentato interamente in inglese e contiene, nell’intestazione, le informazioni principali relative all’esperimento:
% SPDX-License-Identifier: GPL-3.0-or-later
%
% GX-TXT GNU Octave Course - Lesson 02
% Variables, data types, and arithmetic operators
%
% Target framework: GX-TXT 0.9.8.10-dev-109
% Source commit: 940b94c4cd3cbe4200f23f3eb5a04c9d836bd3f0
% Source repository: https://github.com/giuxlab-hub/GX-TXT
Queste informazioni permettono di conoscere la licenza dello script e identificare la versione del framework utilizzata come riferimento.
Una volta caricato il codice, assegniamo allo script un nome e un identificatore.
| Proprietà | Valore utilizzato |
|---|---|
| Name | GNU Octave Lesson 02 — Variables and Operators |
| Script ID | gxtxt_octave_l02 |
| Language | Octave |
| Description | Learn GNU Octave variables, data types, and arithmetic operators through a scientific calculator using GX-TXT public numerical APIs. |
Il campo Name contiene il nome leggibile dello script, mentre lo Script ID costituisce un identificatore stabile utilizzato dal sistema di registrazione.
La versione 1.7.0 dell’editor permette di lavorare sul codice, ma non espone direttamente tutti i metadati che possono essere associati allo script registrato.
Questa distinzione diventerà più chiara esaminando la Script Library.
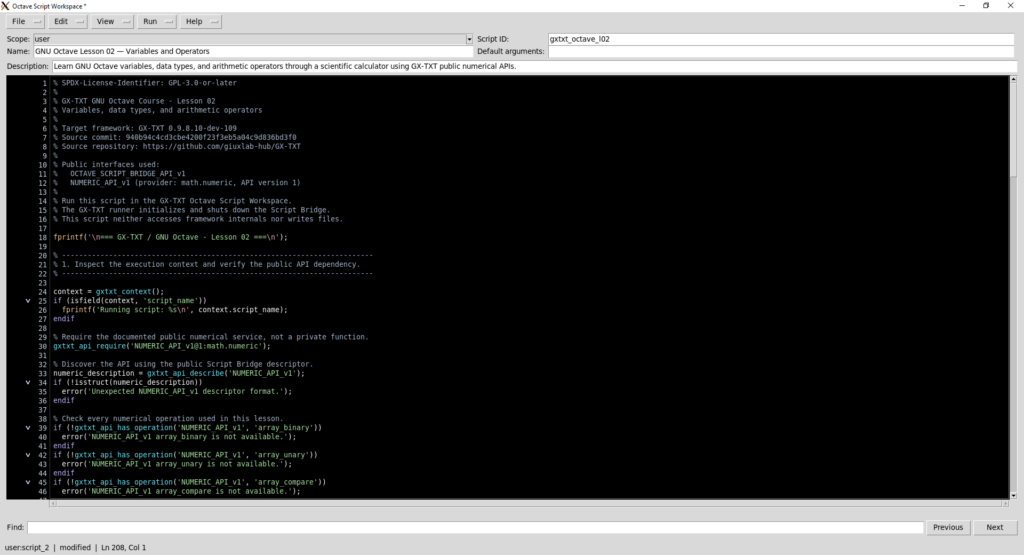
L’API Browser: esplorare le interfacce disponibili
Una funzionalità interessante introdotta nell’interfaccia che stiamo utilizzando è una prima implementazione dell’API Browser.
Questo strumento permette di cercare le API pubbliche disponibili e consultare alcune informazioni relative ai servizi del framework.
Durante il nostro esperimento abbiamo cercato:
NUMERIC_API_v1
Il Browser ha individuato l’API numerica, mostrando informazioni relative al provider math.numeric.
Il pannello permette anche di aprire la documentazione dell’API selezionata attraverso il pulsante API manual.
Nella versione 1.7.0, questo pulsante apre il manuale nella sezione Help del framework, non nel viewer dedicato alla consultazione dei manuali.
Un’altra caratteristica importante riguarda la distinzione tra scoperta e utilizzo delle API.
La ricerca di un’API nel Browser non la attiva automaticamente nello Script Bridge.
Il Browser rappresenta quindi uno strumento di consultazione, mentre il codice dello script deve continuare a dichiarare e verificare esplicitamente le proprie dipendenze.
Nel nostro caso utilizziamo:
gxtxt_api_require('NUMERIC_API_v1@1:math.numeric');Questa istruzione rimane il riferimento programmatico per verificare la dipendenza durante l’esecuzione, indipendentemente dalle funzionalità disponibili nell’interfaccia grafica.
Registrare e consultare lo script nella Script Library
Una volta preparato il codice, possiamo utilizzare la GX-TXT Script Library per gestire lo script come risorsa registrata nel framework.
La libreria non si limita a conservare il testo del programma: permette anche di consultare informazioni utili per identificarlo e controllarne le revisioni.
Nel nostro esperimento, lo script registrato nella Session presenta le seguenti proprietà:
| Proprietà | Valore |
|---|---|
| Script ID | gxtxt_octave_l02 |
| Scope | session |
| Language | Octave |
| Version | 1.0.0 |
| Revision | 1 |
| Required APIs | NUMERIC_API_v1@1:math.numeric |
| SHA-256 | Impronta del sorgente registrato |
Il campo Scope permette di distinguere l’ambito nel quale lo script è registrato. Uno script personale può essere gestito come risorsa dell’utente, mentre uno script associato alla Session appartiene al contesto del lavoro sperimentale corrente.
Nelle nostre schermate vediamo inizialmente lo script nell’editor con scope user e successivamente la sua registrazione nella Session lezione 02.
La libreria permette inoltre di consultare il codice sorgente registrato, identificato da una revisione e da un’impronta SHA-256.
Lo SHA-256 è particolarmente utile perché permette di identificare il contenuto esatto di un file.
Se il codice viene modificato, l’impronta calcolata sul nuovo contenuto cambia, salvo collisioni crittografiche estremamente improbabili.
Questo aiuta a distinguere due revisioni che potrebbero avere lo stesso nome, ma contenere istruzioni differenti.
La versione dello script, invece, è un identificatore assegnato alla risorsa software: non deve essere confusa con la versione del framework GX-TXT.
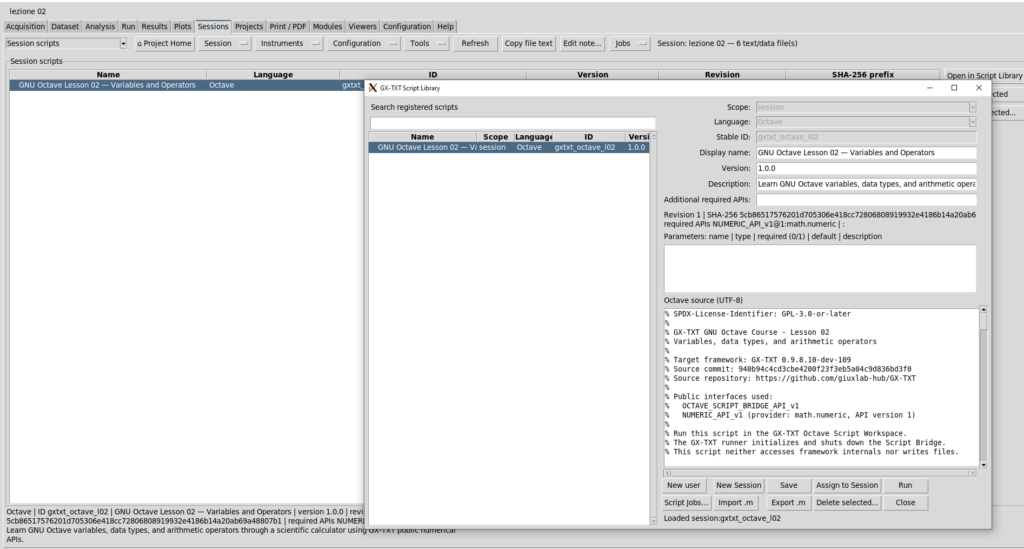
Verificare le API richieste
Nella schermata della Script Library possiamo osservare che GX-TXT ha riconosciuto la dipendenza:
NUMERIC_API_v1@1:math.numeric
Questa informazione è particolarmente importante perché permette di verificare che lo script registrato dichiari il servizio numerico previsto.
Nella versione utilizzata, il campo Additional required APIs può risultare vuoto anche quando sono già presenti dipendenze associate allo script.
Dobbiamo quindi distinguere le eventuali dipendenze aggiuntive da quelle già registrate.
La dichiarazione presente nel codice resta comunque esplicita e leggibile.
Per eseguire una verifica completa, il nostro script utilizza anche:
gxtxt_api_has_operation('NUMERIC_API_v1', 'array_binary');In questo modo possiamo controllare non soltanto la disponibilità dell’API, ma anche quella delle singole operazioni necessarie all’esperimento.
Avviare lo script dalla Script Library
Dopo aver verificato la registrazione, possiamo avviare direttamente lo script dalla libreria.
Selezioniamo la voce corrispondente alla Lezione 02 e utilizziamo il pulsante Run.
GX-TXT apre una finestra di avvio che riporta l’identità dello script e alcune informazioni sulla versione registrata.
La finestra offre inoltre l’accesso alla configurazione degli eventuali Dataset bindings.
Nel nostro caso non abbiamo bisogno di collegare alcun Dataset della Session, perché tutti i dati numerici vengono definiti direttamente nello script.
Possiamo quindi lasciare vuoti i collegamenti opzionali ai Dataset e avviare l’esecuzione.
È importante osservare che non stiamo eseguendo manualmente Octave da un terminale esterno.
Stiamo chiedendo al sistema di esecuzione di GX-TXT di avviare uno script registrato e di gestirne il ciclo di vita.
Il framework si occupa di predisporre l’ambiente di esecuzione, inizializzare lo Script Bridge, avviare il programma e raccoglierne gli output.
Il sistema Script Jobs
Ogni esecuzione viene gestita da GX-TXT come un Job.
Questo consente di distinguere il codice sorgente registrato dalle sue singole esecuzioni.
Lo stesso script può infatti essere eseguito più volte, eventualmente in Session differenti, producendo Job separati.
La finestra GX-TXT Script Jobs permette di consultare diverse informazioni, tra cui:
- Nome e identificatore dello script.
- Linguaggio, versione e revisione.
- Stato dell’esecuzione.
- Data e ora di avvio e completamento.
- Durata del processo.
- Session associata.
- Identificatore del Job.
Nel nostro collaudo il Job della Lezione 02 ha raggiunto lo stato:
COMPLETED
Il tempo di esecuzione registrato è stato di 4,4 secondi.
Questo tempo rappresenta la durata dell’esecuzione gestita dal framework e non deve essere interpretato come una misura isolata delle prestazioni delle singole operazioni aritmetiche.
Il Job comprende infatti anche le attività di preparazione e gestione necessarie per eseguire lo script nell’ambiente GX-TXT.
Consultare i risultati e i messaggi diagnostici
Una volta completato il Job, possiamo aprirne la finestra dei dettagli.
Nella versione dev-109 questa interfaccia offre una consultazione più articolata dei risultati rispetto alle precedenti implementazioni.
È possibile selezionare diverse sorgenti di informazioni:
| Sorgente | Contenuto |
|---|---|
| Program output | Messaggi prodotti sullo standard output |
| Program stderr | Messaggi prodotti sullo standard error |
| Diagnostic log | Informazioni diagnostiche dell’esecuzione |
| Legacy combined stream | Flusso combinato compatibile con la precedente modalità di consultazione |
Questa separazione è utile perché permette di distinguere i risultati stampati dal programma dai messaggi diagnostici.
Nel nostro esperimento, i messaggi generati mediante fprintf() vengono raccolti nel Program output.
La finestra dispone inoltre di funzioni per copiare gli identificatori del Job e dello script, consultare i dettagli dell’esecuzione e recuperare il sorgente conservato.
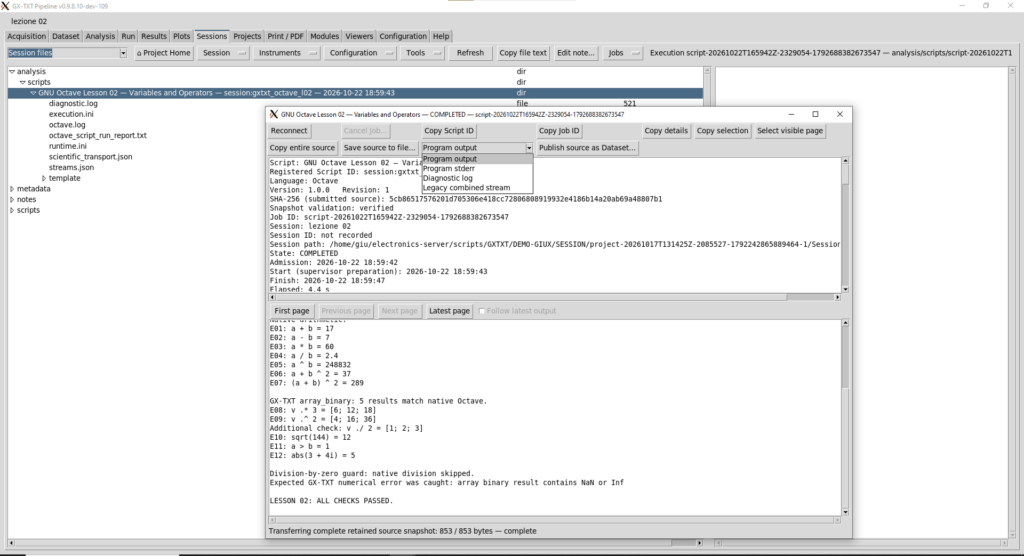
I risultati ottenuti
Il programma ha eseguito le prove previste, iniziando dall’identificazione delle variabili e proseguendo con le operazioni aritmetiche native Octave.
Per esempio:
E01: a + b = 17
E02: a - b = 7
E03: a * b = 60
E04: a / b = 2.4
E05: a ^ b = 248832
E06: a + b ^ 2 = 37
E07: (a + b) ^ 2 = 289
Successivamente ha verificato la corrispondenza con i calcoli eseguiti mediante il servizio numerico pubblico:
GX-TXT array_binary: 5 results match native Octave.Sono state superate anche le verifiche sulle operazioni vettoriali, sulla radice quadrata, sul confronto logico e sul modulo del numero complesso.
Infine, lo script ha eseguito il test della divisione per zero.
Il servizio numerico ha restituito il messaggio:
Expected GX-TXT numerical error was caught: array binary result contains NaN or InfIl messaggio conferma che il programma ha intercettato un errore durante il tentativo di eseguire un’operazione che avrebbe prodotto un risultato non finito.
L’ultima riga dell’output è:
LESSON 02: ALL CHECKS PASSED.Il Job è terminato con stato COMPLETED, confermando il buon esito del collaudo previsto per questa esercitazione.
La conservazione delle informazioni nella Session
Un altro aspetto importante di GX-TXT è la possibilità di consultare dalla Session le informazioni relative a un’esecuzione già terminata.
Nella sezione dei file della Session troviamo i risultati del Job organizzati sotto l’area:
analysis/scripts/
Per il nostro esperimento sono visibili diversi file prodotti e gestiti dal framework, tra cui:
| File | Funzione |
|---|---|
octave.log | Output dell’esecuzione Octave |
diagnostic.log | Informazioni diagnostiche |
octave_script_run_report.txt | Report dell’esecuzione |
execution.ini | Metadati di esecuzione |
runtime.ini | Informazioni relative al runtime |
scientific_transport.json | Informazioni di trasporto scientifico |
streams.json | Informazioni sui flussi di output |
Questi file vengono gestiti dal framework.
Lo script della nostra lezione non li crea direttamente, non ne sceglie i percorsi e non li modifica.
Questa separazione è importante per mantenere una distinzione chiara tra il codice scientifico scritto dall’utente e le responsabilità dell’ambiente di esecuzione.
In particolare, non è necessario accedere direttamente alle directory interne della Session per esaminare i risultati: GX-TXT mette a disposizione gli strumenti di consultazione attraverso la propria interfaccia.
Script, revisione e Job: tre concetti differenti
Prima di concludere, è utile distinguere tre elementi che abbiamo incontrato.
Lo script registrato è la risorsa software identificata dal suo Script ID.
La revisione identifica una specifica versione del codice conservato nella libreria.
Il Job rappresenta una singola esecuzione di quello script.
Questa distinzione permette di sapere quale codice è stato eseguito e di associare a una determinata esecuzione i relativi risultati e messaggi diagnostici.
È un principio essenziale per la riproducibilità: non basta conoscere il nome del programma, ma dobbiamo poter identificare anche il codice effettivamente utilizzato e il contesto nel quale è stato eseguito.
Nel nostro caso abbiamo conservato le informazioni fondamentali:
- GX-TXT
0.9.8.10-dev-109. - Script
gxtxt_octave_l02. - Versione
1.0.0, revisione1. - API pubblica
NUMERIC_API_v1. - Session
lezione 02. - Job completato correttamente.
- Risultati numerici verificati.
Conclusione dell’esperimento pratico
Abbiamo seguito l’intero percorso, dalla preparazione del codice fino alla consultazione dei risultati nella Session.
L’esperimento dimostra che uno script GNU Octave può utilizzare contemporaneamente le funzionalità native del linguaggio e i servizi numerici pubblici di GX-TXT.
Abbiamo inoltre visto come il framework gestisca la registrazione del codice, le dipendenze dalle API, le revisioni e i risultati delle esecuzioni.
Il collaudo della Lezione 02 è stato completato senza modificare il CORE e senza accedere direttamente ai file privati del framework.
Questa modalità di lavoro costituirà il riferimento operativo per le successive esercitazioni del corso, nelle quali inizieremo a utilizzare anche Dataset e strumenti scientifici più avanzati.
Esercizi proposti e verifica delle competenze
Abbiamo completato il nostro primo esperimento dedicato alle variabili, ai tipi di dati e agli operatori aritmetici in GNU Octave.
Durante la lezione abbiamo anche imparato a utilizzare alcune funzioni fondamentali del linguaggio e abbiamo introdotto il sistema di accesso alle API pubbliche di GX-TXT.
Prima di passare alla lezione successiva, proponiamo alcuni esercizi che permettono di mettere in pratica le conoscenze acquisite.
Gli esercizi sono organizzati in ordine di difficoltà crescente. I primi utilizzano esclusivamente le funzioni native di GNU Octave, mentre gli ultimi richiedono l’integrazione con le API pubbliche del framework.
Suggerimento: per svolgere gli esercizi è preferibile creare nuovi script di prova, senza modificare il file originale GXTXT_Octave_L02.m, che abbiamo già collaudato.
Esercizio 1 — Operazioni aritmetiche e precedenza
Definiamo due variabili:
a = 18;
b = 4;
Utilizzando gli operatori aritmetici, calcolare le seguenti espressioni:
result_1 = a + b;
result_2 = a * b;
result_3 = a / b;
result_4 = a + b ^ 2;
result_5 = (a + b) ^ 2;
Visualizzare ciascun risultato utilizzando fprintf().
Successivamente aggiungere cinque controlli assert() per verificare che i risultati corrispondano ai valori attesi.
| Variabile | Risultato atteso |
|---|---|
result_1 | 22 |
result_2 | 72 |
result_3 | 4.5 |
result_4 | 34 |
result_5 | 484 |
Domanda: perché le espressioni a + b ^ 2 e (a + b) ^ 2 producono risultati differenti?
Esercizio 2 — Tipi di dati e conversioni
Creare quattro variabili:
temperature = 23.5;
sample_count = int16(125);
measurement_valid = logical(1);
sample_name = 'Sample A';
Utilizzare la funzione class() per identificare il tipo di ciascuna variabile.
Visualizzare i risultati utilizzando fprintf().
Successivamente eseguire:
converted_count = double(sample_count);Verificare la classe di converted_count e confrontarla con quella di sample_count.
Domande:
- Qual è la differenza tra il valore numerico di una variabile e la sua classe?
- Perché potrebbe essere utile convertire un intero in
doubleprima di un’elaborazione numerica? - La conversione mostrata modifica la variabile originale?
Esercizio 3 — Operazioni vettoriali
Definire il seguente vettore colonna:
v = [3; 6; 9; 12];Calcolare:
double_v = v .* 2;
half_v = v ./ 2;
squared_v = v .^ 2;
Utilizzare size() e numel() per verificare le dimensioni e il numero di elementi del vettore.
Successivamente controllare i risultati mediante assert() e isequal().
| Operazione | Risultato atteso |
|---|---|
v .* 2 | [6; 12; 18; 24] |
v ./ 2 | [1.5; 3; 4.5; 6] |
v .^ 2 | [9; 36; 81; 144] |
Domanda: che cosa accadrebbe se utilizzassimo v ^ 2 anziché v .^ 2?
Spiegare il motivo facendo riferimento alle dimensioni dell’array e al significato matematico dell’operatore.
Esercizio 4 — Numeri complessi e verifiche numeriche
Consideriamo un numero complesso:
z = complex(5, 12);Calcolarne il modulo mediante abs().
Verificare che il risultato sia uguale a 13 entro una tolleranza di 1e-12.
Successivamente utilizzare real() e imag() per estrarre rispettivamente la parte reale e quella immaginaria.
Queste ultime due funzioni appartengono a GNU Octave e permettono di accedere separatamente alle componenti di un numero complesso.
Domanda: perché il modulo di un numero complesso non coincide necessariamente con il valore assoluto della sua sola parte reale?
Esercizio 5 — Gestione di una condizione di errore
Creare due variabili:
numerator = 24;
denominator = 0;
Scrivere un programma che controlli il valore del denominatore prima di eseguire la divisione.
Se il denominatore è zero, visualizzare:
Division skipped: denominator is zero.Altrimenti eseguire il calcolo e visualizzare il risultato.
Successivamente realizzare una seconda versione dell’esercizio utilizzando try, catch ed error().
Domande:
- Qual è la differenza tra un controllo preventivo e la gestione di un’eccezione?
- In quale situazione è preferibile impedire l’operazione prima che venga eseguita?
- Perché non è corretto ignorare sistematicamente tutti gli errori intercettati?
Esercizio 6 — Utilizzare NUMERIC_API_v1
Questo esercizio richiede l’esecuzione all’interno di GX-TXT, poiché utilizza lo Script Bridge e il servizio numerico pubblico del framework.
Definiamo:
a = 18;
b = 4;
Per prima cosa, verifichiamo la disponibilità dell’API:
gxtxt_api_require('NUMERIC_API_v1@1:math.numeric');Successivamente prepariamo i due operandi:
operand_a = struct('kind', 'scalar', 'value', a);
operand_b = struct('kind', 'scalar', 'value', b);
L’obiettivo è eseguire un’addizione attraverso il servizio numerico pubblico di GX-TXT.
api_result = gxtxt_api_call('NUMERIC_API_v1', 'array_binary', ...
                            {'add', operand_a, operand_b});
Recuperiamo il risultato:
result = api_result.values;Il valore atteso è 22.
Aggiungere un controllo assert() che confronti questo risultato con quello ottenuto mediante l’operatore nativo +.
Ripetere successivamente la prova con le operazioni subtract, multiply e divide.
Domande:
- Qual è il compito di
gxtxt_api_require()? - Perché gli operandi vengono rappresentati mediante
struct()? - Perché gli argomenti della chiamata sono contenuti in una cell array?
- Qual è la differenza tra
array_binaryegxtxt_api_call()? - Perché dobbiamo recuperare il risultato attraverso il campo
values?
Esercizio facoltativo — Una calcolatrice con selezione dell’operazione
Come esercizio aggiuntivo proponiamo di realizzare una calcolatrice che permetta di selezionare l’operazione da eseguire mediante una variabile testuale.
Per esempio:
a = 15;
b = 3;

operation = 'multiply';
Utilizzando una struttura condizionale if / elseif / else, il programma dovrà scegliere l’operazione corrispondente.
Le operazioni previste sono:
addsubtractmultiplydivide
Lo script dovrà controllare il denominatore quando viene richiesta una divisione e segnalare eventuali operazioni sconosciute mediante error().
Una volta completata la versione nativa Octave, è possibile realizzare una seconda versione che richiami NUMERIC_API_v1.
Questo esercizio costituisce una prima introduzione alla costruzione di programmi nei quali il comportamento dipende da una scelta o da un parametro.
Riepilogo della Lezione 02
Con questa esercitazione abbiamo approfondito alcuni elementi fondamentali della programmazione scientifica in GNU Octave.
Abbiamo imparato a creare variabili, riconoscerne i tipi e utilizzare correttamente gli operatori aritmetici.
Abbiamo introdotto vettori e operazioni elemento per elemento, distinguendoli dalle operazioni matriciali.
Abbiamo studiato le funzioni di stampa formattata printf() e fprintf() e abbiamo imparato a utilizzare assert() per verificare automaticamente i risultati.
Attraverso abs() abbiamo analizzato sia il valore assoluto di un numero reale sia il modulo di un numero complesso.
Abbiamo inoltre visto come organizzare dati e argomenti mediante strutture e cell array, e come gestire condizioni anomale attraverso if, try e catch.
Infine, abbiamo compiuto un passo importante nell’apprendimento di GX-TXT: utilizzare le API pubbliche del framework direttamente da uno script GNU Octave.
Il confronto tra le operazioni native e quelle eseguite attraverso NUMERIC_API_v1 ha permesso di verificare il funzionamento dello Script Bridge e del servizio numerico.
L’esperimento originale è stato eseguito in GX-TXT dev-109, terminando con il messaggio:
LESSON 02: ALL CHECKS PASSED.Questo risultato si riferisce alle verifiche previste dallo script della lezione. Gli esercizi aggiuntivi proposti in questo capitolo sono invece destinati al lettore e non fanno parte del collaudo originale.
Verso la Lezione 03 — Vettori e matrici
Nella prossima lezione approfondiremo una delle caratteristiche più importanti di GNU Octave: il calcolo vettoriale e matriciale.
Impareremo a costruire e manipolare array di dimensioni differenti, selezionarne gli elementi mediante indicizzazione e utilizzare le principali operazioni di algebra lineare.
Questi strumenti ci permetteranno di passare dalle semplici operazioni sui singoli valori a elaborazioni scientifiche più articolate, preparando il terreno per il lavoro sui Dataset di GX-TXT.
Il nostro percorso proseguirà mantenendo lo stesso metodo: spiegazione del linguaggio, esperimento riproducibile, utilizzo delle API pubbliche e verifica dei risultati.