
GX Spectra Library: spettri di riferimento IR, UV/Vis e NMR su Debian, guida completa
GX Spectra Library è un piccolo programma desktop per Debian, scritto in Python con Tkinter e Matplotlib, che cerca spettri di riferimento IR, UV/Vis e NMR (1H e 13C) nel NIST Chemistry WebBook e in nmrshiftdb2, li mostra in anteprima, ne conserva i file JCAMP-DX originali in una biblioteca locale consultabile offline e li esporta in CSV e in archivi ZIP con la provenienza. Il codice è libero (GNU GPL v3 o successiva) e il pacchetto Debian è nella pagina Releases del repository GitHub; la scheda del programma è nella pagina software. Questo articolo riproduce per intero la guida illustrata originale, scritta in inglese, con un esempio completo sul benzene e dodici schermate reali; i riquadri di approfondimento e di consiglio pratico, che si aprono con un clic, spiegano come lavora il programma dietro le quinte (le richieste a NIST, PubChem e nmrshiftdb2, il formato JCAMP-DX, il catalogo SQLite con le impronte SHA-256), interpretano gli spettri del benzene con i riferimenti bibliografici e presentano quattro piccoli script provati per controllare il catalogo, verificare gli archivi ZIP, calcolare l’assorbanza IR e confrontare i dati prima e dopo il passaggio dal CSV. La guida in inglese è nella versione inglese di questo articolo.
GX Spectra Library · Debian 13 · Guida di laboratorio illustrata
Trovare ed esaminare dati di riferimento infrarossi, ultravioletto/visibile e NMR, conservare i file JCAMP-DX originali, gestire un catalogo consultabile offline e scambiare spettri in CSV e ZIP.
- Caso di studio: benzene · CAS 71-43-2
- 32 risultati online in questa sessione
- 12 schermate reali del desktop
- Versione 0.1.1 · pacchetto Debian 0.1.1-2
Che cosa si impara
Una molecola, quattro spettri complementari
L’esempio usa il benzene (C₆H₆, CAS 71-43-2). Dal NIST Chemistry WebBook si recuperano uno spettro IR di riferimento in fase gassosa e uno spettro UV/Vis; da nmrshiftdb2 le liste dei picchi NMR di 1H e 13C.
Tutte le immagini del programma sono schermate reali dell’applicazione in esecuzione sul desktop XFCE di Debian 13, con l’interfaccia in inglese. Il percorso è stato eseguito sui servizi pubblici il 1º novembre 2026: contenuto e disponibilità delle banche dati possono cambiare.
- Punto di partenza: catalogo dimostrativo vuoto; ricerca online in inglese
- Risultato: quattro file JCAMP-DX scaricati, un’esportazione CSV, uno ZIP con metadati e una reimportazione del CSV verificata
Come seguire la guida. Tenere questa pagina aperta accanto a GX Spectra Library. Un clic su una schermata apre il PNG originale a piena risoluzione. I file prodotti dal percorso sono descritti nella sezione File generati.
Passo 01 · Preparare la postazione
Installare e avviare con l’interfaccia in inglese
Il pacchetto Debian dichiara come dipendenze APT Tkinter, Matplotlib, NumPy, Requests, Beautiful Soup, i certificati e le utilità del desktop. Il lettore JCAMP è incluso, quindi non serve alcun comando pip. Scaricare gx-spectra-library_0.1.1-2_all.deb dalla pagina Releases del repository GitHub e installarlo dalla cartella in cui si trova:
sudo apt install ./gx-spectra-library_0.1.1-2_all.deb
LANGUAGE=en gx-spectra-library
L’applicazione segue normalmente le impostazioni Debian LANGUAGE, LC_MESSAGES e LANG. Il comando sopra sceglie l’inglese solo per questa esecuzione. In alternativa si avvia GX Spectra Library dal menu applicazioni di XFCE.
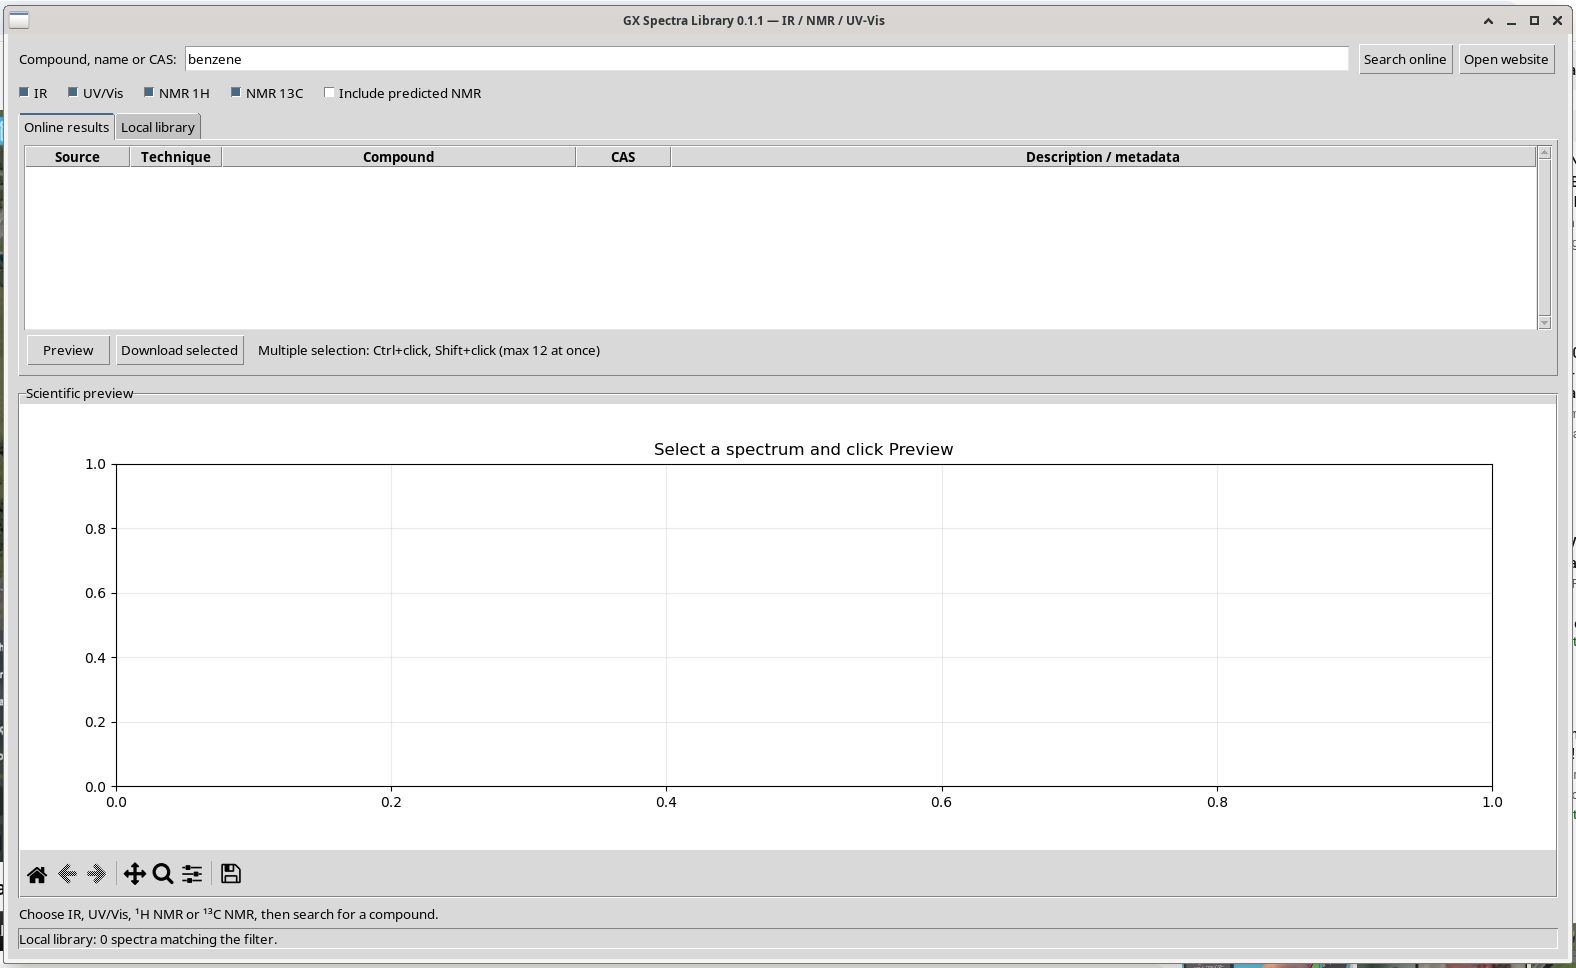
Per questa guida è stato usato un catalogo dimostrativo separato: non ha sovrascritto la biblioteca esistente dell’utente e non ha richiesto un’installazione di sistema del pacchetto per ottenere le schermate.
Consiglio pratico · Scaricare, verificare e installare il pacchetto; un catalogo isolato per le prove
Dalla pagina Releases si scaricano il pacchetto e il file SHA256SUMS; il controllo dell’impronta prima dell’installazione garantisce che il file sia quello pubblicato:
sha256sum -c --ignore-missing SHA256SUMS
# gx-spectra-library_0.1.1-2_all.deb: OK
sudo apt install ./gx-spectra-library_0.1.1-2_all.deb
L’impronta pubblicata della versione 0.1.1-2 è 9c2e43dd5cc357db2bc45ea5f46bc09cf2f6885839c91ee13ffe3284fe7b5887. Il ./ davanti al nome è necessario: senza, APT cerca un pacchetto con quel nome nei repository invece del file locale.
Il pacchetto Debian salva la biblioteca in $XDG_DATA_HOME/gx-spectra-library e, se la variabile non è impostata, in ~/.local/share/gx-spectra-library (lo script packaging/build_deb.py sostituisce in questo senso la cartella dati del sorgente). Per provare il programma senza toccare la propria biblioteca, come è stato fatto per le schermate, basta indicare una cartella temporanea:
XDG_DATA_HOME="$HOME/prova-spettri" LANGUAGE=en gx-spectra-library- al primo avvio, se il catalogo non esiste ancora, il pacchetto copia l’eventuale biblioteca della vecchia versione autonoma da
~/spettrisenza modificarla; - dal sorgente (
git clone, poi./installa_ambiente.she./avvia_spettri.sh) il programma usa un ambiente virtuale con la dipendenzajcampda pip e tiene catalogo e dati nella cartella del sorgente (catalogo.sqlite3edata/), non nella cartella XDG; - il repository contiene 16 test automatici offline (
tests.py,tests_i18n.py):PYTHONPATH=packaging/vendor python3 -m unittest tests tests_i18nli esegue senza rete; nella nostra prova sono passati tutti e 16.
Passo 02 · Ricerca online
Cercare il benzene nelle banche dati pubbliche
- Scrivere
benzenein Compound, name or CAS. Il numero CAS71-43-2è un altro identificativo utile. - Lasciare selezionate IR, UV/Vis, NMR 1H e NMR 13C.
- Per questo esempio lasciare deselezionata Include predicted NMR.
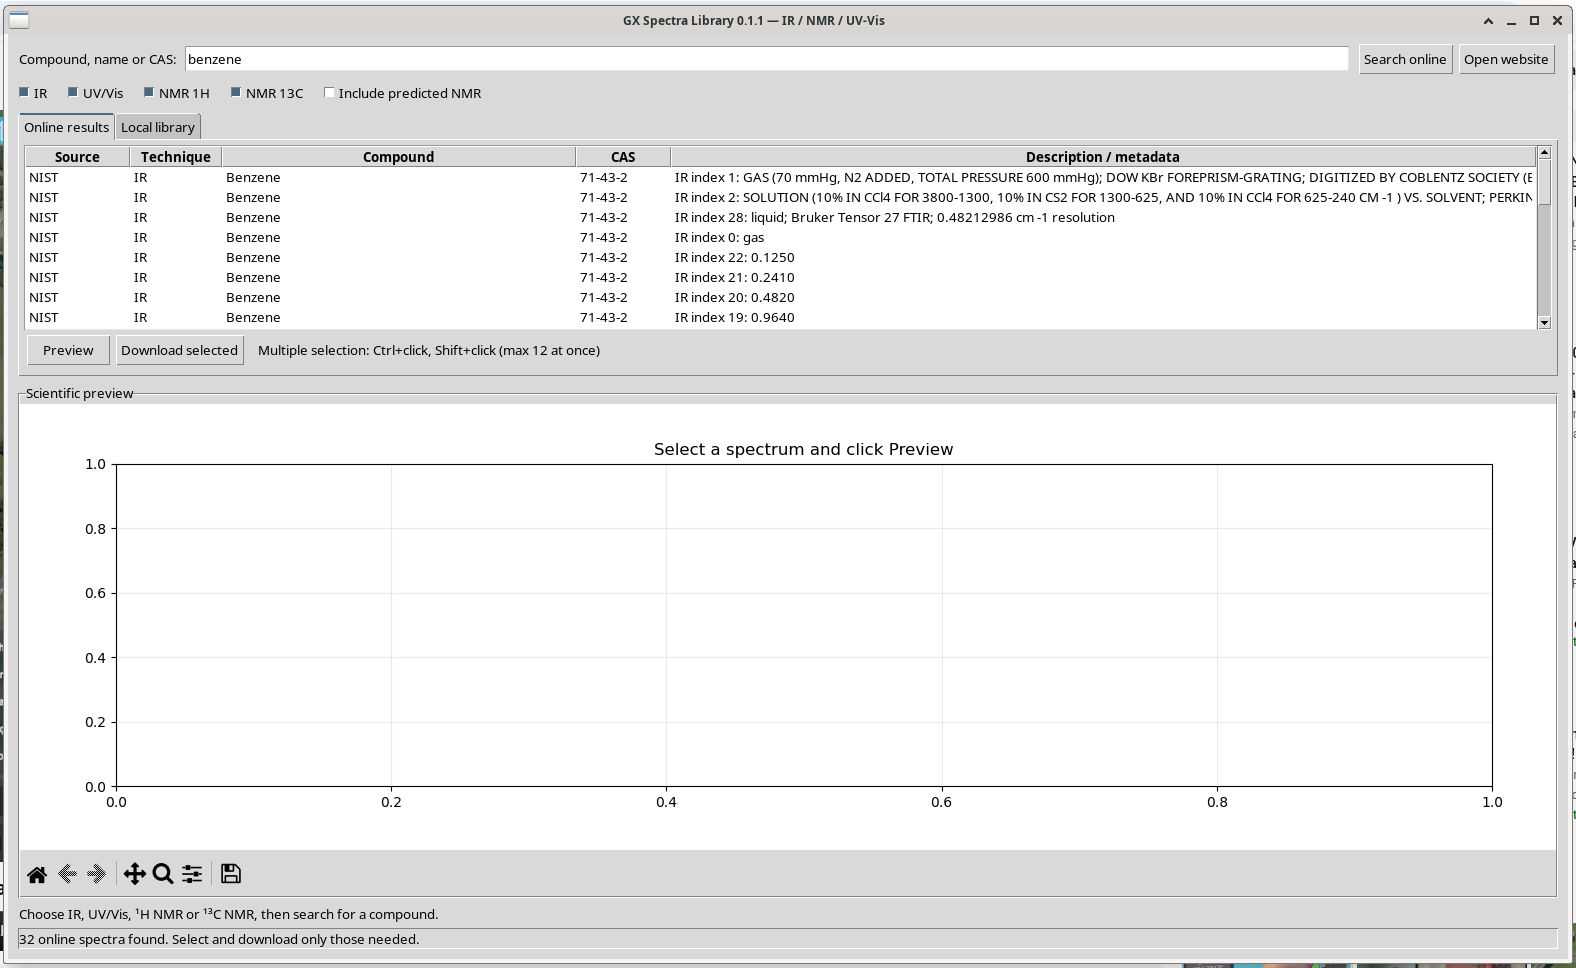
- Fare clic su Search online. I risultati riempiono la tabella senza sostituire la biblioteca corrente.
| Tecnica | Fonte | Risultati in questa esecuzione | Che cosa varia |
|---|---|---|---|
| IR | NIST | 29 | Stato fisico, condizioni di registrazione e risoluzione strumentale |
| UV/Vis | NIST | 1 | Spettro pubblicato e intervallo di lunghezze d’onda |
| NMR 1H | nmrshiftdb2 | 1 | Lista degli spostamenti, solvente e record di origine |
| NMR 13C | nmrshiftdb2 | 1 | Lista degli spostamenti, solvente e record di origine |
I risultati della ricerca non sono misure equivalenti fra loro. Per un confronto sensato si sceglie un singolo record e se ne esaminano condizioni e unità originali prima di scaricarlo.
Approfondimento · Come cerca il programma: NIST, PubChem e nmrshiftdb2 dietro le quinte
Il codice è in backend.py. Ogni ricerca è una singola interrogazione, non una scansione massiva delle banche dati:
| Tecnica | Richiesta | Che cosa ne ricava |
|---|---|---|
| IR, UV/Vis | webbook.nist.gov/cgi/cbook.cgi?Name=benzene&cIR=on&cUV=on (con un numero CAS: ID=C71432) | il numero CAS dalla pagina, poi i collegamenti alle varianti Type=IR-SPEC, trasformati nell’URL JCAMP cbook.cgi?JCAMP=C71432&Index=n&Type=IR, e i collegamenti JCAMP UV/Vis |
| NMR (passo 1) | pubchem.ncbi.nlm.nih.gov/rest/pug/compound/name/benzene/property/ConnectivitySMILES/JSON | lo SMILES di connettività (C1=CC=CC=C1) e il CID 241 |
| NMR (passo 2) | nmrshiftdb.nmr.uni-koeln.de/NmrshiftdbServlet/nmrshiftdbaction/searchorpredict/smiles/<SMILES>/spectrumtype/1H | il primo spettro della risposta XML con picchi, solvente e identificativo; l’URL per lo scaricamento aggiunge /format/jcamp |
- il servizio di nmrshiftdb2 si chiama search or predict: se il composto non ha uno spettro archiviato restituisce una predizione. Il programma la riconosce dall’assenza dell’identificativo dello spettro (o da un programma di calcolo nei metadati) e la nasconde a meno che non sia attiva Include predicted NMR; anche gli spettri archiviati sono etichettati «experimental origin unverified»;
- ogni richiesta dichiara l’agente
GX-SpectraLibrary/0.1, ha tempi limite di 8 s per la connessione e 22 s per la lettura e rifiuta risposte oltre 12 MB per spettro (3 MB per la pagina NIST, 4 MB per la risposta NMR); - per la risoluzione dei nomi la notazione SMILES (Weininger 1988, doi:10.1021/ci00057a005) e PubChem (Kim et al. 2023, doi:10.1093/nar/gkac956) servono solo a identificare la struttura; nmrshiftdb2 è descritto in Steinbeck, Krause e Kuhn (2003, doi:10.1021/ci0341363) e Steinbeck e Kuhn (2004, doi:10.1016/j.phytochem.2004.08.027), il WebBook in Linstrom e Mallard (2001, doi:10.1021/je000236i).
Le 29 voci IR del benzene sono 29 registrazioni diverse (fase, cella, strumento, digitalizzazione), non duplicati: la descrizione di ciascuna riporta le condizioni ed è la prima cosa da leggere prima di scegliere.
Passo 03 · Esame dello spettro
Anteprima dello spettro infrarosso
Selezionare la voce NIST che inizia con “IR index 1: GAS…” e fare clic su Preview. Lo spettro viene letto dalla fonte JCAMP-DX remota e tracciato senza aggiungerlo prima alla biblioteca locale.
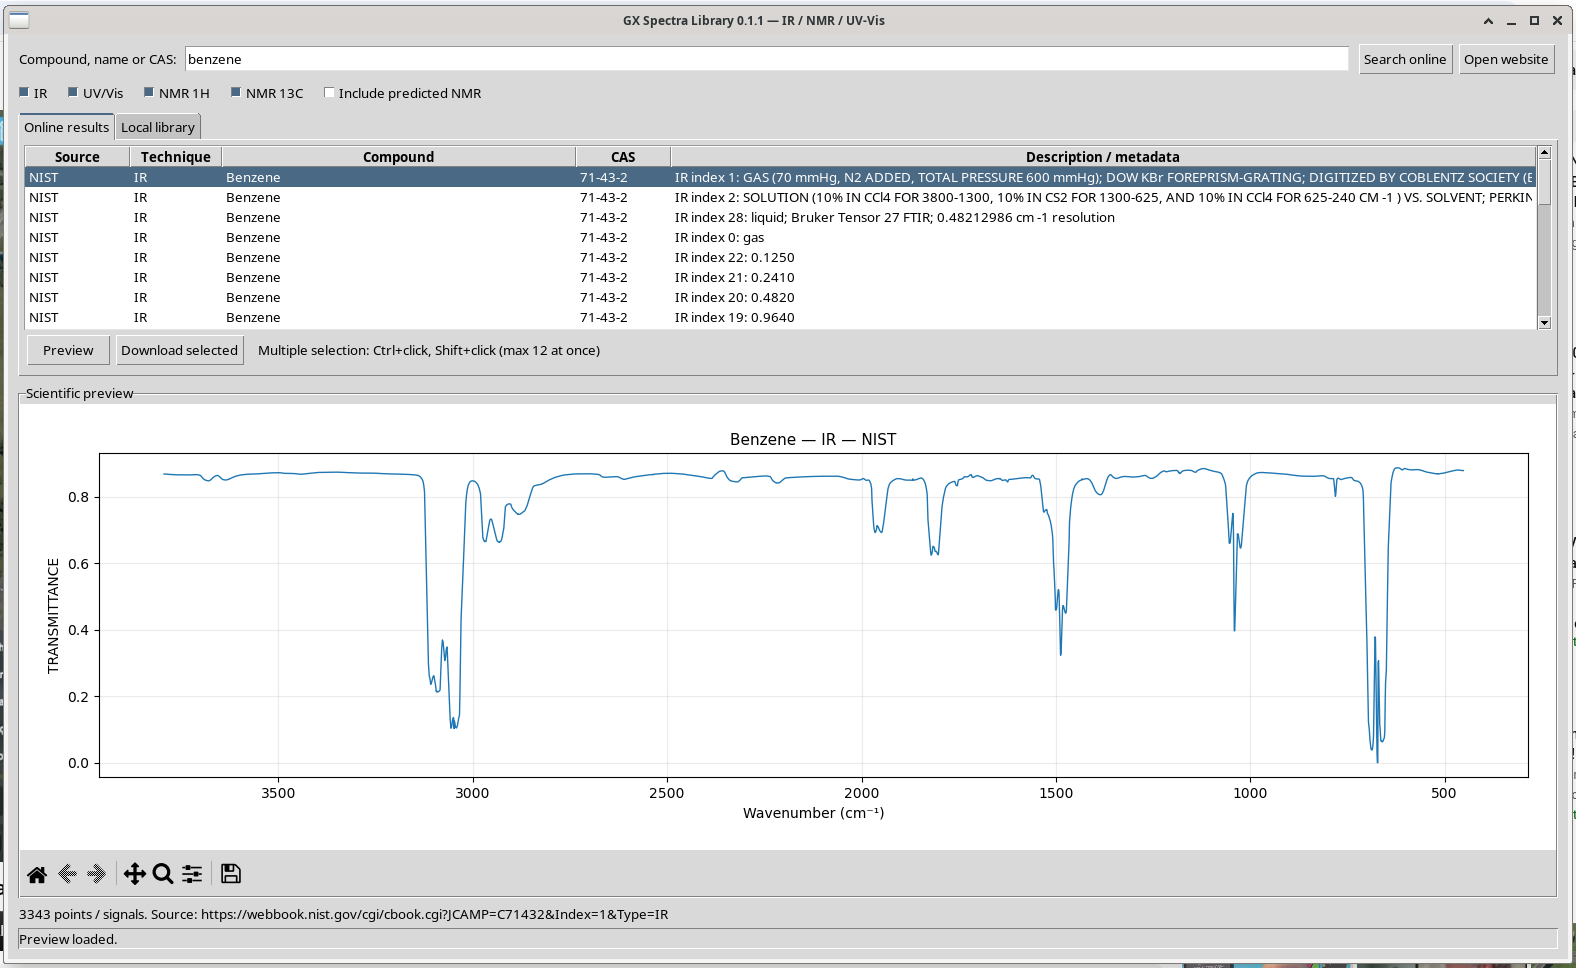
Le bande di assorbimento sono rivolte verso il basso, come in ogni grafico in trasmittanza. L’asse orizzontale va dai numeri d’onda più alti ai più bassi, secondo la convenzione dell’IR. La barra degli strumenti di Matplotlib permette di ingrandire le zone d’interesse, spostarsi, tornare alla vista completa o salvare un’immagine.
Tracciabilità della fonte. Il record selezionato punta alla risorsa JCAMP-DX IR originale del NIST. Per un lavoro quantitativo vanno conservati il file completo e i metadati di catalogo associati.
Approfondimento · Che cosa contiene il JCAMP-DX dell’IR del benzene, e le sue bande
JCAMP-DX è il formato testuale standard per lo scambio di spettri IR (McDonald e Wilks 1988, doi:10.1366/0003702884428734), poi esteso all’NMR (Davies e Lampen 1993, doi:10.1366/0003702934067874). Le intestazioni ##CHIAVE=valore descrivono il dato; i valori sono spesso compressi (forme SQZ, DIF, DUP) e moltiplicati per XFACTOR e YFACTOR: per questo il programma usa un lettore dedicato, il modulo jcamp di Nathan Hagen, licenza MIT. Le intestazioni del file scaricato in questo percorso:
| Intestazione | Valore | Significato |
|---|---|---|
XUNITS, YUNITS | 1/CM, TRANSMITTANCE | numero d’onda in cm⁻¹, trasmittanza fra 0 e 1 |
NPOINTS | 3343 | un punto per cm⁻¹ da 452 a 3794 |
RESOLUTION | 2 | risoluzione strumentale 2 cm⁻¹: il passo di 1 cm⁻¹ non aggiunge dettaglio |
STATE | GAS (70 mmHg, N2 ADDED, TOTAL PRESSURE 600 mmHg) | fase gassosa: le bande hanno la struttura rotazionale P, Q, R |
ORIGIN, OWNER | DOW CHEMICAL COMPANY, Copyright (C) 1987 by the Coblentz Society | provenienza e titolare dei diritti, da citare |
Lo script ir_bands.py (nell’archivio in fondo all’articolo) legge il CSV esportato al passo 08, calcola l’assorbanza A = −log₁₀T e ne elenca i massimi più intensi; su questo spettro:
#!/usr/bin/env python3
# SPDX-License-Identifier: GPL-3.0-or-later
"""Absorbance and strongest bands from an IR transmittance CSV exported by GX Spectra Library.

Reads the two-column CSV (comment lines starting with #, header x,y), converts
transmittance to absorbance A = -log10(T) and lists the N strongest local
maxima of A that are separated by at least --min-sep cm-1. Optionally writes
the absorbance CSV (never overwriting an existing file). The values are those
of the source file: check its YUNITS before applying the conversion.
Bands with T below 0.001 are flagged as saturated: their absorbance is
limited by the 1e-6 floor used here and has no quantitative meaning.

Usage: python3 ir_bands.py benzene_IR_export.csv [--n 8] [--min-sep 40] [--out absorbance.csv]
"""
import argparse, csv, math, os, sys

ap = argparse.ArgumentParser(description=__doc__.split("\n")[0])
ap.add_argument("csv")
ap.add_argument("--n", type=int, default=8)
ap.add_argument("--min-sep", type=float, default=40.0)
ap.add_argument("--out")
a = ap.parse_args()
x, t = [], []
with open(a.csv, encoding="utf-8") as f:
    for row in csv.reader(line for line in f if not line.startswith("#")):
        try:
            x.append(float(row[0])); t.append(float(row[1]))
        except (ValueError, IndexError):
            continue          # header line "x,y"
if max(t) > 1.5:
    sys.exit("values above 1.5: not a 0-1 transmittance; check the units of the source")
A = [-math.log10(max(v, 1e-6)) for v in t]
peaks = [i for i in range(1, len(A) - 1) if A[i] >= A[i - 1] and A[i] > A[i + 1]]
peaks.sort(key=lambda i: A[i], reverse=True)
chosen = []
for i in peaks:
    if all(abs(x[i] - x[j]) >= a.min_sep for j in chosen):
        chosen.append(i)
    if len(chosen) == a.n:
        break
print(f"{len(x)} points, {min(x):g}-{max(x):g} cm-1, T from {min(t):.4f} to {max(t):.4f}")
print(f"{'cm-1':>8s} {'T':>8s} {'A':>8s}")
sat = 1e-3
for i in sorted(chosen, key=lambda i: x[i], reverse=True):
    print(f"{x[i]:8.1f} {t[i]:8.4f} {A[i]:8.4f}" + ("  saturated (T < 0.001): A not quantitative" if t[i] < sat else ""))
if a.out:
    if os.path.exists(a.out):
        sys.exit(f"{a.out} exists: refusing to overwrite")
    with open(a.out, "w", newline="", encoding="utf-8") as f:
        f.write("# absorbance A = -log10(T) computed from " + os.path.basename(a.csv) + "\n")
        w = csv.writer(f); w.writerow(["wavenumber_cm-1", "absorbance"])
        w.writerows(zip(x, (f"{v:.6g}" for v in A)))
    print("written", a.out)
$ python3 ../ir_bands.py benzene_IR_export.csv --n 8 --min-sep 40 --out benzene_IR_absorbance.csv
3343 points, 452-3794 cm-1, T from 0.0000 to 0.8868
cm-1 T A
3092.0 0.2122 0.6733
3048.0 0.1027 0.9884
2932.0 0.6623 0.1789
1949.0 0.6921 0.1598
1821.0 0.6244 0.2045
1488.0 0.3231 0.4907
1041.0 0.3963 0.4020
673.0 0.0000 6.0000 saturated (T < 0.001): A not quantitative
written benzene_IR_absorbance.csv
[exit 0]
$ head -4 benzene_IR_absorbance.csv
# absorbance A = -log10(T) computed from benzene_IR_export.csv
wavenumber_cm-1,absorbance
452.0,0.0561594
453.0,0.0561594
[exit 0]
$ python3 ../ir_bands.py benzene_IR_export.csv --out benzene_IR_absorbance.csv
3343 points, 452-3794 cm-1, T from 0.0000 to 0.8868
cm-1 T A
3092.0 0.2122 0.6733
3048.0 0.1027 0.9884
2932.0 0.6623 0.1789
1949.0 0.6921 0.1598
1821.0 0.6244 0.2045
1488.0 0.3231 0.4907
1041.0 0.3963 0.4020
673.0 0.0000 6.0000 saturated (T < 0.001): A not quantitative
benzene_IR_absorbance.csv exists: refusing to overwrite
[exit 1]Il benzene (D6h) ha quattro fondamentali attive in IR, nelle regioni di 3050 (stiramento C–H, insieme alla banda a 3092 cm⁻¹), 1484, 1038 e 673 cm⁻¹ (deformazione C–H fuori dal piano) secondo le tabelle di Shimanouchi (1972, doi:10.6028/NBS.NSRDS.39); i massimi trovati cadono a 3048, 1488, 1041 e 673 cm⁻¹. Le bande a 1949 e 1821 cm⁻¹ sono combinazioni tipiche degli aromatici. La banda a 673 cm⁻¹ arriva a trasmittanza zero: è saturata, e la sua assorbanza non ha valore quantitativo.
Passo 04 · Una seconda tecnica sperimentale
Anteprima del riferimento UV/Vis
Scorrere verso la fine dei risultati NIST, selezionare UV/Vis spectrum #0 e fare clic su Preview. Il grafico mostra lo spettro elettronico pubblicato.
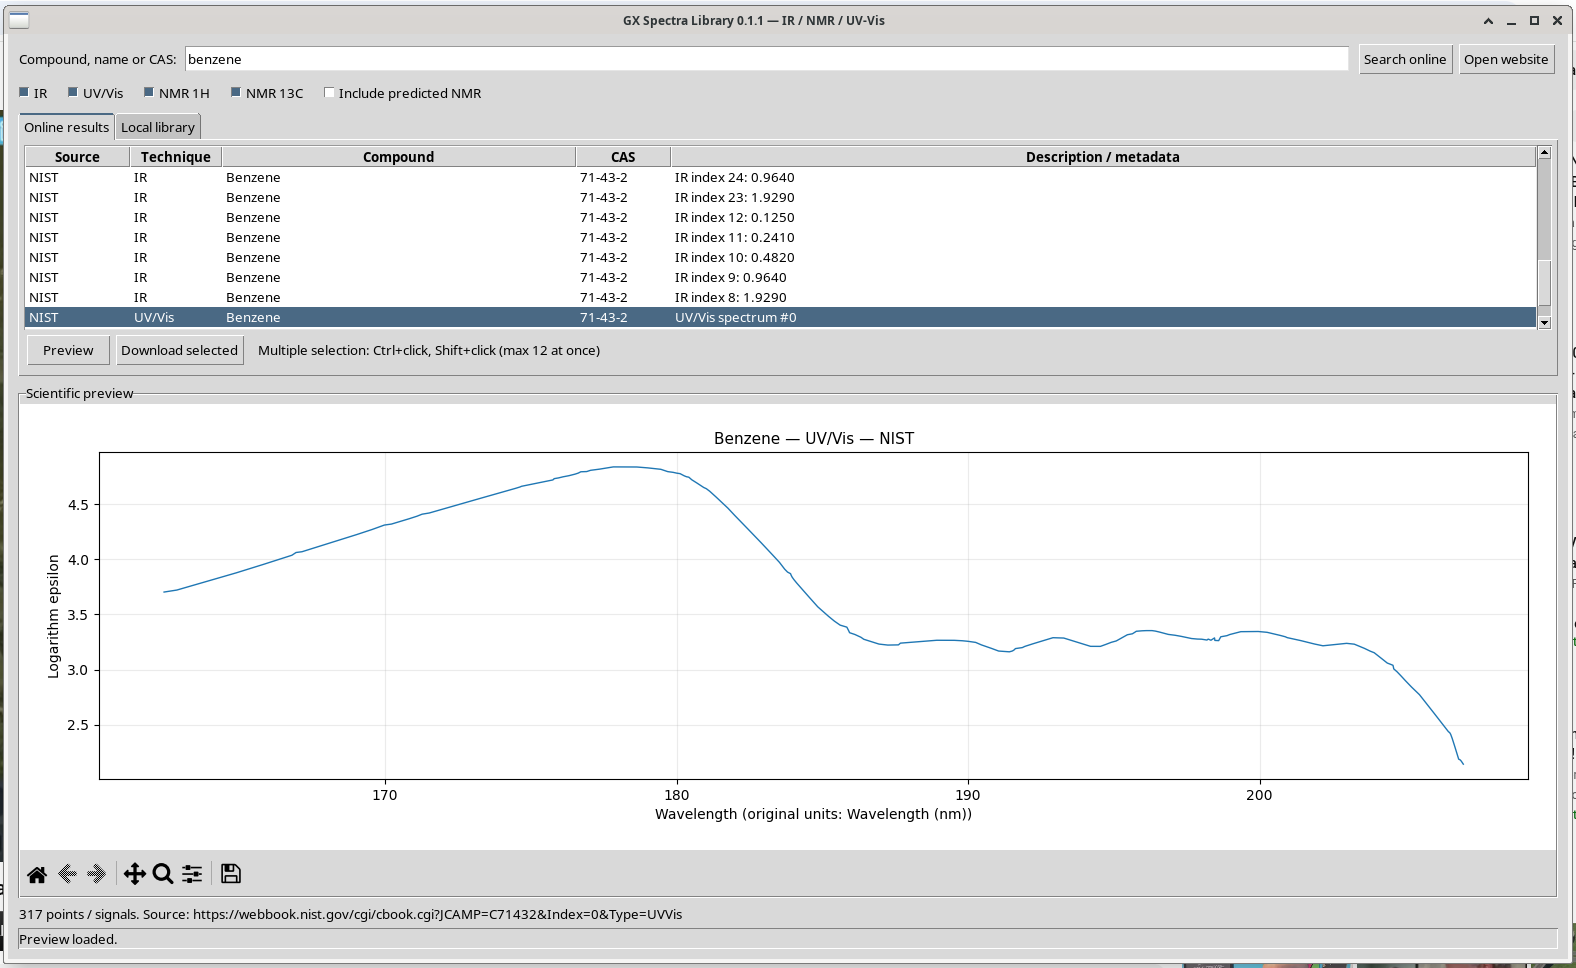
Questo record copre l’ultravioletto lontano. Nel confronto con altri dati vanno conservati l’intervallo esatto di lunghezze d’onda e la definizione originale dell’ordinata. Non si deve mai presumere che spettri di fonti diverse abbiano le stesse unità o le stesse condizioni sperimentali.
Approfondimento · Lo spettro UV del benzene: quali bande copre il record e che cosa significa log ε
Il benzene ha tre transizioni π→π* note: una debole intorno a 254 nm (¹B2u, con la tipica struttura vibronica), una intorno a 200 nm (¹B1u) e una molto intensa intorno a 180 nm (¹E1u). Il record NIST va da 162,4 a 207,0 nm: contiene la banda a 180 nm, con il massimo log ε = 4,84 a 177,8 nm (ε ≈ 6,9·10⁴ L mol⁻¹ cm⁻¹), e il fianco di quella a 200 nm (log ε ≈ 3,3 a 200 nm), ma non la banda a 254 nm, la più usata nelle misure di routine. Le intestazioni indicano come origine l’Institute of Energy Problems of Chemical Physics dell’Accademia russa delle scienze; per il benzene in fase vapore nell’ultravioletto da vuoto un riferimento classico è Pantos, Philis e Bolovinos (1978, doi:10.1016/0022-2852(78)90041-3).
L’ordinata è il logaritmo decimale del coefficiente di estinzione molare. Per confrontarla con la traccia di uno spettrofotometro va riportata in assorbanza con la legge di Beer–Lambert, A = ε·c·l, conoscendo concentrazione molare c e cammino ottico l; ad esempio con c = 10⁻⁵ mol/L e l = 1 cm, a 177,8 nm si avrebbe A ≈ 0,69. Al contrario, uno spettro in assorbanza diventa log ε solo dividendo per c·l. Sotto 190 nm l’ossigeno e quasi tutti i solventi assorbono: i dati di questa regione richiedono strumenti sotto vuoto o in gas inerte.
Passo 05 · Attribuzioni spettroscopiche
Anteprima dei record NMR del protone e del carbonio
Nella stessa tabella Online results, selezionare NMR 1H e fare clic su Preview; ripetere per NMR 13C. Il programma recupera le tabelle dei picchi da nmrshiftdb2, usando PubChem per risolvere il composto in un identificativo di struttura.
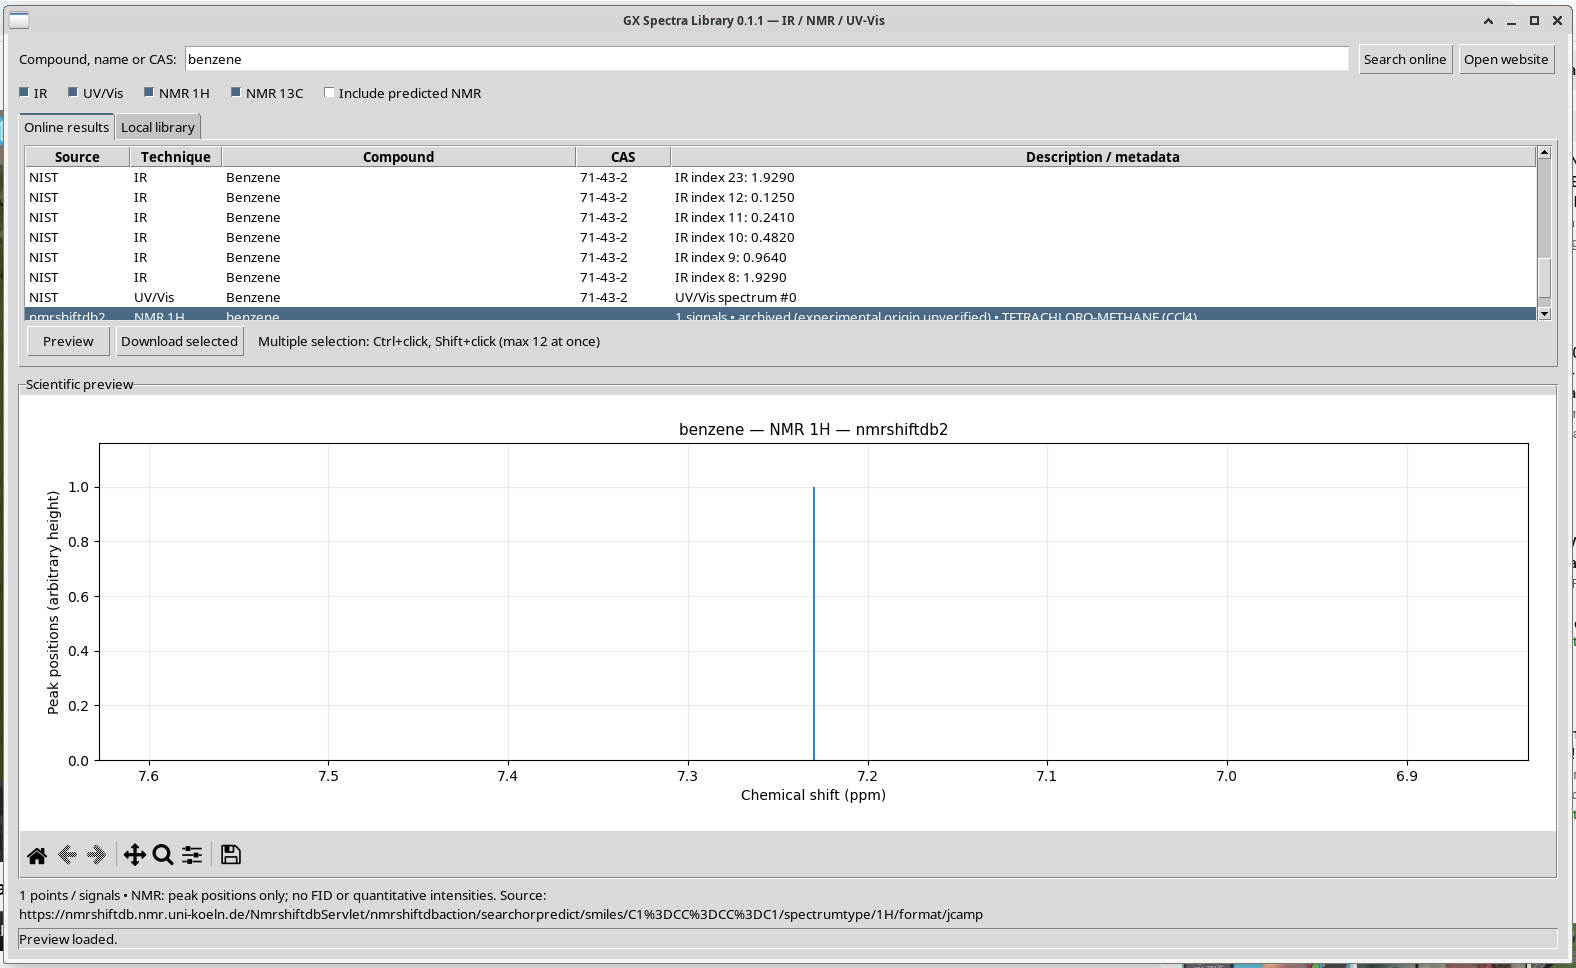
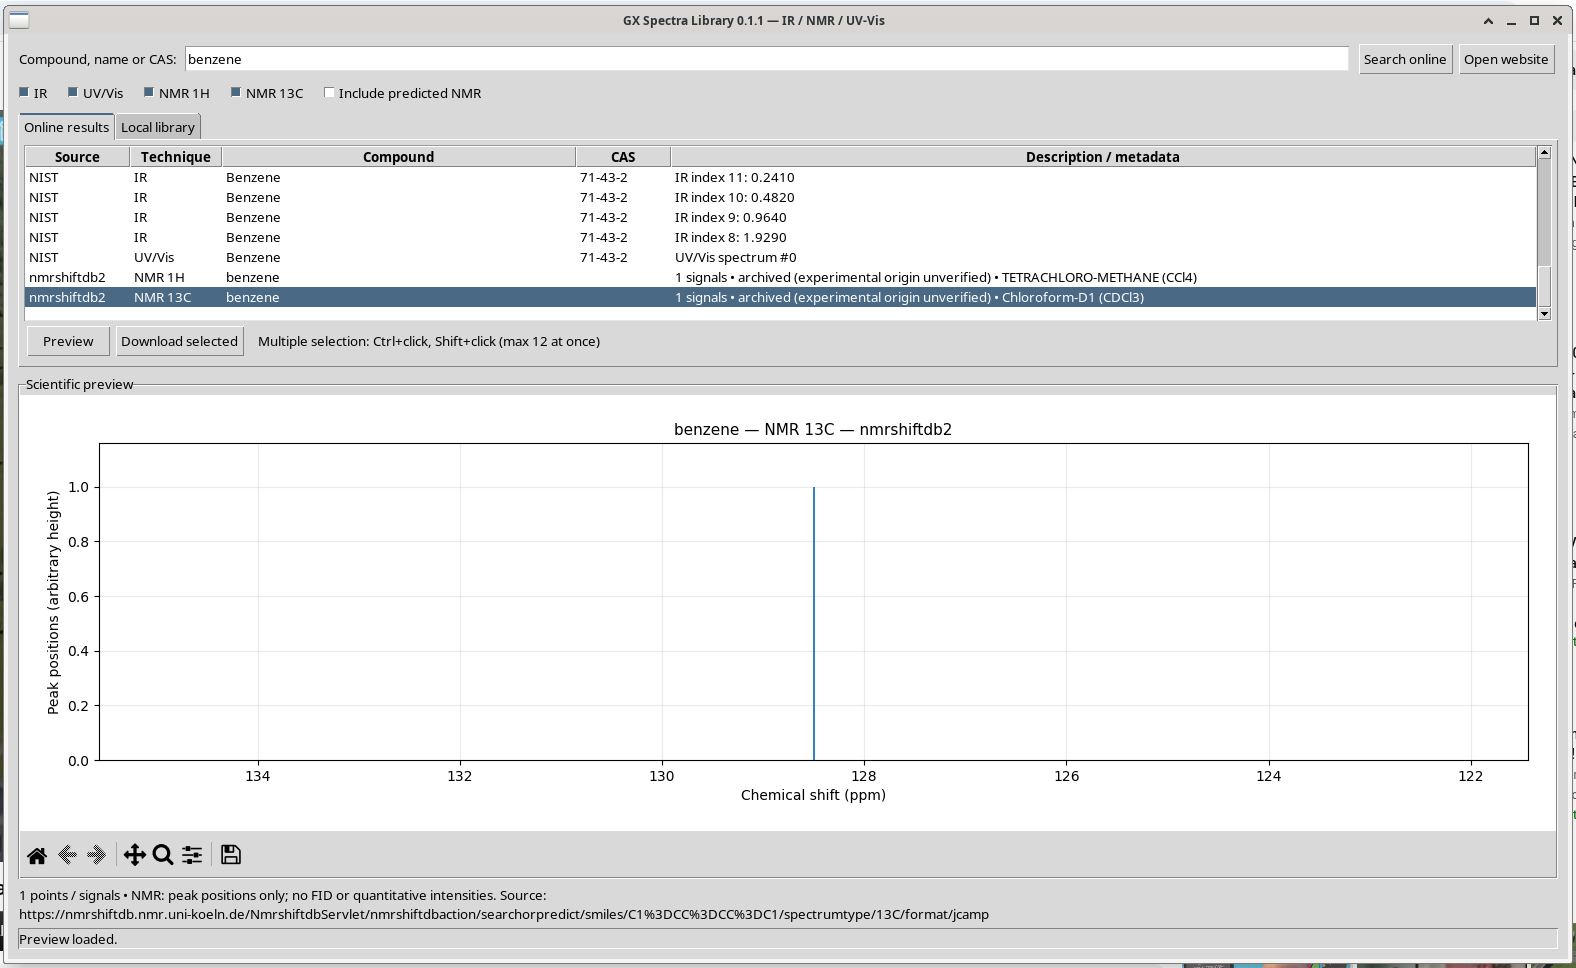
Limite importante dell’NMR. Questi grafici sono liste di posizioni dei picchi, non FID (decadimenti di induzione libera) misurati né tracce spettrali con intensità calibrata. Il visualizzatore disegna di proposito barre di altezza arbitraria. Il record è archiviato, ma la sua origine sperimentale va verificata nella banca dati di provenienza prima di trarne conclusioni metrologiche. Attivando Include predicted NMR possono comparire anche record predetti.
Approfondimento · Che cosa contiene davvero un record NMR di nmrshiftdb2
Il file scaricato per l’1H è questo, completo:
##TITLE=SPECTRUM
##JCAMP-DX=5.01
##DATATYPE=NMR PEAK TABLE
##DATACLASS=PEAK TABLE
##.OBSERVENUCLEUS=1H
##.OBSERVEFREQUENCY=60.0
##XUNITS=PPM
##YUNITS=ARBITRARY UNITS
##NPOINTS=1
##PEAKTABLE=(XY..XY)
7.230000019073486,7.230000019073486
##END=- la tabella dei picchi riporta come «intensità» lo stesso valore dello spostamento (Y = X): non è un’intensità, ed è il motivo per cui il programma disegna barre di altezza fissa (il commento nel codice lo dice esplicitamente);
- la frequenza di osservazione è 60 MHz, quella di uno strumento a onda continua d’epoca; nel record 13C vale 0,0, cioè non dichiarata;
- il solvente non è nel file ma nei metadati del catalogo (dalla risposta XML del servizio): tetraclorometano per l’1H, CDCl3 per il 13C. Lo ZIP lo conserva nel
manifest.json, il CSV no.
Lo spostamento chimico dipende dal solvente e dal riferimento: le tabelle di Gottlieb, Kotlyar e Nudelman (1997, doi:10.1021/jo971176v) e di Fulmer et al. (2010, doi:10.1021/om100106e) riportano per il benzene in CDCl3 7,36 ppm (1H) e 128,37 ppm (13C). Il valore 7,23 ppm del record, in CCl4 e a 60 MHz, e 128,5 ppm per il 13C sono coerenti entro le differenze di solvente e di epoca, ma mostrano perché la condizione va sempre riportata insieme al numero.
Passo 06 · Conservare i dati originali
Scaricare uno spettro per tecnica
Tornare alla lista Online results e selezionare le quattro voci appena viste. Tenere premuto Ctrl per selezionare righe non adiacenti; con Maiusc (Shift) si seleziona un intervallo continuo. Fare clic su Download selected.
Il programma scarica la risposta, controlla che sia un JCAMP-DX (deve iniziare con ##TITLE o contenere l’intestazione ##JCAMP-DX), scrive i dati originali della fonte e registra nel suo catalogo SQLite fonte, tecnica, URL, data e ora e SHA-256. Per non sovraccaricare i server pubblici, i download sono limitati a 12 spettri selezionati per operazione.
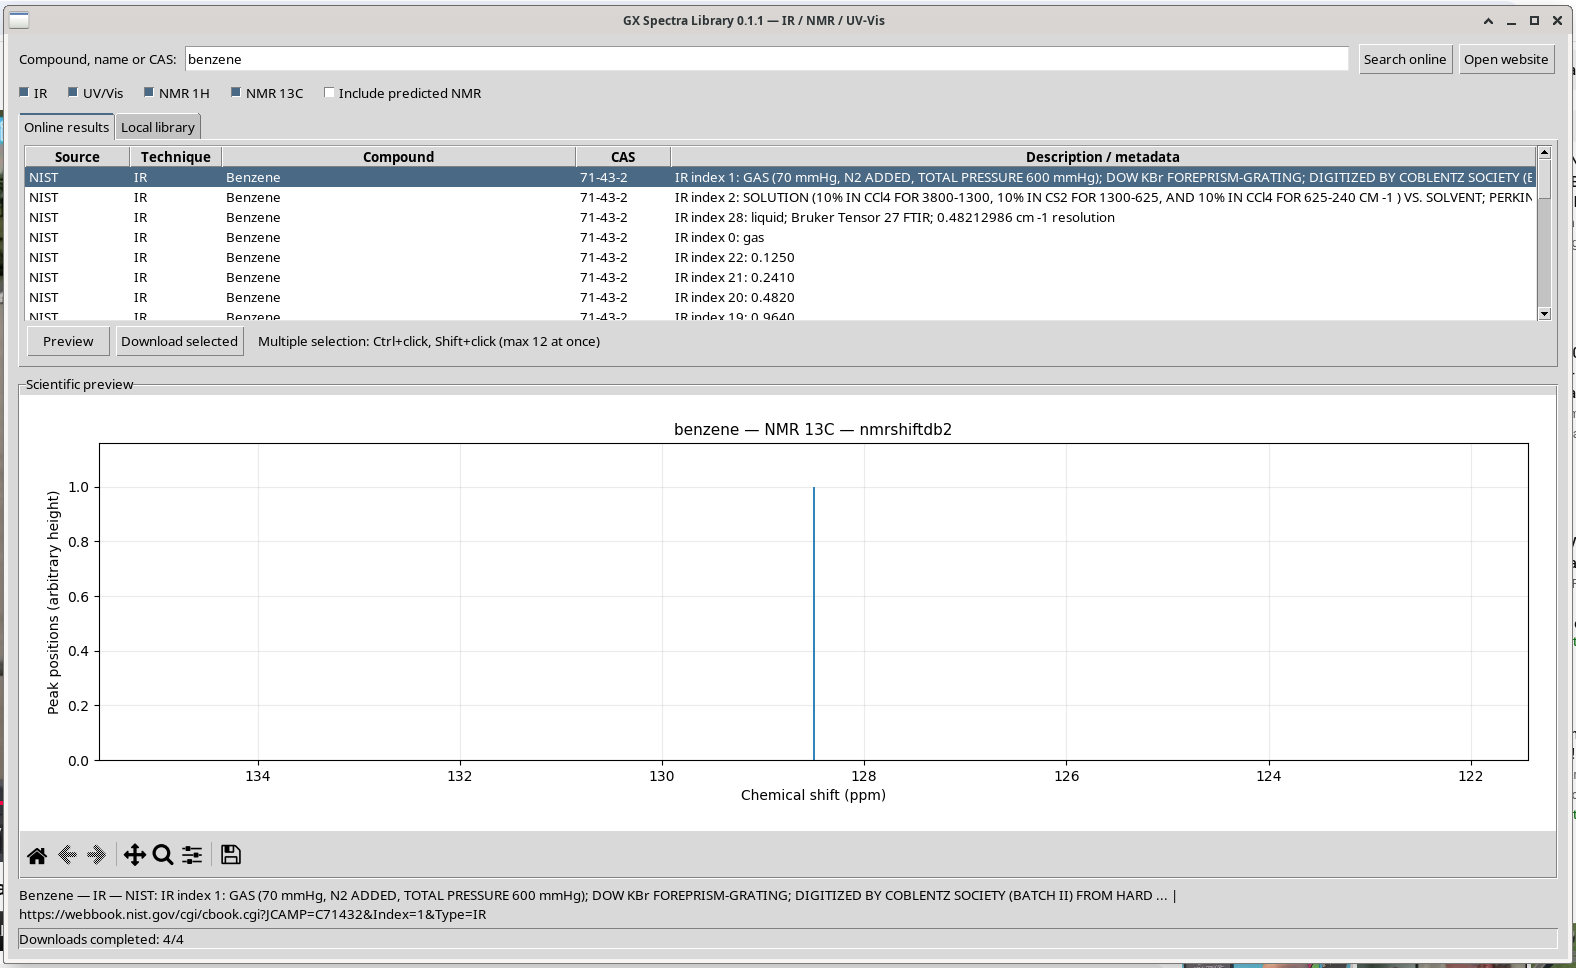
L’applicazione Debian installata salva normalmente i dati scaricati in ~/.local/share/gx-spectra-library/data/. Per questa guida si è usata di proposito una cartella dati isolata: i file dimostrativi non sono stati aggiunti al catalogo personale ordinario della postazione.
Consiglio pratico · Il catalogo SQLite e le impronte SHA-256: controllarli con uno script
Il catalogo è una sola tabella spectra con le colonne uid, source, kind, compound, cas, detail, url, filename, nmr_status, metadata, created. Alcuni dettagli utili:
uidsono i primi 24 caratteri esadecimali dello SHA-256 di «fonte|tecnica|URL»: scaricare di nuovo lo stesso record aggiorna la riga esistente invece di duplicarla;- il file si chiama
<composto>_<tecnica>_<uid[:8]>.jdxe viene scritto prima come.tmpe poi rinominato, così un’interruzione non lascia file troncati; - in
metadata(JSON) ci sono lo SHA-256 del file (lo standard è il FIPS 180-4, doi:10.6028/NIST.FIPS.180-4), la dimensione in byte, la pagina NIST o, per l’NMR, SMILES, CID, identificativo dello spettro e solvente.
catalogue_audit.py apre il catalogo in sola lettura e ricalcola l’impronta di ogni file: è il controllo da fare prima di usare la biblioteca per un lavoro quantitativo o dopo averla copiata su un altro computer.
#!/usr/bin/env python3
# SPDX-License-Identifier: GPL-3.0-or-later
"""Audit a GX Spectra Library catalogue: list every record and re-check the SHA-256 of its file.

Reads catalogo.sqlite3 read-only and, for every row, recomputes the SHA-256
of the stored JCAMP-DX file and compares it with the value written at
download time (metadata.sha256). Nothing is modified.

Usage: python3 catalogue_audit.py [LIBRARY_DIR]
       (default: $XDG_DATA_HOME/gx-spectra-library or ~/.local/share/gx-spectra-library)
"""
import hashlib, json, os, sqlite3, sys
from pathlib import Path

base = Path(sys.argv[1]) if len(sys.argv) > 1 else \
    Path(os.environ.get("XDG_DATA_HOME") or Path.home() / ".local" / "share") / "gx-spectra-library"
db = base / "catalogo.sqlite3"
if not db.is_file():
    sys.exit(f"catalogue not found: {db}")
con = sqlite3.connect(f"file:{db}?mode=ro", uri=True)
rows = con.execute("SELECT uid, source, kind, compound, cas, filename, url, metadata, created "
                   "FROM spectra ORDER BY created").fetchall()
bad = 0
print(f"{len(rows)} records in {db}")
for uid, source, kind, compound, cas, filename, url, meta, created in rows:
    meta = json.loads(meta or "{}")
    path = base / filename
    if not path.is_file():
        state, bad = "MISSING FILE", bad + 1
    else:
        digest = hashlib.sha256(path.read_bytes()).hexdigest()
        state = "OK" if digest == meta.get("sha256") else "HASH MISMATCH"
        bad += state != "OK"
    print(f"{state:13s} {kind:8s} {source:12s} {compound:10s} {cas or '-':9s} {filename}")
    print(f"{'':13s} {meta.get('dimensione_byte', '?')} bytes, {created}, {url[:90]}")
sys.exit(1 if bad else 0)
Eseguito sul catalogo dimostrativo della guida:
$ python3 ../catalogue_audit.py gx-spectra-library
5 records in gx-spectra-library/catalogo.sqlite3
OK            IR       NIST         Benzene    71-43-2   data/IR/Benzene_IR_c92c9880.jdx
              32255 bytes, 2026-11-01T11:43:45+01:00, https://webbook.nist.gov/cgi/cbook.cgi?JCAMP=C71432&Index=1&Type=IR
OK            UV/Vis   NIST         Benzene    71-43-2   data/UV_Vis/Benzene_UV_Vis_cb758131.jdx
              6644 bytes, 2026-11-01T11:43:45+01:00, https://webbook.nist.gov/cgi/cbook.cgi?JCAMP=C71432&Index=0&Type=UVVis
OK            NMR 1H   nmrshiftdb2  benzene    -         data/NMR_1H/benzene_NMR_1H_d4aa46e0.jdx
              254 bytes, 2026-11-01T11:43:46+01:00, https://nmrshiftdb.nmr.uni-koeln.de/NmrshiftdbServlet/nmrshiftdbaction/searchorpredict/smi
OK            NMR 13C  nmrshiftdb2  benzene    -         data/NMR_13C/benzene_NMR_13C_32ac5c67.jdx
              230 bytes, 2026-11-01T11:43:46+01:00, https://nmrshiftdb.nmr.uni-koeln.de/NmrshiftdbServlet/nmrshiftdbaction/searchorpredict/smi
OK            IR       Locale       benzene_IR_export -         data/IR/benzene_IR_export_IR_3016be87.jdx
              42687 bytes, 2026-11-01T11:43:51+01:00, file-import://21f9ce427cfa49f351ba5c2c264909f1229f3caa9f97daf4c8f77fd26eede2e2
[exit 0]
Passo 07 · Consultazione offline
Aprire la biblioteca locale
Selezionare la scheda Local library: ora contiene quattro record. Selezionare la riga IR NIST scaricata e fare clic su Preview. Questa volta il grafico viene caricato dal file salvato su disco: funziona senza connessione a internet.
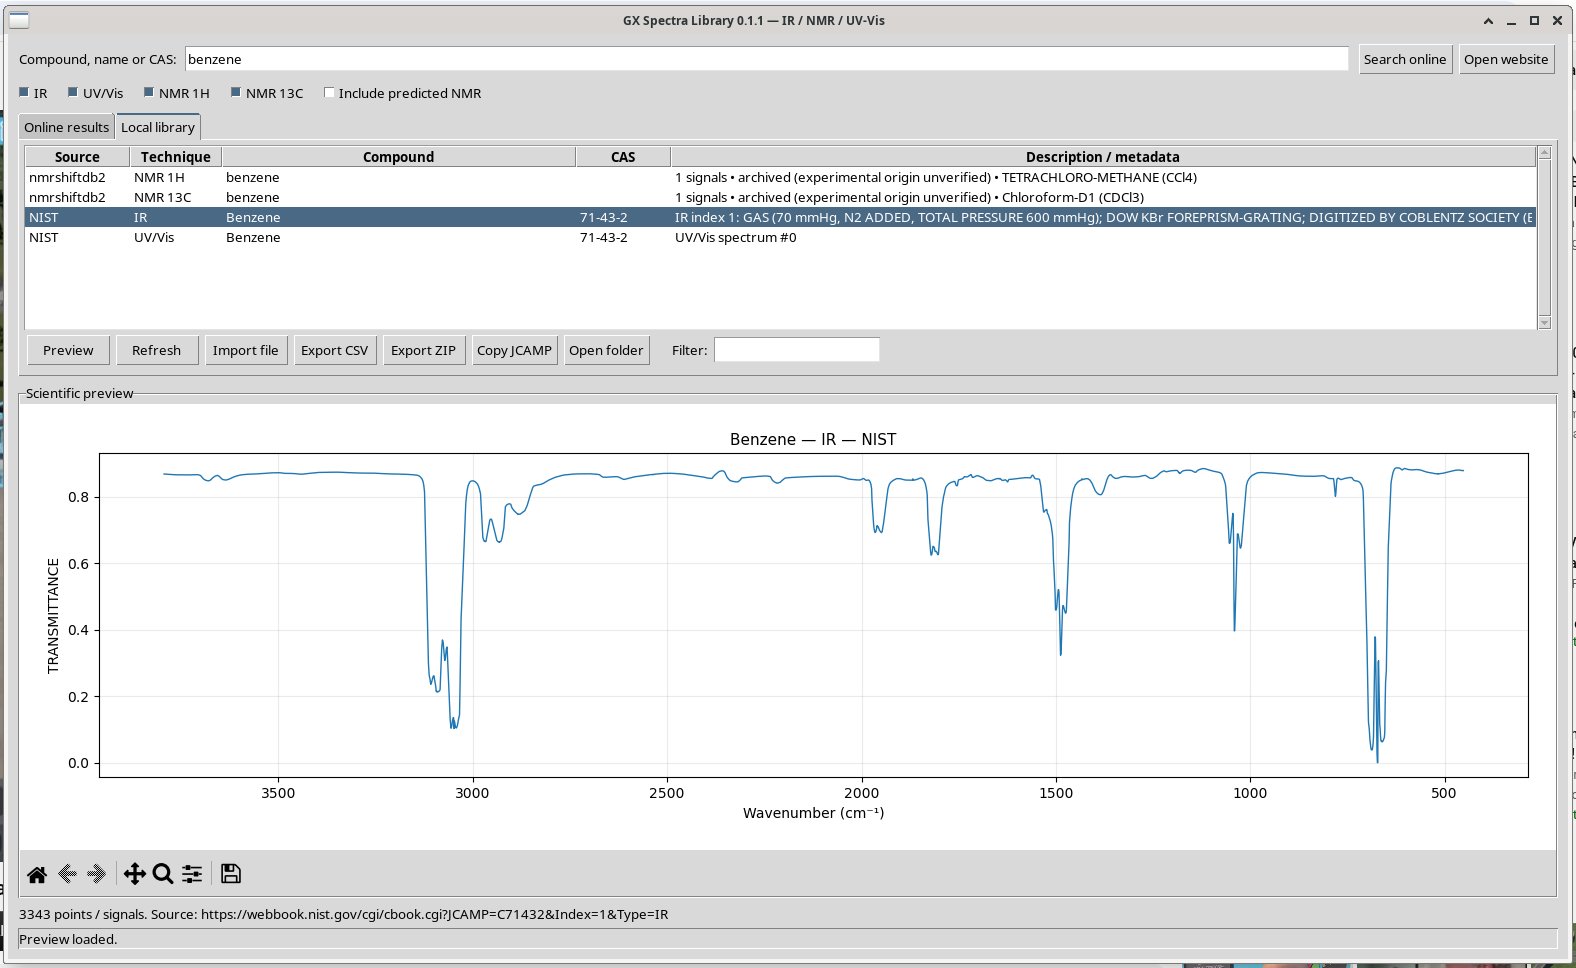
Il campo Filter cerca nei nomi del catalogo, nei numeri CAS, nelle tecniche e nelle descrizioni; con Invio si aggiorna la vista. Refresh ricarica il catalogo e Open folder apre la cartella dei dati spettrali nel file manager del desktop.
Passo 08 · Scambiare dati numerici
Esportare un CSV a due colonne
Con il record IR del benzene salvato selezionato, fare clic su Export CSV, scegliere la destinazione nella finestra di salvataggio e confermare. In questo percorso il file si chiama benzene_IR_export.csv.
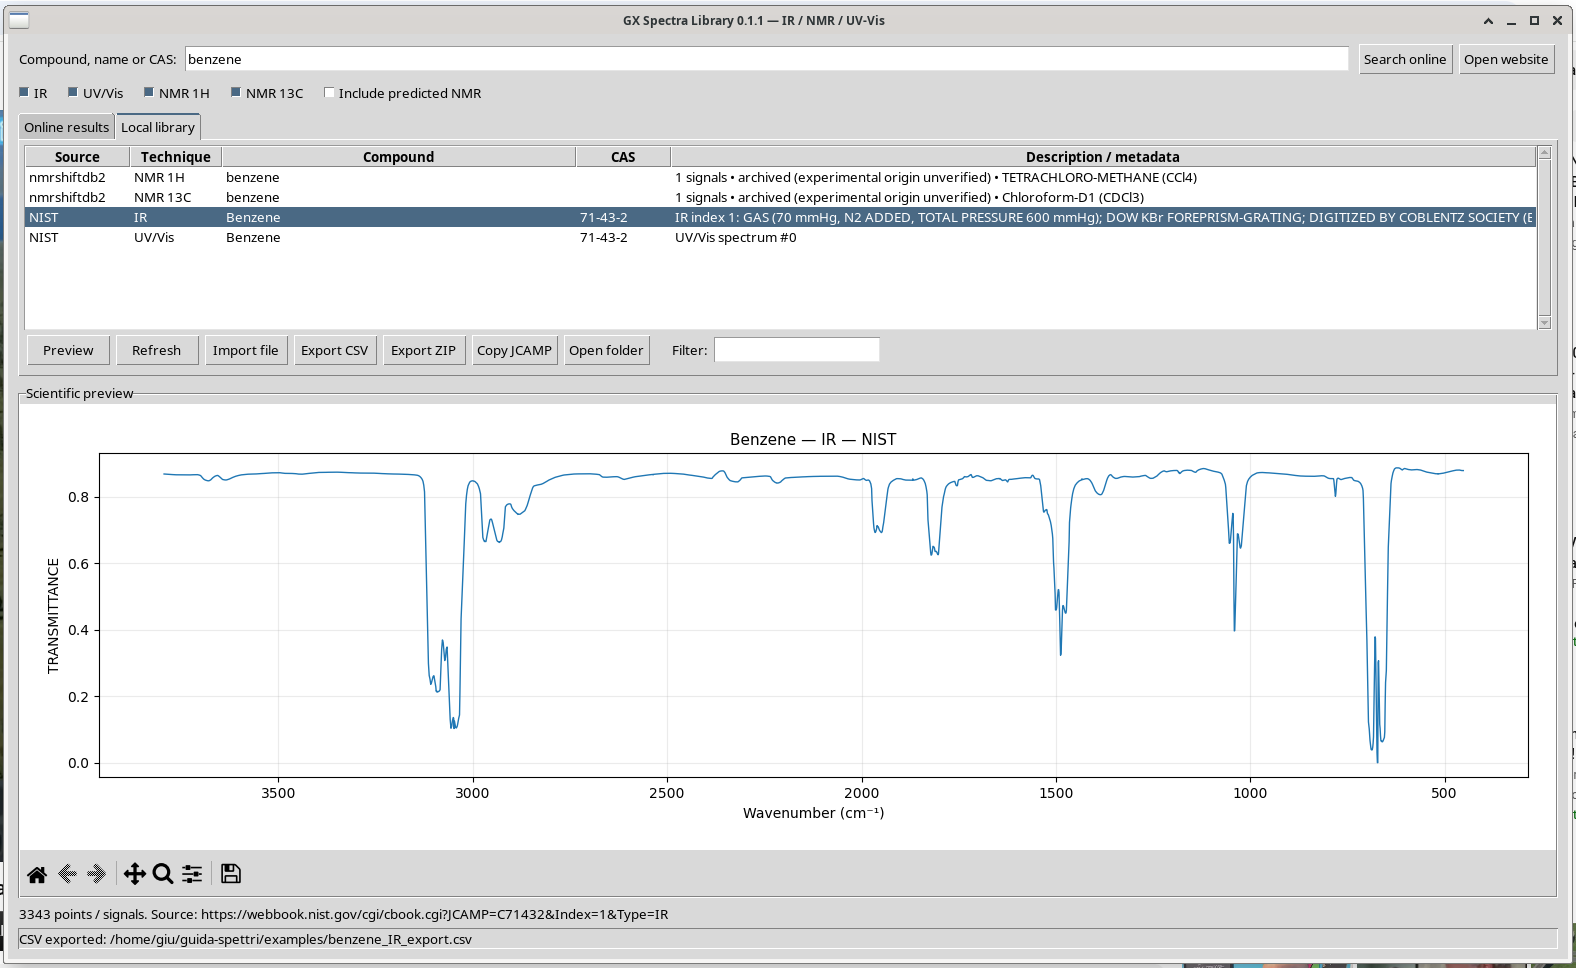
Il CSV contiene i dati numerici X,Y originali, con righe di commento che riportano composto, tecnica, fonte, URL e un avviso sulle unità. Un breve estratto del file realmente esportato:
# compound: Benzene
# technique: IR
# source: NIST
# url: https://webbook.nist.gov/cgi/cbook.cgi?JCAMP=C71432&Index=1&Type=IR
# note: Units and conditions are those in the original JCAMP
x,y
452.0,0.8787
453.0,0.8787
454.0,0.8787
Le 3343 righe X,Y si possono importare in programmi di calcolo come GX-TXT, Octave o Python. Il CSV è un’esportazione numerica derivata: se servono tutti i metadati strumentali e di provenienza va conservato il JCAMP originale.
Consiglio pratico · Leggere il CSV in Python, GX-TXT o Octave
Il file ha cinque righe di commento con #, una riga d’intestazione x,y e poi i dati, con il punto decimale e la virgola come separatore. Viene esportato solo il primo record selezionato. In Python con NumPy:
import numpy as np
x, y = np.loadtxt("benzene_IR_export.csv", delimiter=",", comments="#", skiprows=6, unpack=True)
print(len(x), x.min(), x.max())     # 3343 452.0 3794.0
In skiprows NumPy conta anche le righe di commento: 5 commenti più l’intestazione fanno 6. In Octave dlmread("benzene_IR_export.csv", ",", 6, 0) salta le stesse sei righe; GX-TXT e i fogli di calcolo accettano il file come CSV con intestazione. Nel CSV le righe di commento riportano l’URL ma non lo stato fisico né la risoluzione: per un confronto quantitativo vanno annotati a parte, o si usa il JCAMP.
Passo 09 · Una raccolta trasportabile
Esportare uno ZIP di più spettri con la provenienza
In Local library selezionare con Ctrl+clic i quattro spettri originali. Fare clic su Export ZIP e scegliere benzene_reference_spectra.zip.
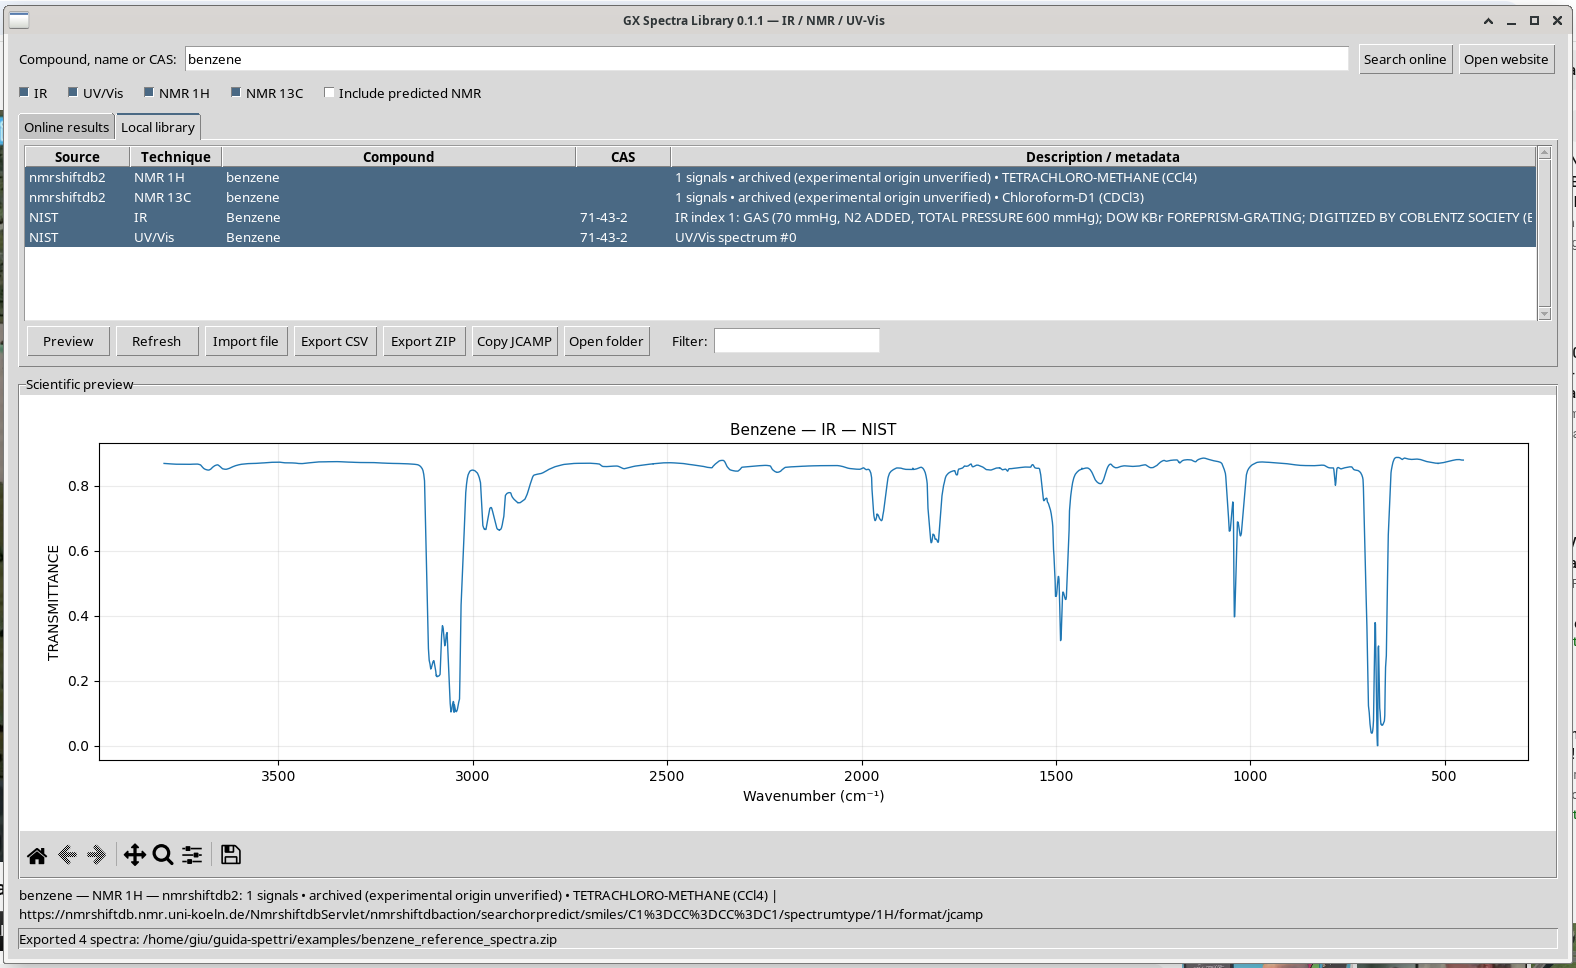
manifest.json.Lo ZIP conserva i file JCAMP non modificati, raggruppati per tecnica. Il suo manifest.json contiene la fonte, l’URL originale, i metadati del record e le impronte dei file. È comodo per trasferire la raccolta fra i propri programmi scientifici senza perdere la tracciabilità.
Diritti e ridistribuzione. Il fatto che una fonte sia accessibile pubblicamente non significa che i suoi dati siano di pubblico dominio. Questi file d’esempio servono per prove in locale: prima di distribuire lo ZIP o di riutilizzare le immagini in una pubblicazione vanno controllate licenza e obblighi di citazione della fonte.
Consiglio pratico · Verificare uno ZIP ricevuto con il suo manifest
Il manifest.json contiene, per ogni spettro, l’intero record di catalogo (fonte, tecnica, URL, solvente, SMILES, impronta SHA-256 e dimensione) e il percorso del file nell’archivio. verify_zip.py ricalcola le impronte e segnala file mancanti, alterati o non elencati:
#!/usr/bin/env python3
# SPDX-License-Identifier: GPL-3.0-or-later
"""Check a ZIP exported by GX Spectra Library against its manifest.json.

For every spectrum listed in the manifest, the file in the archive is hashed
(SHA-256) and compared with the hash recorded in the catalogue at download
time; files present in the archive but absent from the manifest are reported.

Usage: python3 verify_zip.py collection.zip
"""
import hashlib, json, sys, zipfile

if len(sys.argv) != 2:
    sys.exit(__doc__)
with zipfile.ZipFile(sys.argv[1]) as z:
    manifest = json.loads(z.read("manifest.json"))
    names = set(z.namelist()) - {"manifest.json"}
    print(f"{manifest['application']}, created {manifest['created']}: {len(manifest['spectra'])} spectra")
    bad = 0
    for s in manifest["spectra"]:
        arc = s["file_in_archive"]
        names.discard(arc)
        digest = hashlib.sha256(z.read(arc)).hexdigest()
        ok = digest == s["metadata"].get("sha256")
        bad += not ok
        print(f"{'OK ' if ok else 'BAD'} {s['kind']:8s} {s['source']:12s} {arc}")
        print(f"    {s['url']}")
    for extra in sorted(names):
        print(f"NOT IN MANIFEST {extra}")
        bad += 1
sys.exit(1 if bad else 0)
$ python3 ../verify_zip.py benzene_reference_spectra.zip
GX Spectra Library, created 2026-11-01T10:43:50.405573+00:00: 4 spectra
OK NMR 1H nmrshiftdb2 spectra/NMR_1H/benzene_NMR_1H_d4aa46e0.jdx
https://nmrshiftdb.nmr.uni-koeln.de/NmrshiftdbServlet/nmrshiftdbaction/searchorpredict/smiles/C1%3DCC%3DCC%3DC1/spectrumtype/1H/format/jcamp
OK NMR 13C nmrshiftdb2 spectra/NMR_13C/benzene_NMR_13C_32ac5c67.jdx
https://nmrshiftdb.nmr.uni-koeln.de/NmrshiftdbServlet/nmrshiftdbaction/searchorpredict/smiles/C1%3DCC%3DCC%3DC1/spectrumtype/13C/format/jcamp
OK IR NIST spectra/IR/Benzene_IR_c92c9880.jdx
https://webbook.nist.gov/cgi/cbook.cgi?JCAMP=C71432&Index=1&Type=IR
OK UV/Vis NIST spectra/UV_Vis/Benzene_UV_Vis_cb758131.jdx
https://webbook.nist.gov/cgi/cbook.cgi?JCAMP=C71432&Index=0&Type=UVVis
[exit 0]Il manifest dichiara anche che esportare i file non cambia i diritti d’uso delle banche dati di origine: lo ZIP è uno strumento di tracciabilità, non una licenza.
Passo 10 · Verificare il viaggio di andata e ritorno
Importare il CSV e rivederlo in anteprima
- In Local library, fare clic su Import file.
- Selezionare il file
benzene_IR_export.csvesportato prima. - Quando il programma chiede la tecnica, scrivere IR.
- La biblioteca crea un nuovo record locale chiamato
benzene_IR_export. Selezionarlo e fare clic su Preview.
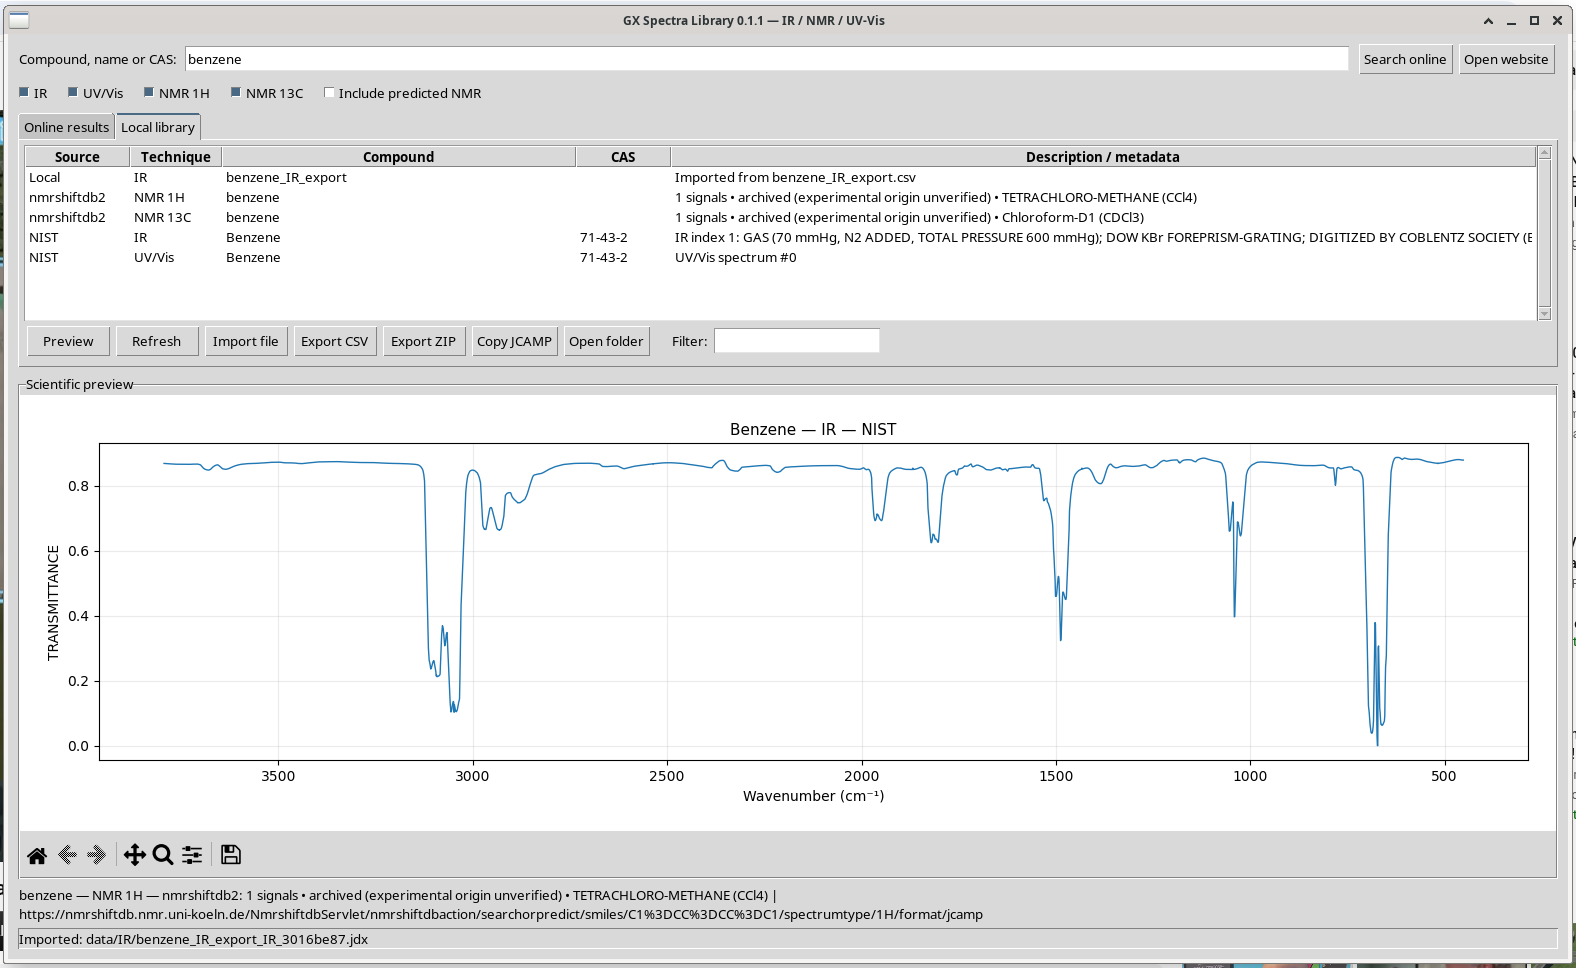
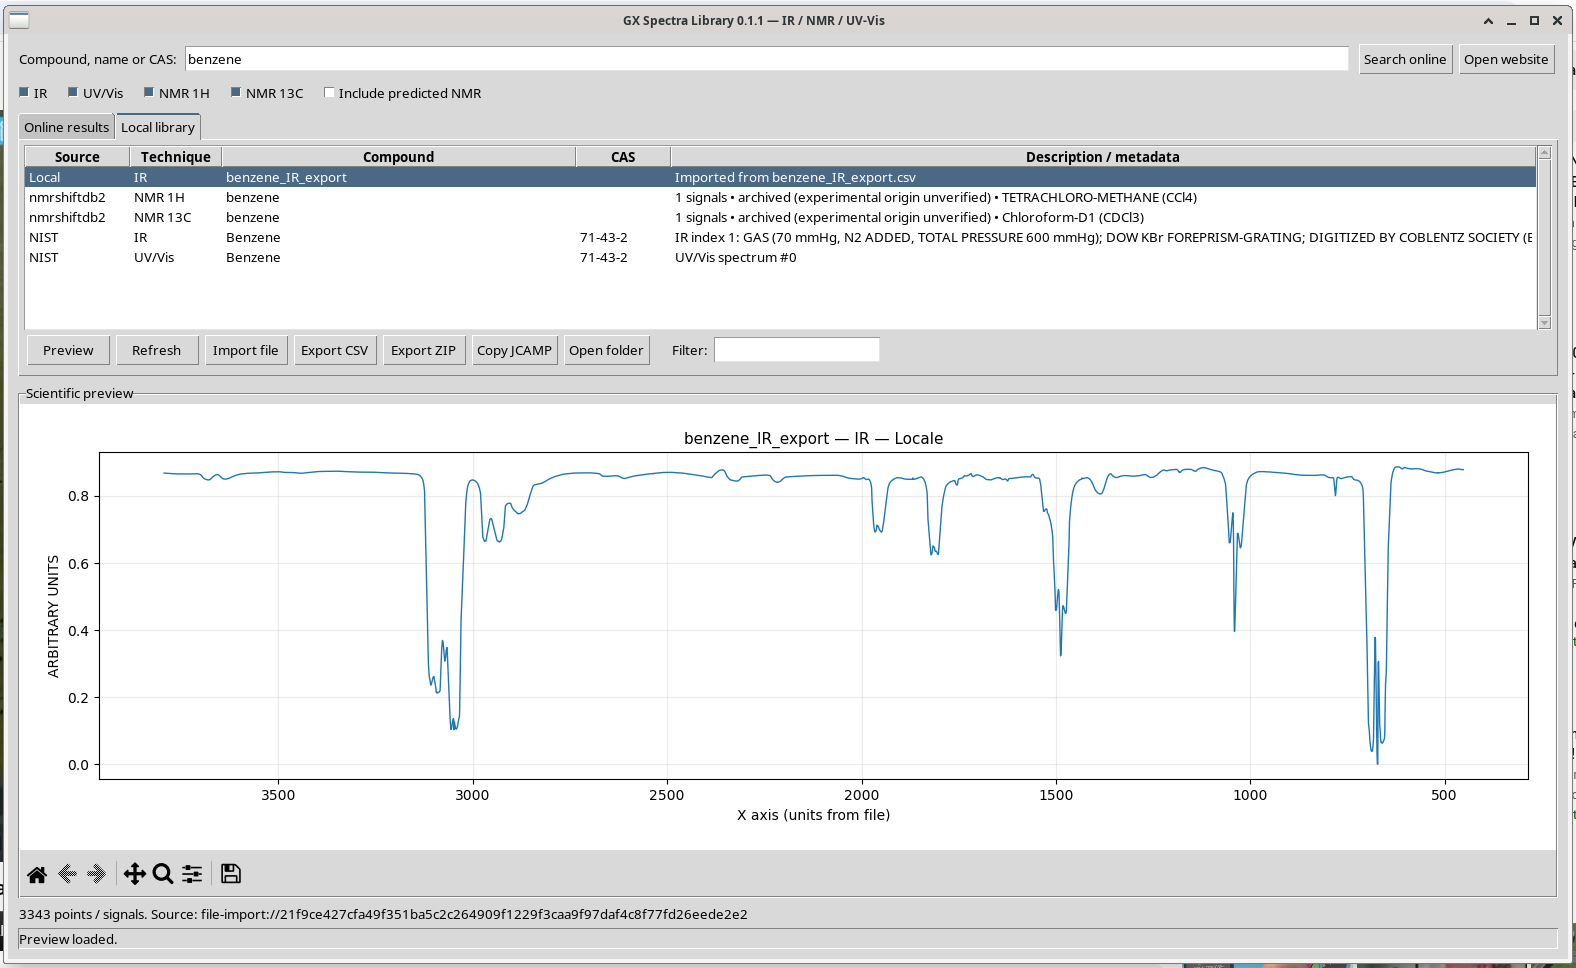
L’importazione converte la serie X,Y del CSV in un record JCAMP locale. Non ricrea tutte le intestazioni e le condizioni del file NIST originale: per questo nel catalogo dimostrativo sono state conservate entrambe le versioni. Questa separazione conta per la provenienza scientifica.
Approfondimento · Che cosa si perde nel passaggio JCAMP → CSV → JCAMP
L’importazione di un CSV crea un JCAMP minimo: ##DATA TYPE=XY DATA, ##XUNITS=ARBITRARY UNITS, ##YUNITS=ARBITRARY UNITS e una tabella (XY..XY); la fonte diventa «Locale» e l’URL file-import:// seguito dallo SHA-256 dei dati. roundtrip_check.py confronta i due file con lo stesso lettore del programma:
#!/usr/bin/env python3
# SPDX-License-Identifier: GPL-3.0-or-later
"""Compare an original JCAMP-DX file with its CSV round trip: numbers and headers.

Uses the same reader as GX Spectra Library (spectrum_io.load_spectrum, run it
from the source checkout or set PYTHONPATH to it) to decode both files, then
reports the number of points, the largest difference in X and Y and the
JCAMP headers that the re-imported file no longer carries.

Usage: PYTHONPATH=/path/to/gx-spectra-library:/path/to/gx-spectra-library/packaging/vendor \\
       python3 roundtrip_check.py original.jdx reimported.jdx [--kind IR]
"""
import argparse
from spectrum_io import load_spectrum

ap = argparse.ArgumentParser(description=__doc__.split("\n")[0])
ap.add_argument("original"); ap.add_argument("reimported"); ap.add_argument("--kind", default="IR")
a = ap.parse_args()
x1, y1, h1, m1 = load_spectrum(a.original, a.kind)
x2, y2, h2, m2 = load_spectrum(a.reimported, a.kind)
print(f"points: {len(x1)} original, {len(x2)} re-imported")
if len(x1) == len(x2):
    print(f"max |dX| = {abs(x1 - x2).max():.3g}, max |dY| = {abs(y1 - y2).max():.3g}")
for key in ("XUNITS", "YUNITS", "DATA TYPE", "STATE", "RESOLUTION", "ORIGIN", "OWNER"):
    print(f"{key:11s} original: {h1.get(key, '-')!s:45.45s} re-imported: {h2.get(key, '-')}")
lost = sorted(set(h1) - set(h2))
print(f"{len(lost)} headers of the original are absent after the round trip:", ", ".join(lost))
$ PYTHONPATH=../../repo:../../repo/packaging/vendor python3 ../roundtrip_check.py gx-spectra-library/data/IR/Benzene_IR_c92c9880.jdx gx-spectra-library/data/IR/benzene_IR_export_IR_3016be87.jdx --kind IR
points: 3343 original, 3343 re-imported
max |dX| = 0, max |dY| = 0
XUNITS original: 1/CM re-imported: ARBITRARY UNITS
YUNITS original: TRANSMITTANCE re-imported: ARBITRARY UNITS
DATA TYPE original: INFRARED SPECTRUM re-imported: XY DATA
STATE original: GAS (70 mmHg, N2 ADDED, TOTAL PRESSURE 600 mm re-imported: -
RESOLUTION original: 2 re-imported: -
ORIGIN original: DOW CHEMICAL COMPANY re-imported: -
OWNER original: Copyright (C) 1987 by the Coblentz Society re-imported: -
26 headers of the original are absent after the round trip: $NIST IMAGE, $NIST SOURCE, CAS REGISTRY NO, CLASS, DATA PROCESSING, DATE, FIRSTX, FIRSTY, INSTRUMENT PARAMETERS, LASTX, MAXX, MAXY, MINX, MINY, MOLFORM, ORIGIN, OWNER, PATH LENGTH, RESOLUTION, SAMPLING PROCEDURE, SOURCE REFERENCE, SPECTROMETER/DATA SYSTEM, STATE, XFACTOR, XYDATA, YFACTOR
[exit 0]I numeri sono identici (differenza zero su tutti i 3343 punti), ma spariscono 26 intestazioni: unità, stato, risoluzione, origine e titolare dei diritti. Si vede anche nella figura 12: gli assi diventano «X axis (units from file)» e «ARBITRARY UNITS», e il titolo del grafico mostra «Locale», l’etichetta interna della fonte non tradotta. Per questo il JCAMP originale va sempre conservato accanto al CSV.
File generati in questo percorso
I file di output reali
Questi file d’esempio sono stati creati usando la vera interfaccia sulle fonti pubbliche. Non sono distribuiti con questo articolo: gli spettri appartengono alle loro fonti (NIST, Coblentz Society, nmrshiftdb2), le cui condizioni regolano la ridistribuzione, e seguendo i passi 06–10 con il programma si ricreano identici.
- IR originale NIST del benzene — JCAMP-DX: il record IR in fase gassosa non modificato usato nelle schermate (32 255 byte).
- IR del benzene — CSV esportato: 3343 campioni X,Y più i commenti sulla fonte (esportazione derivata, circa 49 kB).
- Raccolta di riferimento del benzene — ZIP: un JCAMP IR, uno UV/Vis, uno NMR 1H e uno NMR 13C, più un manifest di provenienza.
- Metadati della cattura e della verifica — JSON: URL delle fonti, numero di campioni, unità, tecniche e identificativi dei file registrati durante il percorso reale.
Dove salva la biblioteca l’applicazione installata?
~/.local/share/gx-spectra-library/
├── catalogo.sqlite3
└── data/
    ├── IR/
    ├── UV_Vis/
    ├── NMR_1H/
    └── NMR_13C/
I dati sono salvati fuori dal pacchetto Debian: aggiornare o rimuovere il programma non cancella gli spettri dell’utente. Il catalogo dimostrativo e le esportazioni d’esempio usati per questa guida sono stati tenuti in una cartella separata, lontano da questa posizione ordinaria della biblioteca.
Note scientifiche e di riproducibilità
Interpretare i numeri, non solo il grafico
| Record | Osservato nel percorso | Interpretazione / limite |
|---|---|---|
| IR del benzene, NIST | 3343 campioni; 452–3794 cm⁻¹; trasmittanza | L’asse X dell’IR è invertito per la visualizzazione. Condizioni e indice dello spettro devono accompagnare i dati. |
| UV/Vis del benzene, NIST | 317 campioni; 162,418–206,9805 nm; logaritmo di epsilon | Fonte nell’ultravioletto lontano con una propria definizione dell’ordinata; non è senz’altro una traccia di assorbanza convenzionale. |
| nmrshiftdb2 1H | Uno spostamento riportato, ~7,23 ppm | Posizione di picco, non FID. L’altezza della barra è arbitraria. L’origine va verificata nella fonte. |
| nmrshiftdb2 13C | Uno spostamento riportato, 128,5 ppm | Posizione di picco, non intensità calibrata. Solvente e dettagli di acquisizione vanno controllati. |
I dati sono stati scaricati direttamente dal NIST Chemistry WebBook e da nmrshiftdb2. PubChem è usato dal programma per risolvere i nomi in SMILES, non come banca dati spettrale. In qualsiasi lavoro scientifico queste fonti vanno citate secondo le loro condizioni.
Per l’elaborazione numerica il JCAMP-DX originale è preferibile a un’immagine. Se serve un CSV, vanno documentati unità originali, stato e condizioni di acquisizione, URL della fonte, momento del recupero ed eventuali trasformazioni applicate.
Approfondimento · Citare le fonti e rispettarne le condizioni
- NIST Chemistry WebBook: NIST Standard Reference Database Number 69, doi:10.18434/T4D303, descritto in Linstrom e Mallard (2001, doi:10.1021/je000236i). Molti spettri IR sono della collezione della Coblentz Society, che ne detiene i diritti: l’intestazione
OWNERdel file lo dichiara; - nmrshiftdb2: citare Steinbeck, Krause e Kuhn (2003, doi:10.1021/ci0341363) e indicare l’identificativo dello spettro (qui
nmrshiftdb19943per l’1H enmrshiftdb15502per il 13C, dai metadati del catalogo); - PubChem: Kim et al. (2023, doi:10.1093/nar/gkac956), se l’identità del composto è parte del ragionamento;
- per la documentazione dei dati i principi FAIR (Wilkinson et al. 2016, doi:10.1038/sdata.2016.18) chiedono identificativi persistenti, provenienza e licenza esplicite: il catalogo e il manifest del programma forniscono già URL, data e impronta, da riportare nel metodo di un lavoro.
Per questo motivo i file JCAMP, CSV e ZIP prodotti nel percorso non sono distribuiti con questo articolo: ripetendo i passi 06–10 il programma li ricrea identici dalla fonte.
Riferimento pratico
Domande frequenti
Il programma si apre in italiano
Avviarlo con LANGUAGE=en gx-spectra-library. GNU gettext legge anche LC_MESSAGES e LANG, e alcune sessioni del desktop li sovrascrivono. Dopo aver cambiato lingua il programma va riavviato. Il pacchetto installato contiene i file di traduzione inglese e italiano.
La ricerca online restituisce meno voci
La disponibilità dipende dalla fonte. Cercare in inglese o per numero CAS; per il benzene 71-43-2. Controllare la connessione a internet e quali tecniche sono selezionate. Non si deve presumere che tutte le voci NIST abbiano condizioni sperimentali confrontabili.
Perché l’NMR sembra una sola riga?
In questo record il benzene ha un solo spostamento protonico e un solo spostamento del carbonio. Il servizio fornisce dati di picco e non un FID continuo. Il grafico usa barre di altezza fissa per rappresentare le posizioni degli spostamenti chimici.
Come lavorare offline o scambiare file con altri programmi?
Local library permette di consultare gli spettri salvati senza rete. Copy JCAMP serve quando occorre il file nativo non modificato, Export CSV per l’analisi tabellare ed Export ZIP per raccolte trasportabili di più spettri.
Dove trovo il codice sorgente e gli script di pacchettizzazione?
Il progetto è pubblicato su github.com/giuxlab-hub/gx-spectra-library, con i pacchetti Debian, l’archivio dei sorgenti e le somme di controllo nella pagina Releases. Il pacchetto Debian si genera con packaging/build_deb.py; le traduzioni si modificano nei file GNU gettext .po in locale/.
Metodo di documentazione: schermate catturate direttamente dal desktop X11 fisico (DISPLAY=:0) su cui girava la versione in pacchetto Debian di GX Spectra Library in inglese, non una ricostruzione senza schermo né un’interfaccia simulata. Ricerche nelle fonti, download JCAMP, esportazioni CSV e ZIP e il viaggio di andata e ritorno del CSV sono stati eseguiti e controllati. Il catalogo dimostrativo è stato isolato di proposito.
GX Spectra Library · Guida pratica · 1º novembre 2026 (originale in inglese)
Download: gli script dei riquadri
L’archivio gx-spectra-library-script-giuxlab.zip contiene i quattro script presentati nei riquadri (catalogue_audit.py, verify_zip.py, ir_bands.py, roundtrip_check.py), un README con le istruzioni e le somme SHA-256 e la licenza GNU GPL v3. Usano solo la libreria standard di Python 3, tranne roundtrip_check.py, che usa il lettore del programma (dal sorgente su GitHub). Non contiene spettri.
Collegamenti: scheda software di GX Spectra Library · repository GitHub · pacchetti Debian e somme di controllo · NIST Chemistry WebBook · nmrshiftdb2.