
Lezione 07 — Creare e pubblicare Dataset scientifici
Dai vettori numerici ai dati scientifici riutilizzabili: sinusoidi, metadati, API pubbliche e pubblicazione atomica.
Nelle lezioni precedenti abbiamo imparato a scrivere programmi GNU Octave, a riconoscere i Dataset di GX-TXT e a leggere le loro variabili mediante identificativi stabili. Adesso percorriamo la strada inversa: partiamo da un modello matematico, generiamo i valori in Octave e pubblichiamo i risultati come Dataset canonici di GX-TXT.
Questo passaggio introduce un concetto importante della programmazione scientifica: produrre un array di numeri non equivale a produrre un Dataset. Un Dataset contiene anche informazioni su ciò che quei numeri rappresentano, sulle unità, sulla loro provenienza e sulla struttura delle variabili. GX-TXT si occupa inoltre della registrazione e della gestione dello storage.
Realizzeremo due esercizi progressivi:
- Una sinusoide di tensione con offset, pubblicata come singolo Dataset.
- Tre segnali correlati — puro, rumoroso e con terza armonica — pubblicati in una sola transazione atomica.
Gli esempi sono interamente sintetici, quindi non occorrono misure o file di ingresso. Il codice degli script è in inglese, mentre in questo articolo ne analizziamo il funzionamento in italiano.
1. Che cosa impariamo di nuovo rispetto alle lezioni precedenti
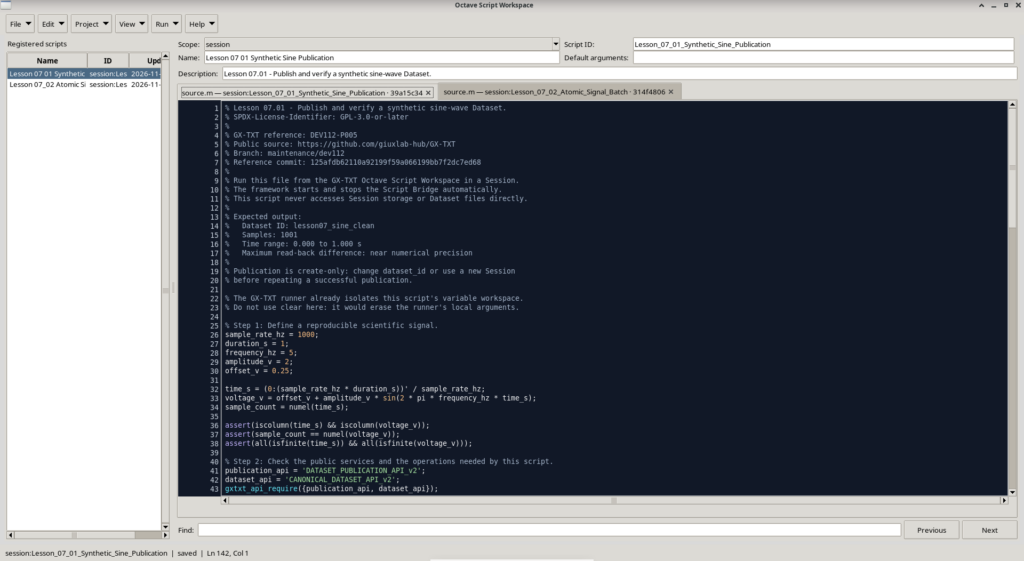
Le lezioni 01–04 hanno introdotto variabili, operatori, vettori, matrici, cicli e funzioni. La Lezione 05 si è concentrata sull’identità di Dataset e Variable ID, mentre la 06 ha mostrato come leggere dati scientifici tramite le API pubbliche.
In questa lezione non ripetiamo da zero la sintassi già introdotta: la utilizziamo per costruire qualcosa di nuovo.
| Concetto | Già conosciuto | Novità di questa lezione |
|---|---|---|
| Vettori | Creazione e operazioni numeriche | Costruzione rigorosa di un asse temporale campionato |
| Operazioni elemento per elemento | Operatori e funzioni Octave | Generazione di segnali fisicamente interpretabili |
for e if | Controllo del flusso | Preparazione sistematica di richieste e controlli di pubblicazione |
struct | Lettura di metadati | Costruzione di descrittori scientifici e richieste annidate |
| Cell array | Collezioni e argomenti del Bridge | Raccolta di più richieste di pubblicazione in un batch |
| Dataset ID e Variable ID | Identità e ispezione | Scelta degli ID di nuovi risultati scientifici |
| Lettura dei Dataset | API canoniche | Verifica dei nuovi risultati e distinzione tra lettura e scrittura |
| Elaborazione numerica | Funzioni native Octave | Confronto con le funzioni pubbliche di NUMERIC_API_v1 |
| Pubblicazione | Non ancora affrontata | publish_series, publish_series_batch e atomicità |
La questione principale diventa: come trasformare dati calcolati in risultati scientifici formalmente descritti e disponibili nella Session?
2. Che cosa significa pubblicare un Dataset
Consideriamo due vettori:
time_s = [0; 0.1; 0.2; 0.3];
voltage_v = [0; 1; 0; -1];
In memoria, Octave conosce quattro numeri per ciascuna variabile. I nomi ci suggeriscono che si tratti di tempo e tensione, ma i suffissi _s e _v non attivano automaticamente un sistema di unità fisiche.
Un Dataset scientifico deve invece dichiarare esplicitamente almeno le informazioni necessarie a interpretare i numeri. Nei nostri esempi avrà questa struttura logica:
Dataset: lesson07_sine_clean
│
├── Variable ID: time_s
│   ├── Name: time_s
│   ├── Display label: Elapsed time
│   ├── Unit: s
│   ├── Data type: float64
│   └── Semantic role: time
│
├── Variable ID: voltage_v
│   ├── Name: voltage_v
│   ├── Display label: Simulated voltage
│   ├── Unit: V
│   ├── Data type: float64
│   └── Semantic role: voltage
│
└── Structured metadata
    ├── Model
    ├── Frequency
    ├── Amplitude
    ├── Offset
    └── Sample rate
Abbiamo già incontrato la coppia Dataset ID + Variable ID nella Lezione 05. Ora impariamo a definirla noi stessi.
L’ID di un Dataset non è un nome di file e il Variable ID non è il numero di una colonna CSV. Questa separazione permette al framework di usare storage diversi, come CSV o HDF5, senza cambiare il significato scientifico degli identificativi.
3. Primo esperimento: una sinusoide con offset
Lo script Lesson_07_01_Synthetic_Sine_Publication.m genera una tensione definita da:
I parametri sono:
| Grandezza | Simbolo | Valore |
|---|---|---|
| Offset di tensione | \(U_0\) | 0,25 V |
| Ampiezza di picco | \(A\) | 2 V |
| Frequenza del segnale | \(f\) | 5 Hz |
| Frequenza di campionamento | \(f_s\) | 1000 Hz |
| Durata | \(T\) | 1 s |
Ne risulta una sinusoide con minimo −1,75 V e massimo +2,25 V.
3.1 Parametri: assegnazione, nomi e unità
sample_rate_hz = 1000;
duration_s = 1;
frequency_hz = 5;
amplitude_v = 2;
offset_v = 0.25;
Ogni istruzione associa un valore numerico a una variabile. Il punto e virgola evita la stampa automatica del risultato: quando il programma termina, potremo presentare solo un riepilogo significativo.
La frequenza del segnale non va confusa con la frequenza di campionamento. La prima indica quante oscillazioni si verificano in un secondo; la seconda quanti valori calcoliamo nello stesso intervallo.
A 5 Hz il periodo è:
Con campionamento a 1000 Hz, durante un periodo vengono rappresentati 200 intervalli di campionamento. La frequenza di Nyquist è 500 Hz, ampiamente superiore alla frequenza del segnale. Questo non costituisce una garanzia generale di accuratezza per qualunque segnale, ma chiarisce perché la nostra sinusoide è campionata con una risoluzione adeguata.
3.2 L’asse temporale: capire l’operatore :
time_s = (0:(sample_rate_hz * duration_s))' / sample_rate_hz;Questa riga merita di essere letta per intero, anziché copiarla meccanicamente.
1. Calcolo dell’ultimo indice. Il prodotto sample_rate_hz * duration_s vale 1000.
2. Generazione degli indici. 0:1000 produce gli interi da 0 a 1000, estremi compresi. Il risultato ha 1001 elementi.
3. Trasposizione. L’apostrofo ' trasforma il vettore riga in un vettore colonna. Su dati reali la trasposizione coniugata coincide con quella ordinaria; per dati complessi, invece, ' e .' non sono intercambiabili.
4. Conversione in secondi. Ogni indice viene diviso per la frequenza di campionamento:
Il passo temporale è \(\Delta t=1/f_s=0{,}001\ \mathrm{s}\). Gli estremi sono 0 e 1 s.
Perché otteniamo 1001 campioni e non 1000? Perché includiamo sia il punto iniziale sia quello finale. Quando \(f_sT\) è intero, il numero di punti è \(N=f_sT+1\). In altri esperimenti si potrebbe scegliere una griglia che esclude l’estremo finale: non è un errore, ma una diversa definizione del campionamento.
3.3 Calcolo vettoriale: una funzione su molti valori
voltage_v = offset_v + amplitude_v * ...
            sin(2 * pi * frequency_hz * time_s);
sample_count = numel(time_s);
La funzione sin() di GNU Octave si applica a tutti gli elementi del vettore. Non è necessario un ciclo che calcoli una tensione per volta.
Per ogni elemento \(t_k\), viene prima costruita la fase \(2\pi f t_k\), poi se ne calcola il seno, si moltiplica per l’ampiezza e infine si aggiunge l’offset.
Notare che il seno riceve una fase espressa in radianti, una quantità adimensionale. Non riceve direttamente secondi o hertz: il loro prodotto genera l’argomento corretto.
La funzione numel() restituisce il numero totale di elementi. È diversa da length(), che restituisce la dimensione maggiore, e da size(), che descrive le dimensioni dell’array. Qui i tre concetti sono semplici perché lavoriamo con un vettore colonna; su matrici o array multidimensionali la differenza diventa importante.
3.4 I controlli prima di pubblicare
assert(iscolumn(time_s) && iscolumn(voltage_v));
assert(sample_count == numel(voltage_v));
assert(all(isfinite(time_s)) && all(isfinite(voltage_v)));
Tre proprietà vengono controllate prima della pubblicazione:
- Forma: entrambi gli array devono essere vettori colonna.
- Coerenza: tempo e tensione devono avere lo stesso numero di campioni.
- Validità numerica: ogni valore deve essere finito, quindi non NaN né infinito.
L’operatore && è una congiunzione logica fra condizioni scalari. all(isfinite(...)) trasforma il controllo su tutti gli elementi in un singolo risultato logico.
assert() arresta l’esecuzione quando una condizione non è soddisfatta. È opportuno individuare un problema sui dati prima di richiedere al framework di pubblicarli.
4. Le funzioni numeriche: Octave nativo e API pubbliche GX-TXT
Il primo script esegue i calcoli con sin() e con gli operatori numerici nativi di Octave. Questo è perfettamente normale: usare GX-TXT non significa rinunciare al linguaggio Octave.
Esiste però anche una API numerica pubblica del framework, NUMERIC_API_v1, che offre operazioni su scalari, vettori e matrici. È importante conoscerla, distinguendola dalle funzioni native.
4.1 Quali operazioni GX-TXT corrispondono ai nostri calcoli?
| Calcolo | GNU Octave | API GX-TXT |
|---|---|---|
| Seno elemento per elemento | sin(v) | array_unary con sin |
| Moltiplicazione per uno scalare | v * A | array_binary con multiply |
| Somma di un offset | v + U0 | array_binary con add |
| Minimo e massimo | min(v), max(v) | array_reduce con minimum, maximum |
| Valore medio | mean(v) | array_reduce con mean |
| Valore RMS | sqrt(mean(v.^2)) | array_reduce con rms |
I nomi array_unary, array_binary e array_reduce sono operazioni del servizio numerico, non funzioni Tcl private da richiamare direttamente.
4.2 Come si rappresenta un operando numerico
L’API numerica non richiede soltanto un numero: la chiamata attraverso il Bridge usa una struttura che dichiara la forma dell’operando.
phase = 2 * pi * frequency_hz * time_s;

phase_operand = struct( ...
    'kind', 'vector', ...
    'value', phase);
Il campo kind distingue scalar, vector e matrix. Il campo value contiene i dati numerici. Si tratta di una struttura Octave, non di una copia del Dataset sul disco.
La stessa costruzione si può usare per uno scalare:
gain_operand = struct('kind', 'scalar', 'value', amplitude_v);Questa esplicitazione consente all’API di verificare tipi, forme e compatibilità degli operandi. Le operazioni binarie possono espandere uno scalare su un vettore; due array non scalari devono avere forme compatibili secondo il contratto dell’operazione.
4.3 array_unary: calcolo del seno con GX-TXT
gxtxt_api_require({'NUMERIC_API_v1'});

sine_result = gxtxt_api_call( ...
    'NUMERIC_API_v1', ...
    'array_unary', ...
    {'sin', phase_operand});

sine_values = sine_result.values;
Spieghiamo ogni componente:
gxtxt_api_require()verifica che l’API richiesta sia disponibile nel contesto di esecuzione.gxtxt_api_call()è la funzione generale dell’Octave Script Bridge.'NUMERIC_API_v1'identifica il servizio pubblico da chiamare.'array_unary'identifica l’operazione su un solo operando.{'sin', phase_operand}è la cell array degli argomenti posizionali: il nome dell’operazione matematica e il descrittore dell’operando.sine_result.valuesestrae il vettore restituito dalla struttura-risultato.
Le parentesi graffe non indicano un vettore numerico: costruiscono una cell array. Questa distinzione, già introdotta nelle lezioni precedenti, è particolarmente importante nel Bridge perché la funzione riceve una collezione ordinata di argomenti.
4.4 array_binary: ampiezza e offset
Possiamo completare la sinusoide usando due operazioni binarie pubbliche.
gain_result = gxtxt_api_call( ...
    'NUMERIC_API_v1', ...
    'array_binary', ...
    {'multiply', ...
     struct('kind', 'vector', 'value', sine_values), ...
     struct('kind', 'scalar', 'value', amplitude_v)});

voltage_result = gxtxt_api_call( ...
    'NUMERIC_API_v1', ...
    'array_binary', ...
    {'add', ...
     struct('kind', 'vector', 'value', gain_result.values), ...
     struct('kind', 'scalar', 'value', offset_v)});

voltage_from_gxtxt = voltage_result.values;
multiply applica la moltiplicazione elemento per elemento e add applica la somma. Poiché un operando è scalare e l’altro è vettoriale, lo scalare viene utilizzato per ogni elemento del vettore.
Questo esempio mostra che possiamo ottenere la stessa espressione matematica sia con le istruzioni Octave sia tramite NUMERIC_API_v1.
Gli script principali della lezione usano le funzioni native di Octave per produrre i segnali. Le chiamate qui illustrate servono a conoscere la superficie numerica pubblica equivalente, senza cambiare l’esperimento.
4.5 array_reduce: dal vettore a un risultato riassuntivo
operand = struct('kind', 'vector', 'value', voltage_v);

minimum_result = gxtxt_api_call( ...
    'NUMERIC_API_v1', 'array_reduce', {'minimum', operand});

maximum_result = gxtxt_api_call( ...
    'NUMERIC_API_v1', 'array_reduce', {'maximum', operand});

rms_result = gxtxt_api_call( ...
    'NUMERIC_API_v1', 'array_reduce', {'rms', operand});

minimum_v = minimum_result.values;
maximum_v = maximum_result.values;
rms_v = rms_result.values;
Una riduzione trasforma una collezione di campioni in uno o più valori riassuntivi, secondo l’asse e l’operazione richiesti. Per un semplice vettore la riduzione globale fornisce un singolo valore.
Il valore RMS è:
Attenzione a non confondere RMS e deviazione standard. Nel nostro primo segnale è presente un offset; la componente continua partecipa al valore RMS ma non rappresenta una fluttuazione attorno alla media.
Le operazioni array_unary, array_binary e array_reduce non attribuiscono automaticamente unità fisiche ai vettori e non eseguono conversioni implicite di unità. La coerenza dimensionale è responsabilità di chi costruisce il calcolo; nella pubblicazione le unità vengono dichiarate esplicitamente nei descrittori delle variabili.
Anche i valori non finiti e i risultati fuori dal dominio reale sono oggetto dei controlli previsti dal contratto numerico. Questa è una delle ragioni per conoscere le API pubbliche, oltre alla semplice disponibilità delle stesse operazioni in Octave.
5. Dichiarare lo schema delle variabili
Dopo il calcolo arriviamo al primo vero compito di pubblicazione: spiegare a GX-TXT che cosa contengono i vettori.
5.1 struct(): costruire un descrittore scientifico
x_variable = struct( ...
    'variable_id', 'time_s', ...
    'name', 'time_s', ...
    'display_label', 'Elapsed time', ...
    'unit', 's', ...
    'dtype', 'float64', ...
    'value_kind', 'number', ...
    'semantic_role', 'time', ...
    'semantic_source', 'generator');
La funzione struct() costruisce una struttura con coppie nome del campo / valore. È simile ai record che abbiamo già letto attraverso le API nella Lezione 05, ma questa volta siamo noi a produrre il descrittore.
| Campo | Significato |
|---|---|
variable_id | Identificativo stabile della variabile all’interno del Dataset |
name | Nome scientifico dichiarato |
display_label | Etichetta leggibile dall’utente |
unit | Unità fisica dichiarata |
dtype | Tipo degli elementi, qui float64 |
value_kind | Natura del valore, qui number |
semantic_role | Significato scientifico della variabile |
semantic_source | Origine della dichiarazione semantica |
dtype e value_kind non sono sinonimi. Il primo descrive come viene rappresentato il dato, il secondo che tipo di valore rappresenta. Il contratto della pubblicazione accetta per value_kind i valori number, text e elapsed_time. Nel nostro caso il tempo è già un numero espresso in secondi: number è appropriato, mentre elapsed_time ha un contratto specifico per il formato HMS.
semantic_source = 'generator' indica che la dichiarazione del significato proviene dal generatore. Non è una dichiarazione di misura sperimentale, e non trasforma i numeri simulati in dati acquisiti.
La seconda variabile segue la stessa logica:
y_variable = struct( ...
    'variable_id', 'voltage_v', ...
    'name', 'voltage_v', ...
    'display_label', 'Simulated voltage', ...
    'unit', 'V', ...
    'dtype', 'float64', ...
    'value_kind', 'number', ...
    'semantic_role', 'voltage', ...
    'semantic_source', 'generator');
Notare che la coppia time_s / voltage_v è comprensibile senza conoscere il software con cui è stato prodotto il segnale.
5.2 Metadati strutturati: conservare il contesto del calcolo
metadata = struct();
metadata.('simulation.model') = 'offset sine wave';
metadata.('simulation.frequency_hz') = frequency_hz;
metadata.('simulation.amplitude_v') = amplitude_v;
metadata.('simulation.offset_v') = offset_v;
metadata.('simulation.sample_rate_hz') = sample_rate_hz;
La novità sintattica è metadata.('simulation.frequency_hz'): si tratta dell’accesso a un campo con nome dinamico, racchiuso tra parentesi tonde e apostrofi.
Non possiamo scrivere metadata.simulation.frequency_hz aspettandoci lo stesso risultato: quest’ultima sintassi rappresenterebbe due livelli di struttura annidata, mentre simulation.frequency_hz è una singola chiave contenente un punto. È una differenza importante quando le API e i registri usano metadati con chiavi qualificate.
Questi metadati non sono una decorazione. Conservano le condizioni necessarie a interpretare e riprodurre il modello: frequenza, ampiezza, offset e campionamento.
Una sinusoide generata a 5 Hz e una generata a 50 Hz potrebbero avere lo stesso numero di campioni. Senza metadati, perdere la distinzione sarebbe facile.
6. Creare la richiesta di pubblicazione
Ora riuniamo dati, descrittori e metadati in un’unica struttura Octave, che verrà consegnata al servizio pubblico.
request = struct( ...
    'dataset_id', dataset_id, ...
    'contract', 'table.generic', ...
    'storage', 'auto', ...
    'x_values', time_s, ...
    'y_values', voltage_v, ...
    'x_variable', x_variable, ...
    'y_variable', y_variable, ...
    'producer_version', '1.0.0', ...
    'source', 'GNU Octave synthetic signal generator', ...
    'provenance', 'Deterministic 5 Hz offset sine wave', ...
    'notes', 'GNU Octave with GX-TXT, Lesson 07.01', ...
    'structured_metadata', metadata);
Qui compaiono diverse idee nuove.
Strutture annidate. I campi x_variable e y_variable contengono a loro volta due strutture. structured_metadata contiene un’altra struttura. Octave permette di creare facilmente questo insieme di informazioni senza introdurre classi o formati di serializzazione personali.
Contratto table.generic. Dichiara il contratto scientifico generale del Dataset tabellare. Non è il nome di un file e non impone direttamente un provider fisico.
storage = 'auto'. Chiede a GX-TXT di scegliere uno storage adatto attraverso la propria politica. Il chiamante non deve selezionare un percorso né scrivere personalmente CSV o HDF5.
Origine e provenienza. source, provenance, producer_version e notes forniscono ulteriori elementi di contesto. Sono differenti dagli ID: descrivono il risultato, non ne determinano l’identità.
Questa è la differenza fra un programma che salva due colonne in un file e un programma che pubblica un risultato scientifico gestito dal framework.
7. La prima API di scrittura: publish_series
Il punto centrale del primo script è la chiamata:
receipt = gxtxt_api_call( ...
    'DATASET_PUBLICATION_API_v2', ...
    'publish_series', ...
    {request});
7.1 Scopo e sintassi
| Elemento | Ruolo |
|---|---|
DATASET_PUBLICATION_API_v2 | Identificativo della API pubblica di pubblicazione |
publish_series | Operazione per pubblicare una serie X/Y monodimensionale |
{request} | Cell array con un solo argomento posizionale, la struttura richiesta |
receipt | Struttura restituita con l’esito della pubblicazione |
publish_series richiede, nella struttura, un dataset_id, un contract, due array X/Y non vuoti e della stessa lunghezza e due descrittori di variabile con variable_id distinti.
Il servizio si occupa della sequenza di preparazione, dichiarazione delle variabili, scrittura e finalizzazione. Le condizioni di validità vengono controllate dalle componenti pubbliche proprietarie del Dataset.
7.2 Che cosa significa finalizzare
Durante la pubblicazione non basta scrivere un array: deve essere prodotto un Dataset coerente. Il framework gestisce l’operazione di commit e la registrazione nel catalogo della Session.
Un fallimento durante la pubblicazione deve impedire che nel catalogo rimanga un nuovo Dataset incompleto. Dopo una pubblicazione riuscita, invece, il Dataset diventa una risorsa effettivamente registrata.
La modalità normale dell’esempio è create-only: se l’ID è già occupato, non sovrascriviamo silenziosamente dati esistenti.
Per questa ragione lo script controlla prima il catalogo:
existing_ids = gxtxt_api_call( ...
    'CANONICAL_DATASET_API_v2', 'list', {});

if any(strcmp(existing_ids, dataset_id))
  error('Dataset already exists');
endif
strcmp() confronta stringhe; any() verifica se almeno un confronto è vero. Si tratta di un controllo preventivo utile per fornire un messaggio chiaro, mentre l’autorità definitiva sulla presenza dell’ID e sulla pubblicazione resta a GX-TXT.
7.3 Che cosa fa il Bridge
Abbiamo già utilizzato gxtxt_api_call() per leggere Dataset. Ora la stessa funzione permette di invocare un’operazione di scrittura autorizzata.
Il Bridge non è un esecutore generico di comandi Tcl e non espone automaticamente tutti i metodi interni del CORE. La chiamata è ammessa solo quando l’API e l’operazione risultano registrate per l’uso da script.
Per questo, all’inizio degli script troviamo:
publication_api = 'DATASET_PUBLICATION_API_v2';
dataset_api = 'CANONICAL_DATASET_API_v2';

gxtxt_api_require({publication_api, dataset_api});

if !gxtxt_api_has_operation(publication_api, 'publish_series')
  error('Publication operation unavailable');
endif
gxtxt_api_require() dichiara i servizi necessari; gxtxt_api_has_operation() controlla che sia disponibile proprio l’operazione richiesta, non semplicemente il nome dell’API.
8. Risultato del primo esperimento
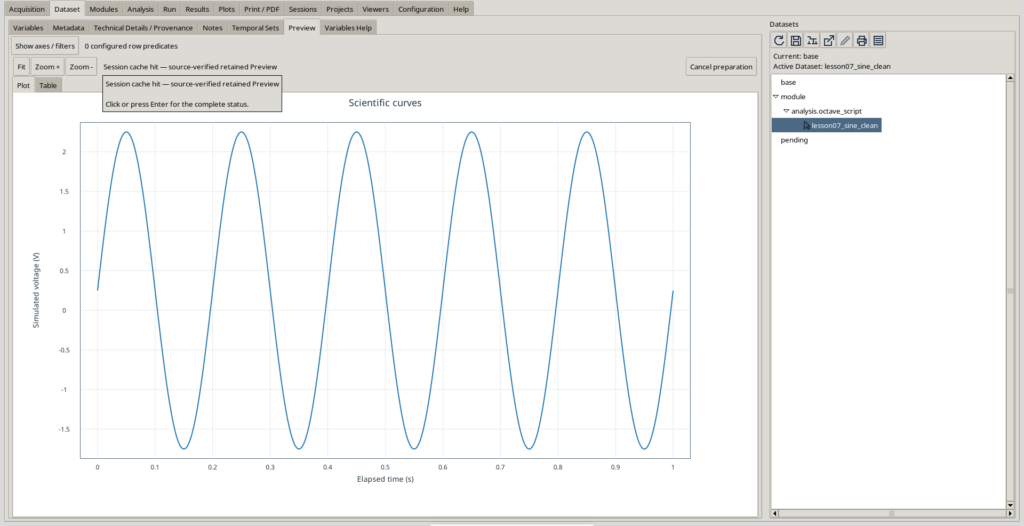
Il Dataset pubblicato porta l’ID lesson07_sine_clean. Contiene 1001 campioni e l’intervallo temporale da 0 a 1 secondo. I valori di tensione vanno da −1,75 V a +2,25 V.
Lo script originale effettua anche una lettura canonica usando CANONICAL_DATASET_API_v2/read_range e confronta i numeri con i vettori iniziali. Questa operazione riprende il metodo della Lezione 06: read_range riceve l’ID del Dataset, una cell array di Variable ID, l’indice iniziale a base zero e il numero di campioni.
Nella pratica quotidiana, dopo la pubblicazione possiamo semplicemente aprire il Dataset nella scheda Dataset di GX-TXT e utilizzare Preview per ispezionare la curva e i metadati. Non occorre creare un secondo script soltanto per visualizzare ciò che il framework già offre.
9. Secondo esperimento: tre segnali sintetici
Con il secondo script, Lesson_07_02_Atomic_Signal_Batch.m, sfruttiamo ciò che abbiamo imparato per creare più Dataset in un’unica operazione.
Usiamo una sinusoide fondamentale di 5 Hz, ampiezza 1,5 V, durata 2 s e frequenza di campionamento 400 Hz.
L’asse contiene \(400\times 2+1=801\) punti. Il passo temporale è 2,5 ms e ogni periodo di 0,2 s occupa 80 intervalli di campionamento.
9.1 I tre modelli matematici
La sinusoide pura è:
Il secondo segnale aggiunge rumore gaussiano sintetico:
Il terzo aggiunge una terza armonica:
La terza armonica ha frequenza tripla rispetto alla fondamentale e ampiezza pari al 30% di quella fondamentale. Non è rumore casuale: è una componente deterministica che modifica in modo sistematico la forma del segnale.
9.2 Il generatore pseudocasuale: rng() e randn()
rng(707, 'twister');

pure_v = amplitude_v * ...
    sin(2 * pi * frequency_hz * time_s);

noisy_v = pure_v + ...
    noise_standard_deviation_v * randn(sample_count, 1);
randn(sample_count, 1) produce un vettore colonna di campioni pseudocasuali con distribuzione normale standard, cioè media teorica zero e deviazione standard teorica uno. La moltiplicazione per 0,2 trasforma la dispersione teorica in 0,2 V.
Il numero 707 è il seme del generatore. rng(707, 'twister') imposta lo stato iniziale di una specifica famiglia di generatori pseudocasuali. Fissando algoritmo, seme e ambiente compatibile, è possibile ripetere la sequenza. È un elemento di riproducibilità del modello, non una simulazione delle proprietà di un particolare oscilloscopio.
Una realizzazione finita di rumore non avrà necessariamente media campionaria esattamente zero o deviazione standard misurata esattamente 0,2 V: questi sono i parametri della distribuzione utilizzata per generare i dati.
Esiste una funzione equivalente in GX-TXT? Il framework espone diverse operazioni numeriche pubbliche, incluse funzioni di riduzione e primitive di ricampionamento, ma non va confuso il ricampionamento di indici con la generazione di un vettore di rumore normale indipendente. In questa esercitazione randn() è la funzione nativa appropriata di Octave; NUMERIC_API_v1 resta disponibile per ulteriori operazioni di analisi sui vettori.
9.3 La terza armonica e l’operatore vettoriale
harmonic_v = pure_v + ...
    third_harmonic_amplitude_v * ...
    sin(2 * pi * (3 * frequency_hz) * time_s);
Abbiamo una somma di due vettori della stessa dimensione. Il primo è la fondamentale, il secondo l’armonica a 15 Hz.
Questa costruzione illustra un altro principio: segnali che condividono lo stesso asse temporale possono essere confrontati campione per campione. Non dovremmo invece sommare direttamente campioni di griglie temporali incompatibili senza prima definire esplicitamente un criterio di allineamento o ricampionamento.
10. Una nuova applicazione delle cell array
signal_values = {pure_v, noisy_v, harmonic_v};

dataset_ids = {'lesson07_sine_pure', ...
               'lesson07_sine_noisy', ...
               'lesson07_sine_harmonic'};
Abbiamo due cell array parallele:
signal_valuesconserva tre vettori numerici.dataset_idsconserva tre identificativi testuali.
Il primo elemento di entrambe si riferisce alla sinusoide pura, il secondo a quella rumorosa, il terzo a quella armonica.
Per accedere al contenuto di una cella usiamo le parentesi graffe:
first_signal = signal_values{1};
first_id = dataset_ids{1};
signal_values(1) restituirebbe invece una cell array con una sola cella. La distinzione è essenziale quando si passa il contenuto alla richiesta di pubblicazione.
10.1 Preallocazione e ciclo di costruzione
series_requests = cell(1, numel(dataset_ids));

for k = 1:numel(dataset_ids)
  metadata = struct();
  metadata.('simulation.model') = model_labels{k};

  series_requests{k} = struct( ...
      'dataset_id', dataset_ids{k}, ...
      'contract', 'table.generic', ...
      'storage', 'auto', ...
      'x_values', time_s, ...
      'y_values', signal_values{k}, ...
      'x_variable', time_variable, ...
      'y_variable', voltage_variable, ...
      'structured_metadata', metadata);
endfor
Questo blocco è una versione ridotta di quello presente nello script completo, che include anche ulteriori campi di provenienza e i parametri del modello.
Preallocare con cell(1, numel(dataset_ids)) riserva una collezione di tre celle prima del ciclo. Per ogni indice k il programma costruisce la struttura di pubblicazione del segnale corrispondente.
La scelta del ciclo non serve a sostituire la vettorizzazione del calcolo numerico: serve a produrre tre descrittori strutturati simili ma distinti, una situazione nella quale un ciclo è naturale.
Ciascuna struttura include:
- Un Dataset ID diverso.
- Un asse temporale comune.
- Un vettore di tensione differente.
- Gli stessi identificativi interni
time_sevoltage_v, validi all’interno di Dataset diversi. - Metadati specifici del modello.
Due Dataset distinti possono quindi contenere entrambi una variabile chiamata voltage_v: è la coppia con il Dataset ID a renderne univoca l’identità.
11. Pubblicazione atomica: publish_series_batch
Ecco la novità maggiore del secondo esperimento.
Potremmo chiamare tre volte publish_series. Se la prima e la seconda pubblicazione riuscissero e la terza fallisse, ci ritroveremmo con due Dataset nuovi ma non con il terzo. Il risultato non corrisponderebbe più all’insieme completo che volevamo pubblicare.
Per evitare questa situazione GX-TXT offre publish_series_batch, che coordina una pubblicazione create-only di più serie X/Y dentro un’unica transazione.
11.1 Preparazione della richiesta
batch_request = struct();
batch_request.series = series_requests;
La struttura ha un solo campo, series, il cui valore è la cell array delle tre richieste preparate in precedenza.
11.2 La chiamata al framework
receipt = gxtxt_api_call( ...
    'DATASET_PUBLICATION_API_v2', ...
    'publish_series_batch', ...
    {batch_request});
L’API riceve un singolo argomento posizionale, costituito dalla struttura batch_request.
La ricevuta contiene informazioni come:
| Campo | Significato |
|---|---|
atomic | Conferma del carattere atomico della pubblicazione |
output_count | Numero di Dataset prodotti |
dataset_ids | Identificativi degli output |
datasets | Ricevute delle singole pubblicazioni |
Lo script controlla la ricevuta:
if !receipt.atomic || ...
   receipt.output_count != numel(dataset_ids)
  error('Unexpected batch publication result');
endif
L’operatore ! rappresenta la negazione logica, mentre || è l’OR logico. La condizione genera un errore se la ricevuta non conferma quanto richiesto.
11.3 Che cosa significa atomicità
Una transazione atomica segue il principio tutto oppure niente: gli output nuovi appartengono allo stesso insieme di pubblicazione. La gestione dei commit e dell’eventuale rollback è responsabilità di GX-TXT, non dello script Octave.
Nel nostro caso il risultato è una collezione di tre Dataset distinti, non un unico Dataset con tre colonne e nemmeno automaticamente un Dataset Group. Questa distinzione va mantenuta anche quando osserviamo i risultati nella Session.
Il contratto esclude la sovrascrittura accidentale: un batch di creazione che incontra identificativi già registrati viene respinto. Se si desidera ripetere l’esperimento pubblicando altri risultati, si devono usare nuovi ID o una nuova Session.
Questa API è particolarmente utile quando i risultati hanno un significato congiunto, per esempio tre condizioni di un esperimento, più repliche o i segnali elaborati di una stessa simulazione.
12. Interpretare le tre Preview
Il secondo esercizio pubblica tre Dataset, ciascuno con 801 campioni e due variabili.
| Dataset ID | Segnale | Caratteristica principale |
|---|---|---|
lesson07_sine_pure | Sinusoide a 5 Hz | Forma periodica regolare |
lesson07_sine_noisy | Sinusoide più rumore normale | Fluttuazioni casuali attorno alla fondamentale |
lesson07_sine_harmonic | Fondamentale più terza armonica | Deformazione periodica deterministica |
Nella Preview del segnale puro appare un andamento regolare. In quello rumoroso la curva è perturbata dai campioni pseudocasuali. Nel terzo, pur essendo il segnale perfettamente deterministico, la forma non è più una sinusoide semplice perché vengono sommate due frequenze.
Sono tre fenomeni matematici diversi: segnale ideale, perturbazione casuale e distorsione armonica. È opportuno non descrivere genericamente tutte le differenze come “rumore”.
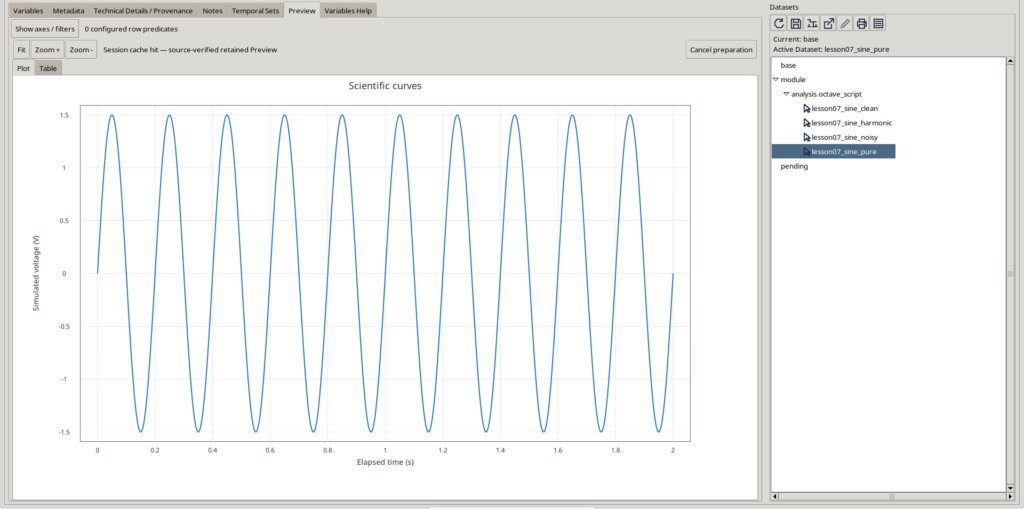
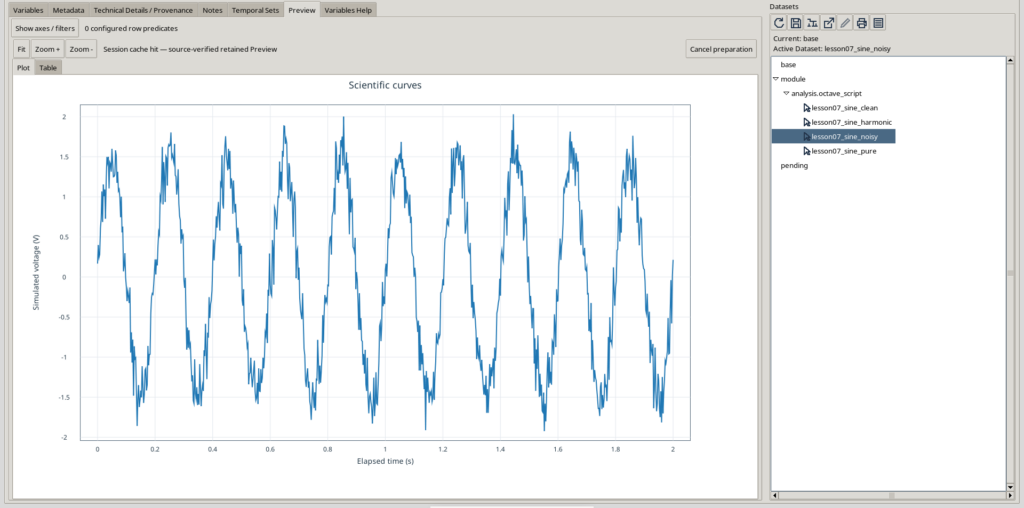
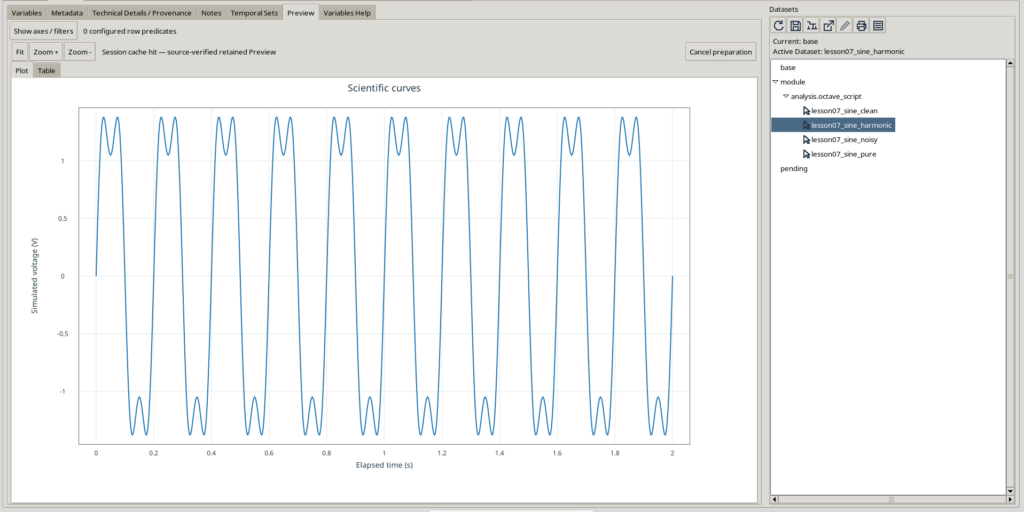
Tre segnali sintetici pubblicati in modo atomico come Dataset separati. L’asse temporale e lo schema delle variabili sono comuni; cambia il modello numerico della tensione.
La Preview è uno strumento di ispezione dei dati già pubblicati. In questa lezione non generiamo immagini attraverso le normali funzioni di plotting di Octave: la visualizzazione e la costruzione di grafici scientifici strutturati con le API di GX-TXT saranno approfondite nella lezione successiva.
13. Riepilogo delle API pubbliche utilizzate e disponibili
Per orientarsi è utile distinguere tre gruppi di API.
A. Octave Script Bridge API v1
| Funzione | Argomenti | Scopo |
|---|---|---|
gxtxt_api_require() | Cell array di requisiti | Verifica le dipendenze pubbliche necessarie |
gxtxt_api_has_operation() | API ID e nome operazione | Controlla la disponibilità di una funzione specifica |
gxtxt_api_call() | API ID, operazione, cell array degli argomenti | Invoca un’operazione pubblica registrata |
Il Bridge è il punto di accesso comune. Il programma utente non deve avviarlo o arrestarlo manualmente: il ciclo di esecuzione è gestito da GX-TXT.
B. Dataset Publication API v2 e Canonical Dataset API v2
| API / operazione | Scopo |
|---|---|
DATASET_PUBLICATION_API_v2 / publish_series | Pubblica una singola serie X/Y con schema e metadati |
DATASET_PUBLICATION_API_v2 / publish_series_batch | Pubblica in modo atomico più serie X/Y come Dataset distinti |
CANONICAL_DATASET_API_v2 / list | Elenca gli ID presenti nella Session |
CANONICAL_DATASET_API_v2 / describe | Restituisce descrizione e variabili del Dataset |
CANONICAL_DATASET_API_v2 / read_range | Legge una finestra di valori tramite Variable ID e indici logici |
C. Numeric API v1
| Operazione | Scopo |
|---|---|
array_unary | Trasforma un array applicando, per esempio, seno o radice quadrata |
array_binary | Combina due operandi con somme, prodotti e altre operazioni |
array_reduce | Calcola statistiche descrittive e valori riassuntivi |
Gli esempi della sezione 4 mostrano come usare anche la Numeric API pubblica per i calcoli che gli script principali svolgono in Octave nativo. La scelta tra le due strade dipende dall’obiettivo: imparare il linguaggio, utilizzare contratti numerici condivisi del framework o comporre elaborazioni di maggiore complessità.
In ogni caso rimane fermo un principio: l’accesso e la pubblicazione dei Dataset devono passare per le API canoniche del framework, senza manipolare i file interni della Session.
14. Esperimenti da svolgere autonomamente
Dopo aver compreso i due script, possiamo modificarne i parametri e prevedere i risultati prima di eseguirli.
- Frequenza e numero di periodi. Nel primo esperimento cambiare
frequency_hzda 5 a 8, mantenendo invariati campionamento e durata. Quanti periodi compariranno tra 0 e 1 s? Il numero di campioni cambierà? Perché? - Offset. Sostituire
offset_v = 0.25conoffset_v = -1. Determinare teoricamente minimo, massimo e valore medio della sinusoide prima della pubblicazione. - Campionamento. Nel secondo script portare
sample_rate_hza 800 Hz. Quanti campioni verranno generati in 2 s? Che cosa cambia nella Preview e che cosa rimane fisicamente invariato? - Rumore. Cambiare la deviazione standard nominale da 0,20 V a 0,05 V. Con lo stesso seme, che relazione rimane fra le sequenze di rumore? Come cambia il rapporto fra ampiezza del segnale e rumore?
- Armoniche. Portare l’ampiezza della terza armonica a zero, poi a 0,75 V. Che differenza c’è fra deformazione armonica e perturbazione casuale?
- Strutture. Aggiungere un metadato
simulation.duration_sa tutte le richieste del batch. Individuare il punto del ciclo in cui conviene farlo. - API numeriche. Calcolare con
NUMERIC_API_v1 / array_reduceil minimo, il massimo e l’RMS dei tre vettori. Confrontare i risultati conmin(),max()e l’espressione nativasqrt(mean(v.^2)).
Ogni variante destinata a essere pubblicata deve utilizzare nuovi Dataset ID oppure una Session dedicata. Non sovrascriviamo i risultati precedenti semplicemente perché abbiamo modificato uno script.
15. Che cosa abbiamo imparato
Questa lezione collega le due metà del nostro percorso: GNU Octave come linguaggio di calcolo e GX-TXT come infrastruttura di dati scientifici.
Abbiamo visto come un asse temporale venga costruito, come una funzione matematica operi su un intero vettore, perché il numero di campioni dipenda dagli estremi inclusi e come si introduca una componente casuale riproducibile.
Abbiamo poi usato strutture Octave per descrivere le variabili e i metadati, distinguendo chiaramente identità, etichette, unità e tipi di dato. Infine abbiamo affidato la pubblicazione a DATASET_PUBLICATION_API_v2, prima per un singolo segnale e poi per tre output atomici.
Il risultato non è soltanto una curva disegnata sullo schermo. Sono Dataset scientifici che GX-TXT conosce, descrive e può mettere a disposizione di altri strumenti.
La prossima lezione approfondirà la visualizzazione scientifica, distinguendo la semplice Preview da una rappresentazione strutturata gestita attraverso le API pubbliche di Plot Dataset.
Materiale della lezione
Gli script GNU Octave associati all’articolo sono:
Lesson_07_01_Synthetic_Sine_Publication.m— genera una sinusoide con offset e la pubblica come Dataset canonico.Lesson_07_02_Atomic_Signal_Batch.m— genera tre segnali sintetici e li pubblica con una sola transazione atomica.
I due script utilizzano le funzioni native di Octave per la generazione numerica e le API pubbliche GX-TXT per i Dataset. Sono distribuiti con licenza GNU GPL v3 o successiva.
Versione e documentazione di riferimento
Questa lezione fa riferimento a GX-TXT DEV112-P005, con i contratti pubblici delle API disponibili nel repository GX-TXT su GitHub, ramo maintenance/dev112, commit 125afdb62110a92199f59a066199bb7f2dc7ed68.
Per approfondire le interfacce utilizzate:
Altre tappe del progetto
- Lezione 01 — Il primo script GNU Octave in GX-TXT
- Lezione 02 — Variabili, tipi di dati e operatori in GNU Octave con GX-TXT
- Lezione 03 — Vettori e matrici in GNU Octave con GX-TXT: analisi di misure di temperatura
- Lezione 04 — condizioni, cicli e funzioni. Simuliamo la legge di raffreddamento di Newton
- Lezione 05: Dataset scientifici e Variable ID
- Lezione 06 — Selezione e lettura dei dati sperimentali con GNU Octave e GX-TXT