
Lezione 08 — Grafici scientifici e debugging in GNU Octave con GX-TXT
Corso: GNU Octave con GX-TXT — Programmazione scientifica e analisi numerica
Framework verificato: GX-TXT 0.9.8.10-dev-112, Release 2, P005
Sorgenti pubblici di riferimento: giuxlab-hub/GX-TXT, maintenance/dev112
Commit di riferimento: 125afdb62110a92199f59a066199bb7f2dc7ed68
Licenza degli script: GPL-3.0-or-later
Obiettivi didattici
In questa lezione utilizzeremo i tre segnali pubblicati nella Lezione 07 per creare due grafici scientifici persistenti all’interno di GX-TXT:
- Un grafico cartesiano nel quale vengono sovrapposte tre curve.
- Tre pannelli disposti verticalmente, con l’asse temporale X condiviso.
Impareremo inoltre a individuare un errore introdotto intenzionalmente in uno script GNU Octave. Non ci limiteremo a mostrare un messaggio d’errore nel terminale: utilizzeremo il debugger nativo dell’Octave Script Workspace di GX-TXT, impostando un vero breakpoint e osservando lo stack delle chiamate e le variabili locali durante l’esecuzione.
Per costruire i grafici utilizzeremo l’API pubblica Plot Dataset API v4. I dati resteranno nei Dataset canonici della Session, mentre GX-TXT gestirà le rappresentazioni grafiche e le loro varianti persistenti. In questo modo potremo visualizzare gli stessi dati in forme differenti senza duplicarli.
Dalle lezioni precedenti ai nuovi strumenti
Questa esercitazione riprende strumenti già utilizzati nel corso e introduce due argomenti nuovi: il debugging durante l’esecuzione e la costruzione di grafici con più serie e più pannelli. La tabella aiuta a distinguere i prerequisiti da ciò che approfondiremo adesso.
| Lezione | Conoscenze già acquisite | Come vengono utilizzate nella Lezione 08 |
|---|---|---|
| 01–04 | Variabili, operatori, vettori, condizioni e cicli for. | Controlliamo il numero di campioni ed eseguiamo cicli per costruire le serie. |
| 05 | Dataset ID, Variable ID, struct e cell array. | Riferiamo ogni curva a una variabile scientifica e organizziamo pannelli e serie. |
| 06 | Lettura con read_range e primo grafico a barre con Plot Dataset API v4. | Passiamo dal grafico singolo a rappresentazioni con più curve e pannelli. |
| 07 | Generazione e pubblicazione atomica dei tre segnali sinusoidali. | Riutilizziamo i Dataset già pubblicati senza generarli nuovamente. |
Non ripartiremo quindi dalla sintassi elementare di Octave. Ci concentreremo su breakpoint, variabili osservate e stack delle chiamate, poi sulla struttura di PlotSpec e sul ciclo di vita dei grafici persistenti.
1. Materiale necessario
Occorrono GX-TXT DEV112-P005, GNU Octave e una Session GX-TXT dedicata alle prove.
I tre Dataset di ingresso sono quelli generati dallo script di pubblicazione atomica della Lezione 07.02:
| Dataset ID | Segnale | Variable ID X | Variable ID Y |
|---|---|---|---|
lesson07_sine_pure | Sinusoide a 5 Hz, ampiezza 1,5 V | time_s | voltage_v |
lesson07_sine_noisy | Sinusoide a 5 Hz con rumore gaussiano riproducibile | time_s | voltage_v |
lesson07_sine_harmonic | Sinusoide a 5 Hz con terza armonica a 15 Hz | time_s | voltage_v |
Ciascun Dataset contiene 801 campioni, relativi all’intervallo da 0 a 2 secondi, con una frequenza di campionamento di 400 campioni al secondo (intervallo fra due punti: 0,0025 s). La deviazione standard del rumore è 0,2 V; l’ampiezza della terza armonica è 0,45 V. Il generatore casuale usato nello script preliminare è inizializzato con il seme 707.
Il numero 801 deriva dal fatto che lo script include sia l’istante iniziale sia quello finale: con 400 intervalli al secondo per 2 secondi si ottengono 800 intervalli, ma 801 punti. È la distinzione fra numero di intervalli e numero di campioni che sfrutteremo nell’esercizio di debugging.
Se questi Dataset non sono ancora presenti, importa L08_00_Prerequisite_L07_Signals.m nell’Octave Script Workspace, assegna uno Script ID univoco, salva lo script nella Session ed eseguilo mediante Run > Open Script Runner…. Il Job dovrà terminare con lo stato COMPLETED. A quel punto, i tre identificativi dovranno comparire nel catalogo dei Dataset della Session.
Il file preliminare riproduce lo script già presentato nella Lezione 07.02. Non modificare né sovrascrivere Dataset esistenti in una Session destinata ad altri esperimenti.
2. Preparare l’Octave Script Workspace
In GX-TXT, apri Viewers > Scientific Scripting > Octave Scripts.
L’editor può mostrare l’Explorer, gli esempi del Bridge GX-TXT, la versione dello script, i parametri, le proprietà e il debugger. Non tutte queste sezioni sono necessarie contemporaneamente.
Durante la preparazione dei grafici:
- Nascondi GX-TXT Bridge Snippets e Script Explorer dopo aver selezionato lo script registrato.
- Nascondi le sezioni Script properties, Version e Parameters dopo aver inserito lo Script ID e salvato.
- Mantieni nascosti Debugger, Call Stack, Variables e Debugger Output finché non inizieremo l’esercizio di debugging.
- Usa View > API Browser quando vuoi consultare la firma dichiarata di un’API; poi nascondilo, per lasciare più spazio al codice sorgente.
Sono tutte regolazioni della presentazione previste da GX-TXT: non modificano né lo script né i dati scientifici né il CORE del framework.
3. L’errore intenzionale: 800 invece di 801
Per cominciare, importa L08_01_Debug_Exercise_Buggy.m. Assegna uno Script ID univoco nella Session, ad esempio lesson08_intentional_bug, e salva.
Nel codice è presente un errore deliberato:
% The debugger exercise uses this expected sample count.
expected_sample_count = 800; % INTENTIONAL BUG: the source has 801 samples.
Successivamente, lo stesso script legge i dati canonici effettivi e confronta il numero dei campioni ottenuti con quello dichiarato:
block = gxtxt_api_call(dataset_api, 'read_range', ...
                       {source_ids{i}, {'time_s', 'voltage_v'}, 0, 801});

time_s = block.time_s.values(:);
voltage_v = block.voltage_v.values(:);
actual_sample_count = numel(time_s);

if actual_sample_count != expected_sample_count
  error('Expected %d samples but found %d in %s.', ...
        expected_sample_count, actual_sample_count, source_ids{i});
endif
I concetti di Octave
numel(time_s) restituisce il numero totale di elementi del vettore. L’operatore != significa «diverso da» e l’istruzione if ... endif esegue il proprio corpo soltanto quando la condizione è vera: sono costruzioni già incontrate nelle lezioni iniziali. Qui le utilizziamo per controllare la correttezza dei dati letti.
Osserva che lo script legge il Dataset reale: non genera un valore fittizio soltanto per provocare un errore.
L’istruzione block.time_s.values(:) estrae i valori della variabile e li dispone in un vettore colonna; source_ids{i} seleziona l’identificativo del Dataset dalla cell array. Nella chiamata read_range, lo 0 indica invece la prima riga del Dataset: gli indici di lettura di GX-TXT partono da zero, mentre gli indici ordinari di Octave partono da uno, come già visto nella Lezione 06.
Che cosa osserva il debugger
Un debugger permette di sospendere uno script in un punto scelto e di esaminarne lo stato durante l’esecuzione. Un breakpoint è un punto di arresto, non una modifica del calcolo. Una volta raggiunto, possiamo distinguere ciò che lo script si aspettava da ciò che le istruzioni hanno effettivamente prodotto.
| Strumento | Che cosa mostra | Perché ci serve |
|---|---|---|
| Breakpoint | La riga alla quale arrestare l’esecuzione. | Fermarci prima del controllo che può generare l’errore. |
| Variables / Locals | I valori delle variabili nel contesto osservato. | Confrontare i numeri 800 e 801 senza dedurli dal solo messaggio finale. |
| Call Stack | La sequenza delle chiamate che ha portato al punto corrente. | Capire in quale funzione e in quale riga si trova l’esecuzione. |
| Continue e Step Over | Ripresa dell’esecuzione o avanzamento oltre una singola istruzione. | Verificare quando viene valutata la condizione errata. |
Il debugger opera sulla revisione dello script salvata e registrata nella Session. Per questo, prima di avviare il Debug Job, occorre salvare le modifiche: il Job deve eseguire una versione identificabile del codice.
Impostare un vero breakpoint
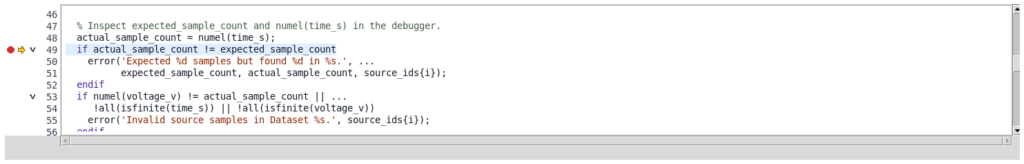
Nell’editor del codice sorgente, raggiungi la riga 49, che contiene il confronto. Apri Run > Debug Session script…. Seleziona la riga e premi Breakpoint.
Premi Start Debug. GX-TXT avvia un Job di debugging gestito dal framework, interrompe l’esecuzione sul breakpoint e mostra la versione registrata dello script utilizzata dal Job.
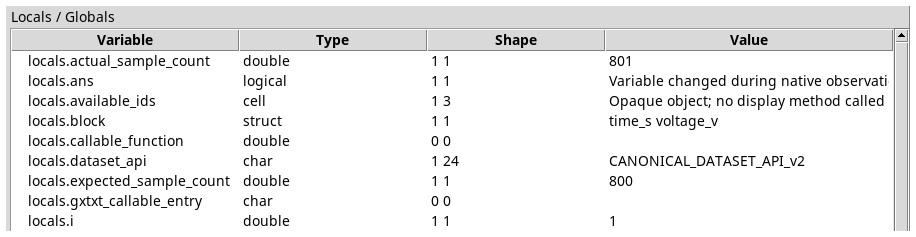
Nella sezione Stack and variables, osserva queste due variabili locali:
| Variabile locale | Valore osservato |
|---|---|
actual_sample_count | 801 |
expected_sample_count | 800 |
La differenza permette di individuare il difetto prima che venga sollevata l’eccezione.
Premi Continue. GNU Octave valuta la condizione, che risulta vera, e genera il messaggio:
Expected 800 samples but found 801 in lesson07_sine_pure.Il Job termina con lo stato FAILED: è il risultato previsto per questo esercizio volutamente errato. Non si tratta di un problema di GX-TXT. L’esecuzione si interrompe prima che venga creato uno qualsiasi dei due grafici scientifici.

Precisazione sul debugger: dopo un errore, uno snapshot etichettato come «last paused» rappresenta i valori osservati nell’ultima pausa, non le variabili ancora attive di una funzione la cui esecuzione è già stata abbandonata.
4. Correggere l’errore
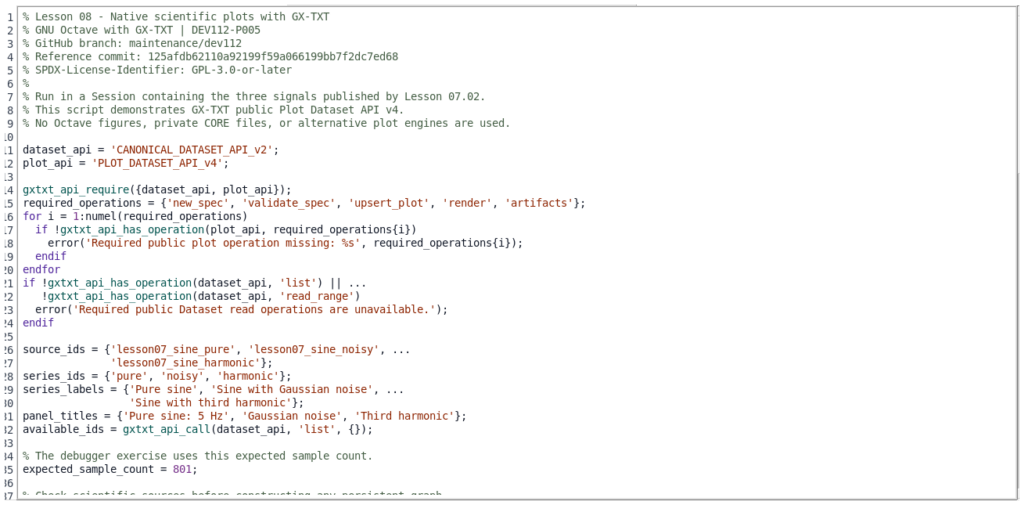
Apri lo script corretto L08_02_Native_Plots_Correct.m. La procedura scientifica è identica, ma questa volta il numero atteso di campioni è quello effettivo:
expected_sample_count = 801;Utilizziamo due script registrati distinti: uno con l’errore e uno corretto. Questa scelta permette di confrontare i risultati dei due Job e dimostra un principio importante: il debugger si riferisce alla revisione dello script effettivamente eseguita, non a modifiche successive effettuate nell’editor.
5. API pubbliche GX-TXT utilizzate nella lezione
Uno script scientifico deve interagire con la superficie pubblica dello Script Bridge, senza chiamare direttamente procedure Tcl, leggere file privati della Session o richiamare le routine interne di rendering.
5.1 Dichiarare le dipendenze
dataset_api = 'CANONICAL_DATASET_API_v2';
plot_api = 'PLOT_DATASET_API_v4';

gxtxt_api_require({dataset_api, plot_api});
gxtxt_api_require() controlla la disponibilità delle API pubbliche richieste nel contesto dello script gestito dal framework. L’argomento è una cell array, cioè una struttura dati Octave contenente gli identificativi delle API.
Il controllo successivo è più specifico:
required_operations = {'new_spec', 'validate_spec', ...
                       'upsert_plot', 'render', 'artifacts'};
for i = 1:numel(required_operations)
  if !gxtxt_api_has_operation(plot_api, required_operations{i})
    error('Required public plot operation missing: %s', ...
          required_operations{i});
  endif
endfor
gxtxt_api_has_operation(api_id, operation) verifica che una determinata operazione dello Script Bridge sia effettivamente registrata. Conoscere il nome di una famiglia di API non autorizza automaticamente a chiamare una qualsiasi procedura interna.
Per consultare una descrizione più dettagliata delle operazioni effettivamente disponibili, puoi usare gxtxt_api_describe('PLOT_DATASET_API_v4') in uno script gestito, oppure aprire l’API Browser di GX-TXT. I descrittori delle operazioni possono documentare i contratti relativi agli argomenti e ai risultati.
5.2 Consultare un Dataset canonico
available_ids = gxtxt_api_call(dataset_api, 'list', {});
block = gxtxt_api_call(dataset_api, 'read_range', ...
                      {'lesson07_sine_pure', {'time_s','voltage_v'}, ...
                       0, 801});
CANONICAL_DATASET_API_v2 / list restituisce gli identificativi dei Dataset registrati nella Session corrente.
CANONICAL_DATASET_API_v2 / read_range permette di leggere un numero delimitato di righe, specificando i Variable ID stabili. I parametri sono:
- L’identificativo del Dataset.
- Una cell array contenente gli identificativi delle variabili da leggere.
- L’indice della prima riga, che parte da zero.
- Il numero delle righe richieste.
Il risultato contiene una struttura per ogni variabile selezionata, inclusi i rispettivi values. La lettura non dipende dal percorso di un file CSV né dalla posizione fisica delle colonne.
5.3 Definire un PlotSpec invece di disegnare una figura
overlay = gxtxt_api_call(plot_api, 'new_spec', ...
                         {'plot.dataset.xy', ...
                          'Lesson 08: signal comparison'});
PLOT_DATASET_API_v4 / new_spec crea una specifica dichiarativa iniziale. Il tipo di grafico plot.dataset.xy identifica una rappresentazione cartesiana X/Y.
Il PlotSpec descrive pannelli, assi, serie e opzioni di presentazione. Il contenuto dei Dataset rimane la fonte scientifica autorevole, indipendente dalla sua rappresentazione grafica.
Che cosa contiene un PlotSpec
Un PlotSpec è una descrizione strutturata di come rappresentare dati scientifici già disponibili. Non contiene necessariamente i campioni delle curve: indica quali Dataset e Variable ID utilizzare e come organizzarli. L’API new_spec restituisce una struttura Octave che possiamo completare prima di chiedere il rendering.
| Elemento | Ruolo nella rappresentazione |
|---|---|
title | Titolo generale del grafico. |
panels | Cell array dei pannelli che compongono il grafico. |
axes | Etichette e scale degli assi di ciascun pannello. |
series | Elenco delle curve presenti in un pannello, con i riferimenti ai Dataset. |
multi_panel | Abilita la disposizione verticale di più pannelli con asse X condiviso. |
Questo modello è dichiarativo: prepariamo e validiamo una struttura dati, poi lasciamo a GX-TXT il compito di generare il grafico. È diverso dal disegnare una curva impartendo direttamente una sequenza di comandi grafici a Octave.
Non bisogna confondere la versione dell’API con quella della specifica: Plot Dataset API v4 indica la versione del servizio pubblico utilizzato dallo script, mentre PlotSpec v2 identifica il formato della struttura che descrive il grafico. Sono due versionamenti diversi e compatibili fra loro.
5.4 Il ciclo di vita di un grafico
| Operazione pubblica | Scopo |
|---|---|
new_spec | Creare una struttura PlotSpec iniziale corretta |
validate_spec | Rifiutare specifiche grafiche non valide o incoerenti |
upsert_plot | Creare o aggiornare un grafico o una variante persistente appartenente allo script, usando una chiave stabile del produttore |
render | Eseguire il rendering del grafico persistente attraverso il framework |
artifacts | Consultare i percorsi pubblici e i metadata degli artefatti prodotti |
Tutte queste chiamate utilizzano il medesimo punto di ingresso dello Script Bridge:
result = gxtxt_api_call(plot_api, operation, arguments);Il parametro arguments è una cell array di argomenti posizionali. Lo Script Bridge associa l’operazione pubblica al provider del framework, ne verifica il contratto e restituisce un risultato strutturato.
Grafico persistente, variante e chiave stabile
La Lezione 06 aveva già utilizzato Plot Dataset API v4 per un grafico a barre. Ora ne approfondiamo il comportamento: validate_spec verifica che la descrizione sia coerente, mentre upsert_plot registra la rappresentazione facendo riferimento a una chiave stabile dello script produttore. Se lo stesso script viene rieseguito nella medesima Session, quella chiave permette di aggiornare la rappresentazione associata anziché crearne automaticamente una nuova a ogni esecuzione.
Il risultato di upsert_plot è un riferimento al grafico (usato nelle successive chiamate render e artifacts). Non va confuso con il dataset_id: il primo identifica una rappresentazione, il secondo la sorgente scientifica. Le varianti consentono quindi di conservare viste differenti degli stessi dati. Gli identificativi p0001 e p0002 citati più avanti sono quelli assegnati nella Session dell’esercitazione; in altre Session possono essere diversi.
6. Primo grafico: tre curve sovrapposte
Per ogni curva descriviamo sia la sua identità scientifica sia la modalità con cui deve essere visualizzata:
p.series{i} = struct( ...
    'id', series_ids{i}, ...
    'label', series_labels{i}, ...
    'dataset_id', source_ids{i}, ...
    'x_variable_id', 'time_s', ...
    'y_variable_id', 'voltage_v', ...
    'axis', 'left', ...
    'kind', 'line');
I valori di dataset_id e dei due variable_id non sono semplici etichette. Sono riferimenti a risorse già pubblicate nella Session GX-TXT corrente.
Il campo axis seleziona l’asse Y sinistro e kind='line' richiede una rappresentazione con linee. Il campo label definisce il testo visualizzato in legenda.
Dal punto di vista di Octave, struct(...) costruisce la descrizione di una serie, mentre p.series{i} la inserisce nell’elemento i di una cell array. Le parentesi graffe {} servono ad accedere al contenuto delle celle; l’operatore punto accede invece ai campi delle strutture. Le due forme di accesso, già introdotte nelle Lezioni 05 e 07, qui lavorano insieme.
È utile distinguere tre identità: id è l’identificativo della serie nel grafico; dataset_id individua il Dataset sorgente; x_variable_id e y_variable_id selezionano le due variabili da rappresentare. Infine axis = left associa la serie all’asse Y sinistro, mentre nel campo axes.y_left si configurano le proprietà di quell’asse.
Lo script costruisce tre strutture di questo tipo nello stesso pannello, configura le etichette degli assi, valida il PlotSpec, quindi lo registra e lo renderizza:
if !gxtxt_api_call(plot_api, 'validate_spec', {overlay})
  error('The three-trace overlay PlotSpec failed validation.');
endif

ref_overlay = gxtxt_api_call(plot_api, 'upsert_plot', ...
                             {'lesson08_signal_overlay', overlay});
gxtxt_api_call(plot_api, 'render', {ref_overlay});
artifact_overlay = gxtxt_api_call(plot_api, 'artifacts', {ref_overlay});
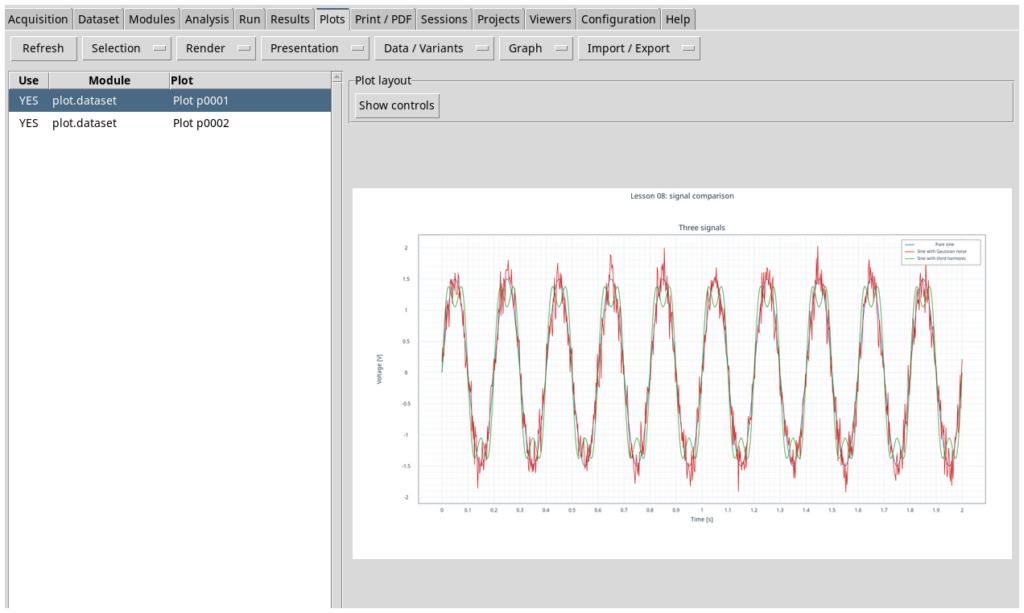
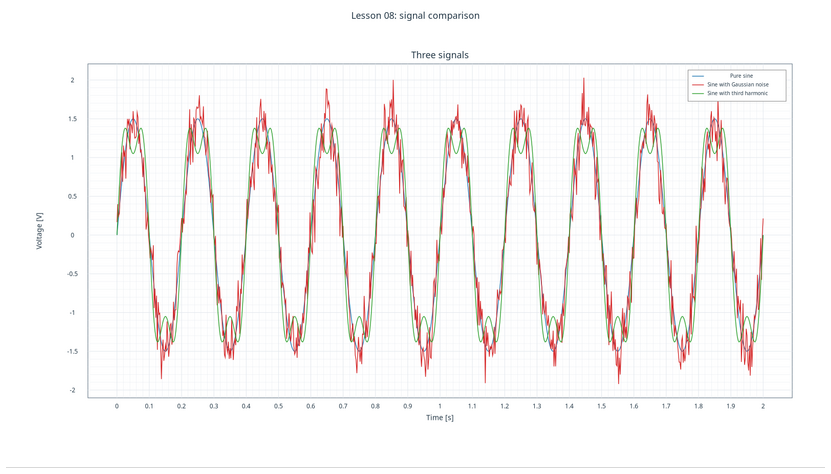
Il risultato, la variante grafica GX-TXT p0001, mostra insieme i tre segnali a 5 Hz. La curva rumorosa si riconosce dalle deviazioni irregolari rispetto alla sinusoide ideale; la presenza della terza armonica altera invece la forma dell’onda.
7. Secondo grafico: tre pannelli verticali
Talvolta la sovrapposizione di più curve nasconde differenze importanti. Il modello PlotSpec v2, disponibile attraverso Plot Dataset API v4, supporta anche pannelli sovrapposti verticalmente che condividono l’asse X.
stacked = gxtxt_api_call(plot_api, 'new_spec', ...
                         {'plot.dataset.xy', ...
                          'Lesson 08: stacked panels'});
stacked.multi_panel = 1;
stacked.panels = cell(1, numel(source_ids));
Una cell array, creata con cell, permette di conservare più strutture che descrivono i pannelli. Il ciclo for ne costruisce uno per ciascun segnale scientifico:
Con cell(1, numel(source_ids)) riserviamo uno spazio per ciascuno dei tre pannelli. La preallocazione rende esplicita la dimensione della struttura che riempiremo con il ciclo for, una tecnica già incontrata nella Lezione 07. Ogni pannello possiede un proprio id, un titolo e un elenco di serie.
for i = 1:numel(source_ids)
  panel = struct();
  panel.id = series_ids{i};
  panel.title = panel_titles{i};
  panel.axes = struct( ...
      'x', struct('label', 'Time [s]', 'scale', 'linear'), ...
      'y_left', struct('label', 'Voltage [V]', 'scale', 'linear'));
  panel.annotations = {};
  panel.series = {p.series{i}};
  stacked.panels{i} = panel;
endfor
La distinzione fondamentale è che non pubblichiamo nuovamente i dati. Il secondo PlotSpec descrive una diversa rappresentazione degli stessi identificativi Dataset/Variable già presenti nella Session.
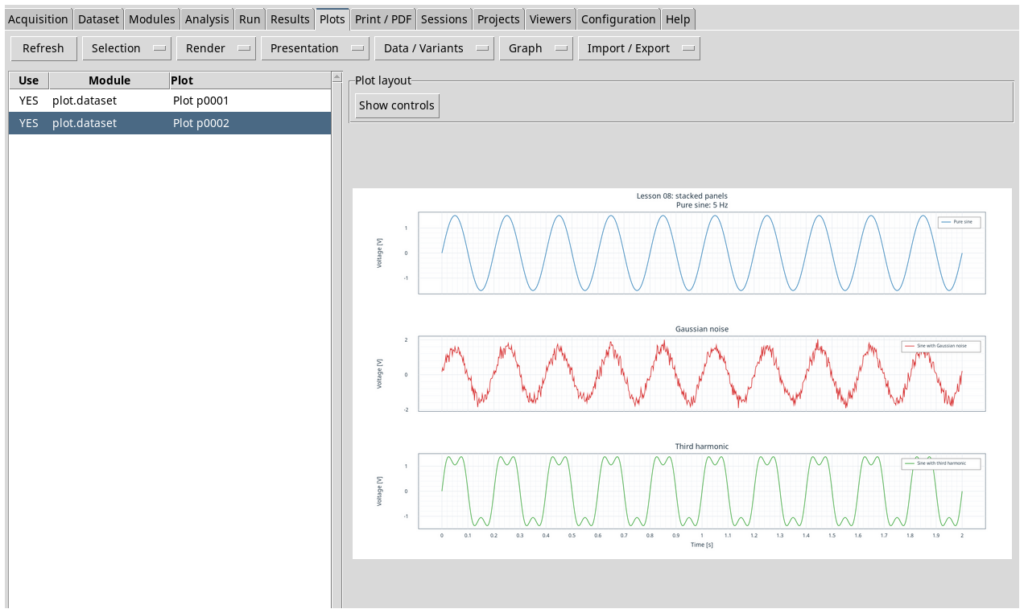
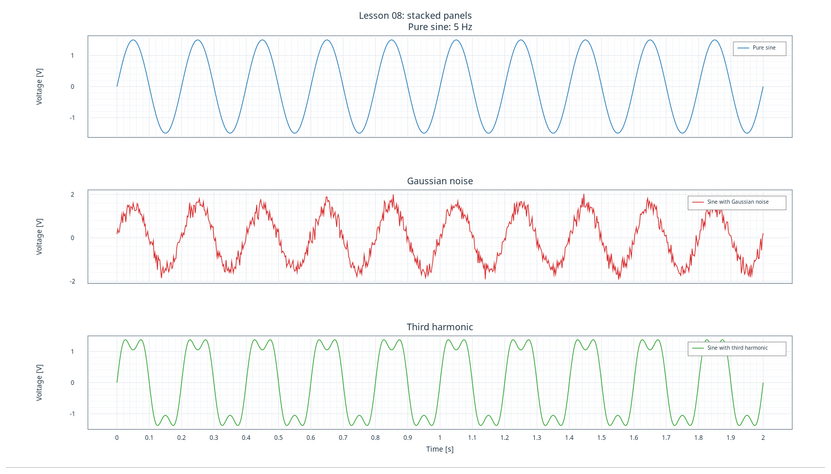
Nella struttura panel.axes, i campi x e y_left contengono a loro volta strutture con label e scale: sono quindi strutture annidate. Assegnare panel.series = {p.series{i}} significa collocare una sola curva nel pannello corrente. Impostando stacked.multi_panel = 1, GX-TXT organizza i pannelli verticalmente: l’asse temporale X è comune, mentre ogni pannello può avere la propria rappresentazione Y.
Validiamo ed eseguiamo il rendering come nel primo caso. Il grafico indipendente ottenuto è la variante p0002.
Quale rappresentazione scegliere?
La sovrapposizione è utile quando vogliamo confrontare i tre segnali allo stesso istante, osservando direttamente le deviazioni rispetto alla sinusoide ideale. I pannelli separati sono più leggibili quando le curve si intersecano o il rumore maschera le differenze di forma. Le due rappresentazioni non cambiano i valori dei Dataset: cambia soltanto il modo in cui vengono osservati.
8. Esercizi
- Modifica il titolo generale del grafico con le curve sovrapposte e osserva come l’aggiornamento interessi la stessa variante grafica persistente.
- Cambia l’etichetta di legenda di una delle curve; verifica che il Dataset ID e i Variable ID della sorgente non siano stati modificati.
- Confronta la rappresentazione sovrapposta con quella a tre pannelli. Quale permette di riconoscere meglio il rumore gaussiano? Quale evidenzia maggiormente la terza armonica?
- Imposta un breakpoint sull’istruzione
actual_sample_count = numel(time_s);ed esegui un Step Over. Osserva come cambia il valore della variabile. - Ripristina l’errore intenzionale impostando il valore 800, esegui il solo esercizio di debugging in una Session di prova e poi correggilo nuovamente.
9. Errori comuni
«Missing Dataset» indica che la Lezione 07.02 non è stata eseguita nella Session corrente oppure che gli identificativi dei Dataset di origine sono differenti. Non sostituire silenziosamente un Dataset scientifico mancante con un array numerico creato nello script.
«Missing public plot operation» indica che la dichiarazione richiesta dallo Script Bridge, oppure il relativo modulo, non è disponibile nel contesto attivo del framework e dello script.
«Expected 800 samples but found 801» è l’errore introdotto appositamente nella prima versione. La correzione prevista consiste nell’impostare a 801 il numero di campioni attesi.
«Invalid Variable ID» indica che un riferimento non corrisponde a un descrittore di variabile realmente presente nel Dataset della Session. Occorre consultare lo schema canonico, anziché dedurre gli identificativi dalle posizioni delle colonne.
10. Materiale della lezione
L08_00_Prerequisite_L07_Signals.m— script preliminare equivalente alla Lezione 07.02.L08_01_Debug_Exercise_Buggy.m— script contenente l’errore intenzionale.L08_02_Native_Plots_Correct.m— implementazione corretta e verificata, basata sulle API pubbliche.
La lezione riunisce i due livelli dell’esercitazione: con GNU Octave organizziamo le strutture, controlliamo i dati e costruiamo le specifiche del grafico; attraverso le API pubbliche, GX-TXT consulta i Dataset canonici e conserva le rappresentazioni grafiche persistenti nella Session.
Riferimenti ai sorgenti pubblici
- Repository GitHub GX-TXT, maintenance/dev112
- Plot Dataset API v4
- Plot Dataset API v2 — PlotSpec e disposizione dei pannelli
- GNU Octave Script Workspace
Limite di validazione: questa lezione è stata verificata su DEV112-P005. Le revisioni successive pubblicate su GitHub potrebbero modificare elementi dell’interfaccia o introdurre nuove operazioni pubbliche: per questo viene indicato il commit esatto di riferimento.
Altre tappe del progetto
- Lezione 01 — Il primo script GNU Octave in GX-TXT
- Lezione 02 — Variabili, tipi di dati e operatori in GNU Octave con GX-TXT
- Lezione 03 — Vettori e matrici in GNU Octave con GX-TXT: analisi di misure di temperatura
- Lezione 04 — condizioni, cicli e funzioni. Simuliamo la legge di raffreddamento di Newton
- Lezione 05: Dataset scientifici e Variable ID
- Lezione 06 — Selezione e lettura dei dati sperimentali con GNU Octave e GX-TXT