
OpenFOAM 14, caso 05: calcolo parallelo con MPI
Quinto caso del percorso Imparare OpenFOAM 14: il calcolo parallelo con MPI. Il canale parametrico validato nel caso 04 viene calcolato due volte, una in seriale con un solo processo e una dopo aver diviso la mesh in quattro sottodomini, con quattro processi MPI.
Caso di addestramento CFD 05 – Esecuzione parallela di OpenFOAM con MPI. OpenFOAM 14: decomposizione del dominio, esecuzione parallela, ricostruzione ed equivalenza numerica.
1. Obiettivi di apprendimento
Questo esercizio introduce l’esecuzione CFD parallela con MPI in OpenFOAM 14. Un caso di canale già validato viene calcolato due volte:
- una volta come normale calcolo seriale, con un solo processo OpenFOAM;
- una volta dopo aver decomposto la mesh in quattro sottodomini, eseguendo quattro processi MPI.
L’esercizio non riguarda solo l’ottenimento di un tempo di esecuzione più breve. Lo studente deve anche verificare che il calcolo parallelo produca la stessa soluzione fisica del calcolo seriale.
Al termine dell’esercizio lo studente dovrebbe essere in grado di:
- spiegare perché un dominio CFD può essere suddiviso fra più processi;
- creare un file
decomposeParDict; - usare il metodo di decomposizione
scotch; - eseguire
decomposePar; - lanciare OpenFOAM con
mpirune l’opzione-parallel; - ricostruire il risultato distribuito con
reconstructPar; - confrontare quantitativamente i risultati seriale e parallelo;
- calcolare speed-up ed efficienza parallela;
- capire perché l’esecuzione parallela non è sempre esattamente proporzionale al numero di processi.
2. Caso di riferimento
Il caso di riferimento è il canale parametrico validato del caso di addestramento CFD 04.
| Grandezza | Valore |
|---|---|
| Lunghezza del canale | 0,75 m |
| Distanza fra le pareti | 0,015 m |
| Profondità del canale | 0,001 m |
| Mesh | 300 × 60 × 1 |
| Celle totali | 18.000 |
| Tipo di cella | esaedri |
| Velocità media in ingresso | 0,010 m/s |
| Viscosità cinematica | 1,0·10⁻⁶ m²/s |
| Numero di Reynolds | 300 |
| Velocità massima analitica | 0,015 m/s |
La validazione numerica del caso 04 aveva dato:
- velocità massima CFD: 0,0149916640 m/s;
- RMSE normalizzato rispetto al profilo analitico: 0,058850%;
- errore puntuale massimo relativo al massimo analitico: 0,083131%.
Si usa questa soluzione già validata in modo che nel caso 05 cambi soltanto la modalità di esecuzione.
3. Che cosa cambia con MPI
In un calcolo seriale un solo processo possiede la mesh completa e risolve tutte le equazioni.
In un calcolo parallelo OpenFOAM divide la mesh in sottodomini. Ogni processo MPI possiede un sottodominio e scambia informazioni con i processi vicini attraverso i confini fra processori (processor boundaries).
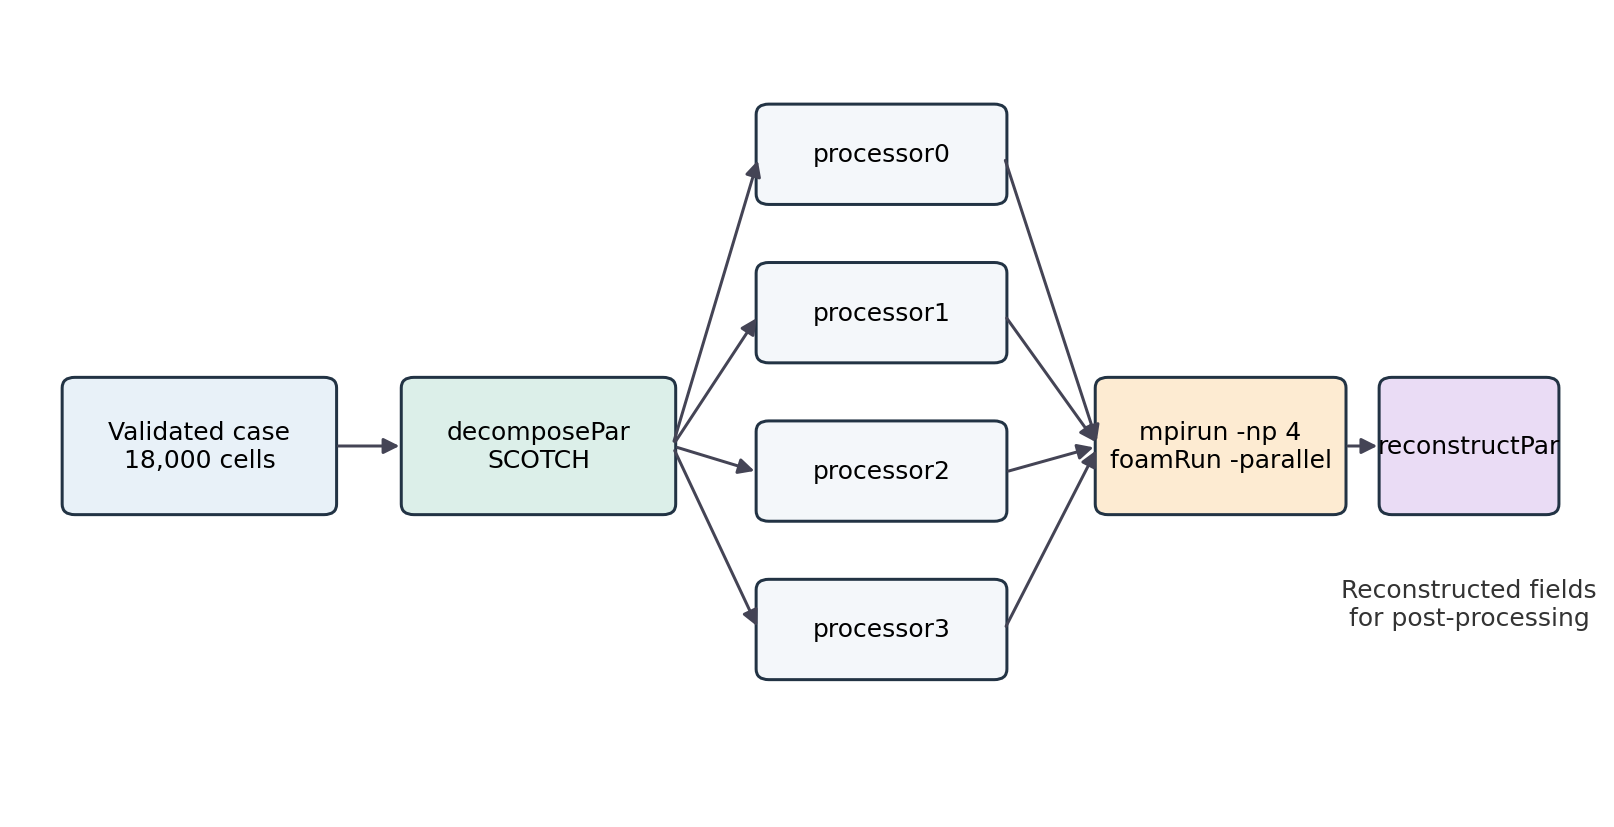
La sequenza principale è:
complete case
    |
    v
decomposePar
    |
    +--> processor0
    +--> processor1
    +--> processor2
    +--> processor3
            |
            v
     foamRun -parallel
            |
            v
      reconstructPar
            |
            v
complete reconstructed result
La fisica resta invariata. Viene distribuito fra più processi soltanto il carico di lavoro numerico.
4. Prerequisiti
OpenFOAM 14 e OpenMPI devono già funzionare.
Controllare i comandi necessari:
foamVersion
command -v foamRun
command -v decomposePar
command -v reconstructPar
command -v mpirun
Versione di OpenFOAM attesa:
14Si può fare anche un semplice controllo di MPI con:
mpirun --versionQuesto esercizio usa quattro processi MPI. La macchina deve quindi mettere a disposizione almeno quattro contesti di esecuzione della CPU perché il test sia significativo.
5. Creare i casi seriale e parallelo
Si parte dalla cartella validata del caso 04:
$FOAM_RUN/04_parametric_channelCreare due copie pulite contenenti gli stessi campi iniziali, la stessa mesh e le stesse impostazioni numeriche:
cd $FOAM_RUN

mkdir -p 05_parallel_channel/{serial,parallel}

for c in serial parallel; do
    cp -a 04_parametric_channel/0          05_parallel_channel/$c/
    cp -a 04_parametric_channel/constant   05_parallel_channel/$c/
    cp -a 04_parametric_channel/system     05_parallel_channel/$c/

    rm -rf 05_parallel_channel/$c/constant/polyMesh_reference
done
La struttura risultante è:
05_parallel_channel/
|-- serial/
|   |-- 0/
|   |-- constant/
|   `-- system/
`-- parallel/
    |-- 0/
    |-- constant/
    `-- system/
I due casi devono essere identici prima della decomposizione.
6. Calcolo seriale di riferimento
Il calcolo seriale fornisce il tempo di esecuzione di riferimento e la soluzione numerica di riferimento.
Entrare nella cartella seriale:
cd $FOAM_RUN/05_parallel_channel/serialEseguire OpenFOAM misurando il tempo reale trascorso (wall time):
/usr/bin/time \
    -o log.time.serial \
    -f 'Serial wall time: %e s' \
    foamRun > log.foamRun 2>&1
L’output del solutore viene rediretto in log.foamRun. Durante l’esecuzione lo si può seguire da un secondo terminale con:
tail -f log.foamRunUn calcolo riuscito termina con:
EndControllare le ultime righe e il tempo misurato:
tail -10 log.foamRun
cat log.time.serial
Risultato misurato in questo esercizio:
Serial wall time: 144.37 sIl log di OpenFOAM all’ultima iterazione conteneva:
Time = 2000s
DICPCG: Solving for p, Initial residual = 1.6999328e-10,
Final residual = 7.3423107e-11, No Iterations 260
ExecutionTime = 144.16033 s ClockTime = 144 s
End
Il valore stampato come Time = 2000s è l’etichetta di iterazione/tempo del calcolo stazionario usata da questo caso, non il tempo di esecuzione misurato. Il tempo reale complessivo si ricava da /usr/bin/time.
7. Post-processing seriale
Estrarre il profilo di velocità di riferimento:
foamPostProcess \
    -solver incompressibleFluid \
    -func graphUniform \
    -latestTime
Il file atteso è di solito:
postProcessing/graphUniform/2000/line.xyContiene il profilo di velocità campionato trasversalmente al canale, usato più avanti per il confronto seriale/parallelo.
8. Configurazione parallela: decomposeParDict
Entrare nel caso parallelo:
cd $FOAM_RUN/05_parallel_channel/parallelCreare system/decomposeParDict:
cat > system/decomposeParDict <<'EOF'
FoamFile
{
    format      ascii;
    class       dictionary;
    object      decomposeParDict;
}

numberOfSubdomains 4;

method scotch;
EOF
Le voci importanti sono:
numberOfSubdomains 4;– crea quattro sottodomini di calcolo;method scotch;– lascia che SCOTCH partizioni la mesh automaticamente.
8.1 Perché usare SCOTCH?
Una buona decomposizione del dominio dovrebbe raggiungere due obiettivi:
- dare a ogni processo all’incirca la stessa quantità di lavoro;
- ridurre al minimo le interfacce fra processi, perché i dati che attraversano quelle interfacce richiedono comunicazione MPI.
SCOTCH tratta la connettività della mesh come un grafo e trova automaticamente una partizione utile. Questo ne fa una buona scelta di uso generale quando non è richiesta una decomposizione geometrica particolare.
9. Decomporre la mesh
Eseguire:
decomposePar | tee log.decomposeParIl caso ora dovrebbe contenere:
processor0/
processor1/
processor2/
processor3/
Verificare:
ls -d processor*Controllare la distribuzione delle celle:
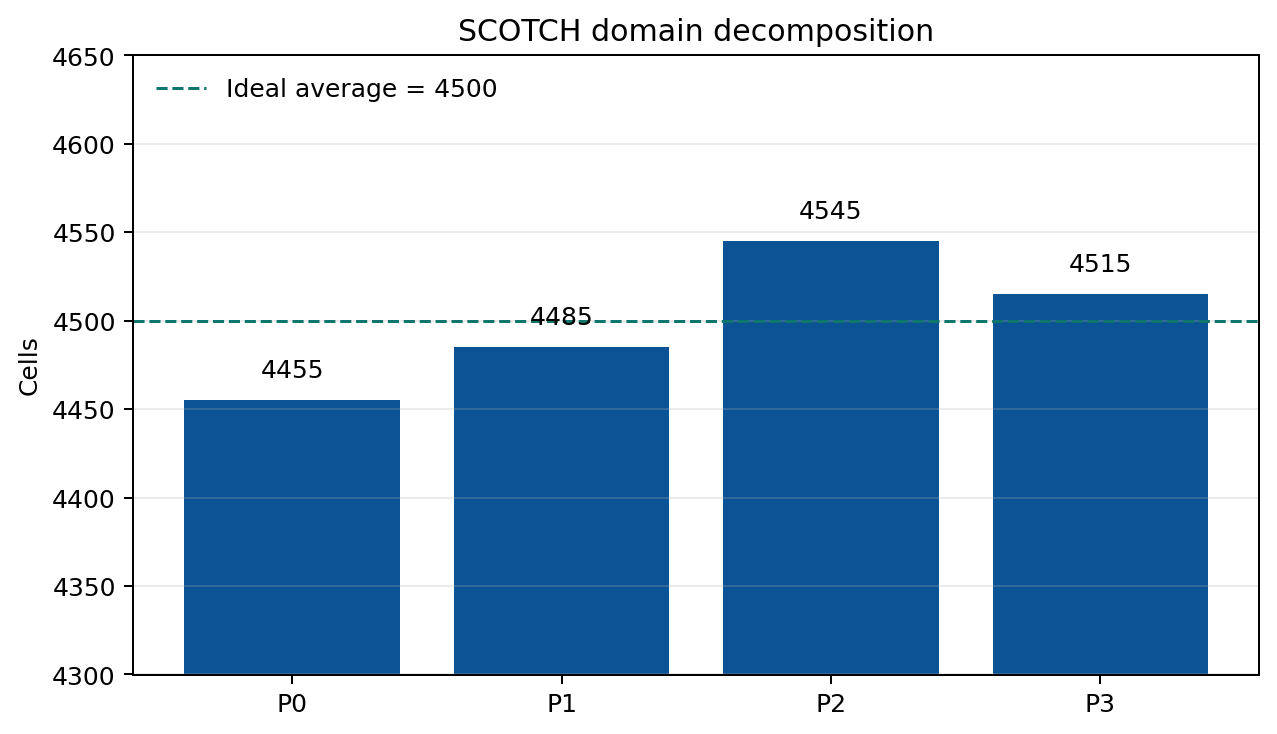
grep -E "Processor [0-9]|Number of cells" log.decomposeParDecomposizione misurata:
Processor 0
    Number of cells = 4455
Processor 1
    Number of cells = 4485
Processor 2
    Number of cells = 4545
Processor 3
    Number of cells = 4515
La media ideale è:
18000 / 4 = 4500 celle/processo
La distribuzione effettiva è quindi molto ben bilanciata.
Il sottodominio più piccolo contiene 4455 celle e il più grande 4545. L’intervallo completo è di sole 90 celle, pari al 2% della quota ideale di 4500 celle.
10. Calcolo con quattro processi MPI
Lanciare il calcolo parallelo:
/usr/bin/time \
    -o log.time.parallel \
    -f 'Parallel wall time: %e s' \
    mpirun -np 4 foamRun -parallel > log.foamRun 2>&1
Gli elementi importanti sono:
mpirun -np 4avvia quattro processi MPI;foamRunesegue il solutore;-paralleldice a OpenFOAM di usare il caso decomposto.
Se serve, seguire il calcolo con:
tail -f log.foamRunUn calcolo parallelo riuscito termina con:
End
Finalising parallel run
Controllare le ultime righe e il tempo reale:
tail -10 log.foamRun
cat log.time.parallel
Risultato misurato:
Parallel wall time: 40.95 sL’output finale di OpenFOAM comprendeva:
Time = 2000s
DICPCG: Solving for p, Initial residual = 1.8497959e-10,
Final residual = 8.9784387e-11, No Iterations 265
time step continuity errors : sum local = 8.2197286e-13,
global = 6.4830667e-15, cumulative = -4.7805998e-07
ExecutionTime = 40.664163 s ClockTime = 41 s
End
Finalising parallel run
11. Ricostruire il risultato parallelo
Dopo un calcolo parallelo ogni cartella processorN contiene soltanto la sua parte locale della soluzione. Molte normali operazioni di post-processing sono più semplici dopo aver ricomposto i campi completi.
Eseguire:
reconstructPar | tee log.reconstructParreconstructPar combina i campi distribuiti dei processori in normali cartelle temporali nel caso principale. Le cartelle processor non vengono cancellate automaticamente: si possono conservare come prova del calcolo parallelo oppure rimuovere più tardi, dopo aver verificato la ricostruzione.
12. Post-processing parallelo
Dopo la ricostruzione, estrarre lo stesso profilo di velocità usato per il caso seriale:
foamPostProcess \
    -solver incompressibleFluid \
    -func graphUniform \
    -latestTime
Ora sia il caso seriale sia quello parallelo dovrebbero contenere un profilo line.xy generato con coordinate di campionamento identiche.
13. Confronto quantitativo seriale/parallelo
Spostarsi nella cartella superiore:
cd $FOAM_RUN/05_parallel_channelIndividuare i profili finali:
S=$(find serial/postProcessing/graphUniform \
    -name line.xy | sort -V | tail -1)

P=$(find parallel/postProcessing/graphUniform \
    -name line.xy | sort -V | tail -1)

echo "$S"
echo "$P"
Confrontare i due profili punto per punto:
paste \
    <(grep -v '^#' "$S") \
    <(grep -v '^#' "$P") |
awk '
{
    ys=$1
    us=$2

    yp=$5
    up=$6

    d=up-us
    ad=(d<0 ? -d : d)

    sumsq += d*d
    n++

    if (ad > maxdiff) {
        maxdiff=ad
        maxy=ys
    }

    if (us > umaxS)
        umaxS=us

    if (up > umaxP)
        umaxP=up
}
END {
    rmse=sqrt(sumsq/n)

    printf "Points                   : %d\n",n
    printf "Serial Umax              : %.12f m/s\n",umaxS
    printf "Parallel Umax            : %.12f m/s\n",umaxP

    printf "Profile RMSE S vs P      : %.12e m/s\n",rmse
    printf "Maximum abs difference   : %.12e m/s\n",maxdiff
    printf "Max-difference y         : %.8f m\n",maxy

    printf "Max diff / 0.015         : %.12e %%\n",
           100*maxdiff/0.015
}'
Risultato misurato:
Points                   : 201
Serial Umax              : 0.014991664000 m/s
Parallel Umax            : 0.014991664000 m/s
Profile RMSE S vs P      : 1.577200743861e-11 m/s
Maximum abs difference   : 1.000000004678e-10 m/s
Max-difference y         : -0.00545750 m
Max diff / 0.015         : 6.666666697852e-07 %
Le velocità massime seriale e parallela sono identiche alla precisione mostrata.
La differenza massima fra i due profili campionati è circa
1 × 10⁻¹⁰ m/s
valore trascurabile rispetto alla velocità caratteristica di 0,015 m/s.
14. Perché possono comparire comunque piccolissime differenze
L’aritmetica in virgola mobile non è perfettamente associativa. In altre parole,
(a + b) + c
e
a + (b + c)
possono differire nelle ultime cifre binarie quando si usa un’aritmetica a precisione finita.
In un calcolo parallelo le riduzioni MPI e la decomposizione delle operazioni sulle matrici possono cambiare l’ordine in cui vengono eseguite le somme e le altre operazioni in virgola mobile. Per questo non ci si deve sempre aspettare che una soluzione parallela sia identica bit per bit a una soluzione seriale.
Il requisito corretto è che le differenze siano numericamente insignificanti rispetto all’accuratezza richiesta dal problema fisico.
In questo esercizio la differenza osservata è di molti ordini di grandezza inferiore all’errore di discretizzazione della soluzione CFD stessa.
15. Speed-up
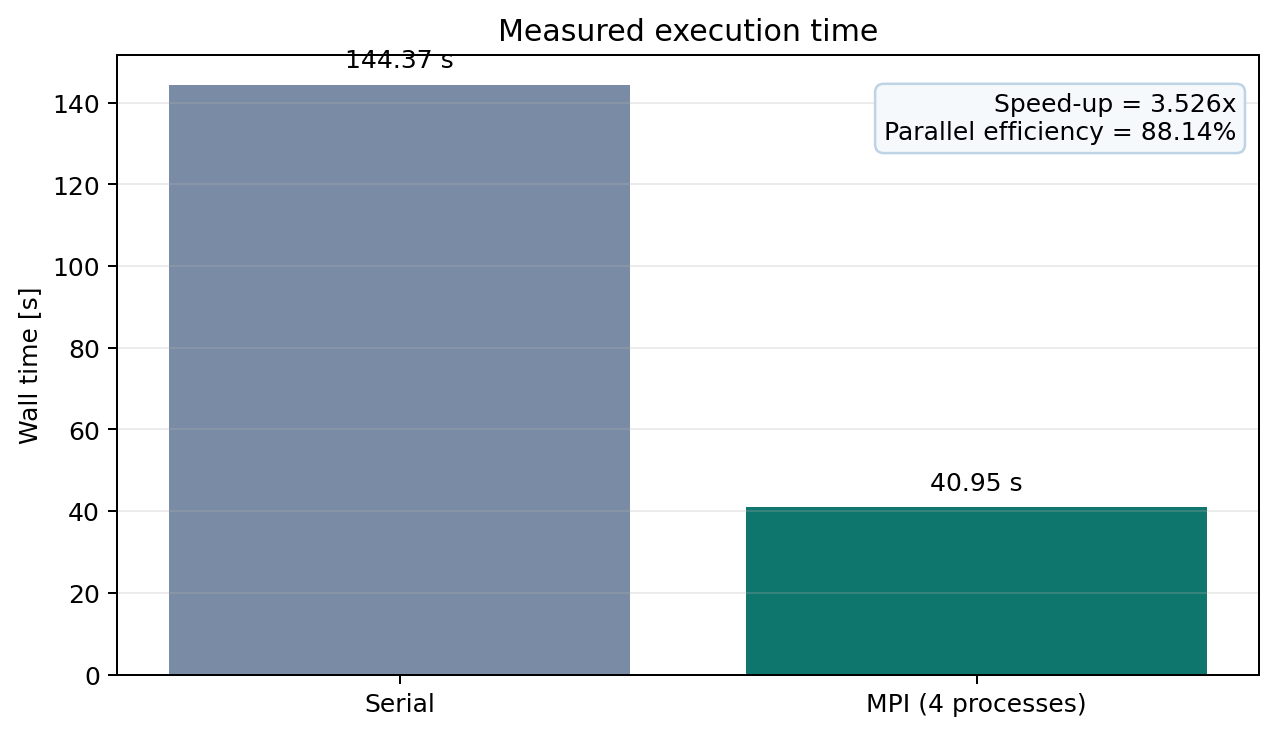
I tempi reali misurati sono:
| Modalità di esecuzione | Tempo reale |
|---|---|
| Seriale | 144,37 s |
| MPI, 4 processi | 40,95 s |
Lo speed-up parallelo è definito come
Sp = T1 / Tp
dove T1 è il tempo reale seriale e Tp il tempo reale usando p processi.
Per questo caso:
S4 = 144,37 / 40,95 = 3,526
Il calcolo con quattro processi è quindi circa 3,53 volte più veloce del calcolo seriale.
16. Efficienza parallela
L’efficienza parallela descrive quanto efficacemente vengono usati i processi disponibili:
ηp = Sp / p
Per quattro processi:
η4 = 3,526 / 4 = 0,8814
ovvero
η4 = 88,14%
È un risultato solido per questo caso di prova.
La riduzione del tempo reale è:
(144,37 − 40,95) / 144,37 × 100 = 71,64%
17. Perché lo speed-up non è esattamente quattro
Un calcolo ideale con quattro processi richiederebbe esattamente un quarto del tempo seriale:
Tideale = 144,37 / 4 = 36,09 s
Il tempo parallelo misurato è 40,95 s. Il tempo in più deriva dal costo aggiuntivo del parallelo (overhead), che comprende:
- comunicazione MPI attraverso i confini fra processori;
- sincronizzazione fra i processi;
- operazioni sulle interfacce legate alla decomposizione;
- costi di avvio e di coordinamento;
- parti dell’algoritmo che non si possono dividere perfettamente.
All’aumentare del numero di processi, di norma la comunicazione diventa più importante. Per questo raddoppiare il numero di processi MPI non dimezza automaticamente il tempo di calcolo.
Con mesh molto piccole l’esecuzione parallela può essere perfino più lenta di quella seriale. Per casi CFD molto grandi, invece, l’esecuzione parallela è spesso indispensabile, sia per il tempo di calcolo sia per distribuire il fabbisogno di memoria.
18. Calcolo automatico delle prestazioni
I tempi reali misurati si possono convertire in speed-up ed efficienza direttamente dai file di log:
serial=$(awk '{print $4}' serial/log.time.serial)
parallel=$(awk '{print $4}' parallel/log.time.parallel)

awk -v ts="$serial" -v tp="$parallel" '
BEGIN {
    p=4
    speedup=ts/tp
    efficiency=100*speedup/p
    reduction=100*(ts-tp)/ts

    printf "Serial wall time      : %.2f s\n",ts
    printf "Parallel wall time    : %.2f s\n",tp
    printf "Speed-up              : %.3f x\n",speedup
    printf "Parallel efficiency   : %.2f %%\n",efficiency
    printf "Wall-time reduction   : %.2f %%\n",reduction
}'
Output atteso per questo esercizio:
Serial wall time       : 144.37 s
Parallel wall time     : 40.95 s
Speed-up               : 3.526 x
Parallel efficiency    : 88.14 %
Wall-time reduction    : 71.64 %
19. Controllo facoltativo in ParaView
Una nuova visualizzazione non è necessaria per validare l’algoritmo parallelo, perché il confronto numerico punto per punto è molto più severo.
Se si desidera un controllo visivo, creare un file marcatore .foam nel caso parallelo ricostruito:
cd $FOAM_RUN/05_parallel_channel/parallel
touch parallel_channel.foam
Collegarsi con il client ParaView attraverso pvserver, aprire il caso ricostruito e verificare U e p all’ultimo tempo.
Il risultato visivo dovrebbe essere indistinguibile dalla soluzione seriale del caso 04.
20. Criteri di accettazione
L’esercizio è completo quando sono soddisfatte tutte le condizioni seguenti:
- il calcolo seriale arriva a
End; decomposeParcrea quattro cartelleprocessorN;- la decomposizione SCOTCH distribuisce le celle in modo ragionevolmente uniforme;
- il calcolo MPI arriva a
EndeFinalising parallel run; reconstructPartermina correttamente;- le velocità massime seriale e parallela coincidono;
- la differenza fra i profili seriale e parallelo è trascurabile rispetto all’errore di discretizzazione CFD;
- i tempi reali seriale e parallelo sono misurati con lo stesso metodo;
- speed-up ed efficienza sono calcolati e interpretati.
Per la prova misurata:
| Criterio | Risultato |
|---|---|
| Tempo reale seriale | 144,37 s |
| Tempo reale con 4 processi | 40,95 s |
| Speed-up | 3,526× |
| Efficienza parallela | 88,14% |
| Umax seriale | 0,014991664000 m/s |
| Umax parallela | 0,014991664000 m/s |
| Differenza massima fra i profili | 1,0·10⁻¹⁰ m/s |
| Equivalenza numerica | SUPERATA |
21. Conclusione finale
Questo esercizio mostra il flusso di lavoro parallelo completo di OpenFOAM:
validated case
    -> decomposePar
    -> MPI execution
    -> reconstructPar
    -> quantitative comparison
Il calcolo con quattro processi ha ridotto il tempo reale da 144,37 s a 40,95 s, con uno speed-up misurato di 3,526 e un’efficienza parallela dell’88,14%.
Ancora più importante, la soluzione parallela ricostruita è numericamente equivalente a quella seriale, a meno di circa 10⁻¹⁰ m/s nel profilo di velocità campionato.
La lezione chiave è che la CFD parallela va valutata sia sulle prestazioni sia sulla correttezza numerica. Un calcolo non è parallelizzato con successo solo perché gira più veloce: deve anche preservare la soluzione fisica.
Nel caso 06 si torna al calcolo seriale per studiare la sensibilità alle condizioni d’ingresso.