
Lezione 09 — Statistica descrittiva e debugging
Dai segnali sintetici alla statistica descrittiva: varianza, deviazione standard, RMS, media progressiva e distribuzione cumulativa empirica, con GNU Octave e le API pubbliche GX-TXT.
Versione di riferimento: GX-TXT 0.9.8.10-dev-112, Release 2, patch P001–P005 · Codice sorgente: commit 125afdb62110a92199f59a066199bb7f2dc7ed68 (ramo maintenance/dev112). Gli script sono distribuiti con licenza GPL-3.0-or-later.
Una formula può essere applicata correttamente a dati sbagliati. In questa lezione impariamo a interpretare le statistiche e a verificare che il segnale analizzato sia davvero quello desiderato.
1. Obiettivi e collegamenti con le lezioni precedenti
Abbiamo già imparato a costruire vettori e matrici, leggere Dataset tramite identificativi stabili, generare segnali sintetici e visualizzarli nei grafici di GX-TXT. Ora affrontiamo una domanda nuova: che cosa possiamo affermare su una serie di osservazioni, e con quali limiti?
| Concetto | Già affrontato nel corso | Approfondimento nella Lezione 09 |
|---|---|---|
| Vettori, media e indicizzazione | Lezioni 03 e 06 | Stimatori di posizione e dispersione; significato di median, var e std. |
| Identificativi e selezione dei dati | Lezioni 05 e 06 | Validare il riferimento fisico, non soltanto i nomi o le dimensioni dei vettori. |
| RMS e dati sintetici | Lezione 07 | Distinguere RMS, deviazione standard e contributo della media non nulla. |
| Script e debugger | Lezione 08 | Diagnosticare un errore scientifico che non causa problemi di sintassi. |
| Ordinamento e somme cumulative | Nuovo in questo percorso | sort, cumsum, media progressiva e funzione ECDF. |
| Valutazione statistica | Nuovo in questo percorso | Varianza campionaria e della popolazione, standard error, quartili e limiti inferenziali. |
Gli strumenti già noti non verranno rispiegati da zero: li useremo all’interno di un esperimento più completo. Prima studieremo il significato dei calcoli e solo dopo vedremo come vengono eseguiti nel framework.
2. L’esperimento: tre segnali e un riferimento fisico
Riprendiamo l’esperimento della Lezione 07. Lo script preliminare genera tre segnali con fondamentale a 5 Hz, campionati a 400 Hz durante 2 s. Entrambi gli estremi dell’asse temporale sono inclusi: il numero di osservazioni è 801. La sequenza di rumore è riproducibile mediante il seme pseudocasuale 707.
| Dataset canonico | Variable ID | Contenuto |
|---|---|---|
lesson07_sine_pure | voltage_v | Sinusoide pura di riferimento. |
lesson07_sine_noisy | voltage_v | Sinusoide più rumore gaussiano con deviazione standard nominale 0,20 V. |
lesson07_sine_harmonic | voltage_v | Sinusoide più terza armonica a 15 Hz, ampiezza 0,45 V. |
Tutti i Dataset utilizzano time_s come variabile X e condividono la stessa griglia temporale. Il rumore che vogliamo studiare è la differenza fra il segnale rumoroso e la sinusoide pura:
Se sottraessimo invece il segnale con terza armonica, il residuo conterrebbe una componente periodica deterministica. Calcoleremmo quindi un RMS valido per quel residuo, ma non un indicatore corretto del solo rumore casuale.
3. Il significato delle statistiche descrittive
3.1 Media e mediana: due misure di posizione
Per una sequenza di N osservazioni \(r_i\), la media aritmetica considera tutti i valori, mentre la mediana è il valore centrale della serie ordinata. La media è sensibile a valori estremi; la mediana è più robusta rispetto a pochi valori anomali.
samples_v = [1; 2; 3; 20];
mean_v = mean(samples_v);      % 6.5
median_v = median(samples_v);  % 2.5
Il valore 20 porta la media a 6,5, mentre la mediana resta 2,5. Non significa che la mediana sia sempre preferibile: le due statistiche riassumono aspetti diversi della distribuzione. Nel nostro rumore sintetico, ci aspettiamo entrambe prossime a zero, ma non necessariamente identiche.
3.2 Varianza campionaria, varianza della popolazione e gradi di libertà
La varianza quantifica la dispersione quadratica dei valori intorno alla media. Due definizioni differiscono nel denominatore: N per descrivere la popolazione osservata, N − 1 per la stima campionaria della varianza di una popolazione da osservazioni indipendenti e identicamente distribuite.
La correzione con \(N-1\) è nota come correzione di Bessel. Poiché la media è stimata dagli stessi dati, le differenze dalla media soddisfano un vincolo: la loro somma è zero. Rimangono quindi N − 1 gradi di libertà. La correzione riguarda la varianza campionaria; non rende automaticamente non distorta anche la radice quadrata di tale varianza.
values_v = [2; 4; 6; 8];
pop_var_v2 = var(values_v, 1);  % 5.000000 V^2
sample_var_v2 = var(values_v, 0); % 6.666667 V^2
pop_std_v = std(values_v, 1);    % 2.236068 V
sample_std_v = std(values_v, 0); % 2.581989 V
Per i quattro valori 2, 4, 6, 8 V la media è 5 V e la somma degli scarti quadratici è 20 V². Dividendo 20 per 4 otteniamo 5 V²; dividendo per 3 otteniamo circa 6,67 V². All’aumentare di N la differenza fra i due denominatori diventa meno importante. Per una sola osservazione, invece, la varianza campionaria non è definita.
3.3 Deviazione standard e RMS: non sono sinonimi
La deviazione standard è la radice della varianza e misura la dispersione intorno alla media. L’RMS, o valore quadratico medio, misura invece l’ampiezza del segnale rispetto allo zero. Per la stessa sequenza finita vale la relazione esatta:
Con i quattro valori del nostro esempio, l’RMS è 5,477 V, mentre la deviazione standard della popolazione è 2,236 V. La differenza è dovuta alla media di 5 V. Se il residuo ha media prossima a zero, RMS e deviazione standard della popolazione sono invece vicini: è proprio il caso del rumore sintetico esaminato in questa lezione.
values_v = [2; 4; 6; 8];
rms_v = sqrt(mean(values_v .^ 2));    % sqrt(30) = 5.477226
pop_std_v = std(values_v, 1);       % sqrt(5) = 2.236068
mean_v = mean(values_v);            % 5
assert(abs(rms_v^2 - (pop_std_v^2 + mean_v^2)) < 1e-10);
L’operatore .^ applica la potenza a ogni elemento. ^, invece, esprime una potenza matriciale: non va usato al posto di .^ quando il vettore contiene osservazioni indipendenti da elevare singolarmente al quadrato.
3.4 Deviazione standard ed errore standard della media
La deviazione standard s descrive quanto sono dispersi i campioni. L’errore standard della media (SEM) descrive invece la variabilità attesa della media campionaria se ripetessimo il campionamento nelle stesse condizioni, sotto ipotesi statistiche specifiche. Non è la dispersione dei singoli valori.
Per N = 801 e s ≈ 0,206560 V il SEM nominale è circa 0,007298 V. Non è corretto trattarlo come incertezza totale di una misura reale: errori sistematici, drift, correlazioni temporali, campionamento e taratura richiedono un’analisi dedicata. Con dati autocorrelati il numero effettivo di osservazioni indipendenti può essere inferiore a 801.
3.5 Quartili e intervallo interquartile
I quartili dividono la distribuzione ordinata in quattro parti: il primo quartile Q1 corrisponde al 25%, il terzo Q3 al 75%. L’intervallo interquartile è IQR = Q3 − Q1 e rappresenta la dispersione della metà centrale dei dati. L’operazione NUMERIC_API_v1/statistics fornisce quartili calcolati con interpolazione di tipo 7: il metodo numerico del quantile va sempre dichiarato quando confrontiamo software differenti.
4. Programmare i calcoli con Octave e GX-TXT
Abbiamo già incontrato le funzioni mean, find e strcmp nelle lezioni precedenti. La novità è combinare la sintassi con un criterio statistico e confrontare le espressioni native con il servizio numerico pubblico del framework.
4.1 Octave: operazioni su vettori
noise_residual_v = signal_v{2} - reference_v;
mean_v = mean(noise_residual_v);
median_v = median(noise_residual_v);
sample_std_v = std(noise_residual_v, 0);
population_std_v = std(noise_residual_v, 1);
variance_sample_v2 = var(noise_residual_v, 0);
rms_native_v = sqrt(mean(noise_residual_v .^ 2));
standard_error_v = sample_std_v / sqrt(numel(noise_residual_v));
La sintassi signal_v{2} estrae il secondo vettore da una cell array; signal_v(2) restituirebbe invece una cell array contenente una sola cella. Questa distinzione era stata introdotta nella Lezione 07 e qui diventa essenziale per eseguire una sottrazione fra veri vettori numerici.
4.2 L’API pubblica NUMERIC_API_v1
L’operazione array_reduce riceve il nome della riduzione, un operando tipizzato e le opzioni. Il Bridge richiede una struttura che dichiari kind e value; con axis = 0 tutti i campioni vengono ridotti a un solo risultato.
numeric_api = 'NUMERIC_API_v1';
gxtxt_api_require({numeric_api});
residual_operand = struct('kind', 'vector', 'value', noise_residual_v);
api_rms = gxtxt_api_call(numeric_api, 'array_reduce', ...
    {'rms', residual_operand, struct('axis', 0)});
observed_noise_rms_v = api_rms.values(1);
api_stats = gxtxt_api_call(numeric_api, 'statistics', ...
    {noise_residual_v, struct()});
gxtxt_api_require assicura che il servizio sia disponibile; gxtxt_api_call invoca un’operazione pubblica con argomenti posizionali. array_reduce produce un risultato sintetico come RMS, media o deviazione standard; statistics calcola un riepilogo più ampio che include quantili e dispersione. Il programma controlla che alcuni risultati coincidano con i calcoli Octave entro tolleranze numeriche definite.
4.3 Le altre API: lettura, pubblicazione e grafici
| API pubblica | Operazione | Funzione nel nostro esperimento |
|---|---|---|
OCTAVE_SCRIPT_BRIDGE_API_v1 | gxtxt_api_require, gxtxt_api_has_operation, gxtxt_api_call | Scoprire e invocare servizi pubblici disponibili nella Session. |
CANONICAL_DATASET_API_v2 | list, read_range | Leggere campioni per Dataset ID e Variable ID, senza dipendere dai file di storage. |
NUMERIC_API_v1 | array_reduce, statistics | Calcolare e confrontare statistiche numeriche con il CORE. |
DATASET_PUBLICATION_API_v2 | publish_series_batch | Pubblicare insieme Dataset derivati, schema delle variabili e metadati. |
PLOT_DATASET_API_v4 | new_spec, validate_spec, upsert_plot, render, artifacts | Creare grafici persistenti associati ai Dataset canonici. |
Queste API sono state spiegate nelle Lezioni 05–08. Qui è importante ricordare il loro ruolo nel processo scientifico: la lettura usa identificativi stabili, la pubblicazione registra dati e unità coerentemente, e i grafici rimangono riferiti ai Dataset anche dopo la fine dello script. Lo Script Runner gestisce automaticamente il ciclo di vita dello Script Bridge.
Per esempio, per leggere 801 campioni del segnale rumoroso, usiamo il metodo già introdotto nella Lezione 06:
samples = gxtxt_api_call('CANONICAL_DATASET_API_v2', ...
    'read_range', {'lesson07_sine_noisy', {'time_s', 'voltage_v'}, 0, 801});
time_s = samples.time_s.values(:);
noisy_v = samples.voltage_v.values(:);
L’offset iniziale della lettura è 0, mentre gli indici dei normali vettori Octave partono da 1. La forma (:) converte l’array in vettore colonna: non modifica l’ordine logico dei campioni.
5. Preparare la Session e generare i Dataset iniziali
- Creare una nuova Session con Sessions → Session → New Session.
- Aprire Viewers → Octave Scripts e importare
L09_00_Prerequisite_L07_Signals.mcon File → Import .m. - Assegnare uno Script ID univoco e premere Save.
- Eseguire il file con Run → Open Script Runner → Run Job, controllando che l’esecuzione sia terminata correttamente.
- Verificare che i tre Dataset
lesson07_sine_pure,lesson07_sine_noisyelesson07_sine_harmonicrisultino presenti.
Il programma preliminare pubblica i tre Dataset in un’unica transazione atomica. Poiché gli identificativi sono creati senza sovrascritture, una nuova prova completa richiede una Session nuova oppure identificativi differenti. Non bisogna modificare direttamente lo storage privato del framework.
6. Un errore logico-scientifico intenzionale
Apriamo L09_01_Debug_Wrong_Reference.m. L’errore è una singola scelta del Dataset di riferimento: la terza armonica viene usata al posto della sinusoide pura. Octave non può riconoscere autonomamente questo equivoco, perché le dimensioni e i tipi di dato sono corretti.
reference_dataset_id = 'lesson07_sine_harmonic'; % INTENTIONAL BUG: use the pure signal.
reference_index = find(strcmp(source_ids, reference_dataset_id));
reference_v = signal_v{reference_index};
noise_residual_v = signal_v{2} - reference_v;
Le funzioni strcmp e find sono già note dalla Lezione 05: la prima confronta le stringhe, la seconda restituisce gli indici corrispondenti. L’uso di un indice corretto dal punto di vista informatico non garantisce che il riferimento sia corretto dal punto di vista scientifico.
Il programma introduce allora una condizione di plausibilità. Poiché abbiamo costruito un modello con rumore nominale di 0,20 V, un RMS superiore a 0,30 V è un segnale di allarme utile per questo specifico esercizio:
api_rms = gxtxt_api_call(numeric_api, 'array_reduce', ...
    {'rms', residual_operand, struct('axis', 0)});
observed_noise_rms_v = api_rms.values(1);
plausibility_limit_v = 0.30;

% BREAKPOINT: inspect the estimated RMS and selected Dataset.
if observed_noise_rms_v > plausibility_limit_v
  error('Noise RMS %.5f V exceeds %.2f V; check reference Dataset %s.', ...
        observed_noise_rms_v, plausibility_limit_v, reference_dataset_id);
endif
La soglia è specifica del modello simulato, non una tolleranza standard per oscilloscopi, generatori o acquisizioni sperimentali. Con un altro modello o con una differente ampiezza del rumore sarebbe necessario ridefinirla.
7. Individuare l’errore nel debugger GNU Octave
Registriamo lo script errato con uno Script ID distinto. In Run → Debug Session script impostiamo un breakpoint sulla condizione if observed_noise_rms_v > plausibility_limit_v (riga 79 del file distribuito) e selezioniamo Start Debug.
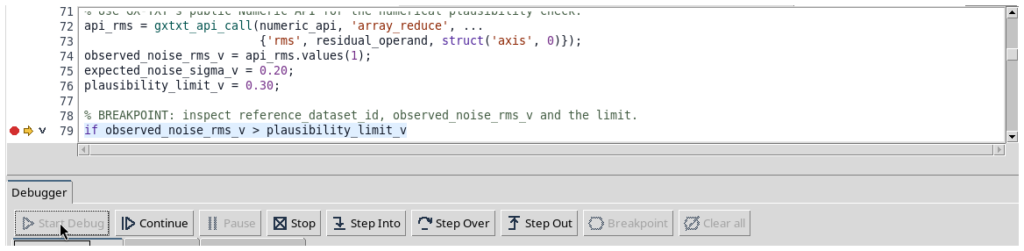
L’esecuzione si arresta prima del controllo. Apriamo Stack and variables e osserviamo i valori locali:
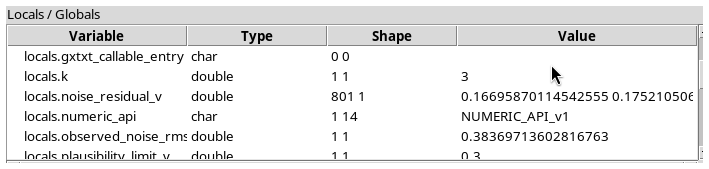
Il RMS calcolato è 0,383697 V, superiore al limite di 0,30 V. Cerchiamo quindi il valore di reference_dataset_id:
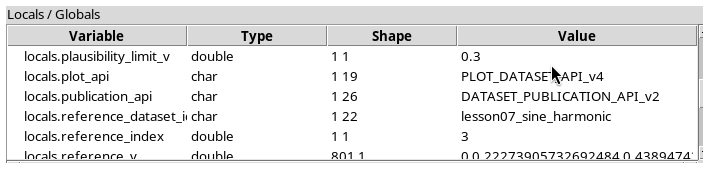
La variabile contiene lesson07_sine_harmonic invece di lesson07_sine_pure. La diagnosi è ora fondata sui dati: abbiamo sottratto un segnale che include una componente armonica estranea al rumore.
Premiamo Continue. La condizione risulta vera e lo script raggiunge l’eccezione intenzionale:
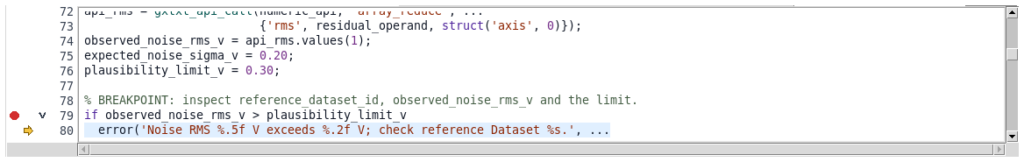
Noise RMS 0.38370 V exceeds 0.30 V; check reference Dataset lesson07_sine_harmonic.
Un debugger serve quindi anche a controllare decisioni scientifiche — scelta del riferimento, unità, allineamento, ipotesi — e non solo a correggere errori di sintassi. In questo caso il fallimento dell’esecuzione è atteso e utile: ci impedisce di pubblicare un residuo mal interpretato.
8. Correggere il riferimento e interpretare le statistiche
Importiamo L09_02_Descriptive_Statistics_Correct.m e scegliamo un nuovo Script ID. La correzione consiste nel selezionare il riferimento fisicamente pertinente:
reference_dataset_id = 'lesson07_sine_pure'; % Correct physical reference.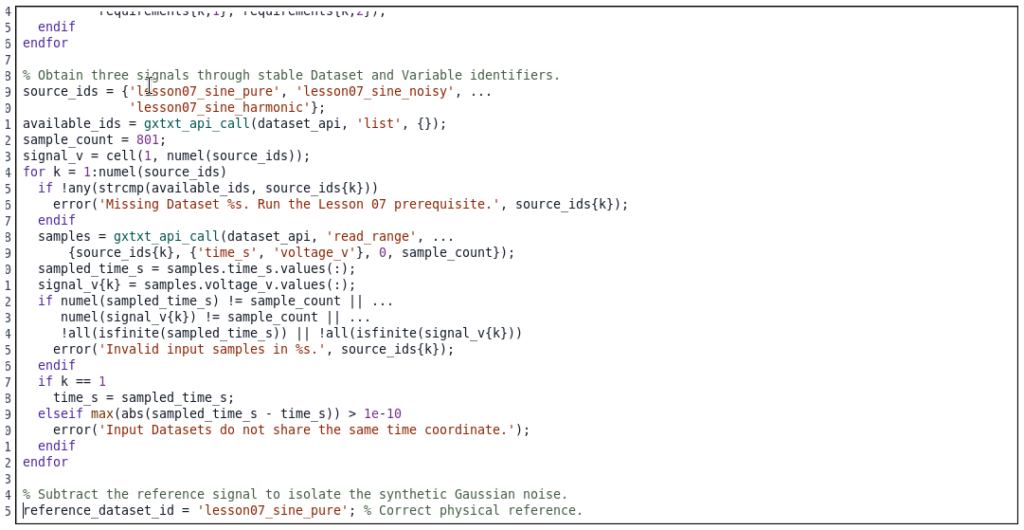
Eseguiamo lo script con Run → Open Script Runner → Run Job. Il gestore dei Job mostra il completamento, mentre il programma restituisce i valori seguenti:

| Statistica | Valore | Unità / interpretazione |
|---|---|---|
| Numero di osservazioni | 801 | campioni |
| Media del residuo | −0,005805 | V |
| Mediana del residuo | −0,003924 | V |
| Deviazione standard campionaria | 0,206560 | V |
| Deviazione standard della popolazione | 0,206431 | V |
| Varianza campionaria | 0,04266717 | V² |
| RMS del residuo | 0,206513 | V |
| Errore standard della media | 0,007298 | V, assumendo osservazioni indipendenti |
La deviazione standard nominale del generatore era 0,20 V, ma una sequenza finita non deve riprodurre esattamente il parametro teorico della distribuzione. La media è vicina a zero, perciò RMS e deviazione standard della popolazione risultano quasi uguali. Il SEM descrive la precisione statistica della media sotto le ipotesi già discusse: non è una dichiarazione di accuratezza o di incertezza strumentale.
Il programma confronta anche le riduzioni della Numeric API con espressioni native GNU Octave. Per gli array considerati, i risultati coincidono entro le tolleranze numeriche previste. Questo confronto verifica i calcoli, ma non sostituisce la riflessione sul significato del dato.
9. Media progressiva, ordinamento e distribuzione cumulativa empirica
9.1 La funzione cumsum() e la media progressiva
La funzione cumsum(v) restituisce un vettore di somme cumulative: ogni posizione contiene la somma dei campioni fino a quel punto. Dividendo ciascuna somma per il numero di osservazioni accumulate otteniamo la media progressiva.
values_v = [2; 4; 6; 8];
running_sum = cumsum(values_v);               % [2; 6; 12; 20]
running_mean = running_sum ./ (1:numel(values_v))';  % [2; 3; 4; 5]
L’operatore ./ divide elemento per elemento. La trasposizione ' rende il vettore dei divisori un vettore colonna, compatibile con la forma prodotta da cumsum. Nel nostro script:
running_mean_v = cumsum(noise_residual_v) ./ (1:sample_count)';La media progressiva è utile per osservare l’evoluzione di una stima, ma non dimostra da sola che una sequenza sia indipendente, stazionaria o sufficientemente lunga. Un appiattimento visivo non equivale a una prova di convergenza statistica.
9.2 La funzione sort() e l’ECDF
Con sort ordiniamo i campioni dal più piccolo al più grande. Associando al campione ordinato in posizione k la frazione k/N costruiamo una funzione di distribuzione cumulativa empirica, o ECDF. La definizione matematica è:
L’indicatrice \(\mathbf{1}\{r_i\le x\}\) vale 1 quando il campione non supera x e 0 altrimenti. Quindi FN(x) misura la frazione di osservazioni inferiori o uguali alla soglia x. Non richiede di assumere preventivamente che la distribuzione sia normale.
values_v = [3; -2; 1; 0];
ordered_v = sort(values_v);       % [-2; 0; 1; 3]
n = numel(ordered_v);            % 4
cdf_fraction = (1:n)' / n;        % [0.25; 0.50; 0.75; 1.00]
Il grafico completo dell’ECDF è teoricamente a gradini, con salti in corrispondenza delle osservazioni. Lo script visualizza i punti ordinati come curva: con dati continui e senza ripetizioni l’andamento è immediatamente leggibile; con osservazioni uguali occorre fare attenzione ai salti verticali della distribuzione cumulativa. La forma sigmoide riscontrata nel nostro esempio è compatibile con il modello gaussiano, ma non costituisce un test di normalità.
9.3 Pubblicare i nuovi Dataset e utilizzare Plot Dataset
Il programma pubblica tre Dataset derivati tramite DATASET_PUBLICATION_API_v2/publish_series_batch, mantenendo identità delle variabili, unità e relazione con i dati originali. I risultati diventano disponibili anche agli altri strumenti GX-TXT.
| Dataset prodotto | Variabile X | Variabile Y |
|---|---|---|
lesson09_noise_residual | time_s | residual_v |
lesson09_running_mean | time_s | running_mean_v |
lesson09_noise_ecdf | residual_v | fraction |
Nella scheda Plots di GX-TXT la prima variante visualizza il rumore residuo e la media progressiva sullo stesso asse temporale:
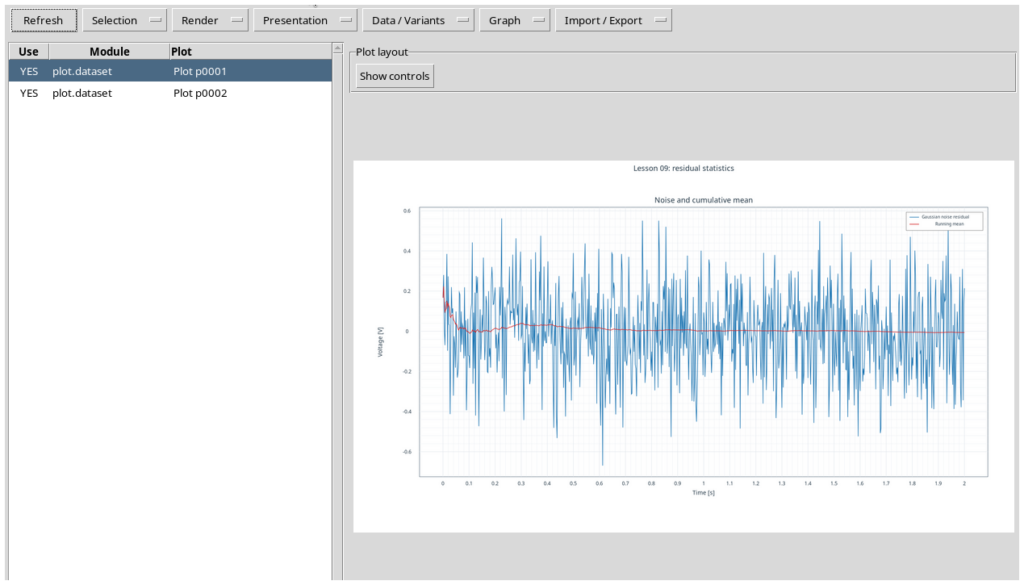
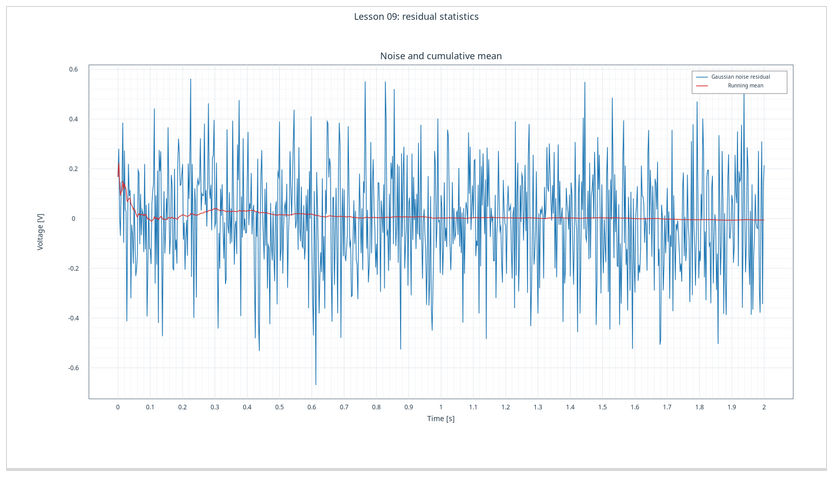
Le oscillazioni rimangono intorno a zero, mentre la media progressiva si avvicina al piccolo valore medio della sequenza. La seconda variante rappresenta la distribuzione cumulativa empirica del rumore in funzione della tensione:
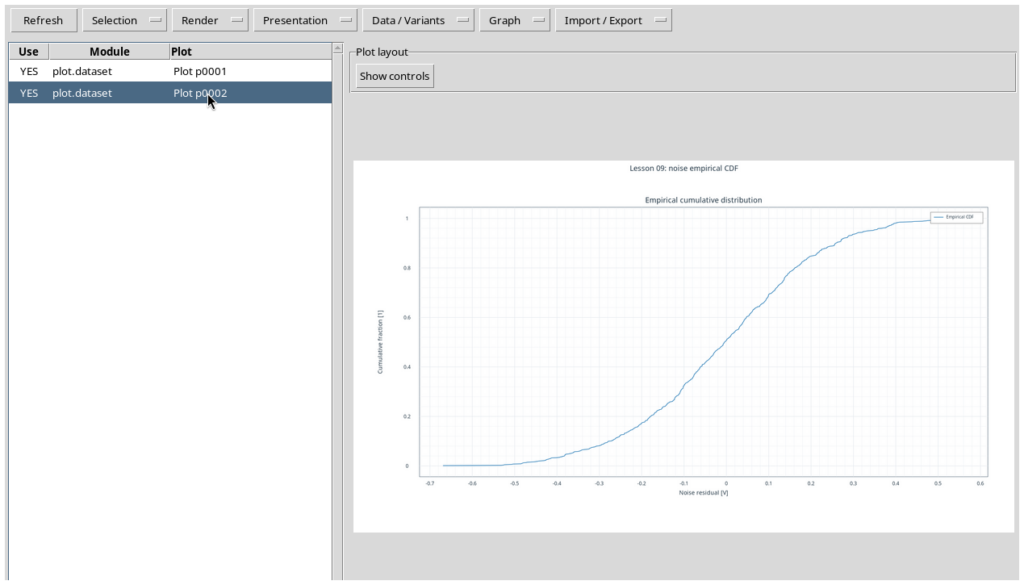
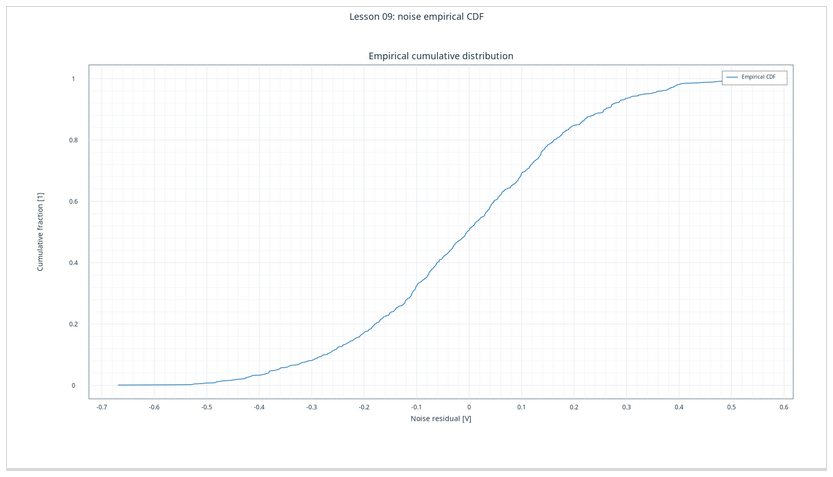
L’ECDF è una descrizione dei campioni osservati. Per valutare quantitativamente la compatibilità con una distribuzione teorica occorrerebbe introdurre ulteriori strumenti, come un confronto con quantili teorici o un test statistico appropriato, argomenti che qui non affrontiamo.
10. Riproducibilità e limiti dell’esperimento
La procedura è riproducibile perché sono specificati il modello di segnale, la frequenza di campionamento, il numero di campioni, il seme pseudocasuale e le operazioni numeriche. Il programma rileva la scelta errata del riferimento, calcola le statistiche della versione corretta e rende disponibili i Dataset e i grafici nella stessa Session.
Un seme identico riproduce una sequenza solo con un generatore e un ambiente compatibili. Le statistiche descrivono questa realizzazione sintetica: non certificano le prestazioni di un dispositivo fisico. Rimangono da approfondire l’eventuale correlazione temporale, la presenza di errori sistematici, gli intervalli di confidenza, l’incertezza di misura e il confronto quantitativo con un modello probabilistico.
11. Esercizi di consolidamento
- Con il vettore
[2;4;6;8], verificare manualmente la somma degli scarti quadratici e calcolare con Octave entrambe le varianze. Spiegare il ruolo di N − 1. - Modificare la deviazione standard del generatore da 0,20 V a 0,10 V, ripetere la procedura in una nuova Session e confrontare i nuovi valori di RMS e deviazione standard.
- Mostrare numericamente che
rms(v)^2 = var(v,1) + mean(v)^2usando l’espressione Octavesqrt(mean(v.^2))per RMS. - Confrontare
std(v,0)estd(v,1)e spiegare perché la loro differenza dipende dal numero di campioni. - Costruire manualmente la media progressiva del vettore
[2;4;6;8]e confrontarla concumsum(v)./(1:numel(v))'. - Costruire i punti ECDF di
[-2;0;1;3]e interpretare il significato di FN(0). Ripetere con due osservazioni uguali e identificare il salto. - Ripetere la generazione con un altro seme e distinguere la variazione delle stime campionarie dalla variazione dei parametri teorici.
- Provare a sostituire il Dataset corretto con quello armonico. Quali controlli del programma continuano a funzionare e quale controllo rende evidente il significato errato del residuo?
Nella Lezione 10 passeremo dall’analisi descrittiva all’interpolazione e al fitting: introdurremo un modello matematico per spiegare e prevedere una relazione fra grandezze sperimentali.
12. Materiale della lezione e documentazione
I tre script sono riportati integralmente nella sezione successiva, in riquadri richiudibili. Il primo genera i Dataset utilizzati per l’esperimento; il secondo contiene un errore scientifico intenzionale; il terzo svolge il calcolo corretto, pubblica i risultati e crea i due grafici GX-TXT. I commenti interni rimangono in inglese, come nel materiale del corso.
API di riferimento: Octave Script Bridge v1; Canonical Dataset v2; Numeric API v1; Dataset Publication v2; Plot Dataset v4.
13. Codice completo degli script GNU Octave
Selezionare il titolo di ciascun riquadro per visualizzare o nascondere il codice integrale. Gli script devono essere importati nell’Octave Script Workspace di GX-TXT, nell’ordine indicato; il programma errato va eseguito con il debugger e la versione corretta con lo Script Runner.
Script 1 — Generazione dei tre segnali sintetici (prerequisito)
File: L09_00_Prerequisite_L07_Signals.m · GNU Octave · commenti in inglese · GPL-3.0-or-later.
% Lesson 07.02 - Publish three synthetic signals in one atomic batch.
% SPDX-License-Identifier: GPL-3.0-or-later
%
% GX-TXT reference: DEV112-P005
% GitHub branch: maintenance/dev112
% Reference commit: 125afdb62110a92199f59a066199bb7f2dc7ed68
%
% Run from the GX-TXT GNU Octave Script Workspace.
% Each Dataset has its own stable identity, schema, and metadata.
% The entire batch is create-only and atomic: any failed publication
% leaves none of the three new Datasets registered.
%
% Use a new Session or change all three IDs before repeating this script.

% The GX-TXT runner already isolates this script's variable workspace.
% Do not use clear here: it would erase the runner's local arguments.

% Step 1: Generate three related 5 Hz signals with a common time axis.
sample_rate_hz = 400;
duration_s = 2;
frequency_hz = 5;
amplitude_v = 1.5;
noise_standard_deviation_v = 0.2;
third_harmonic_amplitude_v = 0.45;

time_s = (0:(sample_rate_hz * duration_s))' / sample_rate_hz;
sample_count = numel(time_s);

rng(707, 'twister');
pure_v = amplitude_v * sin(2 * pi * frequency_hz * time_s);
noisy_v = pure_v + noise_standard_deviation_v * randn(sample_count, 1);
harmonic_v = pure_v + ...
    third_harmonic_amplitude_v * sin(2 * pi * (3 * frequency_hz) * time_s);

signal_values = {pure_v, noisy_v, harmonic_v};
dataset_ids = {'lesson07_sine_pure', 'lesson07_sine_noisy', ...
               'lesson07_sine_harmonic'};
model_labels = {'pure sinusoid', 'sinusoid with Gaussian noise', ...
                'sinusoid with third harmonic'};

for k = 1:numel(signal_values)
  assert(iscolumn(signal_values{k}));
  assert(numel(signal_values{k}) == sample_count);
  assert(all(isfinite(signal_values{k})));
endfor

% Step 2: Verify the public batch writer and public Dataset reader.
publication_api = 'DATASET_PUBLICATION_API_v2';
dataset_api = 'CANONICAL_DATASET_API_v2';
gxtxt_api_require({publication_api, dataset_api});

if !gxtxt_api_has_operation(publication_api, 'publish_series_batch')
  error('The public atomic batch publication operation is unavailable.');
endif

for operation = {'list', 'read_range'}
  if !gxtxt_api_has_operation(dataset_api, operation{1})
    error('Missing Dataset read operation: %s', operation{1});
  endif
endfor

existing_ids = gxtxt_api_call(dataset_api, 'list', {});
for k = 1:numel(dataset_ids)
  if any(strcmp(existing_ids, dataset_ids{k}))
    error('Dataset "%s" already exists. No batch was submitted.', dataset_ids{k});
  endif
endfor

% Step 3: Build the shared Variable Schema v3 declarations.
time_variable = struct( ...
    'variable_id', 'time_s', ...
    'name', 'time_s', ...
    'display_label', 'Elapsed time', ...
    'unit', 's', ...
    'dtype', 'float64', ...
    'value_kind', 'number', ...
    'semantic_role', 'time', ...
    'semantic_source', 'generator');

voltage_variable = struct( ...
    'variable_id', 'voltage_v', ...
    'name', 'voltage_v', ...
    'display_label', 'Simulated voltage', ...
    'unit', 'V', ...
    'dtype', 'float64', ...
    'value_kind', 'number', ...
    'semantic_role', 'voltage', ...
    'semantic_source', 'generator');

% Step 4: Give each output its own scientific metadata and samples.
series_requests = cell(1, numel(dataset_ids));

for k = 1:numel(dataset_ids)
  metadata = struct();
  metadata.('simulation.model') = model_labels{k};
  metadata.('simulation.frequency_hz') = frequency_hz;
  metadata.('simulation.sample_rate_hz') = sample_rate_hz;
  metadata.('simulation.random_seed') = 707;
  metadata.('simulation.noise_std_v') = ...
      (k == 2) * noise_standard_deviation_v;
  metadata.('simulation.third_harmonic_v') = ...
      (k == 3) * third_harmonic_amplitude_v;

  series_requests{k} = struct( ...
      'dataset_id', dataset_ids{k}, ...
      'contract', 'table.generic', ...
      'storage', 'auto', ...
      'x_values', time_s, ...
      'y_values', signal_values{k}, ...
      'x_variable', time_variable, ...
      'y_variable', voltage_variable, ...
      'producer_version', '1.0.0', ...
      'source', 'GNU Octave synthetic signal generator', ...
      'provenance', 'Reproducible Lesson 07 synthetic signal', ...
      'notes', model_labels{k}, ...
      'structured_metadata', metadata);
endfor

% Step 5: Request an atomic publication of all three separate Datasets.
batch_request = struct();
batch_request.series = series_requests;

receipt = gxtxt_api_call(publication_api, 'publish_series_batch', ...
                         {batch_request});

if !receipt.atomic || receipt.output_count != numel(dataset_ids)
  error('The batch publication receipt did not confirm three atomic outputs.');
endif

% Step 6: Verify each published Variable using the public read API.
published_ids = gxtxt_api_call(dataset_api, 'list', {});
for k = 1:numel(dataset_ids)
  assert(any(strcmp(published_ids, dataset_ids{k})));

  samples = gxtxt_api_call(dataset_api, 'read_range', ...
      {dataset_ids{k}, {'time_s', 'voltage_v'}, 0, sample_count});

  read_time_s = samples.time_s.values(:);
  read_voltage_v = samples.voltage_v.values(:);

  assert(numel(read_time_s) == sample_count);
  assert(numel(read_voltage_v) == sample_count);

  time_error = max(abs(read_time_s - time_s));
  voltage_error = max(abs(read_voltage_v - signal_values{k}));

  if time_error > 1e-9 || voltage_error > 1e-9
    error('Read-back verification failed for Dataset "%s".', dataset_ids{k});
  endif

  fprintf('Verified Dataset: %-27s %4d samples, max error %.3g V\n', ...
          dataset_ids{k}, sample_count, voltage_error);
endfor

fprintf('Atomic publication succeeded for %d Datasets.\n', ...
        receipt.output_count);
Script 2 — Riferimento volutamente sbagliato (esercizio di debugging)
File: L09_01_Debug_Wrong_Reference.m · GNU Octave · commenti in inglese · GPL-3.0-or-later.
% Lesson 09 - Descriptive statistics for experimental signal residuals
% Course: GNU Octave with GX-TXT | GX-TXT DEV112-P005
% GitHub reference: maintenance/dev112
% Source commit: 125afdb62110a92199f59a066199bb7f2dc7ed68
% SPDX-License-Identifier: GPL-3.0-or-later
%
% Run as a GX-TXT managed GNU Octave Session script.
% Prerequisite: the three Lesson 07 signals have been published.
% The Script Bridge is managed by GX-TXT; do not start it manually.
% All Dataset and plot operations use public framework APIs.
% Use a new Session: derived Dataset IDs are intentionally create-only.

dataset_api = 'CANONICAL_DATASET_API_v2';
numeric_api = 'NUMERIC_API_v1';
publication_api = 'DATASET_PUBLICATION_API_v2';
plot_api = 'PLOT_DATASET_API_v4';
gxtxt_api_require({dataset_api, numeric_api, publication_api, plot_api});

requirements = {
  dataset_api, 'list';
  dataset_api, 'read_range';
  numeric_api, 'array_reduce';
  numeric_api, 'statistics';
  publication_api, 'publish_series_batch';
  plot_api, 'new_spec';
  plot_api, 'validate_spec';
  plot_api, 'upsert_plot';
  plot_api, 'render';
  plot_api, 'artifacts'
};
for k = 1:rows(requirements)
  if !gxtxt_api_has_operation(requirements{k,1}, requirements{k,2})
    error('Missing public operation %s/%s.', ...
          requirements{k,1}, requirements{k,2});
  endif
endfor

% Obtain three signals through stable Dataset and Variable identifiers.
source_ids = {'lesson07_sine_pure', 'lesson07_sine_noisy', ...
              'lesson07_sine_harmonic'};
available_ids = gxtxt_api_call(dataset_api, 'list', {});
sample_count = 801;
signal_v = cell(1, numel(source_ids));
for k = 1:numel(source_ids)
  if !any(strcmp(available_ids, source_ids{k}))
    error('Missing Dataset %s. Run the Lesson 07 prerequisite.', source_ids{k});
  endif
  samples = gxtxt_api_call(dataset_api, 'read_range', ...
      {source_ids{k}, {'time_s', 'voltage_v'}, 0, sample_count});
  sampled_time_s = samples.time_s.values(:);
  signal_v{k} = samples.voltage_v.values(:);
  if numel(sampled_time_s) != sample_count || ...
     numel(signal_v{k}) != sample_count || ...
     !all(isfinite(sampled_time_s)) || !all(isfinite(signal_v{k}))
    error('Invalid input samples in %s.', source_ids{k});
  endif
  if k == 1
    time_s = sampled_time_s;
  elseif max(abs(sampled_time_s - time_s)) > 1e-10
    error('Input Datasets do not share the same time coordinate.');
  endif
endfor

% Subtract the reference signal to isolate the synthetic Gaussian noise.
reference_dataset_id = 'lesson07_sine_harmonic'; % INTENTIONAL BUG: use the pure signal.
reference_index = find(strcmp(source_ids, reference_dataset_id));
reference_v = signal_v{reference_index};
noise_residual_v = signal_v{2} - reference_v;
residual_operand = struct('kind', 'vector', 'value', noise_residual_v);

% Use GX-TXT's public Numeric API for the numerical plausibility check.
api_rms = gxtxt_api_call(numeric_api, 'array_reduce', ...
                         {'rms', residual_operand, struct('axis', 0)});
observed_noise_rms_v = api_rms.values(1);
expected_noise_sigma_v = 0.20;
plausibility_limit_v = 0.30;

% BREAKPOINT: inspect reference_dataset_id, observed_noise_rms_v and the limit.
if observed_noise_rms_v > plausibility_limit_v
  error('Noise RMS %.5f V exceeds %.2f V; check reference Dataset %s.', ...
        observed_noise_rms_v, plausibility_limit_v, reference_dataset_id);
endif

% Compare native Octave statistics with the public numerical operations.
api_mean = gxtxt_api_call(numeric_api, 'array_reduce', ...
                          {'mean', residual_operand, struct('axis', 0)});
api_sample_std = gxtxt_api_call(numeric_api, 'array_reduce', ...
                                {'std_sample', residual_operand, struct('axis', 0)});
api_statistics = gxtxt_api_call(numeric_api, 'statistics', ...
                                {noise_residual_v, struct()});
mean_v = mean(noise_residual_v);
median_v = median(noise_residual_v);
population_std_v = std(noise_residual_v, 1);
sample_std_v = std(noise_residual_v, 0);
variance_sample_v2 = var(noise_residual_v, 0);
rms_native_v = sqrt(mean(noise_residual_v .^ 2));
standard_error_v = sample_std_v / sqrt(sample_count);
assert(abs(api_mean.values(1) - mean_v) < 1e-10);
assert(abs(api_sample_std.values(1) - sample_std_v) < 1e-9);
assert(abs(observed_noise_rms_v - rms_native_v) < 1e-10);

% The empirical CDF is monotone and uses original residual values.
sorted_noise_v = sort(noise_residual_v);
cumulative_fraction = (1:sample_count)' / sample_count;
running_mean_v = cumsum(noise_residual_v) ./ (1:sample_count)';

fprintf('Descriptive statistics: %d synthetic noise residuals\n', sample_count);
fprintf('Mean = %.6f V; median = %.6f V\n', mean_v, median_v);
fprintf('Sample SD = %.6f V; population SD = %.6f V\n', ...
        sample_std_v, population_std_v);
fprintf('Sample variance = %.8f V^2; RMS = %.6f V\n', ...
        variance_sample_v2, observed_noise_rms_v);
fprintf('SEM = %.6f V (assumes independent observations)\n', ...
        standard_error_v);
disp('GX-TXT Numeric API statistics receipt:');
disp(api_statistics);

% Publish three independent derived scientific Datasets atomically.
derived_ids = {'lesson09_noise_residual', 'lesson09_running_mean', ...
               'lesson09_noise_ecdf'};
existing_ids = gxtxt_api_call(dataset_api, 'list', {});
for k = 1:numel(derived_ids)
  if any(strcmp(existing_ids, derived_ids{k}))
    error('Derived Dataset %s already exists: use a fresh Session.', derived_ids{k});
  endif
endfor

time_variable = struct('variable_id', 'time_s', 'name', 'time_s', ...
    'display_label', 'Elapsed time', 'unit', 's', 'dtype', 'float64', ...
    'value_kind', 'number', 'semantic_role', 'time', ...
    'semantic_source', 'plugin');
residual_variable = struct('variable_id', 'residual_v', ...
    'name', 'residual_v', 'display_label', 'Noise residual', ...
    'unit', 'V', 'dtype', 'float64', 'value_kind', 'number', ...
    'semantic_role', 'voltage', 'semantic_source', 'plugin');
mean_variable = struct('variable_id', 'running_mean_v', ...
    'name', 'running_mean_v', 'display_label', 'Running mean', ...
    'unit', 'V', 'dtype', 'float64', 'value_kind', 'number', ...
    'semantic_role', 'voltage', 'semantic_source', 'plugin');
fraction_variable = struct('variable_id', 'fraction', ...
    'name', 'fraction', 'display_label', 'Empirical cumulative fraction', ...
    'unit', '1', 'dtype', 'float64', 'value_kind', 'number', ...
    'semantic_role', 'fraction', 'semantic_source', 'plugin');

x_values = {time_s, time_s, sorted_noise_v};
y_values = {noise_residual_v, running_mean_v, cumulative_fraction};
x_variables = {time_variable, time_variable, residual_variable};
y_variables = {residual_variable, mean_variable, fraction_variable};
descriptions = {'Noise residual vs time', ...
                'Running mean of the noise residual', ...
                'Empirical cumulative distribution of noise residuals'};
series_requests = cell(1, numel(derived_ids));
for k = 1:numel(derived_ids)
  metadata = struct();
  metadata.('analysis.kind') = descriptions{k};
  metadata.('analysis.reference_dataset') = reference_dataset_id;
  metadata.('analysis.input_samples') = sample_count;
  metadata.('analysis.expected_noise_sigma_v') = expected_noise_sigma_v;
  metadata.('analysis.sample_std_v') = sample_std_v;
  series_requests{k} = struct( ...
      'dataset_id', derived_ids{k}, 'contract', 'table.generic', ...
      'storage', 'auto', 'x_values', x_values{k}, ...
      'y_values', y_values{k}, ...
      'x_variable', x_variables{k}, 'y_variable', y_variables{k}, ...
      'producer_version', '1.0.0', ...
      'source', 'GX-TXT Octave Lesson 09', ...
      'provenance', 'Derived from Lesson 07 canonical signals', ...
      'source_dataset_ids', {source_ids}, ...
      'notes', descriptions{k}, 'structured_metadata', metadata);
endfor
batch = struct('series', {series_requests});
receipt = gxtxt_api_call(publication_api, 'publish_series_batch', {batch});
if !receipt.atomic || receipt.output_count != numel(derived_ids)
  error('Atomic publication did not confirm three derived Datasets.');
endif

% Read derived values back from the public canonical Dataset API.
published = gxtxt_api_call(dataset_api, 'list', {});
for k = 1:numel(derived_ids)
  if !any(strcmp(published, derived_ids{k}))
    error('Published Dataset %s is absent.', derived_ids{k});
  endif
  saved = gxtxt_api_call(dataset_api, 'read_range', ...
      {derived_ids{k}, ...
       {x_variables{k}.variable_id, y_variables{k}.variable_id}, ...
       0, sample_count});
  recovered = saved.(y_variables{k}.variable_id).values(:);
  if max(abs(recovered - y_values{k})) > 1e-9
    error('Read-back mismatch for %s.', derived_ids{k});
  endif
endfor

% Plot 1: noise residual and its running mean on a single GX-TXT plot.
trend = gxtxt_api_call(plot_api, 'new_spec', ...
                       {'plot.dataset.xy', 'Lesson 09: residual statistics'});
panel = trend.panels{1};
panel.id = 'noise_overview';
panel.title = 'Noise and cumulative mean';
panel.axes = struct('x', struct('label', 'Time [s]', 'scale', 'linear'), ...
    'y_left', struct('label', 'Voltage [V]', 'scale', 'linear'));
panel.series = {
  struct('id', 'noise', 'label', 'Gaussian noise residual', ...
         'dataset_id', derived_ids{1}, 'x_variable_id', 'time_s', ...
         'y_variable_id', 'residual_v', 'axis', 'left', 'kind', 'line'),
  struct('id', 'running_mean', 'label', 'Running mean', ...
         'dataset_id', derived_ids{2}, 'x_variable_id', 'time_s', ...
         'y_variable_id', 'running_mean_v', 'axis', 'left', 'kind', 'line')
};
trend.panels = {panel};
if !gxtxt_api_call(plot_api, 'validate_spec', {trend})
  error('Residual PlotSpec failed public validation.');
endif
trend_ref = gxtxt_api_call(plot_api, 'upsert_plot', ...
                           {'lesson09_noise_overview', trend});
gxtxt_api_call(plot_api, 'render', {trend_ref});
trend_artifacts = gxtxt_api_call(plot_api, 'artifacts', {trend_ref});

% Plot 2: empirical cumulative distribution of the observed noise.
distribution = gxtxt_api_call(plot_api, 'new_spec', ...
                       {'plot.dataset.xy', 'Lesson 09: noise empirical CDF'});
cdf_panel = distribution.panels{1};
cdf_panel.id = 'noise_cdf';
cdf_panel.title = 'Empirical cumulative distribution';
cdf_panel.axes = struct( ...
    'x', struct('label', 'Noise residual [V]', 'scale', 'linear'), ...
    'y_left', struct('label', 'Cumulative fraction [1]', 'scale', 'linear'));
cdf_panel.series = {struct( ...
    'id', 'ecdf', 'label', 'Empirical CDF', ...
    'dataset_id', derived_ids{3}, ...
    'x_variable_id', 'residual_v', 'y_variable_id', 'fraction', ...
    'axis', 'left', 'kind', 'line')};
distribution.panels = {cdf_panel};
if !gxtxt_api_call(plot_api, 'validate_spec', {distribution})
  error('Empirical-CDF PlotSpec failed public validation.');
endif
cdf_ref = gxtxt_api_call(plot_api, 'upsert_plot', ...
                         {'lesson09_noise_ecdf', distribution});
gxtxt_api_call(plot_api, 'render', {cdf_ref});
cdf_artifacts = gxtxt_api_call(plot_api, 'artifacts', {cdf_ref});

fprintf('PASS: 3 canonical derived Datasets and 2 persistent GX-TXT plots.\n');
disp(trend_artifacts);
disp(cdf_artifacts);
Script 3 — Statistiche descrittive, Dataset e grafici (versione corretta)
File: L09_02_Descriptive_Statistics_Correct.m · GNU Octave · commenti in inglese · GPL-3.0-or-later.
% Lesson 09 - Descriptive statistics for experimental signal residuals
% Course: GNU Octave with GX-TXT | GX-TXT DEV112-P005
% GitHub reference: maintenance/dev112
% Source commit: 125afdb62110a92199f59a066199bb7f2dc7ed68
% SPDX-License-Identifier: GPL-3.0-or-later
%
% Run as a GX-TXT managed GNU Octave Session script.
% Prerequisite: the three Lesson 07 signals have been published.
% The Script Bridge is managed by GX-TXT; do not start it manually.
% All Dataset and plot operations use public framework APIs.
% Use a new Session: derived Dataset IDs are intentionally create-only.

dataset_api = 'CANONICAL_DATASET_API_v2';
numeric_api = 'NUMERIC_API_v1';
publication_api = 'DATASET_PUBLICATION_API_v2';
plot_api = 'PLOT_DATASET_API_v4';
gxtxt_api_require({dataset_api, numeric_api, publication_api, plot_api});

requirements = {
  dataset_api, 'list';
  dataset_api, 'read_range';
  numeric_api, 'array_reduce';
  numeric_api, 'statistics';
  publication_api, 'publish_series_batch';
  plot_api, 'new_spec';
  plot_api, 'validate_spec';
  plot_api, 'upsert_plot';
  plot_api, 'render';
  plot_api, 'artifacts'
};
for k = 1:rows(requirements)
  if !gxtxt_api_has_operation(requirements{k,1}, requirements{k,2})
    error('Missing public operation %s/%s.', ...
          requirements{k,1}, requirements{k,2});
  endif
endfor

% Obtain three signals through stable Dataset and Variable identifiers.
source_ids = {'lesson07_sine_pure', 'lesson07_sine_noisy', ...
              'lesson07_sine_harmonic'};
available_ids = gxtxt_api_call(dataset_api, 'list', {});
sample_count = 801;
signal_v = cell(1, numel(source_ids));
for k = 1:numel(source_ids)
  if !any(strcmp(available_ids, source_ids{k}))
    error('Missing Dataset %s. Run the Lesson 07 prerequisite.', source_ids{k});
  endif
  samples = gxtxt_api_call(dataset_api, 'read_range', ...
      {source_ids{k}, {'time_s', 'voltage_v'}, 0, sample_count});
  sampled_time_s = samples.time_s.values(:);
  signal_v{k} = samples.voltage_v.values(:);
  if numel(sampled_time_s) != sample_count || ...
     numel(signal_v{k}) != sample_count || ...
     !all(isfinite(sampled_time_s)) || !all(isfinite(signal_v{k}))
    error('Invalid input samples in %s.', source_ids{k});
  endif
  if k == 1
    time_s = sampled_time_s;
  elseif max(abs(sampled_time_s - time_s)) > 1e-10
    error('Input Datasets do not share the same time coordinate.');
  endif
endfor

% Subtract the reference signal to isolate the synthetic Gaussian noise.
reference_dataset_id = 'lesson07_sine_pure'; % Correct physical reference.
reference_index = find(strcmp(source_ids, reference_dataset_id));
reference_v = signal_v{reference_index};
noise_residual_v = signal_v{2} - reference_v;
residual_operand = struct('kind', 'vector', 'value', noise_residual_v);

% Use GX-TXT's public Numeric API for the numerical plausibility check.
api_rms = gxtxt_api_call(numeric_api, 'array_reduce', ...
                         {'rms', residual_operand, struct('axis', 0)});
observed_noise_rms_v = api_rms.values(1);
expected_noise_sigma_v = 0.20;
plausibility_limit_v = 0.30;

% BREAKPOINT: inspect reference_dataset_id, observed_noise_rms_v and the limit.
if observed_noise_rms_v > plausibility_limit_v
  error('Noise RMS %.5f V exceeds %.2f V; check reference Dataset %s.', ...
        observed_noise_rms_v, plausibility_limit_v, reference_dataset_id);
endif

% Compare native Octave statistics with the public numerical operations.
api_mean = gxtxt_api_call(numeric_api, 'array_reduce', ...
                          {'mean', residual_operand, struct('axis', 0)});
api_sample_std = gxtxt_api_call(numeric_api, 'array_reduce', ...
                                {'std_sample', residual_operand, struct('axis', 0)});
api_statistics = gxtxt_api_call(numeric_api, 'statistics', ...
                                {noise_residual_v, struct()});
mean_v = mean(noise_residual_v);
median_v = median(noise_residual_v);
population_std_v = std(noise_residual_v, 1);
sample_std_v = std(noise_residual_v, 0);
variance_sample_v2 = var(noise_residual_v, 0);
rms_native_v = sqrt(mean(noise_residual_v .^ 2));
standard_error_v = sample_std_v / sqrt(sample_count);
assert(abs(api_mean.values(1) - mean_v) < 1e-10);
assert(abs(api_sample_std.values(1) - sample_std_v) < 1e-9);
assert(abs(observed_noise_rms_v - rms_native_v) < 1e-10);

% The empirical CDF is monotone and uses original residual values.
sorted_noise_v = sort(noise_residual_v);
cumulative_fraction = (1:sample_count)' / sample_count;
running_mean_v = cumsum(noise_residual_v) ./ (1:sample_count)';

fprintf('Descriptive statistics: %d synthetic noise residuals\n', sample_count);
fprintf('Mean = %.6f V; median = %.6f V\n', mean_v, median_v);
fprintf('Sample SD = %.6f V; population SD = %.6f V\n', ...
        sample_std_v, population_std_v);
fprintf('Sample variance = %.8f V^2; RMS = %.6f V\n', ...
        variance_sample_v2, observed_noise_rms_v);
fprintf('SEM = %.6f V (assumes independent observations)\n', ...
        standard_error_v);
disp('GX-TXT Numeric API statistics receipt:');
disp(api_statistics);

% Publish three independent derived scientific Datasets atomically.
derived_ids = {'lesson09_noise_residual', 'lesson09_running_mean', ...
               'lesson09_noise_ecdf'};
existing_ids = gxtxt_api_call(dataset_api, 'list', {});
for k = 1:numel(derived_ids)
  if any(strcmp(existing_ids, derived_ids{k}))
    error('Derived Dataset %s already exists: use a fresh Session.', derived_ids{k});
  endif
endfor

time_variable = struct('variable_id', 'time_s', 'name', 'time_s', ...
    'display_label', 'Elapsed time', 'unit', 's', 'dtype', 'float64', ...
    'value_kind', 'number', 'semantic_role', 'time', ...
    'semantic_source', 'plugin');
residual_variable = struct('variable_id', 'residual_v', ...
    'name', 'residual_v', 'display_label', 'Noise residual', ...
    'unit', 'V', 'dtype', 'float64', 'value_kind', 'number', ...
    'semantic_role', 'voltage', 'semantic_source', 'plugin');
mean_variable = struct('variable_id', 'running_mean_v', ...
    'name', 'running_mean_v', 'display_label', 'Running mean', ...
    'unit', 'V', 'dtype', 'float64', 'value_kind', 'number', ...
    'semantic_role', 'voltage', 'semantic_source', 'plugin');
fraction_variable = struct('variable_id', 'fraction', ...
    'name', 'fraction', 'display_label', 'Empirical cumulative fraction', ...
    'unit', '1', 'dtype', 'float64', 'value_kind', 'number', ...
    'semantic_role', 'fraction', 'semantic_source', 'plugin');

x_values = {time_s, time_s, sorted_noise_v};
y_values = {noise_residual_v, running_mean_v, cumulative_fraction};
x_variables = {time_variable, time_variable, residual_variable};
y_variables = {residual_variable, mean_variable, fraction_variable};
descriptions = {'Noise residual vs time', ...
                'Running mean of the noise residual', ...
                'Empirical cumulative distribution of noise residuals'};
series_requests = cell(1, numel(derived_ids));
for k = 1:numel(derived_ids)
  metadata = struct();
  metadata.('analysis.kind') = descriptions{k};
  metadata.('analysis.reference_dataset') = reference_dataset_id;
  metadata.('analysis.input_samples') = sample_count;
  metadata.('analysis.expected_noise_sigma_v') = expected_noise_sigma_v;
  metadata.('analysis.sample_std_v') = sample_std_v;
  series_requests{k} = struct( ...
      'dataset_id', derived_ids{k}, 'contract', 'table.generic', ...
      'storage', 'auto', 'x_values', x_values{k}, ...
      'y_values', y_values{k}, ...
      'x_variable', x_variables{k}, 'y_variable', y_variables{k}, ...
      'producer_version', '1.0.0', ...
      'source', 'GX-TXT Octave Lesson 09', ...
      'provenance', 'Derived from Lesson 07 canonical signals', ...
      'source_dataset_ids', {source_ids}, ...
      'notes', descriptions{k}, 'structured_metadata', metadata);
endfor
batch = struct('series', {series_requests});
receipt = gxtxt_api_call(publication_api, 'publish_series_batch', {batch});
if !receipt.atomic || receipt.output_count != numel(derived_ids)
  error('Atomic publication did not confirm three derived Datasets.');
endif

% Read derived values back from the public canonical Dataset API.
published = gxtxt_api_call(dataset_api, 'list', {});
for k = 1:numel(derived_ids)
  if !any(strcmp(published, derived_ids{k}))
    error('Published Dataset %s is absent.', derived_ids{k});
  endif
  saved = gxtxt_api_call(dataset_api, 'read_range', ...
      {derived_ids{k}, ...
       {x_variables{k}.variable_id, y_variables{k}.variable_id}, ...
       0, sample_count});
  recovered = saved.(y_variables{k}.variable_id).values(:);
  if max(abs(recovered - y_values{k})) > 1e-9
    error('Read-back mismatch for %s.', derived_ids{k});
  endif
endfor

% Plot 1: noise residual and its running mean on a single GX-TXT plot.
trend = gxtxt_api_call(plot_api, 'new_spec', ...
                       {'plot.dataset.xy', 'Lesson 09: residual statistics'});
panel = trend.panels{1};
panel.id = 'noise_overview';
panel.title = 'Noise and cumulative mean';
panel.axes = struct('x', struct('label', 'Time [s]', 'scale', 'linear'), ...
    'y_left', struct('label', 'Voltage [V]', 'scale', 'linear'));
panel.series = {
  struct('id', 'noise', 'label', 'Gaussian noise residual', ...
         'dataset_id', derived_ids{1}, 'x_variable_id', 'time_s', ...
         'y_variable_id', 'residual_v', 'axis', 'left', 'kind', 'line'),
  struct('id', 'running_mean', 'label', 'Running mean', ...
         'dataset_id', derived_ids{2}, 'x_variable_id', 'time_s', ...
         'y_variable_id', 'running_mean_v', 'axis', 'left', 'kind', 'line')
};
trend.panels = {panel};
if !gxtxt_api_call(plot_api, 'validate_spec', {trend})
  error('Residual PlotSpec failed public validation.');
endif
trend_ref = gxtxt_api_call(plot_api, 'upsert_plot', ...
                           {'lesson09_noise_overview', trend});
gxtxt_api_call(plot_api, 'render', {trend_ref});
trend_artifacts = gxtxt_api_call(plot_api, 'artifacts', {trend_ref});

% Plot 2: empirical cumulative distribution of the observed noise.
distribution = gxtxt_api_call(plot_api, 'new_spec', ...
                       {'plot.dataset.xy', 'Lesson 09: noise empirical CDF'});
cdf_panel = distribution.panels{1};
cdf_panel.id = 'noise_cdf';
cdf_panel.title = 'Empirical cumulative distribution';
cdf_panel.axes = struct( ...
    'x', struct('label', 'Noise residual [V]', 'scale', 'linear'), ...
    'y_left', struct('label', 'Cumulative fraction [1]', 'scale', 'linear'));
cdf_panel.series = {struct( ...
    'id', 'ecdf', 'label', 'Empirical CDF', ...
    'dataset_id', derived_ids{3}, ...
    'x_variable_id', 'residual_v', 'y_variable_id', 'fraction', ...
    'axis', 'left', 'kind', 'line')};
distribution.panels = {cdf_panel};
if !gxtxt_api_call(plot_api, 'validate_spec', {distribution})
  error('Empirical-CDF PlotSpec failed public validation.');
endif
cdf_ref = gxtxt_api_call(plot_api, 'upsert_plot', ...
                         {'lesson09_noise_ecdf', distribution});
gxtxt_api_call(plot_api, 'render', {cdf_ref});
cdf_artifacts = gxtxt_api_call(plot_api, 'artifacts', {cdf_ref});

fprintf('PASS: 3 canonical derived Datasets and 2 persistent GX-TXT plots.\n');
disp(trend_artifacts);
disp(cdf_artifacts);
Altre tappe del progetto
- Lezione 01 — Il primo script GNU Octave in GX-TXT
- Lezione 02 — Variabili, tipi di dati e operatori in GNU Octave con GX-TXT
- Lezione 03 — Vettori e matrici in GNU Octave con GX-TXT: analisi di misure di temperatura
- Lezione 04 — condizioni, cicli e funzioni. Simuliamo la legge di raffreddamento di Newton
- Lezione 05: Dataset scientifici e Variable ID
- Lezione 06 — Selezione e lettura dei dati sperimentali con GNU Octave e GX-TXT