
Lezione 10 – Interpolazione e fitting: una curva di calibrazione analitica
Corso di programmazione scientifica con GNU Octave e le API pubbliche di GX-TXT.
Nelle lezioni precedenti abbiamo imparato a lavorare con i Dataset, a rappresentare i risultati scientifici e a calcolare statistiche descrittive. In questa lezione utilizzeremo i dati per costruire un modello matematico: partiremo da nove standard sintetici, confronteremo interpolazione e regressione, esamineremo i residui e determineremo la concentrazione di un campione incognito.
Collegamento con le lezioni precedenti
Nelle Lezioni 05–07 abbiamo introdotto Dataset ID, Variable ID e pubblicazione dei risultati; la Lezione 08 ha presentato i grafici persistenti e il debugger; la Lezione 09 ha spiegato le statistiche descrittive. Adesso non ci limitiamo a descrivere i dati: stimiamo una relazione matematica e ne valutiamo le capacità predittive. Ritroveremo sort(), RMS e Dataset canonici, ma applicati a un problema nuovo.
Le novità principali sono linspace(), polyval(), la regressione ai minimi quadrati, l’interpolazione, i residui di un modello e le operazioni pubbliche linear_regression, interpolate e polynomial_fit.
Il percorso comprende anche un errore intenzionale e la sua individuazione con il debugger nativo di GNU Octave. I risultati saranno pubblicati come Dataset e grafici persistenti di GX-TXT, senza accedere ai file interni del framework.
Prerequisiti: le conoscenze delle Lezioni 05–09, oppure familiarità con vettori e funzioni Octave, Dataset ID, Variable ID e Octave Script Workspace. Per ripetere l’esercizio completo occorre creare una nuova Session GX-TXT: gli script pubblicano Dataset con identificativi espliciti e non sovrascrivono quelli già presenti.
Importante: tutti i valori di assorbanza e concentrazione sono sintetici e deterministici, creati per scopi didattici. Non sono risultati sperimentali, standard certificati o dati di validazione di un metodo analitico.
1. Obiettivi della lezione
Alla fine saremo in grado di distinguere interpolazione e fitting, ordinare correttamente osservazioni accoppiate, calcolare una regressione lineare ai minimi quadrati, confrontarla con un polinomio di secondo grado, interpretare residui e coefficiente di determinazione, stimare una concentrazione incognita all’interno dell’intervallo di calibrazione e utilizzare le API pubbliche GX-TXT per conservare e rappresentare i risultati.
2. Il nostro esperimento: concentrazione e assorbanza
Consideriamo una misura ottica, indicata con l’assorbanza \(A\), effettuata su soluzioni con concentrazione nota \(C\), espressa in mg/L. Nell’intervallo scelto ci aspettiamo una relazione approssimativamente lineare:
\[ A = a + bC + \varepsilon \]
Qui \(a\) è l’intercetta, \(b\) è la pendenza e \(\varepsilon\) rappresenta la parte di segnale non spiegata dal modello. Non imponiamo una retta perfetta: i coefficienti dovranno essere stimati dai dati.
| Concentrazione \(C\) (mg/L) | Assorbanza sintetica \(A\) |
|---|---|
| 0 | 0,010 |
| 1 | 0,096 |
| 2 | 0,177 |
| 3 | 0,258 |
| 4 | 0,343 |
| 5 | 0,423 |
| 7 | 0,589 |
| 9 | 0,748 |
| 11 | 0,915 |
Il nostro campione incognito avrà assorbanza 0,462. La sua concentrazione non è riportata nella tabella: la ricaveremo dal modello.
L’assorbanza è una grandezza adimensionale; nei metadati del Dataset la sua unità sarà quindi 1, mentre la concentrazione sarà espressa in mg/L. Questa distinzione è utile anche quando i dati sono elaborati automaticamente da altre componenti di GX-TXT.
Approfondimento — Assorbanza e legge di Beer-Lambert
Nella spettrofotometria l’assorbanza decimale è definita mediante il rapporto fra intensità luminosa di riferimento \(I_0\) e intensità trasmessa \(I\):
\[A = \log_{10}\!\left(\frac{I_0}{I}\right).\]
Essendo il logaritmo di un rapporto fra grandezze omogenee, l’assorbanza è adimensionale. In condizioni ideali, la legge di Beer-Lambert permette di scrivere \(A=\varepsilon\,l\,C\), dove \(l\) è il cammino ottico. Una calibrazione reale può però presentare intercetta diversa da zero, effetti di matrice, limiti di linearità e rumore. Per questo stimiamo anche il termine \(a\), anziché imporre che la retta passi per l’origine.
3. GNU Octave: vettori, ordinamento e corrispondenza delle osservazioni
In Octave possiamo rappresentare le due colonne della tabella mediante vettori colonna. Il punto e virgola separa gli elementi; i valori nella stessa posizione descrivono lo stesso standard.
concentration_mg_L = [0; 1; 2; 3; 4; 5; 7; 9; 11];
absorbance_au = [0.010; 0.096; 0.177; 0.258; 0.343; ...
                 0.423; 0.589; 0.748; 0.915];
assert(numel(concentration_mg_L) == numel(absorbance_au));
La funzione numel() conta gli elementi di un array; assert() interrompe l’esecuzione quando una condizione non è soddisfatta. diff() calcola le differenze fra elementi consecutivi, mentre all() verifica se tutte le condizioni risultano vere.
Per interpolare occorre che le ascisse siano strettamente crescenti, senza duplicati. sort() può restituire sia il vettore ordinato sia la permutazione degli indici utilizzata:
[ordered_x, permutation] = sort(concentration_mg_L);
ordered_y = absorbance_au(permutation);
assert(all(diff(ordered_x) > 0));
La seconda istruzione è fondamentale: applicando la stessa permutazione alle assorbanze, conserviamo le coppie concentrazione–segnale. Ordinare soltanto le concentrazioni potrebbe associare un’assorbanza allo standard sbagliato, producendo risultati numericamente plausibili ma scientificamente errati.
Approfondimento Octave — Che cosa contiene la permutazione?
Immaginiamo tre coppie concentrazione–assorbanza registrate fuori ordine. sort() restituisce due risultati: le ascisse ordinate e gli indici delle posizioni originali. Questi indici devono essere applicati anche alle ordinate:
x = [2; 0; 1];
y = [0.177; 0.010; 0.096];
[x_sorted, indices] = sort(x);
y_sorted = y(indices);
% x_sorted = [0; 1; 2]
% y_sorted = [0.010; 0.096; 0.177]
La differenza rispetto all’uso statistico di sort() nella Lezione 09 è importante: ora l’ordine conserva l’identità di ogni osservazione accoppiata. Il controllo all(diff(x_sorted) > 0) richiede inoltre ascisse distinte; due standard con uguale concentrazione andrebbero gestiti esplicitamente come repliche, non riordinati in modo arbitrario.
4. Interpolazione e regressione non sono la stessa operazione
Interpolare significa costruire una curva che passa per i punti disponibili. Con l’interpolazione lineare a tratti, due standard consecutivi vengono uniti da un segmento. In corrispondenza della concentrazione misurata, la curva restituisce esattamente l’assorbanza di quello standard, comprese eventuali oscillazioni casuali.
Approfondimento matematico — Interpolazione lineare fra due standard
Se la concentrazione cercata \(C\) è compresa fra due standard adiacenti \((C_1,A_1)\) e \((C_2,A_2)\), la risposta interpolata è:
\[A_{\mathrm{int}}(C)=A_1+\frac{A_2-A_1}{C_2-C_1}(C-C_1),\quad C_1\le C\le C_2.\]
Tra 4 e 5 mg/L abbiamo i segnali sintetici 0,343 e 0,423. A 4,5 mg/L otteniamo 0,383. La retta di regressione calcolata sui nove standard fornisce invece circa 0,381774. Il primo risultato dipende solo dai due punti locali; il secondo deriva da tutti gli standard. Non sono metodi intercambiabili.
Regredire o eseguire il fitting significa cercare i parametri di un modello che descriva complessivamente la relazione tra le variabili. Una retta di regressione non passa necessariamente per ciascun punto: cerca il miglior compromesso in base al criterio scelto.
Nel metodo dei minimi quadrati, dato il valore previsto \(\hat A_i=a+bC_i\), definiamo il residuo:
\[ r_i = A_i – \hat A_i \]
Il metodo determina \(a\) e \(b\) minimizzando la somma dei quadrati dei residui:
Approfondimento matematico — Come si calcolano pendenza e intercetta?
Nei minimi quadrati ordinari non pesati, indicando con \(\bar C\) la concentrazione media e con \(\bar A\) l’assorbanza media, i coefficienti della retta sono:
\[b=\frac{\sum_i (C_i-\bar C)(A_i-\bar A)}{\sum_i (C_i-\bar C)^2},\qquad a=\bar A-b\bar C.\]
La pendenza misura quanto cambia l’assorbanza per ogni mg/L; la sua unità è L/mg. L’intercetta conserva l’unità adimensionale dell’assorbanza. Questa regressione minimizza le differenze verticali in \(A\) e tratta le concentrazioni come valori noti. Se anche le concentrazioni fossero affette da incertezza significativa, bisognerebbe valutare un modello statistico più appropriato.
\[ \mathrm{SSE} = \sum_{i=1}^{n} r_i^2 \]
Per sintetizzare l’adattamento utilizzeremo il coefficiente di determinazione:
\[ R^2 = 1 – \frac{\sum_i r_i^2}{\sum_i (A_i – \bar A)^2} \]
e la radice dell’errore quadratico medio dei residui:
\[ \mathrm{RMSE} = \sqrt{\frac{1}{n}\sum_i r_i^2} \]
La RMSE usata qui divide per \(n\), non per \(n-2\): è un indicatore descrittivo del residuo, non la stima dell’incertezza metrologica di una calibrazione. Un valore di \(R^2\) vicino a 1 non garantisce, da solo, correttezza chimica, assenza di errori sistematici o validità fuori dall’intervallo esaminato.
Approfondimento statistico — RMSE e deviazione standard residua
La Lezione 09 distingueva fra RMS e deviazione standard. Qui compare una distinzione analoga: la RMSE dello script è \(\sqrt{\mathrm{SSE}/n}\), con \(n=9\), ed è pari a circa 0,0017482 unità di assorbanza. La stima della deviazione standard residua di una retta con due parametri stimati usa invece:
\[s_{\mathrm{res}}=\sqrt{\frac{\mathrm{SSE}}{n-2}}\simeq 0{,}0019823.\]
Il denominatore \(n-2\) riflette la stima di pendenza e intercetta. Nessuna delle due quantità rappresenta automaticamente l’incertezza della concentrazione incognita. Anche \(R^2\), per quanto vicino a uno, non dimostra che il modello sia corretto dal punto di vista chimico o che possa essere estrapolato.
5. Le API pubbliche GX-TXT utilizzate
Le funzionalità del framework vengono richiamate da Octave attraverso il bridge pubblico. La forma generale è:
result = gxtxt_api_call(api_id, operation, arguments);api_id identifica l’API pubblica, operation indica l’operazione richiesta e arguments contiene gli argomenti, normalmente raccolti in una cell array. Il risultato è un valore Octave, spesso una struttura con campi nominati.
| API e operazione | A cosa serve | Argomenti e risultato principali |
|---|---|---|
OCTAVE_SCRIPT_BRIDGE_API_v1 | Consente a Octave di scoprire e richiamare i servizi pubblici | gxtxt_api_require, gxtxt_api_has_operation, gxtxt_api_call |
CANONICAL_DATASET_API_v2 / list | Elenca gli identificativi dei Dataset disponibili | Nessun argomento; restituisce gli ID |
CANONICAL_DATASET_API_v2 / read_range | Legge dati indicando Dataset ID e Variable ID stabili | Dataset ID, variabili, riga iniziale e numero di righe; restituisce i valori |
DATASET_PUBLICATION_API_v2 / publish_series_batch | Pubblica un gruppo di serie in modo atomico | Richiesta con le serie; restituisce una ricevuta di pubblicazione |
NUMERIC_API_v1 / interpolate | Interpola i dati su una griglia richiesta | \(x\), \(y\), \(x_q\), opzioni; restituisce yq |
NUMERIC_API_v1 / linear_regression | Esegue il fitting lineare ai minimi quadrati | \(x\), \(y\), pesi, opzioni; restituisce pendenza, intercetta e \(R^2\) |
NUMERIC_API_v1 / polynomial_fit | Adatta un polinomio di grado specificato | \(x\), \(y\), grado, pesi, opzioni; restituisce coefficienti e parametri del fit |
PLOT_DATASET_API_v4 | Crea e conserva grafici scientifici riferiti ai Dataset | new_spec, validate_spec, upsert_plot, render, artifacts |
5.1 Verificare la disponibilità delle operazioni
Prima del calcolo richiediamo il servizio numerico e controlliamo che esponga le operazioni necessarie:
numeric_api = 'NUMERIC_API_v1';
gxtxt_api_require({numeric_api});
assert(gxtxt_api_has_operation(numeric_api, 'linear_regression'));
assert(gxtxt_api_has_operation(numeric_api, 'polynomial_fit'));
assert(gxtxt_api_has_operation(numeric_api, 'interpolate'));
gxtxt_api_require() permette di interrompere subito uno script quando manca un’API indispensabile. gxtxt_api_has_operation() verifica una singola operazione. Si evita così di scoprire l’incompatibilità soltanto dopo aver iniziato a generare i risultati.
Approfondimento API — Argomenti posizionali e strutture di risposta
gxtxt_api_call() riceve una cell array di argomenti posizionali. Per linear_regression la sequenza è {x, y, weights, options}. Il valore [] indica che non specifichiamo pesi; struct('intercept', true) richiede la stima dell’intercetta. Il risultato è una struttura i cui campi slope, intercept e r_squared sono consultati tramite la sintassi linear_fit.slope e analoghe.
interpolate usa {x, y, xq, options}: i primi due vettori sono i dati noti, xq contiene le ascisse di valutazione; method='linear' chiede segmenti rettilinei, mentre extrapolation='error' vieta valori al di fuori dell’intervallo degli standard. La risposta contiene le ordinate nel campo yq. Le verifiche tramite gxtxt_api_has_operation() controllano le capacità del bridge prima di eseguire i calcoli.
Una distinzione utile: la documentazione di NUMERIC_API_v1 descrive anche polynomial_evaluate, ma questa operazione non è disponibile attraverso il bridge Octave della versione utilizzata nella lezione. Useremo quindi polynomial_fit per ottenere il modello dal servizio pubblico GX-TXT e la normale funzione GNU Octave polyval() per valutarne i coefficienti. Non accediamo a funzioni private del CORE e non sostituiamo il fitting del framework con un’implementazione parallela.
5.2 Leggere un Dataset senza accedere ai file interni
Dopo aver pubblicato gli standard, possiamo recuperarli per mezzo dei Variable ID stabili:
data = gxtxt_api_call('CANONICAL_DATASET_API_v2', 'read_range', ...
  {'lesson10_calibration_standards', ...
   {'concentration_mg_L', 'absorbance_au'}, 0, 9});
x = data.concentration_mg_L.values(:);
y = data.absorbance_au.values(:);
Il primo argomento identifica il Dataset, il secondo contiene i due Variable ID, 0 indica la riga iniziale e 9 il numero di righe richieste. Il suffisso (:) trasforma i valori letti in vettori colonna. I nomi visualizzati nell’interfaccia possono cambiare senza modificare gli identificativi stabili su cui si basa lo script.
Approfondimento GX-TXT — Identità dei dati, righe e pubblicazione
Nel contratto read_range l’indice della prima riga parte da zero: la richiesta 0, 9 legge nove osservazioni a partire dalla prima. I Variable ID identificano stabilmente le grandezze, indipendentemente dall’etichetta mostrata nell’interfaccia.
Al momento della pubblicazione, ciascuna serie dichiara Dataset ID, vettori, unità, descrittori delle variabili e provenienza scientifica. publish_series_batch pubblica atomicamente la collezione e restituisce una ricevuta con il numero di risultati confermati. La successiva lettura tramite API pubblica controlla che i dati salvati coincidano con quelli calcolati: non è necessario conoscere la struttura dei file interni di GX-TXT.
Per pubblicare nuove serie utilizzeremo publish_series_batch. Ogni richiesta descrive ID del Dataset, variabili, unità, valori e provenienza scientifica. La pubblicazione atomica evita di lasciare solo una parte del gruppo di risultati se la transazione non riesce; dopo l’operazione controlleremo la ricevuta e rileggeremo i dati pubblicati.
6. Preparazione: pubblicare gli standard di calibrazione
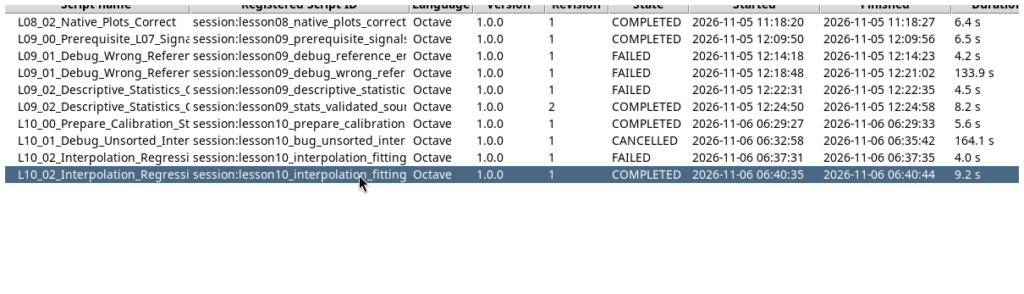
Creiamo una nuova Session in GX-TXT, apriamo Viewers → Octave Scripts e importiamo il file L10_00_Prepare_Calibration_Standards.m con File → Import .m. Assegniamo uno Script ID univoco, salviamo e avviamo lo script da Run → Open Script Runner → Run Job.
Lo script usa le normali istruzioni Octave per creare due vettori e controllarne lunghezza, finitezza e ordinamento. Prepara poi due descrittori di variabile con unità mg/L e 1, pubblica le nove coppie attraverso DATASET_PUBLICATION_API_v2 e ne verifica il contenuto con CANONICAL_DATASET_API_v2.
La riuscita dell’operazione è segnalata da COMPLETED e da un codice di uscita 0. In GX-TXT compare il Dataset canonico lesson10_calibration_standards.
Poiché lo script usa un Dataset ID esplicito, non deve essere ripetuto nella stessa Session. Se vogliamo ricominciare l’esercizio dall’inizio, creiamo una nuova Session anziché eliminare o modificare direttamente i file del Dataset.
7. Inserire un errore intenzionale
Apriamo L10_01_Debug_Unsorted_Interpolation.m. Questo secondo script inverte l’ordine di tutte le osservazioni mantenendo accoppiate le due variabili:
unsorted_x = flipud(concentration_mg_L);
unsorted_y = flipud(absorbance_au);
x_differences = diff(unsorted_x);
is_strictly_increasing = all(x_differences > 0);
query_x = (0:0.25:11)';
flipud() ribalta il vettore, diff() permette di osservare il segno delle differenze successive e all() produce un valore logico. L’apostrofo dopo la sequenza (0:0.25:11) crea un vettore colonna, adatto al contratto dell’interpolazione.
Le concentrazioni diventano:
unsorted_x = [11, 9, 7, 5, 4, 3, 2, 1, 0]
Le differenze risultano tutte negative:
x_differences = [-2, -2, -2, -1, -1, -1, -1, -1]
Lo script chiama comunque l’API:
interpolation = gxtxt_api_call('NUMERIC_API_v1', 'interpolate', ...
  {unsorted_x, unsorted_y, query_x, ...
   struct('method', 'linear', 'extrapolation', 'error')});
È un errore voluto. interpolate richiede ascisse strettamente crescenti: l’API respinge i dati invece di riordinarli silenziosamente. La verifica impedisce che una serie non conforme venga elaborata senza che ce ne accorgiamo.
Approfondimento — Una precondizione è parte del contratto di un’API
L’interpolazione richiede che l’input rispetti determinate condizioni: ascisse finite, strettamente crescenti e ordinate ad esse associate. Qui il vettore è decrescente, ma le coppie rimangono corrette: il difetto non è una permutazione sbagliata delle assorbanze. È una violazione del contratto di NUMERIC_API_v1 / interpolate.
Il debugger aiuta a fermare lo script prima della chiamata, esaminare unsorted_x e x_differences e formulare una diagnosi. Non bisogna aggirare il controllo per far terminare il Job con successo: una verifica esplicita evita risultati numericamente plausibili ma non validi.
8. Individuare il problema con il debugger di Octave
Nell’Octave Script Workspace scegliamo Run → Debug Session script, impostiamo un breakpoint alla riga 30, sull’istruzione is_strictly_increasing, e selezioniamo Start Debug.
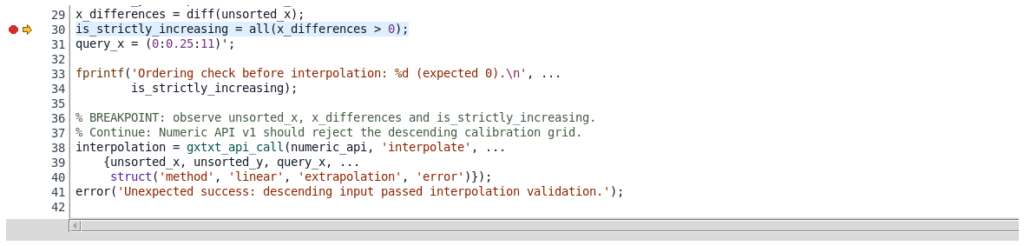
Il debugger permette di esaminare le variabili durante l’esecuzione: il vettore delle concentrazioni è decrescente, e le differenze sono negative. La condizione che richiede l’ordinamento crescente non può essere soddisfatta.

Premendo Continue, lo script raggiunge la chiamata all’API numerica. Il servizio segnala precisamente il problema:
X must be strictly increasing; data are never silently sorted
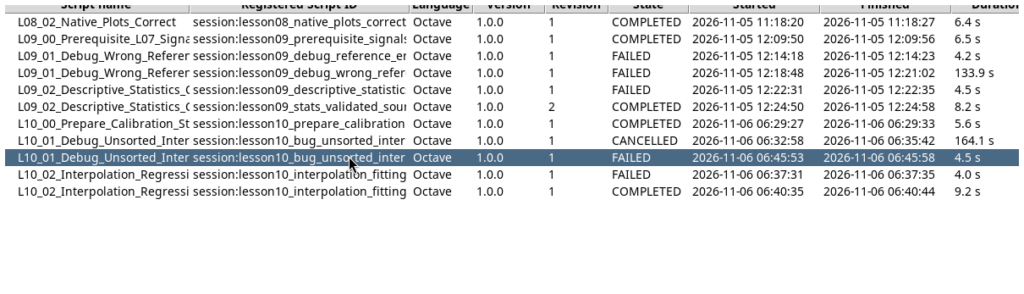
L’esecuzione termina con stato FAILED. Non è un malfunzionamento: abbiamo costruito uno script errato per imparare a riconoscere una precondizione violata. Anche il normale Script Runner registra il fallimento previsto, con codice di uscita 1.
9. Correggere l’errore e calcolare i modelli
Importiamo L10_02_Interpolation_Regression_Correct.m, assegniamo un nuovo Script ID e avviamo il Job.
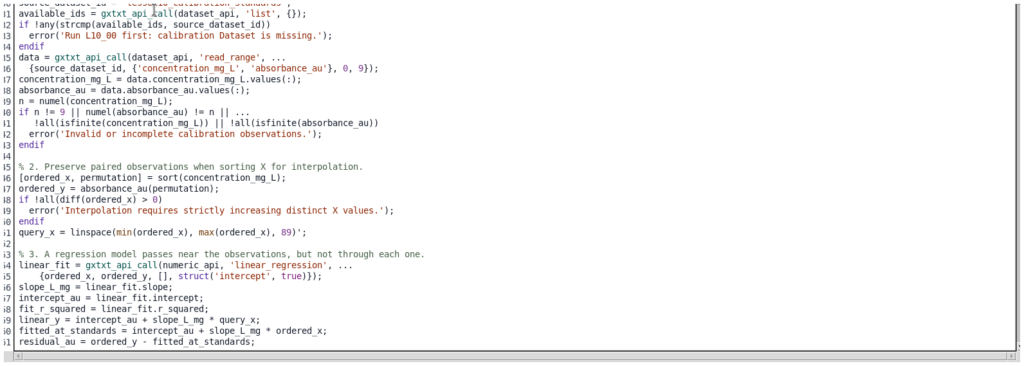
La correzione consiste nell’ordinare le concentrazioni insieme alle corrispondenti assorbanze, non nell’eliminare il controllo:
[ordered_x, permutation] = sort(concentration_mg_L);
ordered_y = absorbance_au(permutation);
assert(all(diff(ordered_x) > 0));
9.1 Regressione lineare
Utilizziamo la regressione ai minimi quadrati del CORE tramite API pubblica:
linear_fit = gxtxt_api_call('NUMERIC_API_v1', 'linear_regression', ...
  {ordered_x, ordered_y, [], struct('intercept', true)});
slope_L_mg = linear_fit.slope;
intercept_au = linear_fit.intercept;
fit_r_squared = linear_fit.r_squared;
Gli argomenti sono i vettori delle osservazioni, un vettore dei pesi opzionale (qui [], cioè non specificato) e una struttura di opzioni che richiede la stima dell’intercetta. Il risultato contiene i coefficienti della retta e il relativo \(R^2\). La regressione è non pesata: non stiamo presumendo di conoscere incertezze differenti per i nove standard.
9.2 Interpolazione lineare a tratti
Per ottenere una curva che passa per gli standard definiamo una griglia più fitta e richiamiamo interpolate:
query_x = linspace(min(ordered_x), max(ordered_x), 89)';
interpolated = gxtxt_api_call('NUMERIC_API_v1', 'interpolate', ...
  {ordered_x, ordered_y, query_x, ...
   struct('method', 'linear', 'extrapolation', 'error')});
interpolated_y = interpolated.yq(:);
linspace() genera 89 ascisse uniformemente distribuite tra la concentrazione minima e la massima; l’opzione extrapolation = 'error' vieta l’interpolazione al di fuori dell’intervallo disponibile.
Approfondimento Octave — Campionamento del modello con linspace()
linspace(0,11,89) produce 89 ascisse, estremi inclusi, con passo costante \(11/(89-1)=0{,}125\) mg/L. Questi valori sono punti di valutazione, non nuove misure. Passare da nove standard a 89 punti rende la curva più regolare nel grafico, ma non aumenta l’informazione sperimentale e non riduce automaticamente l’incertezza.
L’apostrofo finale in linspace(...,89)' dispone il risultato come vettore colonna. La verifica del dominio rimane necessaria: generare una griglia più fitta non autorizza a calcolare oltre la concentrazione massima e minima degli standard.
9.3 Fitting polinomiale
Calcoliamo anche un polinomio di secondo grado:
quadratic_fit = gxtxt_api_call('NUMERIC_API_v1', 'polynomial_fit', ...
  {ordered_x, ordered_y, 2, [], struct('center_scale', true)});
quadratic_y = polyval(quadratic_fit.coefficients(:).', query_x);
L’opzione center_scale migliora la stabilità numerica del fitting. La funzione Octave polyval() valuta il polinomio a partire dai coefficienti restituiti dal servizio pubblico; (:).' li dispone come vettore riga senza coniugazione. Un polinomio di ordine maggiore è utile per il confronto, ma richiede un parametro in più e non è automaticamente il modello migliore.
Approfondimento — Fitting quadratico, stabilità numerica e polyval()
Un polinomio di secondo grado ha la forma \(\hat A(C)=a_2C^2+a_1C+a_0\), quindi tre parametri contro i due della retta. L’opzione center_scale=true consente all’API numerica di risolvere il problema di fitting su ascisse centrate e scalate, migliorando il condizionamento, e di restituire i coefficienti nella base della concentrazione originale.
In GNU Octave polyval([a2,a1,a0],query_x) valuta poi il polinomio. Il passaggio coefficients(:).' assicura che i coefficienti siano organizzati come vettore riga, senza coniugazione complessa. Distinguere il calcolo dei coefficienti dalla loro valutazione permette di comprendere perché polynomial_fit è un’operazione del servizio numerico GX-TXT, mentre polyval() è una normale funzione del linguaggio Octave.
Un valore di \(R^2\) maggiore non basta per preferire il polinomio: aumentando il numero di parametri aumenta anche la capacità di seguire irregolarità casuali. Per selezionare un modello servono coerenza fisica, residui e, quando disponibili, dati di convalida indipendenti.
9.4 Risultati numerici
L’elaborazione fornisce:
| Grandezza | Risultato |
|---|---|
| Intercetta della retta \(a\) | 0,01267879 |
| Pendenza della retta \(b\) | 0,08202121 L/mg |
| \(R^2\) lineare | 0,9999628 |
| RMSE dei residui | 0,0017482 |
| \(R^2\) quadratico | 0,9999705 |
| Assorbanza del campione incognito | 0,462 |
| Concentrazione stimata | 5,478110 mg/L |
La retta di calibrazione è:
\[ A = 0{,}01267879 + 0{,}08202121\, C \]
Invertendo il modello lineare otteniamo la stima della concentrazione:
\[ \hat C_{\mathrm{incognito}} = \frac{A_{\mathrm{incognito}}-a}{b} = 5{,}478110\ \mathrm{mg/L} \]
Il risultato rientra nell’intervallo degli standard, 0–11 mg/L. Si tratta quindi di una stima inversa mediante il modello di calibrazione entro il suo dominio, non di un’estrapolazione oltre la gamma esaminata. È una stima puntuale didattica: per riportarla come risultato analitico reale servirebbe anche una valutazione dell’incertezza.
Approfondimento analitico — Previsione inversa e cifre significative
Per ricavare la concentrazione dall’assorbanza risolviamo la retta rispetto a \(C\): \(\hat C=(A-a)/b\). La stima 5,478110 mg/L è il risultato numerico del caso sintetico: le sei cifre decimali non equivalgono a una dimostrata accuratezza sperimentale.
In un esperimento reale la concentrazione stimata dipende anche dall’incertezza dell’assorbanza del campione, dalla dispersione dei residui, dall’incertezza degli standard e dalla covarianza fra pendenza e intercetta. Occorrerebbero repliche, una calibrazione validata e un modello d’incertezza. La verifica che la stima sia compresa fra 0 e 11 mg/L evita l’estrapolazione ma, da sola, non certifica la qualità analitica del risultato.
Il modello quadratico presenta un valore di \(R^2\) leggermente maggiore. Questo non basta per sceglierlo: un parametro aggiuntivo può adattare anche piccole fluttuazioni casuali. La scelta richiede l’esame dei residui, la plausibilità del modello e, in laboratorio, standard indipendenti e prove di validazione.
10. Pubblicare i risultati e visualizzare i grafici in GX-TXT
Lo script corretto pubblica quattro Dataset derivati tramite DATASET_PUBLICATION_API_v2 / publish_series_batch:
lesson10_linear_calibration: risposta prevista dalla retta.lesson10_piecewise_interpolation: curva interpolata linearmente tra gli standard.lesson10_quadratic_calibration: risposta prevista dal polinomio di secondo grado.lesson10_calibration_residuals: differenza tra assorbanza osservata e risposta prevista dalla retta.
Ogni Dataset riporta gli identificativi delle variabili, le unità, il riferimento ai dati di origine e il metodo di elaborazione. Dopo la pubblicazione il programma rilegge i valori con CANONICAL_DATASET_API_v2: il controllo conferma che i risultati conservati corrispondono a quelli calcolati.
Per i grafici utilizziamo PLOT_DATASET_API_v4. Il procedimento consiste nel creare una specifica con new_spec, completarne pannelli, assi e serie, verificarla con validate_spec, registrarla con upsert_plot, renderizzarla con render e consultare i risultati con artifacts.
Approfondimento GX-TXT — Grafici persistenti e collegamento ai Dataset
Come nella Lezione 08, un grafico GX-TXT non è un’immagine generata autonomamente da figure(): è una specifica registrata tramite PLOT_DATASET_API_v4 che fa riferimento ai Dataset e ai loro Variable ID. new_spec prepara la struttura, validate_spec controlla pannelli e serie, upsert_plot assegna un’identità persistente, render produce la visualizzazione e artifacts ne restituisce le informazioni.
Questa volta un grafico confronta gli standard con tre modelli, mentre l’altro mostra i residui. Sono rappresentazioni di risultati numerici già presenti nella Session, non copie indipendenti dei dati e non file di plotting scritti direttamente sul disco.
10.1 Confronto tra standard, retta e curve interpolate
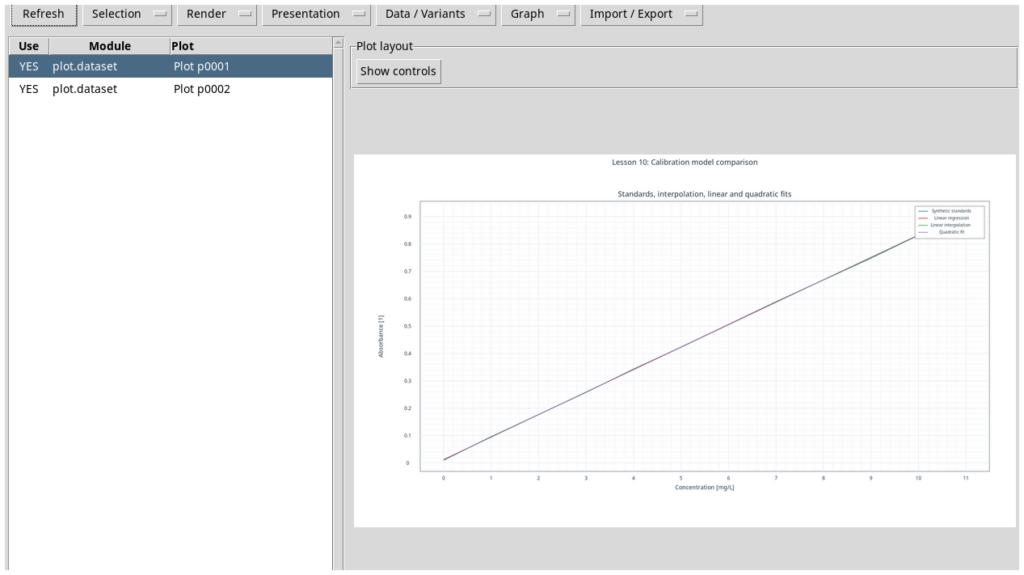
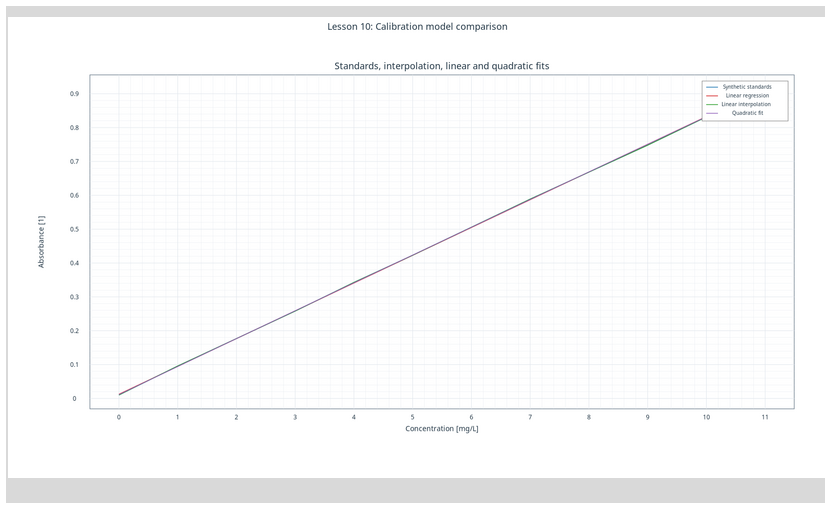
Le curve sono molto vicine tra loro perché la relazione scelta è quasi lineare. Il grafico permette di confrontare i comportamenti, ma le sovrapposizioni visive non significano che i modelli siano matematicamente equivalenti.
10.2 Analisi dei residui
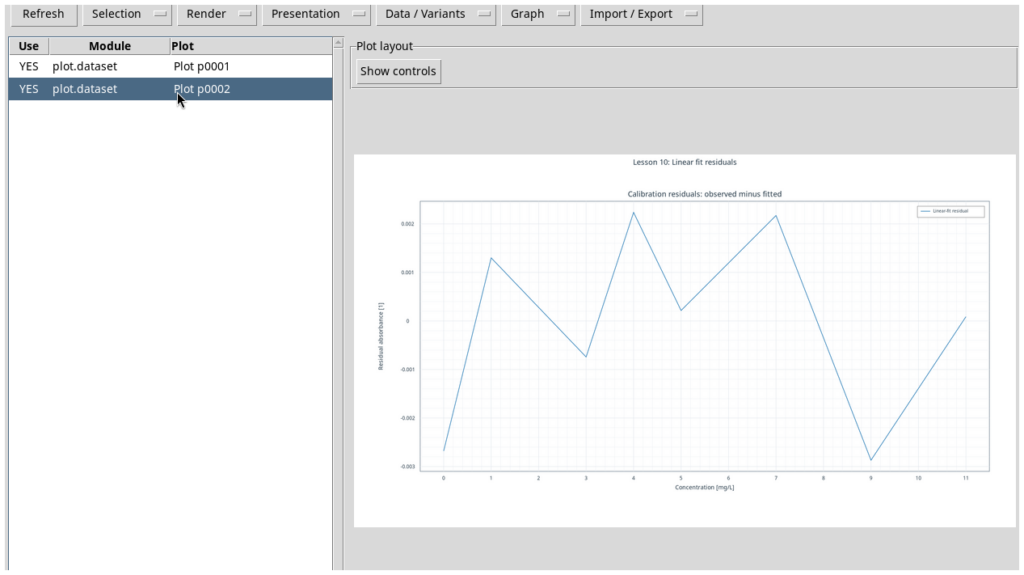
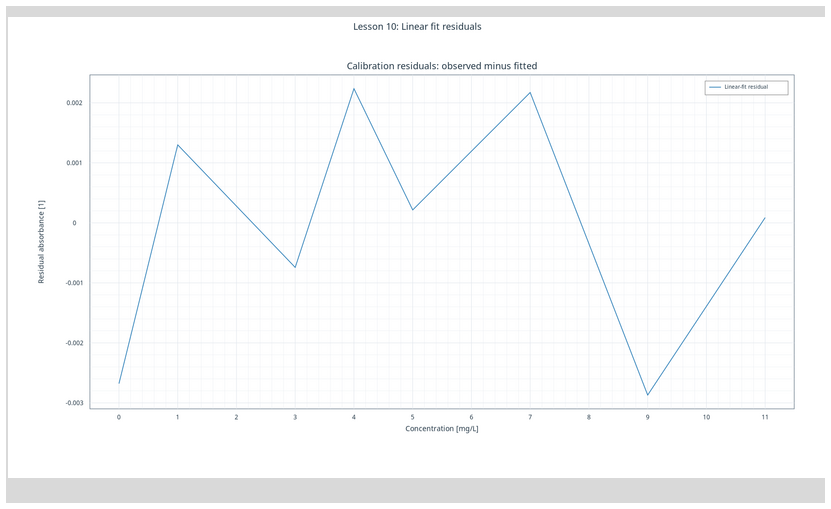
I residui oscillano attorno allo zero per pochi millesimi di unità di assorbanza. Dobbiamo osservarne l’andamento, non soltanto il valore sintetico di \(R^2\): curvature sistematiche, gruppi o punti anomali possono rivelare limiti del modello. Con nove standard sintetici non è possibile dedurre precisione del metodo, limite di rivelabilità o robustezza della calibrazione.
Approfondimento — Interpretazione scientifica dei residui
Un modello adeguato dovrebbe lasciare residui senza andamenti sistematici evidenti rispetto alla concentrazione. Una sequenza curva può indicare una relazione non lineare; una dispersione che aumenta con la concentrazione può suggerire eteroschedasticità, cioè varianza non costante; un punto isolato può richiedere il controllo dello standard corrispondente.
Questi indizi non sostituiscono una verifica statistica. Con nove dati sintetici possiamo esercitarci nell’interpretazione del grafico, ma non dimostrare precisione, limiti di rivelabilità o assenza di interferenze di un metodo analitico reale. Il residuo è una differenza in unità di assorbanza, non una concentrazione.
Il Job corretto termina in stato COMPLETED, codice di uscita 0. I quattro Dataset sono disponibili nella Session insieme ai due grafici persistenti.
11. Ripetere l’esperimento ed esercitarsi
Per riprodurre l’esempio: create una nuova Session, importate e avviate prima lo script di preparazione, eseguite poi quello intenzionalmente errato con il debugger, osservate la causa del fallimento e infine importate ed eseguite lo script corretto. Controllate i Dataset e aprite entrambi i grafici dal pannello GX-TXT.
Esercizi proposti:
- Spiegare perché la griglia di interpolazione deve essere strettamente crescente e perché ordinare soltanto le ascisse compromette le coppie sperimentali.
- Aggiungere uno standard sintetico a concentrazione intermedia; in una nuova Session ricalcolare pendenza, intercetta, \(R^2\) e residui.
- Inserire un punto volutamente anomalo e verificare l’effetto sul fitting e sulla concentrazione stimata dell’incognito.
- Confrontare retta e polinomio di secondo grado: perché il modello con il valore di \(R^2\) più elevato non è necessariamente preferibile?
- Proporre le misure aggiuntive e il metodo statistico necessari per assegnare un’incertezza credibile alla concentrazione dell’incognito.
12. Versione del framework, fonti e licenza
Questa lezione fa riferimento ai sorgenti pubblici GX-TXT del ramo maintenance/dev112, commit 125afdb62110a92199f59a066199bb7f2dc7ed68, verificato il 6 novembre 2026. L’esecuzione descritta utilizza GX-TXT DEV112 Release 2 con patch P001–P005 e lo Script Bridge Octave disponibile in tale versione. Operazioni e firme possono variare nelle versioni precedenti o successive.
La documentazione tecnica delle API utilizzate è disponibile nel repository, riferita allo stesso commit:
- Numeric API v1: interpolazione e regressione
- Canonical Dataset API v2
- Dataset Publication API v2
- Plot Dataset API v4
- Octave Script Bridge API v1
I tre script GNU Octave della lezione sono distribuiti con licenza GNU GPL v3 o successiva. Il codice sorgente completo è riportato nei riquadri espandibili alla fine dell’articolo.
13. Script GNU Octave completi
I tre script sono riportati integralmente qui sotto. Apri il riquadro corrispondente e copia il codice nel file .m, mantenendo i commenti originali in inglese.
Script 00 — Preparazione degli standard sintetici (L10_00_Prepare_Calibration_Standards.m)
% Lesson 10 - Prepare a reproducible analytical calibration Dataset.
% Course: GNU Octave with GX-TXT | DEV112 Release 2 + P001-P005
% GitHub commit: 125afdb62110a92199f59a066199bb7f2dc7ed68
% SPDX-License-Identifier: GPL-3.0-or-later
%
% Execute in a NEW GX-TXT Session using the managed Octave Script Workspace.
% This example represents synthetic analytical standards, not real measurements.
% The Dataset is create-only. Do not repeat this script in the same Session.

dataset_api = 'CANONICAL_DATASET_API_v2';
publication_api = 'DATASET_PUBLICATION_API_v2';
gxtxt_api_require({dataset_api, publication_api});
assert(gxtxt_api_has_operation(dataset_api, 'list'));
assert(gxtxt_api_has_operation(dataset_api, 'read_range'));
assert(gxtxt_api_has_operation(publication_api, 'publish_series_batch'));

% Each concentration and absorbance value belongs to one calibration standard.
concentration_mg_L = [0; 1; 2; 3; 4; 5; 7; 9; 11];
absorbance_au = [0.010; 0.096; 0.177; 0.258; 0.343; ...
                 0.423; 0.589; 0.748; 0.915];
n = numel(concentration_mg_L);
assert(n == numel(absorbance_au));
assert(all(isfinite(concentration_mg_L)) && all(isfinite(absorbance_au)));
assert(all(diff(concentration_mg_L) > 0));

source_dataset_id = 'lesson10_calibration_standards';
existing_ids = gxtxt_api_call(dataset_api, 'list', {});
if any(strcmp(existing_ids, source_dataset_id))
  error('Calibration Dataset already exists. Create a fresh Session.');
endif

% A stable Variable ID is not the same thing as a display label.
x_variable = struct('variable_id', 'concentration_mg_L', ...
   'name', 'concentration_mg_L', ...
   'display_label', 'Concentration (synthetic standard)', ...
   'unit', 'mg/L', 'dtype', 'float64', 'value_kind', 'number', ...
   'semantic_source', 'generator');
y_variable = struct('variable_id', 'absorbance_au', ...
   'name', 'absorbance_au', ...
   'display_label', 'Absorbance (synthetic)', ...
   'unit', '1', 'dtype', 'float64', 'value_kind', 'number', ...
   'semantic_source', 'generator');

metadata = struct();
metadata.('simulation.model') = 'synthetic_analytical_calibration';
metadata.('simulation.is_real_measurement') = false;
metadata.('simulation.n_standards') = n;
metadata.('simulation.units_x') = 'mg/L';
metadata.('simulation.units_y') = '1';

request = struct( ...
   'dataset_id', source_dataset_id, 'contract', 'table.generic', ...
   'storage', 'auto', 'x_values', concentration_mg_L, ...
   'y_values', absorbance_au, 'x_variable', x_variable, ...
   'y_variable', y_variable, 'producer_version', '1.0.0', ...
   'source', 'GX-TXT GNU Octave Lesson 10', ...
   'provenance', 'Deterministic synthetic standard concentrations and absorbances', ...
   'notes', 'Artificial data for interpolation and regression education', ...
   'structured_metadata', metadata);
batch_request = struct('series', {{request}});
receipt = gxtxt_api_call(publication_api, 'publish_series_batch', {batch_request});
if !receipt.atomic || receipt.output_count != 1
  error('The public Dataset batch publication was not confirmed.');
endif

% Read back through the public canonical Dataset service, not private files.
readback = gxtxt_api_call(dataset_api, 'read_range', ...
   {source_dataset_id, {'concentration_mg_L', 'absorbance_au'}, 0, n});
assert(max(abs(readback.concentration_mg_L.values(:) - concentration_mg_L)) < 1e-12);
assert(max(abs(readback.absorbance_au.values(:) - absorbance_au)) < 1e-12);
fprintf('PASS: published %d synthetic calibration standards in %s.\n', ...
         n, source_dataset_id);
Script 01 — Errore intenzionale e debugger (L10_01_Debug_Unsorted_Interpolation.m)
% Lesson 10 - Intentional error: unsorted X values in interpolation.
% Course: GNU Octave with GX-TXT | DEV112-P005
% GitHub commit: 125afdb62110a92199f59a066199bb7f2dc7ed68
% SPDX-License-Identifier: GPL-3.0-or-later
%
% Run this script in GX-TXT's native Octave debugger. It MUST fail.
% Place a breakpoint on the interpolate call below. Inspect the X vector,
% the first differences, and the boolean ordering check before continuing.

dataset_api = 'CANONICAL_DATASET_API_v2';
numeric_api = 'NUMERIC_API_v1';
gxtxt_api_require({dataset_api, numeric_api});
assert(gxtxt_api_has_operation(dataset_api, 'read_range'));
assert(gxtxt_api_has_operation(numeric_api, 'interpolate'));

samples = gxtxt_api_call(dataset_api, 'read_range', ...
   {'lesson10_calibration_standards', ...
    {'concentration_mg_L', 'absorbance_au'}, 0, 9});
concentration_mg_L = samples.concentration_mg_L.values(:);
absorbance_au = samples.absorbance_au.values(:);
if numel(concentration_mg_L) != 9 || numel(absorbance_au) != 9
  error('The calibration prerequisites are incomplete.');
endif

% INTENTIONAL BUG: reverse the paired standard observations before interpolating.
% Regression would accept unordered X, but interpolation requires increasing X.
unsorted_x = flipud(concentration_mg_L);
unsorted_y = flipud(absorbance_au);
x_differences = diff(unsorted_x);
is_strictly_increasing = all(x_differences > 0);
query_x = (0:0.25:11)';

fprintf('Ordering check before interpolation: %d (expected 0).\n', ...
        is_strictly_increasing);

% BREAKPOINT: observe unsorted_x, x_differences and is_strictly_increasing.
% Continue: Numeric API v1 should reject the descending calibration grid.
interpolation = gxtxt_api_call(numeric_api, 'interpolate', ...
    {unsorted_x, unsorted_y, query_x, ...
     struct('method', 'linear', 'extrapolation', 'error')});
error('Unexpected success: descending input passed interpolation validation.');
Script 02 — Interpolazione, fitting, Dataset e grafici (L10_02_Interpolation_Regression_Correct.m)
% Lesson 10 - Fit and interpolate a synthetic analytical calibration.
% Course: GNU Octave with GX-TXT | DEV112 Release 2 + P001-P005
% GitHub commit: 125afdb62110a92199f59a066199bb7f2dc7ed68
% SPDX-License-Identifier: GPL-3.0-or-later
%
% Run after L10_00 in the same fresh Session; outputs are create-only.
% Every scientific Dataset and plot is managed by GX-TXT's public APIs.
% Native GNU Octave syntax is used for vector checks and scalar arithmetic.

dataset_api = 'CANONICAL_DATASET_API_v2';
numeric_api = 'NUMERIC_API_v1';
publication_api = 'DATASET_PUBLICATION_API_v2';
plot_api = 'PLOT_DATASET_API_v4';
gxtxt_api_require({dataset_api, numeric_api, publication_api, plot_api});
required = {
  dataset_api, 'list'; dataset_api, 'read_range';
  numeric_api, 'interpolate'; numeric_api, 'linear_regression';
  numeric_api, 'polynomial_fit';
  publication_api, 'publish_series_batch';
  plot_api, 'new_spec'; plot_api, 'validate_spec';
  plot_api, 'upsert_plot'; plot_api, 'render'; plot_api, 'artifacts'
};
for k = 1:rows(required)
  if !gxtxt_api_has_operation(required{k,1}, required{k,2})
    error('Missing public operation: %s/%s', required{k,1}, required{k,2});
  endif
endfor

% 1. Read the actual published calibration Dataset through stable Variable IDs.
source_dataset_id = 'lesson10_calibration_standards';
available_ids = gxtxt_api_call(dataset_api, 'list', {});
if !any(strcmp(available_ids, source_dataset_id))
  error('Run L10_00 first: calibration Dataset is missing.');
endif
data = gxtxt_api_call(dataset_api, 'read_range', ...
  {source_dataset_id, {'concentration_mg_L', 'absorbance_au'}, 0, 9});
concentration_mg_L = data.concentration_mg_L.values(:);
absorbance_au = data.absorbance_au.values(:);
n = numel(concentration_mg_L);
if n != 9 || numel(absorbance_au) != n || ...
   !all(isfinite(concentration_mg_L)) || !all(isfinite(absorbance_au))
  error('Invalid or incomplete calibration observations.');
endif

% 2. Preserve paired observations when sorting X for interpolation.
[ordered_x, permutation] = sort(concentration_mg_L);
ordered_y = absorbance_au(permutation);
if !all(diff(ordered_x) > 0)
  error('Interpolation requires strictly increasing distinct X values.');
endif
query_x = linspace(min(ordered_x), max(ordered_x), 89)';

% 3. A regression model passes near the observations, but not through each one.
linear_fit = gxtxt_api_call(numeric_api, 'linear_regression', ...
    {ordered_x, ordered_y, [], struct('intercept', true)});
slope_L_mg = linear_fit.slope;
intercept_au = linear_fit.intercept;
fit_r_squared = linear_fit.r_squared;
linear_y = intercept_au + slope_L_mg * query_x;
fitted_at_standards = intercept_au + slope_L_mg * ordered_x;
residual_au = ordered_y - fitted_at_standards;
rmse_au = sqrt(mean(residual_au .^ 2));
if !(isfinite(slope_L_mg) && slope_L_mg > 0 && ...
     isfinite(intercept_au) && isfinite(fit_r_squared))
  error('Regression returned implausible calibration coefficients.');
endif

% 4. Polynomial fitting: a higher R-squared alone cannot select a model.
quadratic_fit = gxtxt_api_call(numeric_api, 'polynomial_fit', ...
    {ordered_x, ordered_y, 2, [], struct('center_scale', true)});
% The polynomial_evaluate API is not available through this Script Bridge.
% Evaluating the public fitted coefficients with native Octave polyval is safe.
% The small physical concentration range avoids severe power-basis conditioning.
quadratic_y = polyval(quadratic_fit.coefficients(:).', query_x);

% 5. Piecewise linear interpolation passes through each standard point.
interpolated = gxtxt_api_call(numeric_api, 'interpolate', ...
    {ordered_x, ordered_y, query_x, ...
     struct('method', 'linear', 'extrapolation', 'error')});
interpolated_y = interpolated.yq(:);
assert(numel(interpolated_y) == numel(query_x));
assert(numel(quadratic_y) == numel(query_x));
assert(all(isfinite(interpolated_y)) && all(isfinite(quadratic_y)));

% 6. Inverse prediction uses the linear calibration model, not interpolation.
unknown_absorbance_au = 0.462;
unknown_concentration_mg_L = ...
    (unknown_absorbance_au - intercept_au) / slope_L_mg;
if unknown_concentration_mg_L < min(ordered_x) || ...
   unknown_concentration_mg_L > max(ordered_x)
  error('Unknown concentration lies outside the calibrated range.');
endif
fprintf('Linear calibration: A = %.8f + %.8f * C [mg/L]\n', ...
       intercept_au, slope_L_mg);
fprintf('Linear R-squared = %.7f; residual RMSE = %.7f AU\n', ...
       fit_r_squared, rmse_au);
fprintf('Quadratic R-squared = %.7f (not automatically better)\n', ...
       quadratic_fit.r_squared);
fprintf('Unknown absorbance %.3f gives concentration %.6f mg/L\n', ...
       unknown_absorbance_au, unknown_concentration_mg_L);

% 7. Publish four independent derived canonical Datasets atomically.
derived_ids = {'lesson10_linear_calibration', ...
               'lesson10_piecewise_interpolation', ...
               'lesson10_quadratic_calibration', ...
               'lesson10_calibration_residuals'};
for k = 1:numel(derived_ids)
  if any(strcmp(available_ids, derived_ids{k}))
    error('Derived Dataset already exists: %s. Use a new Session.', ...
          derived_ids{k});
  endif
endfor

x_variable = struct('variable_id', 'concentration_mg_L', ...
  'name', 'concentration_mg_L', 'display_label', 'Concentration', ...
  'unit', 'mg/L', 'dtype', 'float64', 'value_kind', 'number', ...
  'semantic_source', 'plugin');
absorbance_variable = struct('variable_id', 'absorbance_au', ...
  'name', 'absorbance_au', 'display_label', 'Model absorbance', ...
  'unit', '1', 'dtype', 'float64', 'value_kind', 'number', ...
  'semantic_source', 'plugin');
residual_variable = struct('variable_id', 'residual_au', ...
  'name', 'residual_au', 'display_label', 'Observed minus fitted absorbance', ...
  'unit', '1', 'dtype', 'float64', 'value_kind', 'number', ...
  'semantic_source', 'plugin');
x_values = {query_x, query_x, query_x, ordered_x};
y_values = {linear_y, interpolated_y, quadratic_y, residual_au};
y_variables = {absorbance_variable, absorbance_variable, ...
               absorbance_variable, residual_variable};
methods = {'linear least squares', 'piecewise linear interpolation', ...
           'degree-two polynomial least squares', 'linear fit residuals'};
series = cell(1, numel(derived_ids));
for k = 1:numel(derived_ids)
  meta = struct();
  meta.('analysis.method') = methods{k};
  meta.('analysis.input_dataset_id') = source_dataset_id;
  meta.('analysis.linear_r_squared') = fit_r_squared;
  meta.('analysis.unknown_concentration_mg_L') = unknown_concentration_mg_L;
  series{k} = struct('dataset_id', derived_ids{k}, ...
    'contract', 'table.generic', 'storage', 'auto', ...
    'x_values', x_values{k}, 'y_values', y_values{k}, ...
    'x_variable', x_variable, 'y_variable', y_variables{k}, ...
    'producer_version', '1.0.0', 'source', 'GX-TXT Octave Lesson 10', ...
    'provenance', 'Derived from synthetic calibration standards via public APIs', ...
    'source_dataset_ids', {{source_dataset_id}}, ...
    'notes', methods{k}, 'structured_metadata', meta);
endfor
request = struct('series', {series});
receipt = gxtxt_api_call(publication_api, 'publish_series_batch', {request});
if !receipt.atomic || receipt.output_count != numel(derived_ids)
  error('Atomic batch publication did not confirm four derived Datasets.');
endif

% 8. Verify persistent scientific values via the public Dataset reader.
all_ids = gxtxt_api_call(dataset_api, 'list', {});
for k = 1:numel(derived_ids)
  if !any(strcmp(all_ids, derived_ids{k}))
    error('Published Dataset missing: %s.', derived_ids{k});
  endif
  saved = gxtxt_api_call(dataset_api, 'read_range', ...
      {derived_ids{k}, {'concentration_mg_L', ...
      y_variables{k}.variable_id}, 0, numel(y_values{k})});
  recovered = saved.(y_variables{k}.variable_id).values(:);
  if numel(recovered) != numel(y_values{k}) || ...
     max(abs(recovered - y_values{k})) > 1e-9
    error('Public read-back failed for: %s.', derived_ids{k});
  endif
endfor

% 9. Create persistent native GX-TXT plots using canonical Dataset references.
comparison = gxtxt_api_call(plot_api, 'new_spec', ...
    {'plot.dataset.xy', 'Lesson 10: Calibration model comparison'});
p = comparison.panels{1};
p.id = 'calibration_comparison';
p.title = 'Standards, interpolation, linear and quadratic fits';
p.axes = struct('x', ...
    struct('label', 'Concentration [mg/L]', 'scale', 'linear'), ...
    'y_left', struct('label', 'Absorbance [1]', 'scale', 'linear'));
p.series = {
  struct('id', 'standards', 'label', 'Synthetic standards', ...
      'dataset_id', source_dataset_id, ...
      'x_variable_id', 'concentration_mg_L', ...
      'y_variable_id', 'absorbance_au', 'axis', 'left', 'kind', 'line'),
  struct('id', 'linear', 'label', 'Linear regression', ...
      'dataset_id', derived_ids{1}, ...
      'x_variable_id', 'concentration_mg_L', ...
      'y_variable_id', 'absorbance_au', 'axis', 'left', 'kind', 'line'),
  struct('id', 'piecewise', 'label', 'Linear interpolation', ...
      'dataset_id', derived_ids{2}, ...
      'x_variable_id', 'concentration_mg_L', ...
      'y_variable_id', 'absorbance_au', 'axis', 'left', 'kind', 'line'),
  struct('id', 'quadratic', 'label', 'Quadratic fit', ...
      'dataset_id', derived_ids{3}, ...
      'x_variable_id', 'concentration_mg_L', ...
      'y_variable_id', 'absorbance_au', 'axis', 'left', 'kind', 'line')
};
comparison.panels = {p};
if !gxtxt_api_call(plot_api, 'validate_spec', {comparison})
  error('The model comparison PlotSpec is invalid.');
endif
plot_ref = gxtxt_api_call(plot_api, 'upsert_plot', ...
    {'lesson10_calibration_comparison', comparison});
gxtxt_api_call(plot_api, 'render', {plot_ref});
comparison_artifacts = gxtxt_api_call(plot_api, 'artifacts', {plot_ref});

residual_spec = gxtxt_api_call(plot_api, 'new_spec', ...
    {'plot.dataset.xy', 'Lesson 10: Linear fit residuals'});
r = residual_spec.panels{1};
r.id = 'residuals';
r.title = 'Calibration residuals: observed minus fitted';
r.axes = struct('x', ...
    struct('label', 'Concentration [mg/L]', 'scale', 'linear'), ...
    'y_left', struct('label', 'Residual absorbance [1]', 'scale', 'linear'));
r.series = {struct('id', 'residual', 'label', 'Linear-fit residual', ...
    'dataset_id', derived_ids{4}, 'x_variable_id', 'concentration_mg_L', ...
    'y_variable_id', 'residual_au', 'axis', 'left', 'kind', 'line')};
residual_spec.panels = {r};
if !gxtxt_api_call(plot_api, 'validate_spec', {residual_spec})
  error('The residual PlotSpec is invalid.');
endif
residual_ref = gxtxt_api_call(plot_api, 'upsert_plot', ...
    {'lesson10_calibration_residuals', residual_spec});
gxtxt_api_call(plot_api, 'render', {residual_ref});
residual_artifacts = gxtxt_api_call(plot_api, 'artifacts', {residual_ref});

fprintf('PASS: 4 canonical Datasets, 2 native plots, read-back verified.\n');
disp(comparison_artifacts);
disp(residual_artifacts);
Altre tappe del progetto
- Lezione 01 — Il primo script GNU Octave in GX-TXT
- Lezione 02 — Variabili, tipi di dati e operatori in GNU Octave con GX-TXT
- Lezione 03 — Vettori e matrici in GNU Octave con GX-TXT: analisi di misure di temperatura
- Lezione 04 — condizioni, cicli e funzioni. Simuliamo la legge di raffreddamento di Newton
- Lezione 05: Dataset scientifici e Variable ID
- Lezione 06 — Selezione e lettura dei dati sperimentali con GNU Octave e GX-TXT