

Lezione 12 – Algebra lineare: analisi di una miscela spettrofotometrica con GNU Octave e GX-TXT
Un sistema di equazioni lineari permette di ricavare concentrazioni sconosciute da più misure contemporanee. In questa lezione prepariamo una miscela spettrofotometrica sintetica di tre componenti, recuperiamo le loro concentrazioni, studiamo la perdita del rango e impariamo a interpretare i valori singolari. Useremo GNU Octave all’interno di GX-TXT e soltanto le API pubbliche del framework.
Versione di riferimento: GX-TXT 0.9.8.10-dev-112 Release 2 P008, release GitHub, commit verificato 17ff2a7f93de0612015a873e626f87dbeb56b6a2. I numeri di versione dei contratti API sono distinti dalla versione della distribuzione GX-TXT.
Cosa impariamo
Impareremo a costruire matrici e vettori, utilizzare rows, columns e size, distinguere il prodotto matriciale da quello elemento per elemento, riconoscere il rango e il condizionamento, risolvere sistemi sovradeterminati ai minimi quadrati, interpretare la SVD e pubblicare Dataset e grafici persistenti in GX-TXT. La lezione prosegue il percorso dei metodi statistici e numerici introdotti nelle Lezioni 09, 10 e 11.
Continuità con le lezioni 01–11
Questo esercizio introduce nuovi metodi matematici, ma riutilizza strumenti già acquisiti: Lezioni 01–04 (Script Bridge, tipi numerici, matrici, funzioni, condizioni e cicli), 05–06 (Dataset, Variable ID e lettura canonica), 07 (pubblicazione atomica), 08 (Plot Dataset e debugger), 09 (statistiche e residui), 10 (interpolazione, regressione e fitting) e 11 (derivazione e integrazione numeriche).
| Già affrontato | Novità della Lezione 12 |
|---|---|
| Matrici e prodotto matriciale (03) | Rango, sistemi rettangolari e significato geometrico delle colonne |
| Fitting e residui (10) | Stima simultanea di tre concentrazioni da cinque osservazioni |
| Statistica dei dati (09) | Distinzione tra bontà del residuo e identificabilità del modello |
| Debugger e verifiche (08–11) | Errore scientifico da rango insufficiente e diagnosi mediante SVD |
| API numeriche GX-TXT | linear_matrix: inspect, solve, multiply e svd |
La parola rango richiede un chiarimento: nella Lezione 05 il campo rank di un descrittore di variabile indicava il numero di dimensioni di un array (per esempio 1 per un vettore). Qui rank(A) indica invece il numero di colonne o righe linearmente indipendenti della matrice. Sono concetti distinti, anche se condividono il nome inglese.
1. Il problema scientifico
Tre specie A, B e C assorbono luce a lunghezze d’onda differenti. Acquisiamo cinque valori di assorbanza a 420, 460, 500, 540 e 580 nm. La legge di Beer-Lambert per la miscela è:
\[a_i=\ell\sum_{j=1}^{3}\varepsilon_{ij}c_j+\eta_i\]
Il cammino ottico è \(\ell=1\) cm; \(\varepsilon_{ij}\) è il coefficiente di assorbimento della specie \(j\), \(c_j\) la concentrazione e \(\eta_i\) un piccolo disturbo sintetico. La formulazione matriciale è:
\[\mathbf b=\mathbf A\mathbf c+\boldsymbol\eta,\qquad \mathbf A=\ell\boldsymbol\varepsilon\]
La matrice \(\mathbf A\) ha 5 righe e 3 colonne: misuriamo cinque assorbanze per stimare tre concentrazioni. I dati sono sintetici e deterministici: non sono misure reali.
| Lunghezza d’onda (nm) | Coeff. A | Coeff. B | Coeff. C | Assorbanza |
|---|---|---|---|---|
| 420 | 0,115 | 0,020 | 0,015 | 0,2235 |
| 460 | 0,092 | 0,056 | 0,018 | 0,2180 |
| 500 | 0,054 | 0,097 | 0,038 | 0,2241 |
| 540 | 0,024 | 0,078 | 0,101 | 0,2419 |
| 580 | 0,010 | 0,030 | 0,133 | 0,2139 |
Le unità dei coefficienti sono L/(mmol·cm), le concentrazioni mmol/L e l’assorbanza è adimensionale.
1.1 Perché servono più lunghezze d’onda
A una singola lunghezza d’onda, l’assorbanza di una miscela fornisce un’equazione che dipende dalle tre concentrazioni incognite: in generale non basta per risalire univocamente ad A, B e C. Misurando a cinque lunghezze d’onda otteniamo cinque equazioni per tre incognite. Le tre colonne della matrice rappresentano la risposta di ciascun componente alle cinque lunghezze d’onda.
Il cammino ottico di 1 cm trasforma la matrice dei coefficienti di assorbimento in una matrice A le cui unità sono L/mmol. Il prodotto A*c, con c in mmol/L, è quindi adimensionale, come deve essere l’assorbanza. Questo controllo delle unità aiuta a riconoscere errori che un algoritmo numerico non potrebbe individuare.
I cinque punti non costituiscono uno spettro UV-Vis continuo: sono cinque misure discrete sintetiche. La linea che il grafico unisce fra i punti è un ausilio visivo, non un’informazione sperimentale aggiuntiva.
2. Le matrici in GNU Octave
Le righe di una matrice sono separate da punti e virgola. I vettori colonna usano lo stesso separatore:
A = [0.115, 0.020, 0.015;
     0.092, 0.056, 0.018;
     0.054, 0.097, 0.038;
     0.024, 0.078, 0.101;
     0.010, 0.030, 0.133];
b = [0.2235; 0.2180; 0.2241; 0.2419; 0.2139];

rows(A)
columns(A)
size(A)
L’operatore * esegue la moltiplicazione matriciale, mentre .* moltiplica elemento per elemento. Per i dati reali della lezione, l’operatore ’ fornisce la trasposta; con matrici complesse effettua anche la coniugazione, mentre .’ esegue la sola trasposizione.
Una soluzione di controllo in Octave si può calcolare con A \ b. L’esempio scientifico completo utilizza invece NUMERIC_API_v1/linear_matrix, per far eseguire il calcolo al CORE di GX-TXT. La soluzione tramite Octave è solo una verifica numerica. Evitiamo il metodo inv(A)*b: qui la matrice non è quadrata e, più in generale, formare l’inversa è spesso una scelta numericamente svantaggiosa.
2.1 Dimensioni e compatibilità: la regola prima del calcolo
La matrice A è 5×3, il vettore delle concentrazioni c è 3×1 e il vettore delle assorbanze b è 5×1. Il prodotto A*c è definito perché le dimensioni interne coincidono (3 e 3), e il risultato è un vettore 5×1. Invece c*A non è definito in questo esempio.
\[\underbrace{\mathbf A}_{5\times 3}\,\underbrace{\mathbf c}_{3\times 1}=\underbrace{\widehat{\mathbf b}}_{5\times 1}\]
L’operatore .* esegue invece un prodotto elemento per elemento e richiede dimensioni compatibili con le regole di espansione dell’ambiente Octave. Non sostituisce la moltiplicazione di matrici. Anche la trasposizione va scelta con attenzione: A' coniuga gli elementi complessi, mentre A.' traspone senza coniugare.
A = [1, 2; 3, 4; 5, 6];  % 3x2 matrix
c = [2; 1];                 % 2x1 column vector
b = A * c;                 % 3x1 result
assert(isequal(size(b), [3, 1]));
disp(b);
Questo esempio puramente Octave serve a isolare il concetto di dimensione; il calcolo scientifico principale della lezione utilizza successivamente il servizio pubblico NUMERIC_API_v1.
3. Primo script: creare e pubblicare quattro Dataset
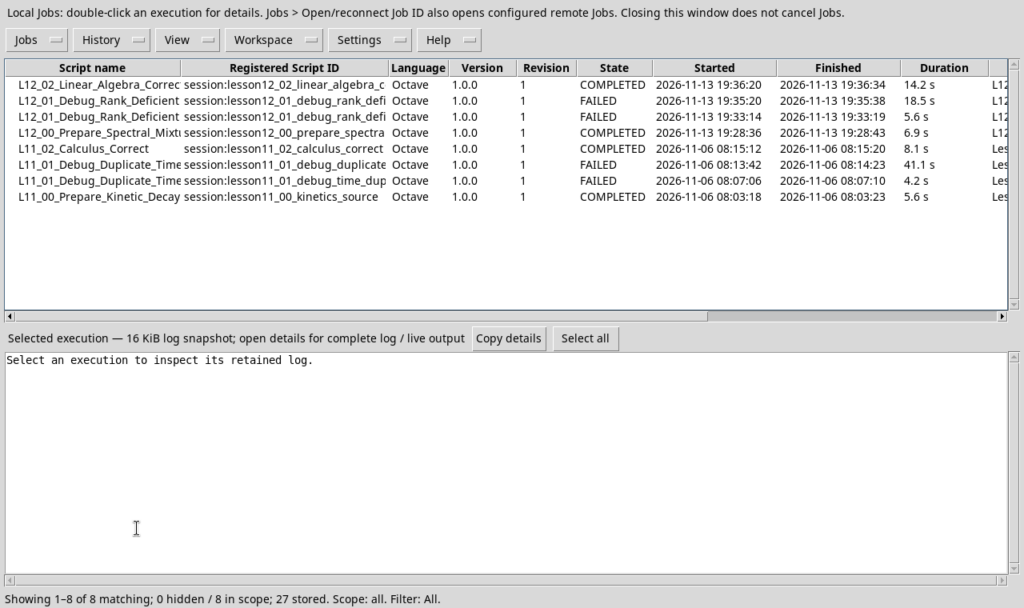
Creiamo una nuova Session standalone, apriamo Viewers → Octave Scripts, importiamo L12_00_Prepare_Spectral_Mixture.m, assegniamo uno Script ID e salviamo. Dal menu Run → Open Script Runner avviamo il Job. Verranno creati quattro Dataset: tre spettri dei coefficienti e lo spettro osservato della miscela. I dati vengono immediatamente riletti per verificare che la pubblicazione abbia conservato i valori corretti.
API per i Dataset
CANONICAL_DATASET_API_v2 definisce la lettura canonica: l’operazione list restituisce gli identificativi disponibili; read_range(dataset_id, variable_ids, start, count) legge le variabili indicate dai loro Variable ID stabili, evitando accessi ai file interni e dipendenze dall’ordine delle colonne.
DATASET_PUBLICATION_API_v2 gestisce la pubblicazione: publish_series_batch riceve una struttura con campo series, composta da specifiche con Dataset ID, vettori X/Y, descrittori delle variabili, unità, provenienza e metadati. Il risultato contiene una ricevuta con atomic e output_count, che devono essere controllati.
dataset_ids = gxtxt_api_call('CANONICAL_DATASET_API_v2', 'list', {});
data = gxtxt_api_call('CANONICAL_DATASET_API_v2', 'read_range', ...
  {'lesson12_mixture_observed', {'wavelength_nm', 'absorbance_au'}, 0, 5});
observed = data.absorbance_au.values(:);
Questa sintassi mostra anche l’accesso ai campi di una struttura Octave: data.absorbance_au.values.
4. Lo Script Bridge e la nuova API di algebra lineare
OCTAVE_SCRIPT_BRIDGE_API_v1 è il collegamento pubblico fra uno script Octave gestito e le API registrate da GX-TXT. gxtxt_api_require verifica prerequisiti e capability, gxtxt_api_has_operation controlla una specifica operazione e gxtxt_api_call esegue una chiamata con argomenti posizionali in un cell array. Non avviamo manualmente il Bridge: lo gestisce il Job GX-TXT.
L’operazione NUMERIC_API_v1 / linear_matrix offre azioni inspect, solve, multiply, svd e altre operazioni algebriche. In questa release, per attraversare correttamente lo Script Bridge occorre racchiudere le matrici in strutture con le parti real e imaginary, di uguali dimensioni. Per matrici reali, la parte immaginaria è una matrice di zeri.
gxtxt_api_require({'NUMERIC_API_v1@1:math.numeric+complex_linear_algebra'});
A_node = struct('real', A, 'imaginary', zeros(size(A)));
b_node = struct('real', b, 'imaginary', zeros(size(b)));

info = gxtxt_api_call('NUMERIC_API_v1', 'linear_matrix', ...
  {'inspect', A_node, []});
solution = gxtxt_api_call('NUMERIC_API_v1', 'linear_matrix', ...
  {'solve', A_node, b_node});
concentrations = solution.value_real(:);
inspect restituisce il rango (rank), il numero di condizionamento (condition_number) e altre proprietà. solve fornisce la soluzione in value_real e value_imaginary, i residui, residual_norm, relative_residual e la modalità di soluzione. multiply calcola un prodotto matriciale; svd restituisce le componenti della decomposizione ai valori singolari.
I contratti completi sono pubblicati a un commit fisso: Script Bridge, Numeric API, Canonical Dataset, Dataset Publication e Plot Dataset v4.
4.1 Perché trasportiamo matrici reali e immaginarie
Octave può rappresentare direttamente i numeri complessi, ma il contratto pubblico di linear_matrix in questa versione richiede un oggetto strutturato con due campi: real e imaginary. Entrambi devono avere la stessa forma. Per la nostra matrice reale la parte immaginaria viene dichiarata esplicitamente come zeros(size(A)). Non è una simulazione di numeri complessi: è il formato di trasporto documentato per lo Script Bridge.
4.2 Che cosa chiediamo al CORE, e con quale risultato
| Operazione pubblica | Ingresso | Interpretazione dell’uscita |
|---|---|---|
| inspect | Matrice A | Rango numerico e condizionamento; verifica preliminare della possibilità di distinguere i componenti |
| solve | Matrice A e vettore b | Concentrazioni stimate ai minimi quadrati, residui e indicatori di soluzione |
| multiply | Matrice A e vettore c stimato | Assorbanza ricostruita; verifica indipendente della soluzione |
| svd | Matrice A | Decomposizione U, S, V e valori singolari per studiare stabilità e rango |
Prima di ogni chiamata è opportuno controllare la disponibilità dell’operazione con gxtxt_api_has_operation. La presenza generica di NUMERIC_API_v1 non autorizza a presumere che una determinata operazione sia supportata da tutte le versioni del framework.
5. Errore intenzionale: due spettri indistinguibili
Importiamo L12_01_Debug_Rank_Deficient.m con uno Script ID diverso. Lo script contiene l’errore scientifico deliberato:
invalid_matrix = design_matrix;
invalid_matrix(:, 3) = invalid_matrix(:, 2);
Le colonne 2 e 3 diventano identiche. Il rango della matrice scende da 3 a 2: il sistema non identifica più separatamente B e C. Apriamo Run → Debug Session script, inseriamo un breakpoint sulla riga 46 dello script distribuito, avviamo Start Debug e osserviamo le variabili invalid_matrix, octave_rank, singular_values, inspect.rank e is_full_column_rank.
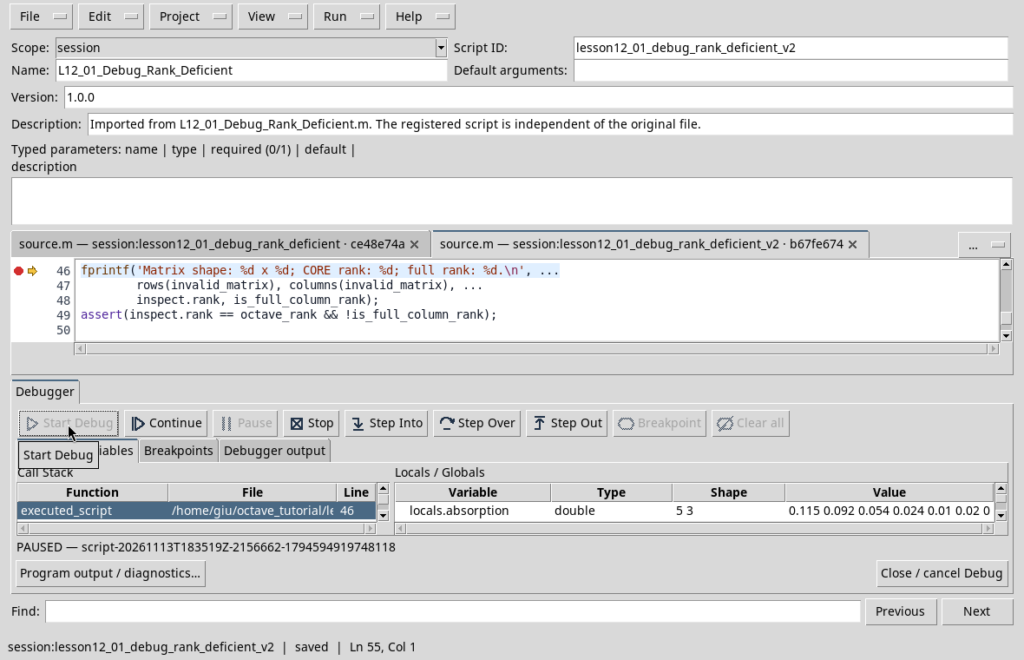
Con Continue, il CORE rifiuta il tentativo di soluzione con l’errore documentato di rango insufficiente. È il risultato atteso: il Job fallisce per impedire di attribuire concentrazioni fisicamente non identificabili.
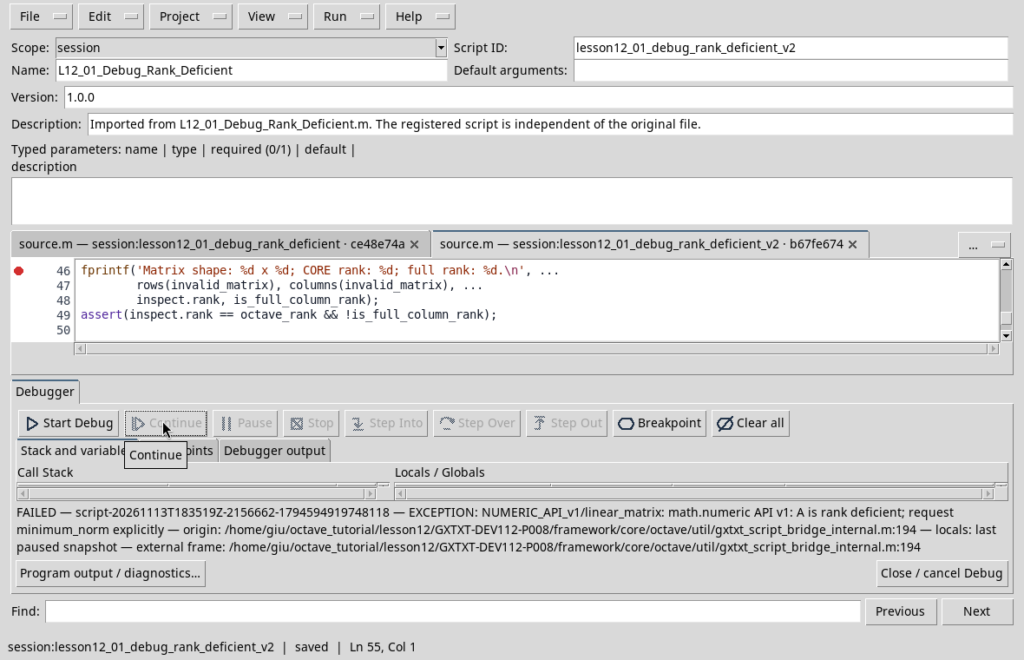
Il contratto supporta anche l’opzione esplicita rank_policy=minimum_norm per una soluzione tramite pseudoinversa. Non è una correzione automatica dei dati: due specie con spettri identici rimangono indistinguibili. Non la usiamo in questa lezione.
5.1 Dal rango all’identificabilità chimica
Il rango massimo di una matrice 5×3 è 3. Se le colonne A, B e C sono indipendenti, è possibile distinguere matematicamente i loro contributi; se due colonne coincidono, il rango scende a 2. In quel caso si può aumentare la concentrazione di B e diminuire quella di C della stessa quantità senza cambiare l’assorbanza prevista. Le due concentrazioni non sono identificabili separatamente dai dati disponibili.
\[\mathbf A_{B}=\mathbf A_{C}\quad\Longrightarrow\quad \mathbf A\bigl(\mathbf c+t[0,1,-1]^T\bigr)=\mathbf A\mathbf c\]
Non bisogna però attendere che le colonne siano esattamente uguali: se gli spettri diventano quasi uguali, la matrice può conservare formalmente rango 3 ma diventare mal condizionata. Una piccola perturbazione dell’assorbanza può allora produrre una grande variazione delle concentrazioni. La SVD della sezione 7 permette di vedere questa transizione.
6. Soluzione corretta: minimi quadrati
Importiamo L12_02_Linear_Algebra_Correct.m e lo eseguiamo nella stessa Session. Il programma rilegge i quattro Dataset, verifica la corrispondenza delle lunghezze d’onda e costruisce una matrice 5×3 di rango completo. Poiché le cinque misure contengono un piccolo rumore, cerchiamo la soluzione che minimizza la somma dei quadrati dei residui:
\[\widehat{\mathbf c}=\underset{\mathbf c}{\operatorname{arg\,min}}\;\left\|\mathbf A\mathbf c-\mathbf b\right\|_2^2\]
L’API pubblica linear_matrix(‘solve’,…) esegue il calcolo, mentre Octave A \ b fornisce un controllo indipendente. Evitiamo le equazioni normali esplicite, che possono amplificare il condizionamento.
| Componente | Concentrazione sintetica originaria | Ricostruzione |
|---|---|---|
| A | 1,600000 mmol/L | 1,597382 mmol/L |
| B | 0,900000 mmol/L | 0,911384 mmol/L |
| C | 1,300000 mmol/L | 1,292708 mmol/L |
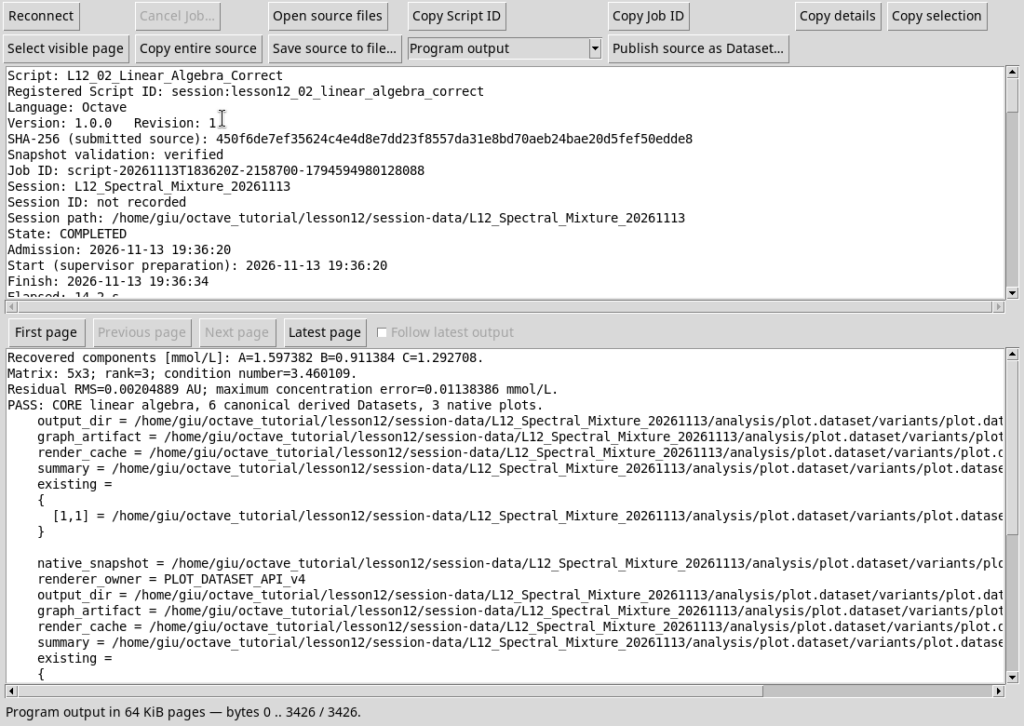
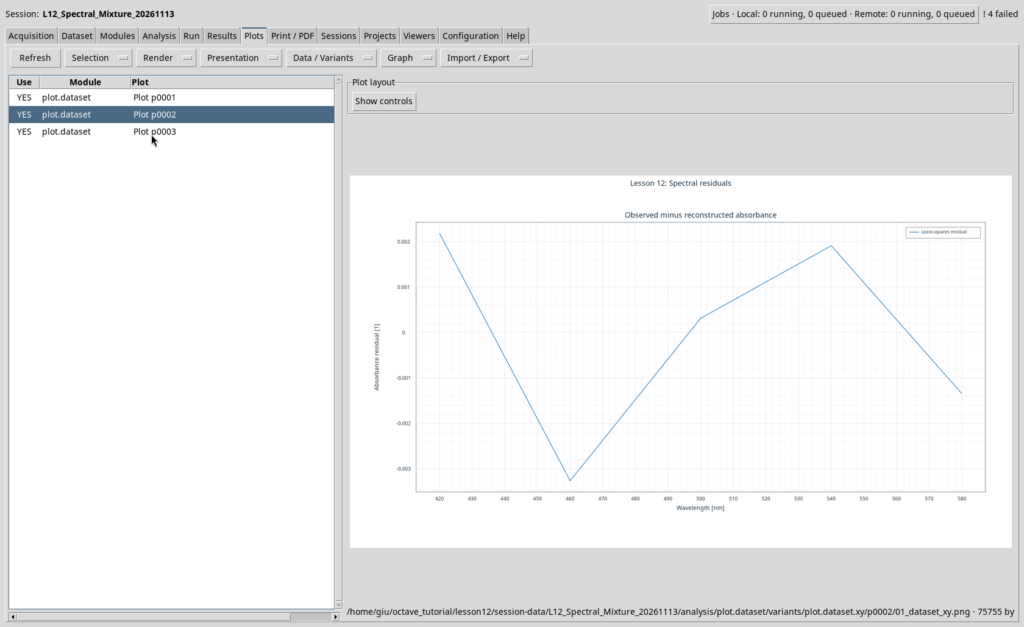
La matrice presenta rango 3 e numero di condizionamento 3,460109. Il residuo RMS è 0,00204889 in assorbanza; il massimo scostamento dalle concentrazioni sintetiche di riferimento è 0,01138386 mmol/L. La differenza dalle concentrazioni originarie deriva dal rumore sintetico introdotto prima del calcolo.
6.1 Perché usiamo i minimi quadrati e non una soluzione esatta
Nella Lezione 10 abbiamo stimato i parametri di una curva di calibrazione. Qui il principio del fitting è analogo, ma il vettore dei parametri contiene tre concentrazioni simultanee. Poiché abbiamo cinque osservazioni e un rumore sintetico non nullo, in genere non esiste un vettore di concentrazioni che soddisfi esattamente tutte le equazioni. Cerchiamo quello che rende minima la somma dei quadrati dei cinque scarti.
\[J(\mathbf c)=\sum_{i=1}^{5}\left(b_i-\sum_{j=1}^{3}A_{ij}c_j\right)^2\]
Per una matrice a rango colonnare completo, il minimo soddisfa A'*(A*c-b)=0: i residui sono ortogonali alle colonne di A. È una proprietà matematica, non la garanzia che il modello fisico sia corretto. In pratica, per stabilità numerica si usano fattorizzazioni come QR o SVD, evitando di formare esplicitamente l’inversa o le equazioni normali A'*A.
6.2 Interpretare i numeri ottenuti
La concentrazione del componente B è la più distante dal valore sintetico iniziale, con uno scarto assoluto di circa 0,01138 mmol/L. Il residuo RMS di 0,00204889 è espresso in unità di assorbanza e descrive lo scostamento medio quadratico fra le cinque osservazioni e il modello ricostruito. Non è automaticamente l’incertezza delle concentrazioni: per stimarla occorrerebbe esplicitare un modello statistico del rumore, le sue correlazioni e le ipotesi di calibrazione.
7. Valori singolari e sensibilità numerica
L’azione linear_matrix(‘svd’,…) calcola la fattorizzazione:
\[\mathbf A=\mathbf U\,\mathbf S\,\mathbf V^{T}\]
I valori singolari \(\sigma_i\) sono gli elementi diagonali di \(\mathbf S\). Il condizionamento in norma 2, per una matrice a rango completo, è:
\[\kappa_2(\mathbf A)=\frac{\sigma_{\max}}{\sigma_{\min}}\]
Se \(\sigma_{\min}\) si avvicina a zero, distinguere alcune componenti diventa difficile: errori piccoli nelle misure possono produrre forti variazioni nelle concentrazioni. Il programma verifica numericamente la ricostruzione U*S*V’ e confronta il rapporto dei valori singolari con il condizionamento calcolato dal CORE.
7.1 Che cosa significa geometricamente la SVD
La decomposizione ai valori singolari separa tre aspetti dell’azione di una matrice: orientazioni di ingresso, amplificazioni lungo direzioni indipendenti e orientazioni di uscita. La matrice V identifica combinazioni delle concentrazioni; S contiene i fattori di amplificazione (i valori singolari); U descrive come queste combinazioni appaiono nello spazio delle assorbanze. Poiché i dati sono reali, la formula usa la trasposta V'. Per matrici complesse la decomposizione richiede la trasposta coniugata.
Per la matrice della lezione i tre valori singolari sono approssimativamente 0,229178, 0,134846 e 0,066234 L/mmol. Nessuno è nullo: il rango è 3. Il rapporto fra il maggiore e il minore vale circa 3,460109, un condizionamento relativamente moderato in questo esempio. Se il valore minimo si annullasse, non potremmo distinguere tutte le concentrazioni.
singular_values = svd(A);
kappa = max(singular_values) / min(singular_values);
fprintf("Condition number = %.6f\n", kappa);
L’esempio appena mostrato è una verifica didattica con la funzione nativa Octave svd(). Nello script della lezione la decomposizione usata per i risultati pubblicati viene richiesta al CORE mediante NUMERIC_API_v1 / linear_matrix, azione svd.
8. Ricostruzione della miscela e residui
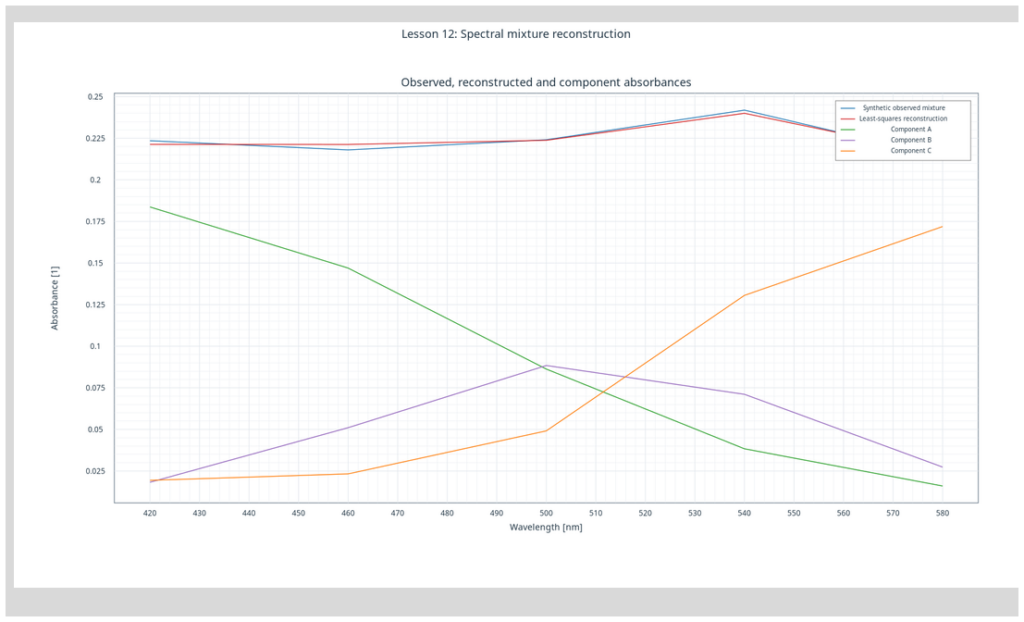
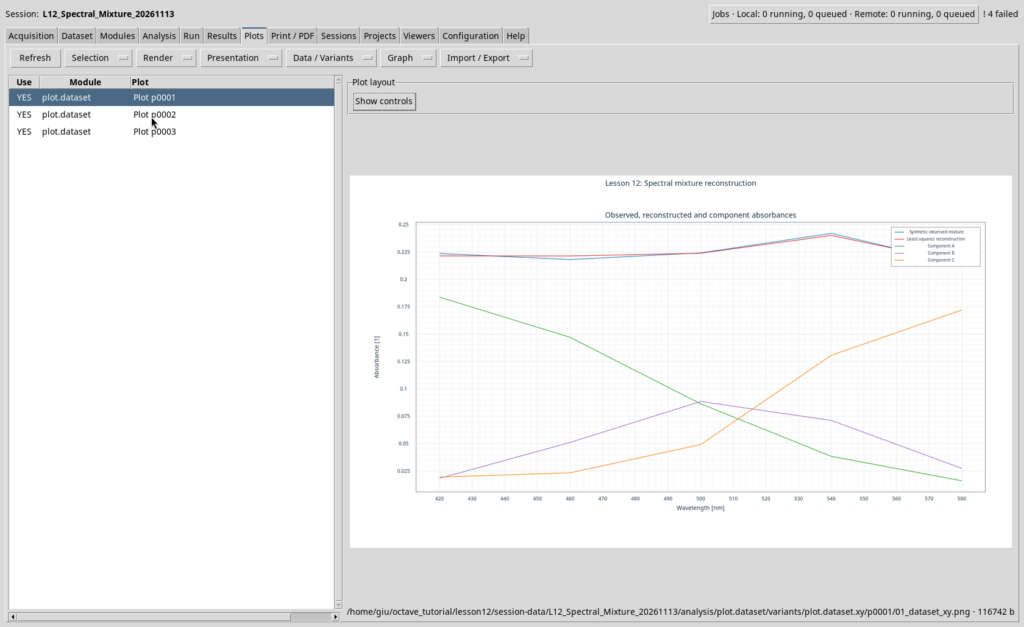
La miscela stimata è \(\widehat{\mathbf b}=\mathbf A\widehat{\mathbf c}\). L’azione pubblica linear_matrix(‘multiply’,…) riproduce il prodotto, mentre Octave calcola i singoli contributi dei tre componenti.
Per visualizzare gli scarti definiamo:
\[r_i=b_i-\widehat b_i\]
Attenzione ai segni: la ricevuta di solve esprime il residuo come A*c - b, mentre il nostro grafico usa b - A*c. I due vettori sono opposti; lo script controlla esplicitamente questa relazione.
8.1 Residui, segno e controlli scientifici
Il residuo scelto per il grafico è r = b - A*c_hat, cioè osservato meno ricostruito. Alcune API di soluzione lineare restituiscono invece A*c_hat - b; lo script verifica che i due vettori siano opposti. Il segno cambia l’orientamento del grafico, ma non la norma euclidea né il valore RMS.
\[\mathrm{RMS}(\mathbf r)=\sqrt{\frac{1}{5}\sum_{i=1}^{5}r_i^2}\]
Un residuo piccolo indica che il modello riproduce bene queste cinque assorbanze; non dimostra da solo che le specie chimiche siano davvero tre, che i coefficienti siano esatti o che non esistano interferenze. Un’analisi su misure reali richiederebbe verifiche di linearità Beer-Lambert, qualità delle misure, possibili sovrapposizioni e incertezze dei coefficienti spettrali.
9. Sei Dataset derivati e tre grafici nativi
Lo script pubblica in un’unica transazione i Dataset della miscela ricostruita, dei residui, dei tre contributi A/B/C e dei valori singolari. Ogni risultato è riletto tramite API canonica.
PLOT_DATASET_API_v4 consente di creare grafici scientifici persistenti. new_spec prepara la struttura del grafico, validate_spec la verifica, upsert_plot registra un oggetto persistente che fa riferimento a Dataset ID e Variable ID, render genera la rappresentazione e artifacts restituisce le risorse prodotte. Non usiamo grafici Octave temporanei al posto del sistema scientifico GX-TXT.
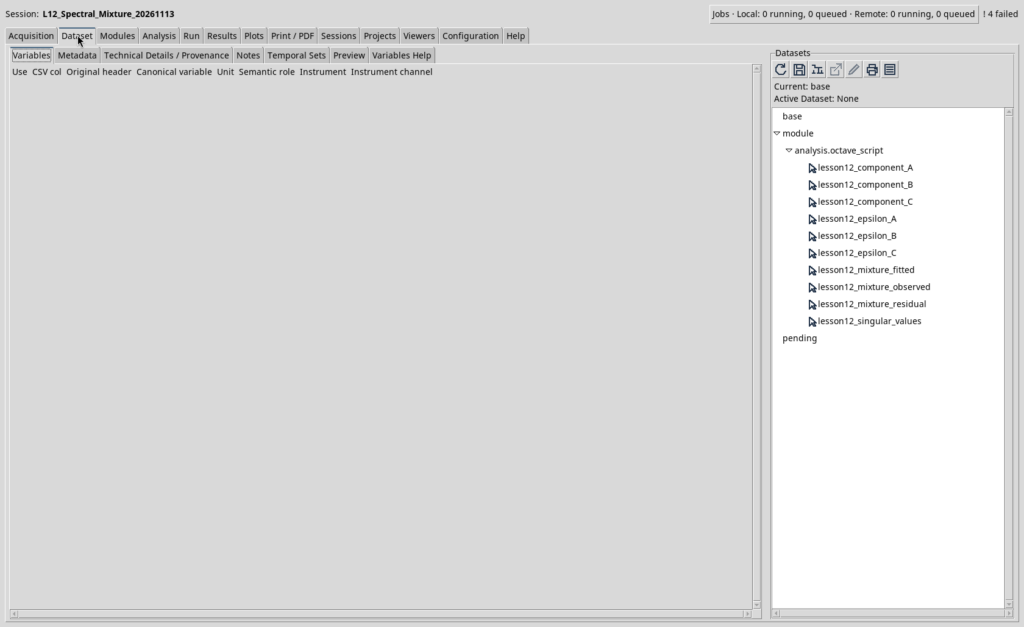
9.1 Perché i Dataset derivati restano separati
Il Dataset osservato rimane distinto da quello ricostruito perché corrispondono a grandezze con provenienza differente: il primo simula una misura, il secondo è il risultato di un modello matematico. I tre contributi delle specie, il residuo e i valori singolari vengono pubblicati come ulteriori Dataset canonici. È un’estensione della pubblicazione atomica introdotta nella Lezione 07, applicata ora a un’analisi inversa.
I Plot Dataset v4 conservano riferimenti a Dataset ID e Variable ID: non sono semplici immagini esportate da Octave. In questo modo i grafici rimangono collegati ai risultati scientifici gestiti da GX-TXT. La visualizzazione dei cinque campioni con linee continue non implica che siano stati acquisiti punti intermedi.
10. Procedura completa per lo studente
- Creare una nuova Session in GX-TXT e aprire Viewers → Octave Scripts.
- Importare, registrare ed eseguire L12_00_Prepare_Spectral_Mixture.m tramite Run → Open Script Runner.
- Importare L12_01_Debug_Rank_Deficient.m con uno Script ID diverso. Aprire Run → Debug Session script, fermarsi al breakpoint e verificare il rango 2; proseguire fino all’errore atteso.
- Importare ed eseguire L12_02_Linear_Algebra_Correct.m, usando un terzo Script ID.
- Esaminare i sei Dataset derivati e i tre grafici nella scheda Plots.
I Dataset hanno identificativi create-only: per ripetere la sequenza, usare una nuova Session; non intervenire manualmente sui registri o sui file del CORE.
Controlli concettuali prima di passare agli esercizi. Lo studente dovrebbe saper spiegare: perché cinque equazioni possono stimare tre concentrazioni, che cosa significa il rango 3, perché rango 2 rende indistinguibili due componenti, che cosa misura il numero di condizionamento, perché il residuo RMS non coincide con l’incertezza delle concentrazioni e quale ruolo svolgono i Dataset canonici nel rendere riproducibili i risultati.
11. Esercizi
Dimensioni. Ridurre le lunghezze d’onda a quattro e aggiornare coerentemente la matrice e i Dataset. Quali dimensioni deve avere il vettore delle misure?
Condizionamento. Rendere gli spettri B e C progressivamente simili e osservare il numero di condizionamento. Cosa succede alla stabilità delle concentrazioni?
Rumore. Aumentare il rumore sintetico e confrontare il residuo RMS con l’errore sulle concentrazioni. Un residuo minore garantisce sempre un modello corretto?
Matrici complesse. Costruire due piccole matrici con parti reali e immaginarie e utilizzare linear_matrix(‘multiply’,…); ricostruire il risultato complesso con la funzione Octave complex.
Materiali
Il materiale comprende tre script GNU Octave con commenti esclusivamente in inglese, guide italiane e inglesi, schermate reali GX-TXT e riferimenti ai contratti API pubblici. Gli script sono distribuiti con licenza GNU GPL-3.0-or-later. L’esempio insegna a distinguere il semplice calcolo numerico dalla costruzione di un’analisi scientifica verificabile e riproducibile.
Script GNU Octave completi
Aprire ciascun riquadro per consultare e copiare il codice completo. Tutti i commenti sono in inglese.
L12_00_Prepare_Spectral_Mixture.m
% Lesson 12 - Publish a synthetic three-component UV/Vis calibration experiment.
% Course: GNU Octave with GX-TXT | DEV112 Release 2 + P008
% GitHub release: https://github.com/giuxlab-hub/GX-TXT/releases/tag/v0.9.8.10-dev-112-r2-p008
% Pinned public source commit: 17ff2a7f93de0612015a873e626f87dbeb56b6a2
% SPDX-License-Identifier: GPL-3.0-or-later
%
% Run once in a new managed GX-TXT Session.
% All numbers are synthetic educational data, not experimental measurements.
% Extinction coefficients use L/(mmol*cm); optical path length is 1 cm.

dataset_api = 'CANONICAL_DATASET_API_v2';
publication_api = 'DATASET_PUBLICATION_API_v2';
gxtxt_api_require({dataset_api, publication_api});
assert(gxtxt_api_has_operation(dataset_api, 'list'));
assert(gxtxt_api_has_operation(dataset_api, 'read_range'));
assert(gxtxt_api_has_operation(publication_api, 'publish_series_batch'));

wavelength_nm = [420; 460; 500; 540; 580];
epsilon = [0.115, 0.020, 0.015;
           0.092, 0.056, 0.018;
           0.054, 0.097, 0.038;
           0.024, 0.078, 0.101;
           0.010, 0.030, 0.133];
path_length_cm = 1.0;
reference_concentrations_mmol_L = [1.6; 0.9; 1.3];
synthetic_noise_au = [0.002; -0.003; 0.001; 0.002; -0.002];
absorbance_au = (epsilon * path_length_cm) * ...
                reference_concentrations_mmol_L + synthetic_noise_au;
assert(isequal(size(epsilon), [5, 3]));
assert(all(isfinite(epsilon(:))) && all(isfinite(absorbance_au)));
assert(all(diff(wavelength_nm) > 0));

dataset_ids = {'lesson12_epsilon_A', 'lesson12_epsilon_B', ...
               'lesson12_epsilon_C', 'lesson12_mixture_observed'};
available_ids = gxtxt_api_call(dataset_api, 'list', {});
for k = 1:numel(dataset_ids)
  if any(strcmp(available_ids, dataset_ids{k}))
    error('Source Dataset already exists: %s. Use a new Session.', ...
          dataset_ids{k});
  endif
endfor

wavelength_var = struct('variable_id', 'wavelength_nm', ...
  'name', 'wavelength_nm', 'display_label', 'Wavelength', ...
  'unit', 'nm', 'dtype', 'float64', 'value_kind', 'number', ...
  'semantic_source', 'generator');
epsilon_var = struct('variable_id', 'epsilon_L_mmol_cm', ...
  'name', 'epsilon_L_mmol_cm', 'display_label', ...
  'Synthetic molar absorptivity', 'unit', 'L/(mmol*cm)', ...
  'dtype', 'float64', 'value_kind', 'number', ...
  'semantic_source', 'generator');
absorbance_var = struct('variable_id', 'absorbance_au', ...
  'name', 'absorbance_au', 'display_label', 'Synthetic absorbance', ...
  'unit', '1', 'dtype', 'float64', 'value_kind', 'number', ...
  'semantic_source', 'generator');

series = cell(1, 4);
for k = 1:4
  if k <= 3
    values = epsilon(:, k);
    variable = epsilon_var;
    label = sprintf('Synthetic pure-component absorptivity %s', char('A'+k-1));
  else
    values = absorbance_au;
    variable = absorbance_var;
    label = 'Synthetic observed mixture absorbance';
  endif
  metadata = struct();
  metadata.('simulation.synthetic') = true;
  metadata.('simulation.wavelength_count') = numel(wavelength_nm);
  metadata.('simulation.path_length_cm') = path_length_cm;
  metadata.('simulation.model') = 'Beer-Lambert multicomponent linear model';
  metadata.('simulation.series_label') = label;
  series{k} = struct('dataset_id', dataset_ids{k}, ...
    'contract', 'table.generic', 'storage', 'auto', ...
    'x_values', wavelength_nm, 'y_values', values, ...
    'x_variable', wavelength_var, 'y_variable', variable, ...
    'producer_version', '1.0.0', ...
    'source', 'GX-TXT GNU Octave Lesson 12', ...
    'provenance', 'Deterministic synthetic five-wavelength UV/Vis example', ...
    'notes', label, 'structured_metadata', metadata);
endfor
batch = struct('series', {series});
receipt = gxtxt_api_call(publication_api, 'publish_series_batch', {batch});
if !receipt.atomic || receipt.output_count != 4
  error('Atomic publication did not confirm four source Datasets.');
endif

% Read every series back via canonical Dataset and Variable identifiers.
for k = 1:4
  if k <= 3
    y_id = 'epsilon_L_mmol_cm';
    expected = epsilon(:, k);
  else
    y_id = 'absorbance_au';
    expected = absorbance_au;
  endif
  result = gxtxt_api_call(dataset_api, 'read_range', ...
    {dataset_ids{k}, {'wavelength_nm', y_id}, 0, 5});
  assert(max(abs(result.wavelength_nm.values(:) - wavelength_nm)) < 1e-12);
  assert(max(abs(result.(y_id).values(:) - expected)) < 1e-12);
endfor
fprintf('PASS: 4 canonical synthetic source Datasets published and verified.\n');
fprintf('Synthetic reference concentrations [mmol/L]: %.3f %.3f %.3f\n', ...
        reference_concentrations_mmol_L);
L12_01_Debug_Rank_Deficient.m
% Lesson 12 - Intentional rank-deficient linear system for debugging.
% Course: GNU Octave with GX-TXT | DEV112 Release 2 + P008
% GitHub source commit: 17ff2a7f93de0612015a873e626f87dbeb56b6a2
% SPDX-License-Identifier: GPL-3.0-or-later
%
% Run after L12_00 in the same Session. The public solver MUST reject this.
% Set a debugger breakpoint on the marked line before the API call.
% No canonical Dataset or plot is created by this intentionally failing script.

dataset_api = 'CANONICAL_DATASET_API_v2';
numeric_api = 'NUMERIC_API_v1';
gxtxt_api_require({dataset_api, numeric_api});
assert(gxtxt_api_has_operation(dataset_api, 'read_range'));
assert(gxtxt_api_has_operation(numeric_api, 'linear_matrix'));

spectral_ids = {'lesson12_epsilon_A', 'lesson12_epsilon_B', ...
                'lesson12_epsilon_C'};
absorption = zeros(5, 3);
for k = 1:3
  result = gxtxt_api_call(dataset_api, 'read_range', ...
    {spectral_ids{k}, {'wavelength_nm', 'epsilon_L_mmol_cm'}, 0, 5});
  absorption(:, k) = result.epsilon_L_mmol_cm.values(:);
endfor
measurement = gxtxt_api_call(dataset_api, 'read_range', ...
  {'lesson12_mixture_observed', {'wavelength_nm', 'absorbance_au'}, 0, 5});
observed_au = measurement.absorbance_au.values(:);
path_length_cm = 1.0;
design_matrix = absorption * path_length_cm;

% INTENTIONAL SCIENTIFIC ERROR: two components now have identical spectra.
% The matrix columns are linearly dependent; their amounts are not identifiable.
invalid_matrix = design_matrix;
invalid_matrix(:, 3) = invalid_matrix(:, 2);
octave_rank = rank(invalid_matrix);
singular_values = svd(invalid_matrix);
% The Script Bridge transports matrices in explicit real/imaginary envelopes.
invalid_node = struct('real', invalid_matrix, ...
  'imaginary', zeros(size(invalid_matrix)));
observed_node = struct('real', observed_au, ...
  'imaginary', zeros(size(observed_au)));
inspect = gxtxt_api_call(numeric_api, 'linear_matrix', ...
  {'inspect', invalid_node, []});
is_full_column_rank = (inspect.rank == columns(invalid_matrix));

% BREAKPOINT: inspect invalid_matrix, octave_rank, singular_values and inspect.rank.
fprintf('Matrix shape: %d x %d; CORE rank: %d; full rank: %d.\n', ...
        rows(invalid_matrix), columns(invalid_matrix), ...
        inspect.rank, is_full_column_rank);
assert(inspect.rank == octave_rank && !is_full_column_rank);

% No automatic pseudoinverse is requested: the documented default rejects rank loss.
invalid_solution = gxtxt_api_call(numeric_api, 'linear_matrix', ...
  {'solve', invalid_node, observed_node});
error('Unexpected success: rank-deficient system was accepted.');
L12_02_Linear_Algebra_Correct.m
% Lesson 12 - Recover three concentrations with public GX-TXT linear algebra.
% Course: GNU Octave with GX-TXT | DEV112 Release 2 + P008
% GitHub release: https://github.com/giuxlab-hub/GX-TXT/releases/tag/v0.9.8.10-dev-112-r2-p008
% Pinned source commit: 17ff2a7f93de0612015a873e626f87dbeb56b6a2
% SPDX-License-Identifier: GPL-3.0-or-later
%
% Run after L12_00 in a fresh managed GX-TXT Session.
% The calculations use NUMERIC_API_v1/linear_matrix, not a private solver.
% All canonical input/output and plotting operations use public APIs.

dataset_api = 'CANONICAL_DATASET_API_v2';
numeric_api = 'NUMERIC_API_v1';
publication_api = 'DATASET_PUBLICATION_API_v2';
plot_api = 'PLOT_DATASET_API_v4';
gxtxt_api_require({dataset_api, ...
  'NUMERIC_API_v1@1:math.numeric+complex_linear_algebra', ...
  publication_api, plot_api});
required = {
  dataset_api, 'list'; dataset_api, 'read_range';
  numeric_api, 'linear_matrix';
  publication_api, 'publish_series_batch';
  plot_api, 'new_spec'; plot_api, 'validate_spec';
  plot_api, 'upsert_plot'; plot_api, 'render'; plot_api, 'artifacts'
};
for k = 1:rows(required)
  if !gxtxt_api_has_operation(required{k, 1}, required{k, 2})
    error('Missing public operation %s/%s.', required{k, 1}, required{k, 2});
  endif
endfor

% Step 1: read four published source Datasets using stable Variable IDs.
source_ids = {'lesson12_epsilon_A', 'lesson12_epsilon_B', ...
              'lesson12_epsilon_C', 'lesson12_mixture_observed'};
available_ids = gxtxt_api_call(dataset_api, 'list', {});
for k = 1:numel(source_ids)
  if !any(strcmp(available_ids, source_ids{k}))
    error('Missing source Dataset %s: execute L12_00 first.', source_ids{k});
  endif
endfor

n_wavelengths = 5;
wavelength_nm = [];
epsilon = zeros(n_wavelengths, 3);
for k = 1:3
  data = gxtxt_api_call(dataset_api, 'read_range', ...
    {source_ids{k}, {'wavelength_nm', 'epsilon_L_mmol_cm'}, ...
     0, n_wavelengths});
  current_wavelengths = data.wavelength_nm.values(:);
  if k == 1
    wavelength_nm = current_wavelengths;
  elseif max(abs(current_wavelengths - wavelength_nm)) > 1e-12
    error('Component spectra have different wavelength grids.');
  endif
  epsilon(:, k) = data.epsilon_L_mmol_cm.values(:);
endfor
data = gxtxt_api_call(dataset_api, 'read_range', ...
  {source_ids{4}, {'wavelength_nm', 'absorbance_au'}, 0, n_wavelengths});
observed_au = data.absorbance_au.values(:);
if numel(observed_au) != n_wavelengths || ...
   max(abs(data.wavelength_nm.values(:) - wavelength_nm)) > 1e-12 || ...
   !all(isfinite(epsilon(:))) || !all(isfinite(observed_au))
  error('Nonfinite, incomplete, or misaligned spectral observations.');
endif

% Step 2: apply Beer-Lambert units and inspect the overdetermined system.
% epsilon: L/(mmol*cm), path_length: cm, A: L/mmol, c: mmol/L, b: 1.
path_length_cm = 1.0;
A = epsilon * path_length_cm;
b = observed_au;
if !isequal(size(A), [5, 3]) || !isequal(size(b), [5, 1])
  error('Expected a five-row, three-column design matrix and five observations.');
endif
% Explicit matrix envelopes preserve real/imaginary structure across the Bridge.
A_node = struct('real', A, 'imaginary', zeros(size(A)));
b_node = struct('real', b, 'imaginary', zeros(size(b)));
matrix_info = gxtxt_api_call(numeric_api, 'linear_matrix', ...
  {'inspect', A_node, []});
if matrix_info.rank != columns(A) || ...
   !isfinite(matrix_info.condition_number) || ...
   matrix_info.condition_number >= 1e12
  error('Spectral system has insufficient rank or excessive conditioning.');
endif

% Step 3: solve a full-column-rank overdetermined system via the CORE.
% The documented default policy is rank_policy=error, not minimum_norm.
solution = gxtxt_api_call(numeric_api, 'linear_matrix', ...
  {'solve', A_node, b_node});
estimated_mmol_L = solution.value_real(:);
assert(max(abs(solution.value_imaginary(:))) < 1e-12);
assert(numel(estimated_mmol_L) == 3);
assert(all(estimated_mmol_L >= 0) && all(isfinite(estimated_mmol_L)));

% Octave backslash is presented only as a language-learning cross-check.
octave_reference = A \ b;
assert(norm(estimated_mmol_L - octave_reference, Inf) < 1e-9);
assert(solution.rank == 3);
assert(solution.relative_residual < 0.03);

% Step 4: independently reconstruct absorbance using public multiplication.
calculated = gxtxt_api_call(numeric_api, 'linear_matrix', ...
  {'multiply', A_node, ...
   struct('real', estimated_mmol_L, ...
          'imaginary', zeros(size(estimated_mmol_L)))});
fitted_au = calculated.value_real(:);
assert(max(abs(calculated.value_imaginary(:))) < 1e-12);
residual_au = b - fitted_au;
assert(norm(residual_au + solution.residual_real(:)) < 1e-9);
residual_rms_au = sqrt(mean(residual_au .^ 2));
reference_mmol_L = [1.6; 0.9; 1.3];
max_concentration_error_mmol_L = ...
  max(abs(estimated_mmol_L - reference_mmol_L));
if max_concentration_error_mmol_L >= 0.05 || residual_rms_au > 0.004
  error('The synthetic reconstruction failed numerical accuracy checks.');
endif

% Step 5: decompose the coefficient matrix with the public SVD operation.
decomposition = gxtxt_api_call(numeric_api, 'linear_matrix', ...
  {'svd', A_node, []});
U = decomposition.u_real;
S = decomposition.s_real;
V = decomposition.v_real;
assert(norm(U * S * V' - A, 'fro') < 1e-10);
singular_values = diag(S);
assert(numel(singular_values) == 3 && all(singular_values > 0));
assert(abs(max(singular_values) / min(singular_values) - ...
           matrix_info.condition_number) < 1e-8);

% Reconstruct the contribution of each component without inverting A.
component_absorbance_au = A .* repmat(estimated_mmol_L.', n_wavelengths, 1);
assert(max(abs(sum(component_absorbance_au, 2) - fitted_au)) < 1e-10);
fprintf('Recovered components [mmol/L]: A=%.6f B=%.6f C=%.6f.\n', ...
        estimated_mmol_L);
fprintf('Matrix: %dx%d; rank=%d; condition number=%.6f.\n', ...
        rows(A), columns(A), matrix_info.rank, ...
        matrix_info.condition_number);
fprintf('Residual RMS=%.8f AU; maximum concentration error=%.8f mmol/L.\n', ...
        residual_rms_au, max_concentration_error_mmol_L);

% Step 6: publish six derived canonical Datasets in one atomic transaction.
derived_ids = {'lesson12_mixture_fitted', 'lesson12_mixture_residual', ...
  'lesson12_component_A', 'lesson12_component_B', ...
  'lesson12_component_C', 'lesson12_singular_values'};
for k = 1:numel(derived_ids)
  if any(strcmp(available_ids, derived_ids{k}))
    error('Derived Dataset exists: %s. Start a new Session.', derived_ids{k});
  endif
endfor
wavelength_var = struct('variable_id', 'wavelength_nm', ...
  'name', 'wavelength_nm', 'display_label', 'Wavelength', ...
  'unit', 'nm', 'dtype', 'float64', 'value_kind', 'number', ...
  'semantic_source', 'plugin');
index_var = struct('variable_id', 'singular_index', ...
  'name', 'singular_index', 'display_label', 'Singular-value index', ...
  'unit', '1', 'dtype', 'float64', 'value_kind', 'number', ...
  'semantic_source', 'plugin');
absorbance_var = struct('variable_id', 'absorbance_au', ...
  'name', 'absorbance_au', 'display_label', 'Calculated absorbance', ...
  'unit', '1', 'dtype', 'float64', 'value_kind', 'number', ...
  'semantic_source', 'plugin');
residual_var = struct('variable_id', 'residual_au', ...
  'name', 'residual_au', 'display_label', 'Observed minus fitted', ...
  'unit', '1', 'dtype', 'float64', 'value_kind', 'number', ...
  'semantic_source', 'plugin');
singular_var = struct('variable_id', 'singular_value_L_mmol', ...
  'name', 'singular_value_L_mmol', 'display_label', 'Singular value', ...
  'unit', 'L/mmol', 'dtype', 'float64', 'value_kind', 'number', ...
  'semantic_source', 'plugin');

x_values = {wavelength_nm, wavelength_nm, wavelength_nm, ...
            wavelength_nm, wavelength_nm, (1:3)'};
y_values = {fitted_au, residual_au, component_absorbance_au(:, 1), ...
            component_absorbance_au(:, 2), ...
            component_absorbance_au(:, 3), singular_values};
x_variables = {wavelength_var, wavelength_var, wavelength_var, ...
               wavelength_var, wavelength_var, index_var};
y_variables = {absorbance_var, residual_var, absorbance_var, ...
               absorbance_var, absorbance_var, singular_var};
descriptions = {'Least-squares fitted mixture', 'Absorbance residuals', ...
                'Component A absorbance', 'Component B absorbance', ...
                'Component C absorbance', 'Design-matrix singular values'};
series = cell(1, numel(derived_ids));
for k = 1:numel(derived_ids)
  metadata = struct();
  metadata.('analysis.method') = descriptions{k};
  metadata.('analysis.synthetic_source') = true;
  metadata.('analysis.matrix_rank') = matrix_info.rank;
  metadata.('analysis.condition_number') = matrix_info.condition_number;
  metadata.('analysis.residual_rms_au') = residual_rms_au;
  metadata.('analysis.concentration_A_mmol_L') = estimated_mmol_L(1);
  metadata.('analysis.concentration_B_mmol_L') = estimated_mmol_L(2);
  metadata.('analysis.concentration_C_mmol_L') = estimated_mmol_L(3);
  series{k} = struct('dataset_id', derived_ids{k}, ...
    'contract', 'table.generic', 'storage', 'auto', ...
    'x_values', x_values{k}, 'y_values', y_values{k}, ...
    'x_variable', x_variables{k}, 'y_variable', y_variables{k}, ...
    'producer_version', '1.0.0', ...
    'source', 'GX-TXT GNU Octave Lesson 12', ...
    'source_dataset_ids', {source_ids}, ...
    'provenance', 'Synthetic spectral mixture solved through public NUMERIC_API_v1', ...
    'notes', descriptions{k}, 'structured_metadata', metadata);
endfor
receipt = gxtxt_api_call(publication_api, 'publish_series_batch', ...
  {struct('series', {series})});
if !receipt.atomic || receipt.output_count != numel(derived_ids)
  error('Atomic publication did not confirm six derived Datasets.');
endif
for k = 1:numel(derived_ids)
  recovered = gxtxt_api_call(dataset_api, 'read_range', ...
    {derived_ids{k}, ...
     {x_variables{k}.variable_id, y_variables{k}.variable_id}, ...
     0, numel(y_values{k})});
  saved = recovered.(y_variables{k}.variable_id).values(:);
  if numel(saved) != numel(y_values{k}) || ...
     max(abs(saved - y_values{k})) > 1e-9
    error('Public Dataset read-back mismatch: %s.', derived_ids{k});
  endif
endfor

% Step 7: make native GX-TXT Plot Dataset v4 visualizations.
comparison = gxtxt_api_call(plot_api, 'new_spec', ...
  {'plot.dataset.xy', 'Lesson 12: Spectral mixture reconstruction'});
panel = comparison.panels{1};
panel.id = 'spectral_reconstruction';
panel.title = 'Observed, reconstructed and component absorbances';
panel.axes = struct('x', struct('label', 'Wavelength [nm]', 'scale', 'linear'), ...
  'y_left', struct('label', 'Absorbance [1]', 'scale', 'linear'));
panel.series = {
  struct('id', 'measured', 'label', 'Synthetic observed mixture', ...
    'dataset_id', source_ids{4}, 'x_variable_id', 'wavelength_nm', ...
    'y_variable_id', 'absorbance_au', 'axis', 'left', 'kind', 'line'),
  struct('id', 'fitted', 'label', 'Least-squares reconstruction', ...
    'dataset_id', derived_ids{1}, 'x_variable_id', 'wavelength_nm', ...
    'y_variable_id', 'absorbance_au', 'axis', 'left', 'kind', 'line'),
  struct('id', 'A', 'label', 'Component A', ...
    'dataset_id', derived_ids{3}, 'x_variable_id', 'wavelength_nm', ...
    'y_variable_id', 'absorbance_au', 'axis', 'left', 'kind', 'line'),
  struct('id', 'B', 'label', 'Component B', ...
    'dataset_id', derived_ids{4}, 'x_variable_id', 'wavelength_nm', ...
    'y_variable_id', 'absorbance_au', 'axis', 'left', 'kind', 'line'),
  struct('id', 'C', 'label', 'Component C', ...
    'dataset_id', derived_ids{5}, 'x_variable_id', 'wavelength_nm', ...
    'y_variable_id', 'absorbance_au', 'axis', 'left', 'kind', 'line')
};
comparison.panels = {panel};
if !gxtxt_api_call(plot_api, 'validate_spec', {comparison})
  error('Spectral comparison PlotSpec is invalid.');
endif
comparison_ref = gxtxt_api_call(plot_api, 'upsert_plot', ...
  {'lesson12_spectral_reconstruction', comparison});
gxtxt_api_call(plot_api, 'render', {comparison_ref});
comparison_artifacts = gxtxt_api_call(plot_api, 'artifacts', {comparison_ref});

residual_plot = gxtxt_api_call(plot_api, 'new_spec', ...
  {'plot.dataset.xy', 'Lesson 12: Spectral residuals'});
rp = residual_plot.panels{1};
rp.id = 'spectral_residual';
rp.title = 'Observed minus reconstructed absorbance';
rp.axes = struct('x', struct('label', 'Wavelength [nm]', 'scale', 'linear'), ...
  'y_left', struct('label', 'Absorbance residual [1]', 'scale', 'linear'));
rp.series = {struct('id', 'residual', 'label', 'Least-squares residual', ...
  'dataset_id', derived_ids{2}, 'x_variable_id', 'wavelength_nm', ...
  'y_variable_id', 'residual_au', 'axis', 'left', 'kind', 'line')};
residual_plot.panels = {rp};
if !gxtxt_api_call(plot_api, 'validate_spec', {residual_plot})
  error('Residual PlotSpec is invalid.');
endif
residual_ref = gxtxt_api_call(plot_api, 'upsert_plot', ...
  {'lesson12_spectral_residual', residual_plot});
gxtxt_api_call(plot_api, 'render', {residual_ref});
residual_artifacts = gxtxt_api_call(plot_api, 'artifacts', {residual_ref});

sv_plot = gxtxt_api_call(plot_api, 'new_spec', ...
  {'plot.dataset.xy', 'Lesson 12: Spectral matrix singular values'});
sp = sv_plot.panels{1};
sp.id = 'singular_values';
sp.title = 'Singular values of the five-by-three spectral matrix';
sp.axes = struct('x', struct('label', 'Singular-value index', 'scale', 'linear'), ...
  'y_left', struct('label', 'Singular value [L/mmol]', 'scale', 'linear'));
sp.series = {struct('id', 'sv', 'label', 'Singular values', ...
  'dataset_id', derived_ids{6}, 'x_variable_id', 'singular_index', ...
  'y_variable_id', 'singular_value_L_mmol', ...
  'axis', 'left', 'kind', 'line')};
sv_plot.panels = {sp};
if !gxtxt_api_call(plot_api, 'validate_spec', {sv_plot})
  error('Singular-value PlotSpec is invalid.');
endif
sv_ref = gxtxt_api_call(plot_api, 'upsert_plot', ...
  {'lesson12_singular_values', sv_plot});
gxtxt_api_call(plot_api, 'render', {sv_ref});
sv_artifacts = gxtxt_api_call(plot_api, 'artifacts', {sv_ref});

fprintf('PASS: CORE linear algebra, 6 canonical derived Datasets, 3 native plots.\n');
disp(comparison_artifacts);
disp(residual_artifacts);
disp(sv_artifacts);
Altre tappe del progetto
- Lezione 01 — Il primo script GNU Octave in GX-TXT
- Lezione 02 — Variabili, tipi di dati e operatori in GNU Octave con GX-TXT
- Lezione 03 — Vettori e matrici in GNU Octave con GX-TXT: analisi di misure di temperatura
- Lezione 04 — condizioni, cicli e funzioni. Simuliamo la legge di raffreddamento di Newton
- Lezione 05: Dataset scientifici e Variable ID
- Lezione 06 — Selezione e lettura dei dati sperimentali con GNU Octave e GX-TXT