

Cicli for, enumerate e catalogo Dataset
Corso Python scientifico in GX-TXT · Modulo 2 · Lezione 9
Un ciclo ripete un blocco per ogni elemento di una sequenza. In questa lezione attraverseremo liste e intervalli, poi useremo un ciclo per elencare Dataset realmente presenti in una Session GX-TXT. Per rendere l’esempio riproducibile, lo script prepara una piccola serie sintetica se non è già presente.
Obiettivi: usare for,
range ed enumerate; capire unpacking e
indentazione; interrogare il catalogo Dataset con API pubbliche e
riconoscere il costo delle chiamate ripetute.
Prerequisiti: liste e dizionari del modulo 1, condizioni e booleani delle lezioni 7–8.
Un elemento alla volta
letture_mv = [1.2, 1.5, 1.3]
for lettura in letture_mv:
    print(lettura, "mV")
Per ogni elemento della lista, Python associa il valore corrente al
nome lettura ed esegue il blocco indentato. Dopo l’ultimo
elemento il ciclo termina. Se la lista è vuota, il corpo non viene
eseguito. I valori qui sono sintetici: non sono misure e non hanno
un’incertezza assegnata.
Il nome dopo for è una variabile ordinaria: il suo
valore cambia a ogni iterazione. Evita di modificare la lunghezza della
lista mentre la attraversi, perché è facile saltare o ripetere elementi.
Se occorre trasformarla, prepara una nuova lista o usa una procedura
esplicita.
range e posizioni
range(4) genera gli interi 0, 1, 2 e 3: il limite finale
è escluso, come nello slicing. range(1, 4) produce 1, 2 e
3; range(0, 6, 2) produce 0, 2 e 4. Un ciclo può usare
questi valori senza costruire prima una lista completa:
for indice in range(3):
    print(indice)
Se ti servono solo i valori di una lista, iterare direttamente sugli
elementi è in genere più chiaro. Se ti servono posizione e valore
insieme, usa enumerate.
enumerate e unpacking
for posizione, lettura in enumerate(letture_mv, start=1):
    print(posizione, lettura)
enumerate fornisce coppie posizione–valore. Python
assegna i due elementi della coppia ai nomi posizione e
lettura: questo si chiama unpacking.
start=1 rende la numerazione più comoda da leggere, ma non
cambia gli indici della lista, che continuano a partire da zero. Se una
riga mostra posizione 1, il corrispondente indice Python è 0.
Un’altra forma di unpacking è x, y = (0.5, 1.5). Il
numero di nomi deve essere compatibile con il numero di valori;
altrimenti Python segnala un errore.
Il catalogo della Session
L’API pubblica CANONICAL_DATASET_API_v2 offre
list per ottenere gli identificativi dei Dataset della
Session e describe per leggere i metadati di un Dataset
identificato. Tramite il client Python si usa
gxtxt_api_call(api_id, operazione, argomenti):
list riceve una lista di argomenti vuota,
describe riceve l’identificativo in una lista.
Per la prova creiamo, se necessario, un Dataset chiamato
corso_python_serie_sintetica con
DATASET_PUBLICATION_API_v2/publish_series. I tempi sono
[0.0, 0.5, 1.0, 1.5] s e i segnali
[1.2, 1.5, 1.3, 1.6] mV. Sono valori sintetici scelti per
il corso, non misure sperimentali; non è stata assegnata un’incertezza.
La pubblicazione usa gli identificativi di variabile tempo
e segnale e metadati che dichiarano la natura
didattica.
Se l’identificativo è già nel catalogo, lo script non lo sovrascrive. Il controllo del nome da solo non dimostra che un Dataset preesistente contenga questi stessi dati: usa una Session dedicata al corso e, se esiste già un Dataset con quel nome ma diverso, scegline uno libero o controllane il contenuto prima di proseguire.
Codice completo
from gxtxt import gxtxt_api_call, gxtxt_api_require

gxtxt_api_require("CANONICAL_DATASET_API_v2@2")
gxtxt_api_require("DATASET_PUBLICATION_API_v2@2")
catalogo = gxtxt_api_call("CANONICAL_DATASET_API_v2", "list", [])
identificatore = "corso_python_serie_sintetica"
if identificatore not in catalogo:
    richiesta = {
        "dataset_id": identificatore, "contract": "table.generic", "storage": "csv",
        "x_values": [0.0, 0.5, 1.0, 1.5], "y_values": [1.2, 1.5, 1.3, 1.6],
        "x_variable": {"variable_id": "tempo", "name": "tempo", "unit": "s", "semantic_role": "time"},
        "y_variable": {"variable_id": "segnale", "name": "segnale", "unit": "mV"},
        "structured_metadata": {"experimental.sample": "serie sintetica didattica"},
    }
    gxtxt_api_call("DATASET_PUBLICATION_API_v2", "publish_series", [richiesta])
    catalogo = gxtxt_api_call("CANONICAL_DATASET_API_v2", "list", [])
print("Numero Dataset:", len(catalogo))
for posizione, dataset_id in enumerate(catalogo, start=1):
    descrizione = gxtxt_api_call("CANONICAL_DATASET_API_v2", "describe", [dataset_id])
    print(posizione, dataset_id, "campi:", list(descrizione.keys()))
Il dizionario richiesta descrive la serie e le sue
variabili. Dopo la pubblicazione ricarichiamo il catalogo. Il ciclo
visita ogni identificativo, chiede la descrizione e mostra le chiavi
disponibili; i campi e l’ordine dipendono dal contenuto e dalla versione
della Session.
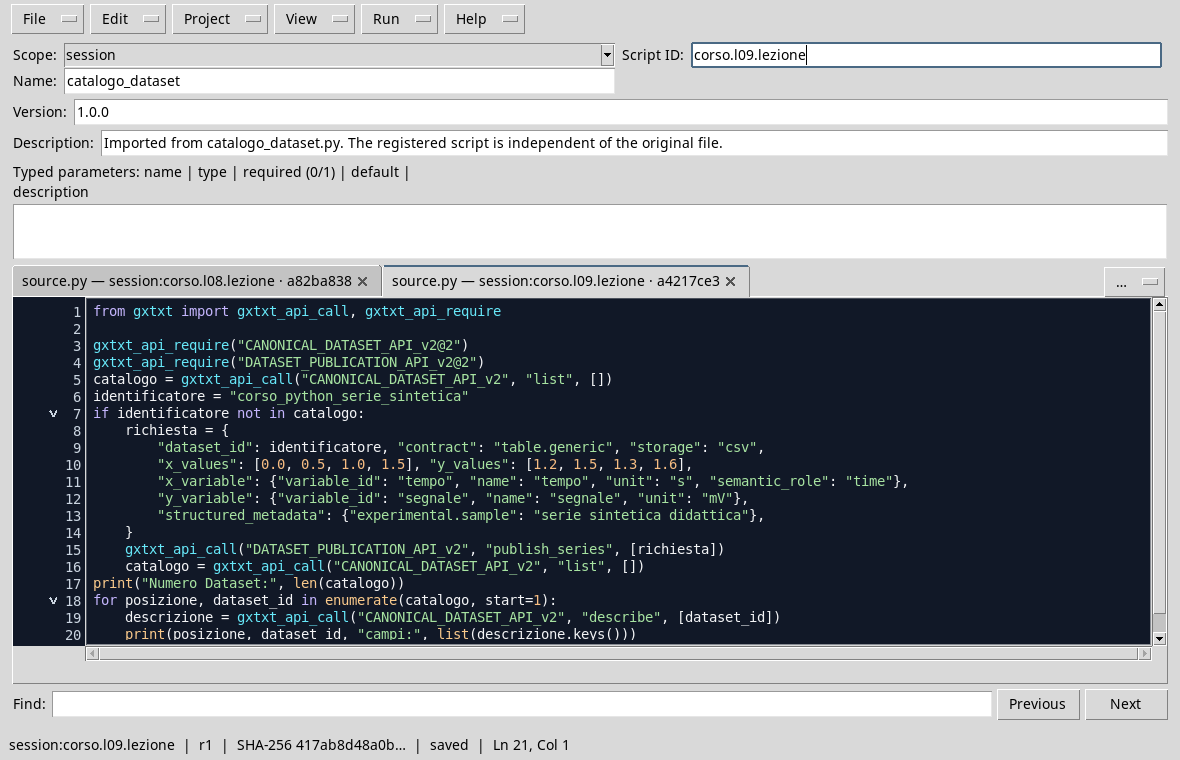
Lo script nel Viewer Python; il codice completo è disponibile nel file della lezione.
Esecuzione
- Apri una Session dedicata al corso e il Viewer Python Scripts.
- Importa
catalogo_dataset.py, assegna nome e Script ID nello scopesession, quindi salva. - Apri Run → Open Script Runner… e premi Run Job. La prima esecuzione pubblica la serie sintetica se l’identificativo non è presente.
- Leggi l’output e confronta il Dataset elencato con il catalogo della Session. Una Session può contenere più Dataset; la figura mostra un esempio con un solo elemento.
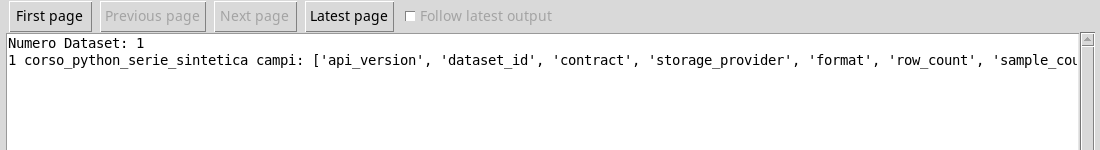
La Session di esempio contiene il Dataset sintetico del corso.
Attenzione al costo delle chiamate
Il ciclo effettua una chiamata describe per ogni
Dataset. Per un catalogo grande o remoto, ogni chiamata può richiedere
tempo: evita di richiedere ripetutamente gli stessi metadati se puoi
conservarli durante l’elaborazione. Non assumere che la posizione di un
Dataset nel catalogo sia stabile; usa il suo identificativo.
Esercizio
Data la lista sintetica tempi = [0.0, 0.5, 1.0], stampa
una numerazione a partire da 1 e il tempo in secondi. Cosa succede se la
lista è vuota?
Soluzione ragionata
tempi = [0.0, 0.5, 1.0]
for posizione, tempo in enumerate(tempi, start=1):
    print(posizione, tempo, "s")
Le righe sono numerate 1, 2 e 3; gli indici interni rimangono 0, 1 e 2. Con una lista vuota il corpo non viene eseguito e non viene stampata nessuna riga.
Nella prossima lezione leggeremo la serie per blocchi con un ciclo
while.