

Precisione, aggregazioni e statistiche di base
Corso Python scientifico in GX-TXT · Modulo 3 · Lezione 17
Una serie di numeri può essere riassunta con somma, media e dispersione. Questi numeri sono utili solo se sappiamo quali dati sono stati inclusi, quali convenzioni sono state usate e che cosa rappresentano. Confronteremo NumPy con le statistiche pubbliche di GX-TXT sulla serie sintetica già pubblicata.
Obiettivi: usare np.sum,
np.mean e np.std; distinguere popolazione e
campione con ddof; riconoscere valori non finiti e limiti
della precisione floating point; confrontare risultati con una
tolleranza motivata.
Prerequisiti: Dataset della lezione 9 e array delle lezioni 13–16.
Somma e media
Per i quattro segnali sintetici [1.2, 1.5, 1.3, 1.6] mV,
la somma è 5.6 mV e la media è \(\frac{5{,}6}{4}=1{,}4\)
mV. Il controllo a mano aiuta a interpretare l’output delle
funzioni:
import numpy as np
segnale = np.array([1.2, 1.5, 1.3, 1.6])
print(np.sum(segnale))
print(np.mean(segnale))
Questi dati sono scelti per l’esercizio, non sono misure sperimentali e non hanno incertezza assegnata. Una media non descrive da sola la dispersione né garantisce che le osservazioni siano indipendenti.
Deviazione standard e
ddof
La varianza misura la dispersione quadratica intorno alla media; la
deviazione standard è la sua radice quadrata e ha la stessa unità dei
dati. Per i quattro valori dell’esempio, la somma degli scarti
quadratici è 0.1 mV².
Con la convenzione di popolazione, dividiamo per
n = 4: la varianza è 0.025 mV² e la deviazione
standard è circa 0.1581 mV. Con la convenzione
campionaria, dividiamo per \(n-1=3\): la
varianza è circa 0.03333 mV² e la deviazione standard è
circa 0.1826 mV.
In NumPy, np.std(segnale, ddof=0) usa il divisore
n, mentre ddof=1 usa n − 1. Non
scegliere una convenzione solo perché produce il numero desiderato: la
scelta dipende dalla domanda e dalle ipotesi. Per
n <= ddof, il divisore non è positivo e il risultato non
è una stima valida; controlla la dimensione del campione.
Dati mancanti e non finiti
Un array può contenere NaN o infiniti.
np.mean e np.std possono propagare
NaN; funzioni come np.nanmean adottano una
politica diversa e ignorano i NaN. Ignorare valori mancanti
senza dichiararlo può alterare l’interpretazione. Conta i valori inclusi
ed esclusi, conserva l’informazione sulla loro origine e scegli la
politica in base al problema. Una maschera di celle mancanti fornita da
un Dataset non va automaticamente identificata con ogni NaN
esplicito.
La serie sintetica di questa lezione contiene quattro valori finiti. Le statistiche del provider riportano nell’esecuzione mostrata quattro valori validi e nessun valore non finito.
Precisione e confronto
Gli array float64 hanno precisione finita. Somme
effettuate in ordini differenti possono produrre piccoli scarti,
soprattutto con valori di scale molto diverse. Un confronto fra due
implementazioni dovrebbe usare una tolleranza assoluta e/o relativa
motivata dalla scala dei dati e dallo scopo;
np.isclose(a, b, rtol=..., atol=...) è uno strumento
possibile, ma i suoi parametri vanno scelti consapevolmente. La
tolleranza numerica non è automaticamente l’incertezza fisica.
Un controllo analitico, come la media di questa piccola serie calcolata a mano, aiuta a individuare un errore di unità o una convenzione diversa. Per lavori complessi, valuta anche stabilità numerica, dimensione e qualità del campione.
Statistiche pubbliche GX-TXT
Leggiamo quattro righe di segnale con
CANONICAL_DATASET_API_v2/read_range. Poi
NUMERIC_API_v1/dataset_statistics riceve l’identificativo
Dataset, l’identificativo di variabile e un dizionario di opzioni. Il
risultato strutturato include conteggi, somma, media e statistiche di
popolazione e campionarie; le unità riportate provengono dalla variabile
del Dataset.
Il Dataset della lezione 9 deve essere presente nella Session.
L’array letto è una colonna (4, 1) nell’esecuzione
mostrata: lo trasformiamo in vettore monodimensionale con
reshape(-1) perché sappiamo di avere una singola colonna.
Per dati multidimensionali occorre verificare gli assi prima di
appiattire.
Codice completo
import numpy as np
from gxtxt import gxtxt_api_call, gxtxt_api_require

gxtxt_api_require("NUMERIC_API_v1@1")
gxtxt_api_require("CANONICAL_DATASET_API_v2@2")
blocco = gxtxt_api_call("CANONICAL_DATASET_API_v2", "read_range", ["corso_python_serie_sintetica", ["segnale"], 0, 4])
segnale = np.asarray(blocco["segnale"]["values"]).reshape(-1)
print("Segnale sintetico (mV):", segnale)
print("Somma (mV):", np.sum(segnale))
print("Media (mV):", np.mean(segnale))
print("Deviazione standard popolazione (mV):", np.std(segnale, ddof=0))
print("Deviazione standard campionaria (mV):", np.std(segnale, ddof=1))
risultato = gxtxt_api_call("NUMERIC_API_v1", "dataset_statistics", ["corso_python_serie_sintetica", "segnale", {}])
print("Statistiche GX-TXT:", risultato)
Il confronto è valido qui perché entrambe le operazioni usano la stessa variabile e tutte e quattro le righe, senza valori non finiti. In un caso generale controlla che selezione, politica sui dati mancanti e convenzioni coincidano prima di confrontare le cifre.
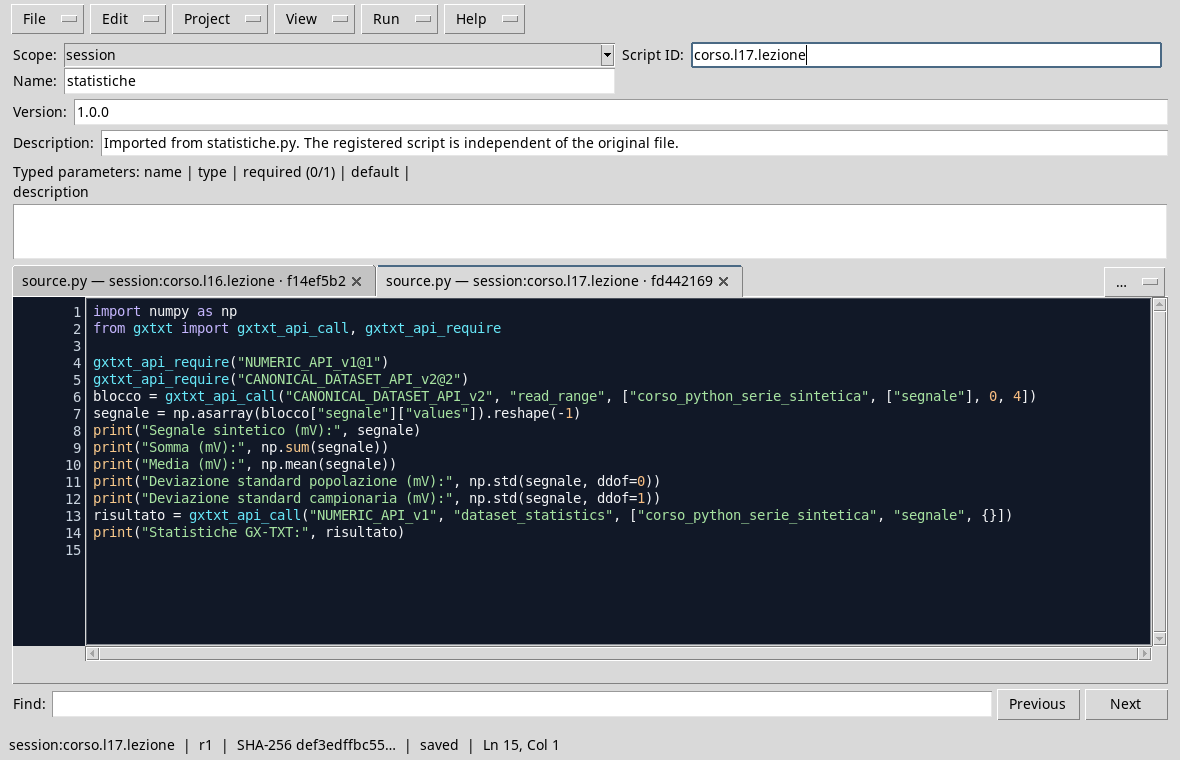
Lo script confronta aggregazioni NumPy con le statistiche del Dataset.
Esecuzione e controllo
- Apri la Session contenente
corso_python_serie_sinteticae il Viewer Python Scripts. - Importa
statistiche.py, assegna nome e Script ID nello scopesession, quindi salva. - Apri il Runner, premi Run Job e leggi l’output.
- Controlla somma
5.6, media1.4, deviazione standard di popolazione circa0.1581e campionaria circa0.1826mV. Nel risultato GX-TXT confronta i campisum,mean,std_populationestd_sample.
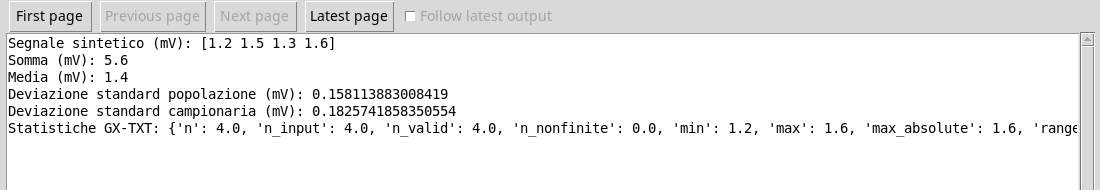
L’output mostra i risultati NumPy e il descrittore di statistiche GX-TXT.
Errore comune
Confrontare la deviazione standard di popolazione di un programma con quella campionaria di un altro e concludere che uno dei due è sbagliato può essere fuorviante. Prima verifica il divisore, i valori inclusi, le unità e il trattamento dei mancanti.
Esercizio
Per i valori sintetici [2.0, 4.0] mV calcola media e
deviazione standard di popolazione. Qual è invece la deviazione standard
campionaria?
Soluzione ragionata
La media è 3.0 mV. Gli scarti sono −1 e
1 mV: la varianza di popolazione è
\(\frac{1+1}{2}=1\,\mathrm{mV}^{2}\), quindi la deviazione standard è
1 mV. La varianza campionaria è
\(\frac{1+1}{1}=2\,\mathrm{mV}^{2}\), con deviazione standard
\(\sqrt{2}\approx1{,}414\,\mathrm{mV}\). Questi numeri descrivono l’esempio, non
un’incertezza sperimentale completa.
Nella prossima lezione scriveremo un file di output gestito e lo pubblicheremo con le API previste.