

Pathlib, context manager e output gestito
Corso Python scientifico in GX-TXT · Modulo 3 · Lezione 18
Uno script può produrre un file, ma in GX-TXT deve usare i percorsi e le operazioni pubbliche previste per conservarlo nella Session. Creeremo un piccolo CSV sintetico nella directory di output assegnata al lavoro e lo pubblicheremo come documento testuale.
Obiettivi: costruire percorsi con
pathlib.Path; aprire e chiudere file con with;
scrivere CSV UTF-8; distinguere un file pubblicato da un Dataset
tabellare con variabili scientifiche.
Prerequisiti: funzioni, dizionari, eccezioni e Dataset delle lezioni precedenti.
Percorsi con pathlib
Path rappresenta un percorso in modo indipendente dalla
sintassi usata dal sistema operativo. L’operatore / combina
una directory e un nome:
from pathlib import Path
cartella = Path("risultati")
file_csv = cartella / "serie.csv"
Questo costruisce un oggetto percorso; non crea automaticamente la
directory né il file. Nel Runner GX-TXT usiamo
Path(gxtxt_context()["output_dir"]) per ottenere la
directory assegnata all’esecuzione. Non scriviamo direttamente negli
archivi interni della Session o del framework.
Aprire un file con
with
with file_csv.open("w", encoding="utf-8", newline="") as file:
    file.write("tempo_s,segnale_mV\n")
"w" apre il file in scrittura e può sovrascrivere un
file esistente allo stesso percorso: scegli un nome appropriato nella
directory assegnata. encoding="utf-8" specifica la codifica
del testo. Il blocco with usa un context
manager: quando il blocco termina, anche per molte eccezioni,
il file viene chiuso correttamente. Una chiusura ordinata è importante
prima di chiedere a GX-TXT di pubblicare il file completo.
Le operazioni di I/O possono fallire, per esempio per permessi o spazio insufficiente. Un programma deve mostrare o gestire l’errore in modo appropriato; non deve pubblicare come completo un file scritto solo in parte.
Scrivere CSV
Un CSV rappresenta righe di campi testuali separati da un
delimitatore. Il modulo standard csv gestisce correttamente
delimitatori e virgolette nei campi. Con newline=""
lasciamo al modulo la gestione delle terminazioni di riga:
import csv
with file_csv.open("w", encoding="utf-8", newline="") as file:
    writer = csv.writer(file)
    writer.writerow(["tempo_s", "segnale_mV"])
    writer.writerow([0.0, 1.2])
Le intestazioni documentano le unità scelte. I valori dell’esempio sono sintetici: non sono misure sperimentali e non è assegnata un’incertezza. In un progetto reale descrivi anche provenienza, unità, incertezza e convenzioni di formattazione.
Pubblicare il file nella Session
DATASET_FILE_PUBLICATION_API_v1/publish accetta una
richiesta con identificativo, contratto, formato, file sorgente, tipo di
memorizzazione e media type. La sorgente deve essere un file completo
sotto la directory di output gestita. Il provider pubblica una copia
nella Session e restituisce informazioni sul risultato; lo script non
deve modificare direttamente registri o percorsi interni.
Il contratto document.text usato qui pubblica il CSV
come documento testuale. Le intestazioni descrivono il
contenuto, ma questo percorso non crea automaticamente variabili
scientifiche canoniche con schema e unità. Per creare una serie con
variabili GX-TXT, usa invece il percorso schema-first
DATASET_PUBLICATION_API_v2 visto nella lezione 9.
L’esempio richiede replace_owned=True per consentire una
nuova esecuzione sullo stesso identificativo soltanto se la sostituzione
è autorizzata dalle regole del provider per quel produttore. Non usare
questo parametro per sovrascrivere dati altrui; se l’identificativo
esiste con un’altra proprietà, scegli un identificativo libero.
Codice completo
import csv
from pathlib import Path
from gxtxt import gxtxt_context, gxtxt_api_call, gxtxt_api_require

gxtxt_api_require("DATASET_FILE_PUBLICATION_API_v1@1")
output_dir = Path(gxtxt_context()["output_dir"])
file_csv = output_dir / "serie_sintetica.csv"
with file_csv.open("w", encoding="utf-8", newline="") as file:
    writer = csv.writer(file)
    writer.writerow(["tempo_s", "segnale_mV"])
    writer.writerows([[0.0, 1.2], [0.5, 1.5], [1.0, 1.3], [1.5, 1.6]])
richiesta = {
    "dataset_id": "corso_python_file_sintetico", "contract": "document.text",
    "format": "csv", "source_file": str(file_csv), "storage_kind": "text",
    "media_type": "text/csv", "replace_owned": True,
    "provenance": "Serie sintetica didattica, non misure sperimentali",
}
risultato = gxtxt_api_call("DATASET_FILE_PUBLICATION_API_v1", "publish", [richiesta])
print("File sintetico scritto:", file_csv.name)
print("Dataset pubblicato:", risultato)
writerows scrive quattro righe dopo l’intestazione. La
chiamata a publish avviene dopo il blocco
with, quando il file è stato chiuso. Il dizionario di
risultato descrive l’oggetto pubblicato; i campi effettivi dipendono
dalla versione dell’API.
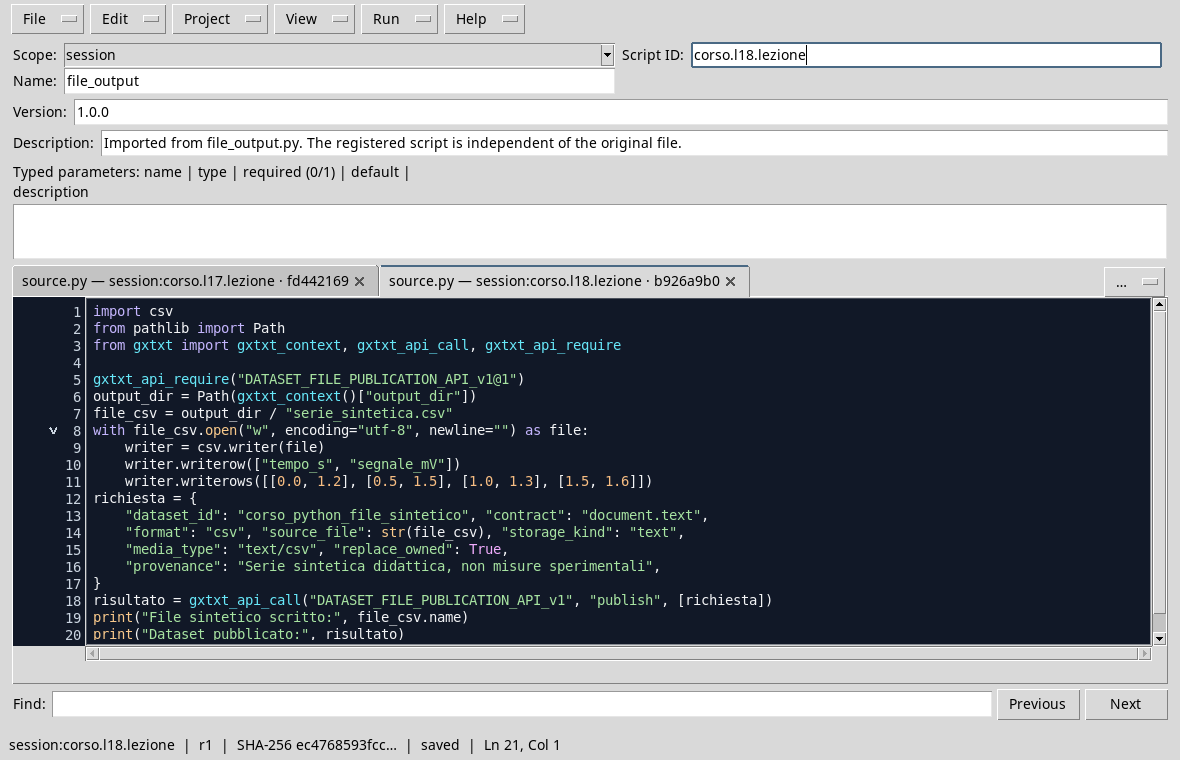
Il file viene scritto nell’output gestito e pubblicato con l’API pubblica.
Esecuzione e controllo
- Apri una Session dedicata e il Viewer Python Scripts.
- Importa
file_output.py, assegna nome e Script ID nello scopesessione salva. - Apri il Runner, premi Run Job e controlla che l’esecuzione termini correttamente.
- Nell’output cerca
serie_sintetica.csve l’identificativocorso_python_file_sintetico. Apri il documento dal catalogo della Session e verifica intestazione e quattro righe. La figura mostra la risposta della pubblicazione.
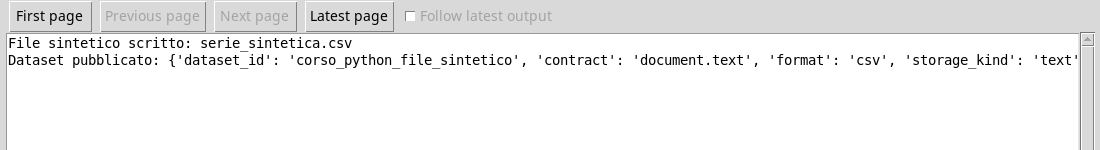
Il risultato riporta l’identificativo del documento pubblicato.
Errore comune
Costruire un percorso con Path non concede
automaticamente il permesso di scrivere ovunque. Pubblicare un file
esterno alla directory di output assegnata può essere rifiutato; non
aggirare questo vincolo scrivendo nei registri della Session. Un file
presente nella directory di output non è necessariamente già pubblicato:
la pubblicazione è un’operazione distinta.
Esercizio
Aggiungi una riga sintetica con tempo 2.0 s e segnale
1.4 mV. Quali punti devi controllare prima di
ripubblicare?
Soluzione ragionata
Aggiungi [2.0, 1.4] alla lista passata a
writerows, salva lo script e rieseguilo nel Runner.
Controlla che il file sia chiuso prima di publish, che
l’identificativo sia disponibile o sostituibile secondo le regole del
provider e che il documento pubblicato contenga intestazione e cinque
righe. La nuova riga è sintetica, non una misura.
Il prossimo modulo approfondisce Dataset canonici, variabili e metadati.