

Test di ipotesi
Confrontare una media, due campioni o coppie
Scegli analysis.statistics.tests. Per la prova iniziale imposta Group comparison method su one_sample_t e First numeric sample su voltage. Lascia vuoto il secondo campione. Imposta Null mean or mean difference (t-tests) a 10, alternativa two_sided, confidenza 0.95 e ID guide.tests.baseline. Tutti i numeri della prova si riferiscono alla tabella sintetica.
L’ID di uscita iniziale del provider è statistics.tests.result. L’esercizio usa un nome dedicato.
Configurazione nella GUI
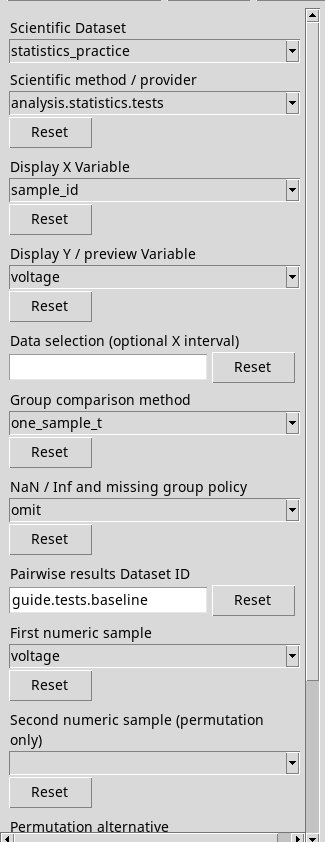
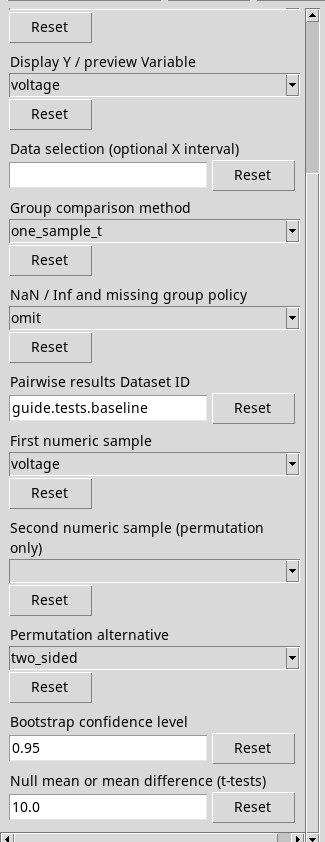
Scegliere il test in base al disegno
- one_sample_t
- Confronta la media della prima colonna con μ0. Il modello t classico richiede misure indipendenti e campionamento gaussiano.
- independent_t
- Confronta le medie di campioni indipendenti con varianza comune. Il denominatore usa una stima aggregata della varianza. Le posizioni di riga delle due colonne possono avere significati indipendenti.
- welch_t
- Confronta medie indipendenti con varianze potenzialmente diverse. Gradi di libertà e inferenza sono approssimati. Il rapporto lascia indefinito l’effetto standardizzato previsto per altri t-test.
- paired_t
- Calcola un t-test sulle differenze prima − seconda riga per riga. Verifica che le misure siano realmente abbinate e che le differenze siano indipendenti fra coppie. La condizione gaussiana riguarda le differenze.
- mann_whitney
- Confronta i ranghi dei due campioni indipendenti. Un’interpretazione come differenza di posizione richiede ipotesi sulla forma delle distribuzioni. Una differenza di ranghi può riflettere anche una differenza di forma.
- signed_rank
- Usa rango e segno delle differenze appaiate. L’interpretazione come test di posizione richiede simmetria delle differenze. Le differenze nulle sono escluse dalla componente di rango con segno.
Per ogni metodo a due campioni seleziona la seconda colonna in Second numeric sample (permutation only), anche quando l’etichetta riporta «permutation only». Usa response per esercitarti. Questa coppia di colonne è misurata sulla stessa riga. Gli esempi con test indipendenti servono a osservare il comportamento del comando in una prova sintetica, mentre l’esempio appaiato rispecchia la relazione per riga. Le unità devono essere compatibili e la seconda colonna viene convertita nell’unità della prima.
Scelte di altri provider. Il menu condiviso può mostrare anche bootstrap, iqr, mad, ordinary, permutation_independent, permutation_paired, welch. Ognuna viene rifiutata prima di avviare questo metodo. Riprendi una delle scelte descritte qui e premi di nuovo Run selected method.
Direzione, confidenza e riferimento nullo
- Permutation alternative
- L’etichetta è condivisa. Qui
two_sided(iniziale) considera entrambe le direzioni.greaterguarda verso valori maggiori elessverso valori minori della media o differenza di riferimento, oppure nella corrispondente direzione dei ranghi. Scegli la direzione prima di leggere il risultato. - Bootstrap confidence level
- Nel metodo di questo capitolo è il livello per l’intervallo dei t-test. Usa un numero strettamente fra 0 e 1, per esempio
0.95o0.90. L’intervallo a una coda ha un estremo infinito. L’intervallo di shift per i test sui ranghi è indisponibile. - Null mean or mean difference (t-tests)
- Il valore iniziale è 0. Indica la media di riferimento nel caso a un campione e la differenza prima − seconda di riferimento negli altri t-test. Si esprime nell’unità della prima variabile. Reimposta a zero per i test sui ranghi.
Leggere stima, evidenza e precisione
In tests_report.txt trovi stima 13 V, t ≈ 3,332, 17 gradi di libertà, p ≈ 0,00394 e intervallo bilaterale al 95% da 11,101 a 14,899 V. Il p-value quantifica quanto sarebbe insolito un esito almeno così estremo assumendo l’ipotesi nulla e il modello di test. L’intervallo riguarda la precisione secondo il procedimento campionario. L’effetto, qui Cohen d ≈ 0,785, esprime lo scarto su scala standardizzata.
La tabella contiene metodo, numerosità iniziali e valide, stima, statistiche, alternativa, intervallo, effetto e approssimazione. Nei test sui ranghi l’effetto è la correlazione rango-biseriale. Fino a 20 osservazioni pertinenti il calcolo usa distribuzioni condizionali esatte. Per dimensioni maggiori usa un’approssimazione normale corretta per ranghi a pari merito e continuità. Varianza o differenze costanti possono lasciare indefiniti inferenza e intervallo pur consentendo la stima puntuale.
Risultato nella GUI
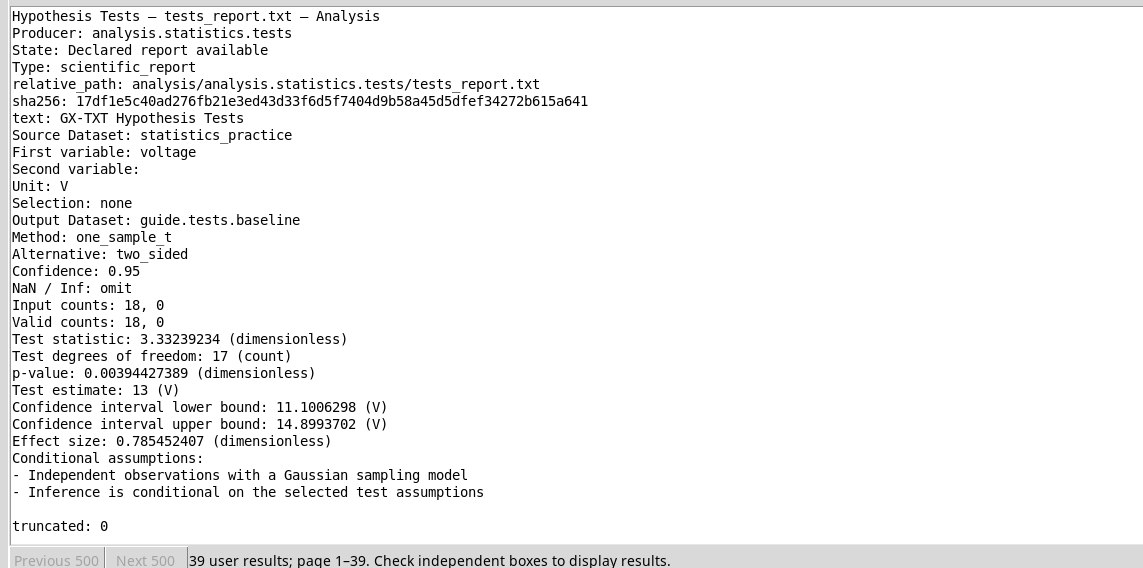
Per ID di uscita, selezione e criteri di pubblicazione consulta Opzioni condivise dei provider. Per consultare o aprire il risultato vai a Tabelle, rapporti e grafici.