

Bootstrap e permutazioni
Stimare con bootstrap o permutazioni
Scegli analysis.statistics.resampling. Per la prima prova imposta Group comparison method a bootstrap, First numeric sample a voltage, statistica mean, confidenza 0.95, Replicates / permutations a 400 e seme 31. Usa il prefisso guide.resampling.baseline.
Il prefisso di uscita iniziale del provider è statistics.resampling. L’esercizio usa un nome dedicato.
Configurazione nella GUI
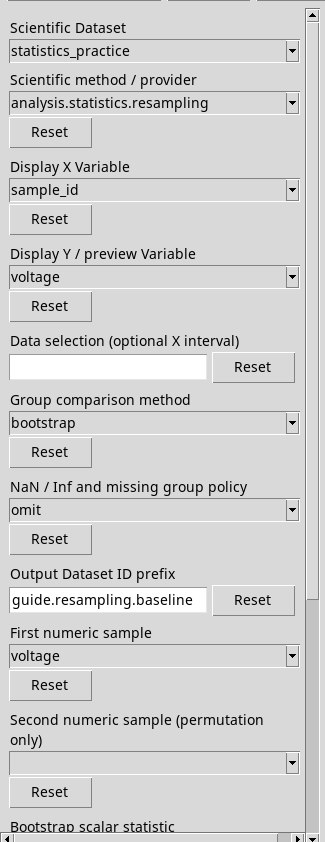
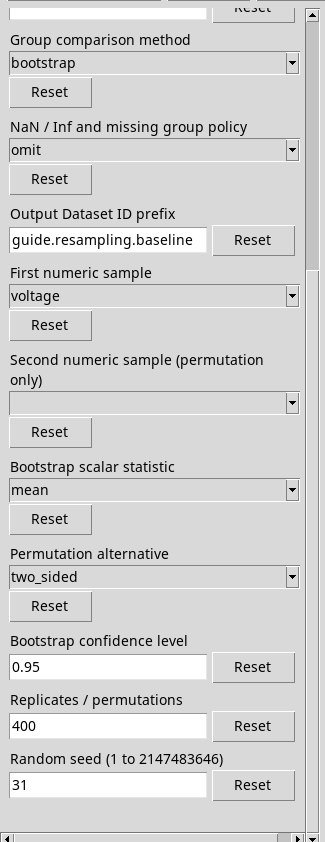
Che cosa viene ricampionato
- bootstrap
- Scelta iniziale. Estrae con ripetizione dal primo campione finito e richiede almeno due valori. Bootstrap scalar statistic sceglie
mean,medianosample_sdper media, mediana o deviazione standard campionaria. Bootstrap confidence level imposta la frazione centrale della distribuzione empirica, inizialmente 0,95. L’intervallo percentile ha due code. - permutation_independent
- Rimescola le etichette dei due campioni per costruire, sotto scambiabilità, la distribuzione della differenza tra le medie. Seleziona la seconda colonna di misure in Second numeric sample (permutation only). Con
omitrimuove valori non finiti da ciascun campione separatamente. - permutation_paired
- Ribalta il segno delle differenze prima − seconda entro coppia. Usa righe valide in entrambe le colonne e richiede scambiabilità dei segni sotto l’ipotesi nulla. Per un esercizio sulla relazione appaiata usa
voltageeresponse. La seconda variabile deve essere convertibile nell’unità della prima. - Permutation alternative
two_sided(iniziale) confronta la magnitudine assoluta.greaterconta una coda verso differenze maggiori elessl’altra. Conta sempre dalla prospettiva della prima colonna meno la seconda. Il selettore riguarda le permutazioni.
Scelte di altri provider. Il menu condiviso può mostrare anche independent_t, iqr, mad, mann_whitney, one_sample_t, ordinary, paired_t, signed_rank, welch, welch_t. Ognuna viene rifiutata prima di avviare questo metodo. Riprendi una delle scelte descritte qui e premi di nuovo Run selected method.
Budget, seme e stabilità
- Replicates / permutations
- Intero positivo, inizialmente 1.000. Il metodo ammette al massimo 100.000 repliche e un budget di 10 milioni di indici generati. Più repliche migliorano la risoluzione empirica e richiedono più tempo. La minima probabilità Monte Carlo restituita è 1/(B+1).
- Random seed (1 to 2147483646)
- Inserisci un intero nell’intervallo indicato. Il valore iniziale è 1. Usa lo stesso seme, righe, ordine, statistica e numero di repliche per riprodurre la distribuzione.
Interpretare i Dataset pubblicati
.distribution conserva ogni replica. .summary conserva conteggi, stima, configurazione e inferenza disponibile. La prova bootstrap dà media osservata 13 V, intervallo da 11,443 a 14,668 V ed errore standard bootstrap circa 0,904 V. L’intervallo è un’approssimazione della copertura campionaria e presuppone osservazioni indipendenti e identicamente distribuite.
Con le permutazioni leggi differenza in V, numero di repliche estreme (e), direzione e p = (e + 1)/(B + 1). Con 400 permutazioni anche zero repliche estreme dà un p-value Monte Carlo di circa 0,00249. La validità dell’inferenza dipende dallo schema di permutazione compatibile con il disegno. Confidenza, stima e p-value sono esposti con la rispettiva disponibilità in resampling_report.txt.
Risultato nella GUI
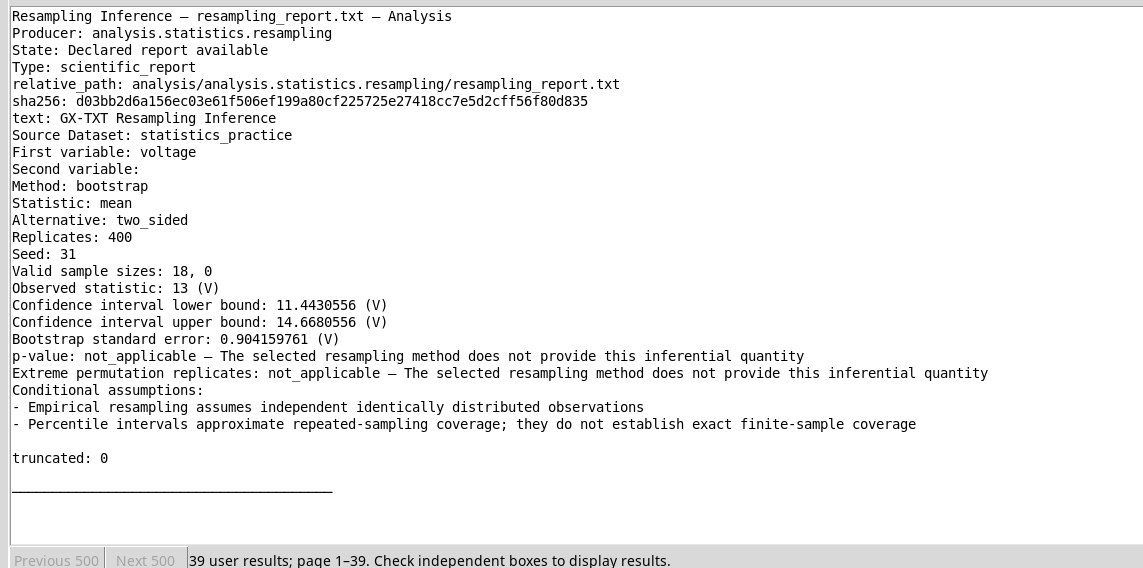
Per ID di uscita, selezione e criteri di pubblicazione consulta Opzioni condivise dei provider. Per consultare o aprire il risultato vai a Tabelle, rapporti e grafici.