GX-TXT Python Script Workspace: dai log ai Dataset scientifici canonici
Il risultato di un Job Python non diventa automaticamente un Dataset scientifico di GX-TXT. È possibile pubblicare il testo di stdout come documento canonico, oppure utilizzare le API pubbliche di pubblicazione per registrare variabili numeriche con tipo, dimensioni e unità. Sono due operazioni diverse: la prima conserva fedelmente un file di testo; la seconda crea uno schema scientifico verificabile. Questa guida mostra entrambe le strade attraverso le funzioni originali di GX-TXT.
1. Perché pubblicare un risultato
Quando un programma stampa un valore sullo schermo, quel valore appartiene anzitutto al log dell’esecuzione. Il supervisore ne conserva il contenuto, ma altri moduli scientifici non devono interpretare ogni riga di console come una misura. La pubblicazione canonica rende invece un risultato riconoscibile dal Registry e dal Catalogo della Session, con una propria identità, un contratto e una provenienza. L’operazione deve essere esplicita e deve riferirsi a dati realmente disponibili.
2. Due contratti da non confondere
Nel nostro esempio vengono creati due Dataset:
| Caratteristica | Documento da stdout | Risultato numerico |
|---|---|---|
| Contratto | document.text | table.generic |
| Formato | txt, UTF-8 | csv |
| Contenuto | Righe del programma | Variabile numerica mean_c |
| Schema tipizzato | Nessuna colonna numerica | float64, 1 riga |
| Unità scientifica | Non definita | degC |
| Origine | Stream del Job completato | Commit dell’API pubblica dello Script |
La differenza è semantica, non semplicemente l’estensione del file: anche un Dataset numerico tipizzato può usare un file CSV, che fisicamente è testo.
3. Aprire lo stdout di un Job completato
Nel Script Jobs Manager, selezionare un Job Python concluso e scegliere Open execution details. Verificare la sua identità, la revisione e la validazione dello snapshot. Nel selettore degli stream scegliere Program output, quindi utilizzare Publish source as Dataset…. Non scegliere stderr o Diagnostic log se l’obiettivo è conservare precisamente il normale stdout.

4. Il file sorgente della pubblicazione testuale
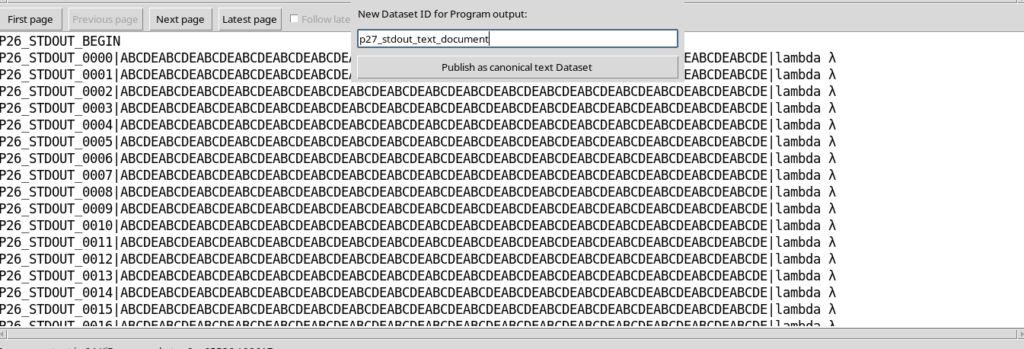
Nel riquadro del log sono presenti le righe che Python ha scritto su stdout. Per una prova riproducibile abbiamo usato soltanto messaggi sintetici numerati. Il testo non è stato ricostruito copiando il pannello: la pubblicazione usa lo stream completo conservato dal Job, anche se la vista mostra una sola pagina da 64 KiB. Una selezione manuale, al contrario, potrebbe trasferire soltanto la parte visibile.
5. L’identità di un nuovo Dataset
Un Dataset deve avere un Dataset ID nuovo, valido e non già registrato nella Session. È opportuno scegliere un identificativo leggibile e stabile, per esempio stdout_document_demo. Il nome visualizzato nell’interfaccia può essere diverso dall’ID; per riconoscere con precisione la provenienza conta l’identità registrata, non un titolo generico come Risultati. Non si deve sostituire automaticamente un Dataset esistente per recuperare spazio.
6. Confermare la pubblicazione del documento
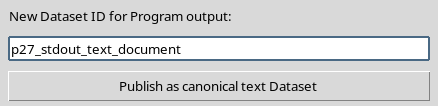
Il dialogo Publish the selected execution source presenta il campo New Dataset ID e il pulsante Publish as canonical text Dataset. Nell’esempio l’ID registrato è p27_stdout_text_document. La pressione del pulsante è un’operazione di pubblicazione effettiva: non è un semplice salvataggio del pannello e non avvia un nuovo Job Python.
7. Leggere la conferma della GUI
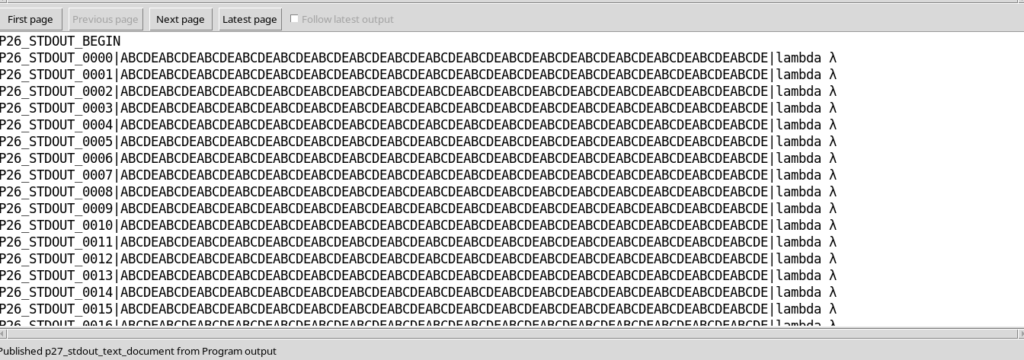
Al termine, Execution details comunica che il Dataset è stato pubblicato da Program output. Questa conferma indica l’avvenuto commit del documento nella Session corrente. Non basta però fermarsi al messaggio: la verifica completa richiede anche l’esistenza nel Catalogo, il file canonico, il suo contenuto e il corrispondente SHA-256.
8. Il contratto document.text
Il documento pubblicato ha contratto document.text, storage text, formato txt e media type text/plain. Non è una tabella numerica: non possiede colonne scientifiche float64, una variabile mean_c o un’unità di temperatura. Le righe presenti nel documento possono contenere numeri come parte del linguaggio naturale o di un log, ma GX-TXT non deve trasformarle implicitamente in misure.
9. Verificare il testo byte per byte
Per il documento dell’esempio, lo stdout originale occupa 98.617 byte. Il file canonico appena creato ha esattamente la stessa dimensione e lo stesso SHA-256. Conserva inoltre il marcatore iniziale e finale dello stream, compresi i caratteri UTF-8. Questo controllo dimostra che il contenuto è stato pubblicato per intero, non soltanto copiato dalla prima o dall’ultima pagina del log.
10. Provenienza del Dataset testuale
Il metadato canonico registra il Job di origine, il ruolo stdout, lo SHA-256 dello Script eseguito, lo SHA-256 dello stream e l’indicazione che il contenuto è completo. Il produttore risulta analysis.python_script, nel relativo namespace di modulo. La provenienza serve a risalire dall’artefatto al calcolo senza affidarsi a percorsi assoluti di una particolare macchina.
11. Tentare di riutilizzare lo stesso ID
La pubblicazione è normalmente create-only. Se si ripropone un Dataset ID già utilizzato, GX-TXT rifiuta la richiesta; il documento originale, il suo SHA-256 e la sua revisione rimangono invariati. Questa protezione è importante quando più esecuzioni producono log con nomi simili: una nuova pubblicazione deve avere una nuova identità, oppure passare attraverso una sostituzione esplicitamente autorizzata e compatibile.
12. Passare a un risultato numerico
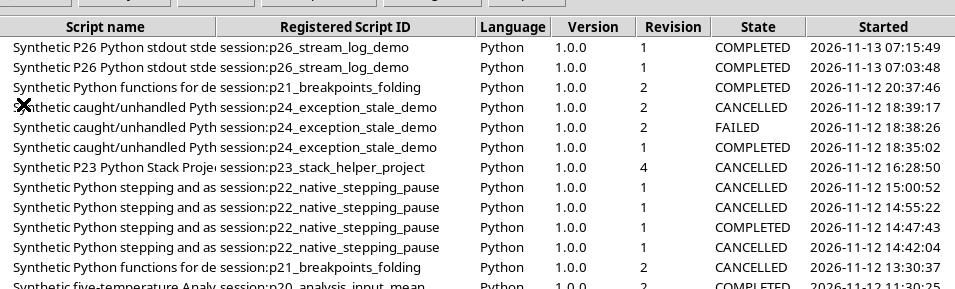
Per pubblicare una grandezza calcolata, non basta trasformare il documento di stdout in un file CSV. È necessario dichiarare variabili, tipi, dimensioni e unità. Apriamo una precedente esecuzione Python che calcolava la media di cinque temperature sintetiche. Dal Script Jobs Manager possiamo selezionarla e preparare Rerun selected…, mantenendo intatto lo storico.
13. Non sovrascrivere il Dataset precedente
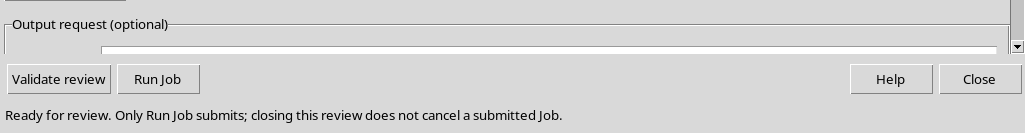
Il Runner propone inizialmente la richiesta di output della vecchia esecuzione. Ma quel Dataset può già esistere. Se Replace owned output non è stato selezionato, Validate review deve rifiutare l’identificativo duplicato e chiedere un nuovo ID. Questo evita di modificare involontariamente il risultato storico. Nell’esempio scegliamo un nuovo ID per la media numerica.
14. Il nuovo Output request
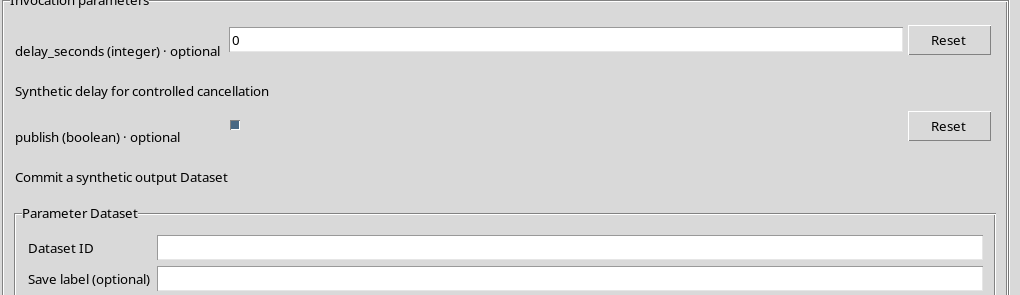
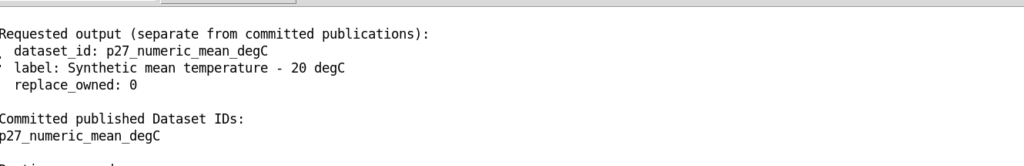
Il Runner distingue il Dataset ID richiesto, l’etichetta descrittiva, l’eventuale sostituzione autorizzata e i parametri di invocazione. Per questa prova l’ID è p27_numeric_mean_degC, il valore di publish è vero e Replace owned output resta disabilitato. La richiesta identifica dove l’utente vuole pubblicare; il vero commit sarà effettuato dal codice Python mediante l’API pubblica.
15. Il parametro publish non è il commit
Lo Script registrato dichiara un parametro booleano che decide se eseguire il ramo di pubblicazione:
from gxtxt import gxtxt_parameter_declare, gxtxt_context

gxtxt_parameter_declare(
    "publish", "boolean", default=False,
    description="Commit a synthetic output Dataset"
)

ctx = gxtxt_context()
should_publish = ctx["parameters"]["publish"]
Se il parametro rimane falso, il programma può calcolare e stampare valori senza pubblicare alcun Dataset. Quando è vero, il codice deve comunque effettuare correttamente l’operazione di commit.
16. Validate review prima del nuovo Job
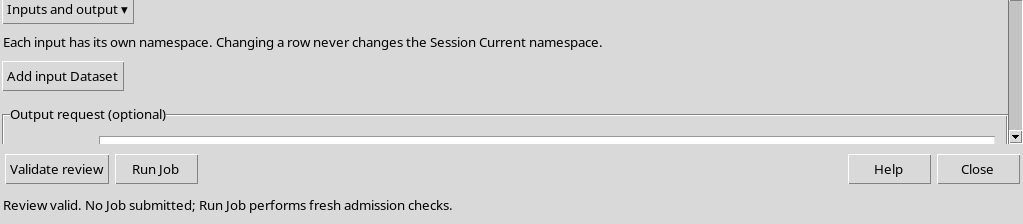
Prima di eseguire, verificare il nuovo Output Dataset ID, l’assenza di input non desiderati, il parametro di pubblicazione e lo SHA-256 dello Script corrente. Premere Validate review: un risultato positivo conferma che la richiesta è coerente, ma non crea un Job e non pubblica ancora il Dataset. Nel percorso Rerun selected… è necessaria anche la conferma esplicita I reviewed this invocation prima di Run Job.
17. Il ruolo del client pubblico Python
Lo Script usa il client documentato gxtxt, e non scrive direttamente nel Registry:
from gxtxt import gxtxt_context, gxtxt_api_call, gxtxt_api_require

ctx = gxtxt_context()
output_id = ctx["output"]["dataset_id"]

gxtxt_api_require("DATASET_PUBLICATION_API_v2@2")
gxtxt_context() legge il contesto dell’invocazione, inclusi parametri e output richiesto. gxtxt_api_require() verifica che il contratto pubblico sia disponibile nella versione richiesta. gxtxt_api_call() invia poi le operazioni al servizio autorizzato.
18. begin e la dichiarazione dello schema
Il primo passaggio di scrittura è begin, con contratto e modalità di conservazione. Nell’esempio:
definition = {
    "dataset_id": output_id,
    "contract": "table.generic",
    "storage": "csv",
    "producer_version": "1.0.0",
    "source": "Five synthetic values only",
    "provenance": "Synthetic arithmetic mean",
}
writer = gxtxt_api_call("DATASET_PUBLICATION_API_v2", "begin", [definition])
Il contratto table.generic indica che la pubblicazione contiene una tabella canonica. L’estensione CSV non sostituisce il contratto, la descrizione delle variabili o l’unità scientifica.
19. declare_dimension, declare_variable, append e finalize
Dopo begin, si definisce una dimensione row estendibile e una variabile mean_c, di tipo float64, rango 1, unità degC, ruolo derived. Il codice esegue poi append con un unico valore numerico, 20,0. finalize effettua il commit canonico e restituisce una ricevuta. In caso di errore prima del commit, lo Script deve chiamare abort sul writer ancora aperto.
writer = gxtxt_api_call("DATASET_PUBLICATION_API_v2", "begin", [definition])
try:
    gxtxt_api_call("DATASET_PUBLICATION_API_v2", "declare_dimension",
                   [writer, "row", 0, {"extendible": 1}])
    gxtxt_api_call("DATASET_PUBLICATION_API_v2", "declare_variable",
                   [writer, "mean_c", {
                       "name": "Synthetic temperature mean",
                       "dtype": "float64",
                       "rank": 1,
                       "dimension_ids": "row",
                       "unit": "degC",
                       "coordinate_role": "data",
                       "semantic_role": "derived",
                   }])
    gxtxt_api_call("DATASET_PUBLICATION_API_v2", "append",
                   [writer, "row", {"mean_c": [20.0]}])
    receipt = gxtxt_api_call("DATASET_PUBLICATION_API_v2", "finalize", [writer])
    writer = None
except Exception:
    if writer is not None:
        gxtxt_api_call("DATASET_PUBLICATION_API_v2", "abort", [writer])
    raise
Il valore di esempio deve essere calcolato dal proprio programma quando si applica questo schema a dati reali.
20. Output richiesto e Dataset effettivamente pubblicato
Il nuovo Job termina COMPLETED e i suoi Execution details mostrano due sezioni diverse: Requested output (separate from committed publications) e Committed published Dataset IDs. Nell’esempio entrambe si riferiscono al nuovo ID numerico, ma con ruoli differenti. Il primo è il desiderio espresso dal Runner; il secondo è la prova del commit effettivamente riconosciuto dal supervisore.
21. Lo stdout del Job numerico
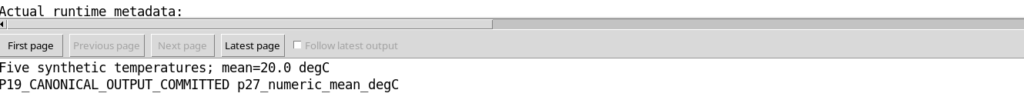
Il programma scrive sul normale stdout la media calcolata e, dopo finalize, un messaggio che riporta il Dataset ID pubblicato. Questo testo facilita la lettura del rapporto, ma non sostituisce la ricevuta del Dataset. L’identificativo confermato da GX-TXT è quello presente nel registro delle pubblicazioni del Job e nel Catalogo canonico.
22. Leggere il valore tramite CANONICAL_DATASET_API_v2
Il risultato numerico è stato riletto dal Catalogo mediante CANONICAL_DATASET_API_v2, non estratto dal messaggio di console. La lettura ha verificato una riga, una variabile mean_c di tipo float64, forma 1, unità degC e valore 20,0. È la media dei cinque valori sintetici 18, 20, 22, 21 e 19 °C. Il controllo ha verificato anche lo SHA-256 del file canonico.
23. Il Job storico rimane invariato
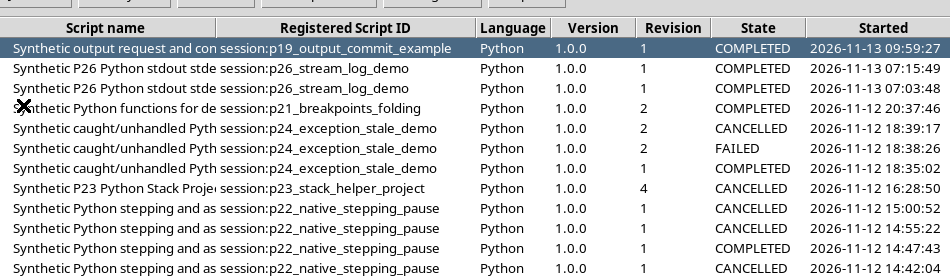
Una riesecuzione genera un nuovo Job ID. La precedente esecuzione conserva il proprio snapshot, lo stato e il suo Dataset pubblicato. Nella cronologia della Session compaiono quindi due Job distinti, e il nuovo non sostituisce il vecchio. Questa separazione permette di confrontare invocazioni effettuate in momenti diversi senza confondere i risultati con l’identità del codice.
24. Un documento .txt e una tabella .csv non sono lo stesso dato
In GX-TXT, il documento document.text contiene il testo UTF-8 dello stream completo, senza variabili scientifiche. La tabella table.generic ha invece uno schema che identifica mean_c come variabile numerica, con tipo, rango, dimensione e unità. Entrambi possono risiedere fisicamente in file testuali: per stabilire come usarli scientificamente bisogna leggere il contratto canonico e lo schema, non soltanto il campo storage_kind.
25. Perché unità e provenienza sono indispensabili
Il numero 20.0 privo di contesto potrebbe essere una tensione, una concentrazione o una temperatura. La dichiarazione unit="degC" rende invece esplicita l’unità del dato. La provenienza identifica il produttore analysis.python_script, la revisione del codice e il Job che ha impegnato il risultato. I valori di questa guida sono sintetici: non rappresentano misure strumentali né includono una stima d’incertezza.
26. Le pubblicazioni non sono Job aggiuntivi
Pubblicare lo stream di un Job già terminato non crea una nuova esecuzione Python dell’utente. Il Dataset testuale è ottenuto dal file precedentemente conservato. La tabella numerica è invece prodotta dal commit effettuato durante un nuovo Job Python. GX-TXT può avviare separatamente servizi CORE per preparare anteprime dei nuovi Dataset: tali servizi non devono essere confusi con i Job scientifici richiesti dall’utente.
27. Verifiche consigliate prima di riutilizzare un Dataset
Prima di impiegare un risultato in un altro modulo GX-TXT, verificare che il Dataset sia presente nel Catalogo della Session corretta, che il contratto corrisponda all’uso previsto, che siano disponibili le variabili e le unità attese, che la lettura canonica restituisca i valori corretti e che lo SHA-256 concordi con il file registrato. Se la pubblicazione non compare fra gli ID commessi, un messaggio di console o lo stato COMPLETED non bastano a garantirne l’esistenza.
28. Tornare al normale Python Script Workspace
Al termine chiudere i pannelli di esecuzione e ritornare all’editor High Contrast Dark, con il sorgente precedente pulito. I due Dataset pubblicati rimangono nel Catalogo della Session, ognuno con la propria identità e il proprio contratto. Il risultato testuale serve a conservare una traccia; quello numerico consente elaborazioni scientifiche tipizzate. La guida successiva approfondisce il ciclo di vita della Session, la riapertura dei sorgenti e la consultazione dei Job storici.