GX-TXT Python Script Workspace: configurare l’output, validare ed eseguire un Job
Lo Script Runner separa la revisione delle impostazioni dall’esecuzione effettiva. Con Validate review controlla lo Script, i parametri e i Dataset senza lanciare Python; con Run Job invia al supervisore una richiesta autonoma con sorgente e configurazione verificati. Questa guida segue tre esecuzioni sintetiche: una senza pubblicazione, una con un Dataset realmente pubblicato e una interrotta tramite i comandi originali di GX-TXT.
1. Le quattro identità da non confondere
Uno Script registrato identifica il codice attraverso riferimento, versione, revisione e SHA-256. La Session fornisce il contesto scientifico. Il Job identifica una singola esecuzione immutabile, che ha un proprio stato e un proprio log. Il Dataset di output, quando pubblicato, è un ulteriore oggetto canonico con identità e provenienza distinte. L’esistenza di uno di questi elementi non implica automaticamente l’esistenza degli altri.
2. Preparare un sorgente Python sintetico
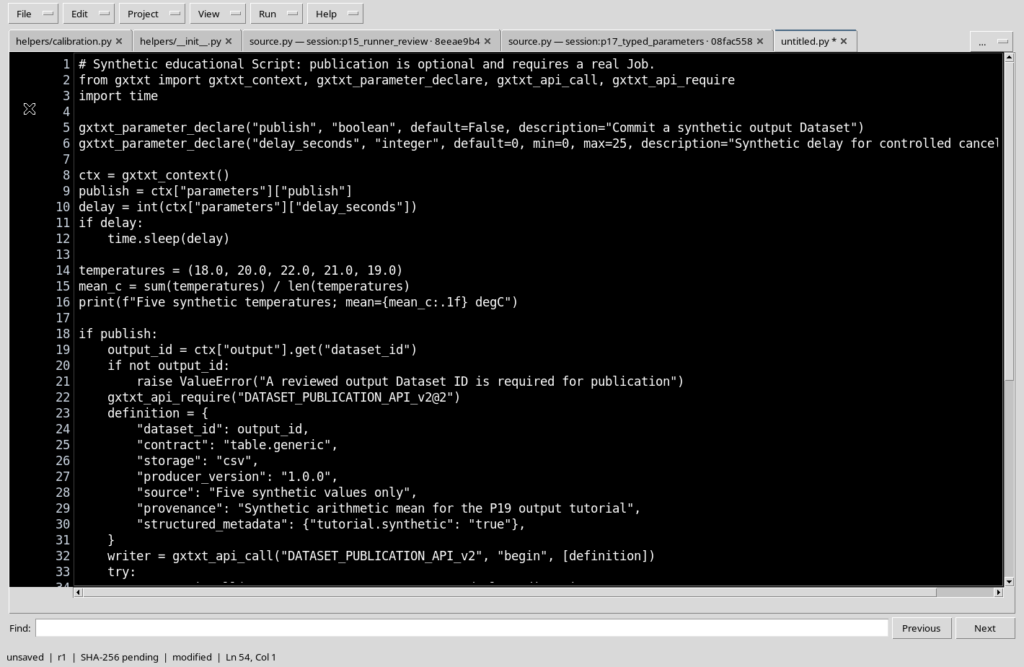
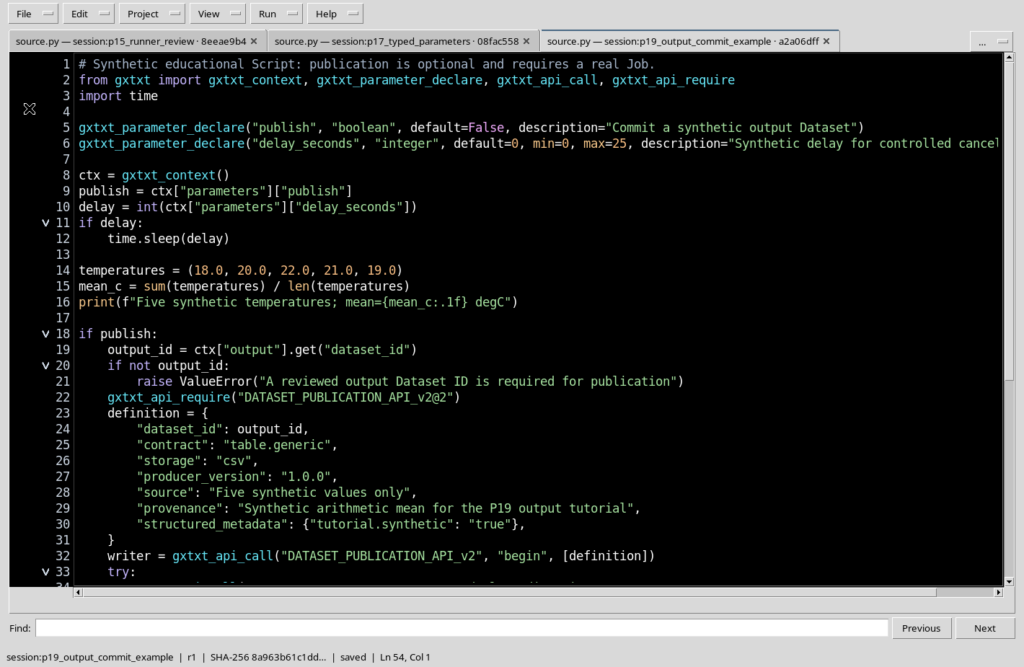
Per illustrare la procedura utilizziamo cinque temperature inventate: 18, 20, 22, 21 e 19 °C. Il programma calcola la media aritmetica, pari a 20,0 °C. Nel sorgente è presente anche un’opzione booleana per distinguere il calcolo dalla pubblicazione e un ritardo opzionale per dimostrare la cancellazione. Sono dati didattici, non risultati sperimentali.
3. Registrare lo Script prima dell’esecuzione
Nel Python Script Workspace compilare Script ID, Name, Version e Scope, quindi usare File → Save. La registrazione conserva un’identità e un’impronta SHA-256 del sorgente. Salvare uno Script non produce alcun Job: permette al Runner di scegliere una revisione ben definita. Se l’editor ha modifiche non salvate, occorre decidere quale revisione utilizzare prima di procedere.
4. Aprire la finestra Script Runner
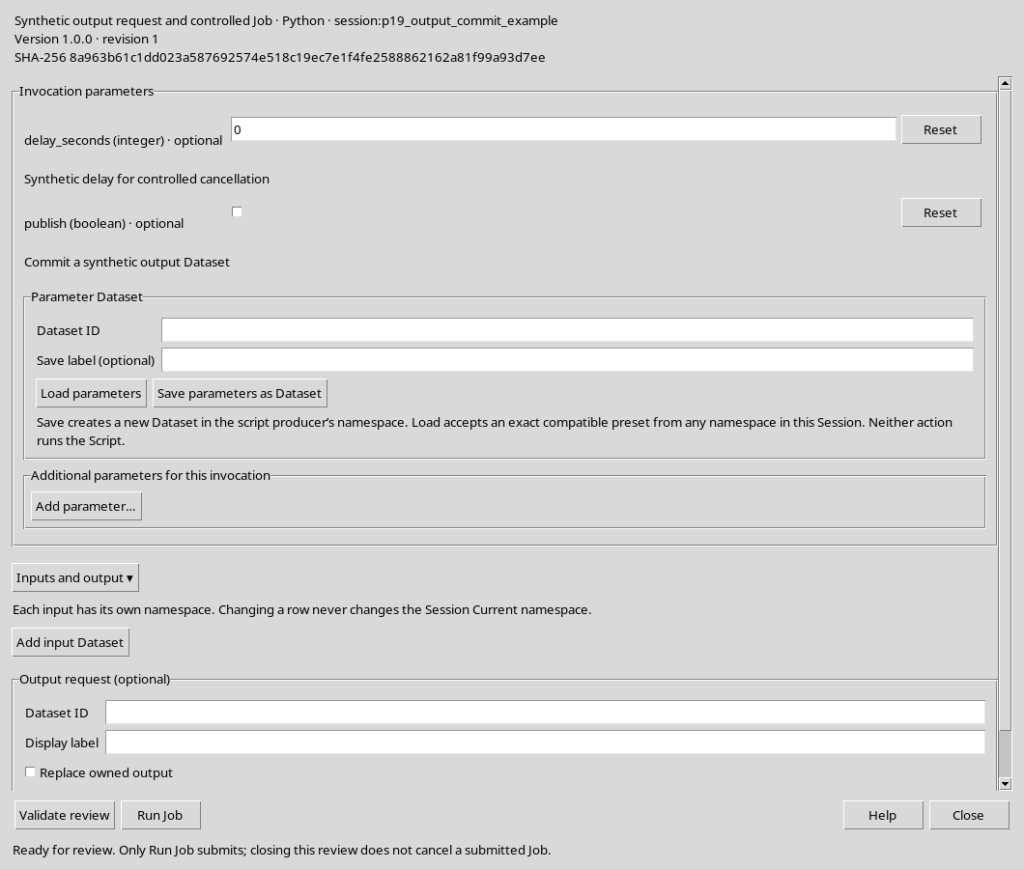
Con lo Script registrato selezionato, scegliere Run → Open Script Runner…. La testata mostra nome, linguaggio, riferimento, versione, revisione e SHA-256 del sorgente. Questi dati sono fondamentali per riconoscere il programma che potrebbe essere eseguito. L’apertura non invia un Job e non acquisisce automaticamente un Dataset di risultati.
5. Espandere Inputs and output
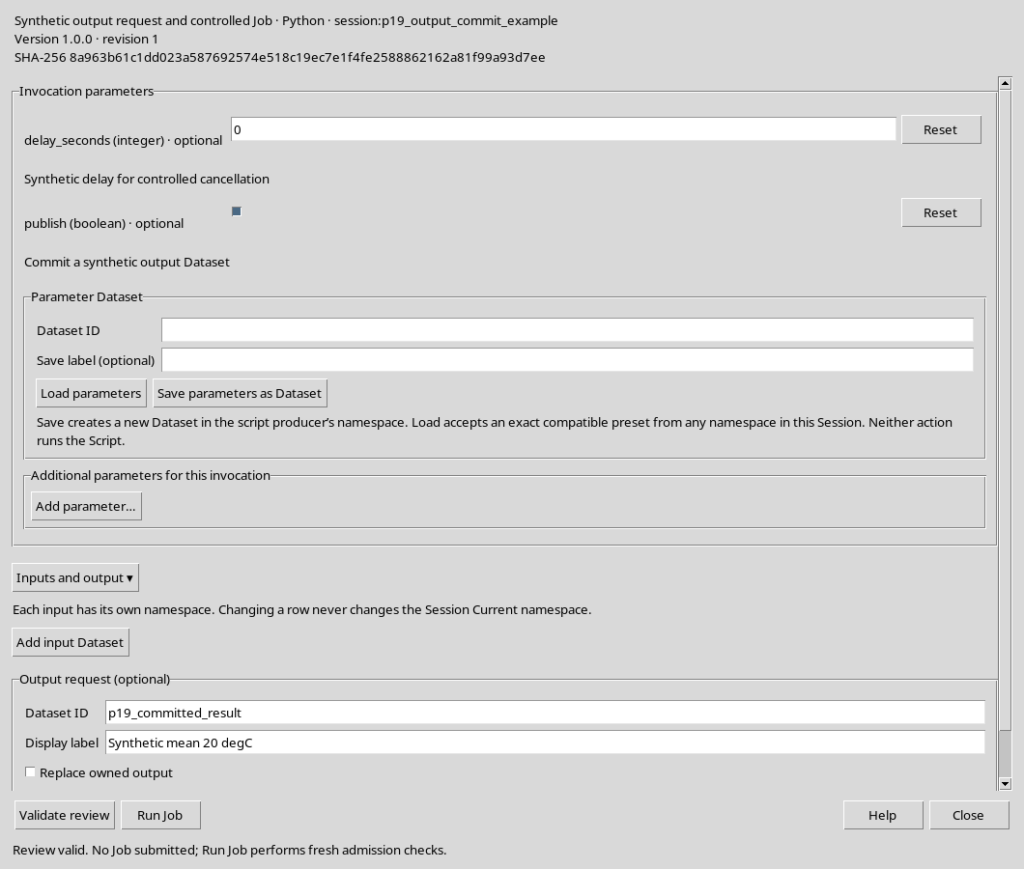
Aprire Inputs and output ▾ nella finestra del Runner. La parte superiore permette di associare eventuali Dataset di ingresso, mentre Output request (optional) contiene Dataset ID, Display label e Replace owned output. Gli input sono stati trattati nel capitolo dedicato ai namespace. Per l’esempio attuale il programma usa direttamente cinque valori sintetici, quindi non occorre aggiungere input esterni.
6. Dataset ID e Display label
Il campo Dataset ID descrive l’identificativo canonico desiderato per un risultato. Display label è facoltativo e serve a spiegare il significato dell’output. I due campi hanno funzioni diverse: l’etichetta non è un identificativo e non conferisce alcun diritto di pubblicazione. Lasciare vuoto il Dataset ID significa non richiedere una destinazione esplicita: non impedisce a uno Script autorizzato di usare le API scientifiche previste dal proprio contratto.
7. Un identificativo di output non valido viene rifiutato
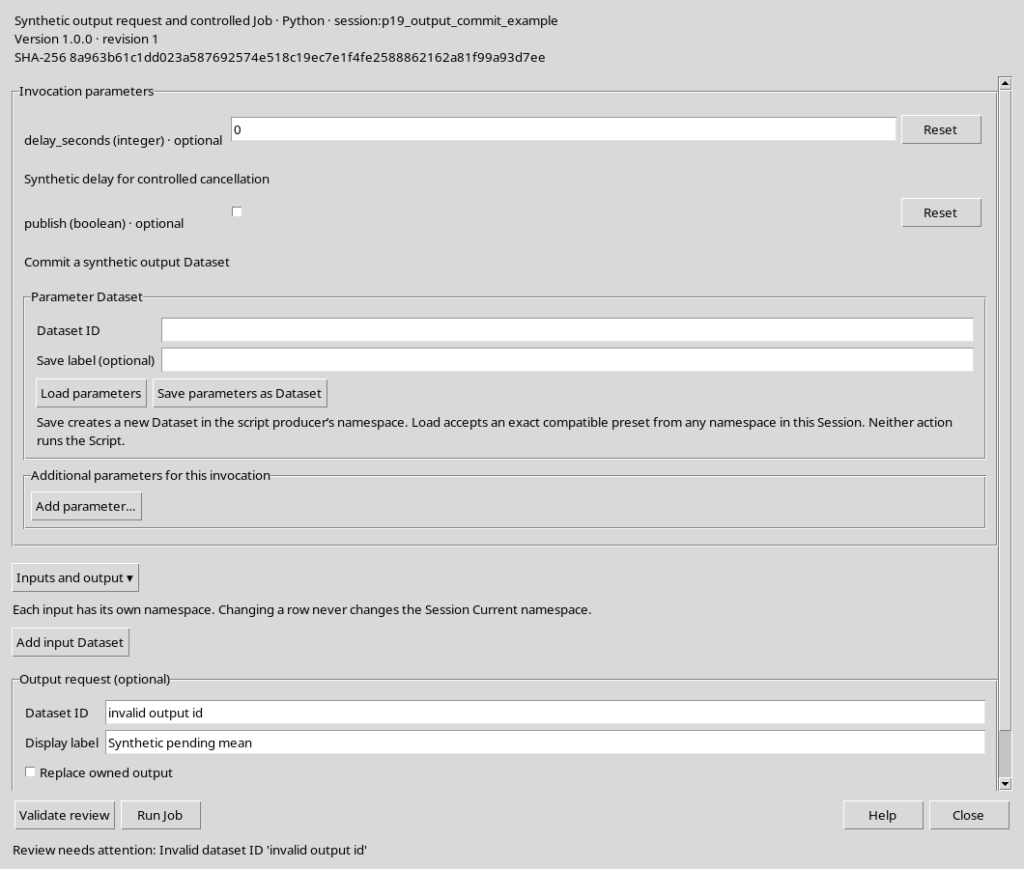
La scelta dell’ID deve rispettare la sintassi richiesta dal Registry. Se, per esempio, si inserisce un identificativo con spazi non ammessi, Validate review mostra Review needs attention e non autorizza la richiesta. L’errore riguarda la preparazione dell’output; non è necessario lanciare lo Script per accorgersene.
8. Un output esistente non viene sovrascritto implicitamente
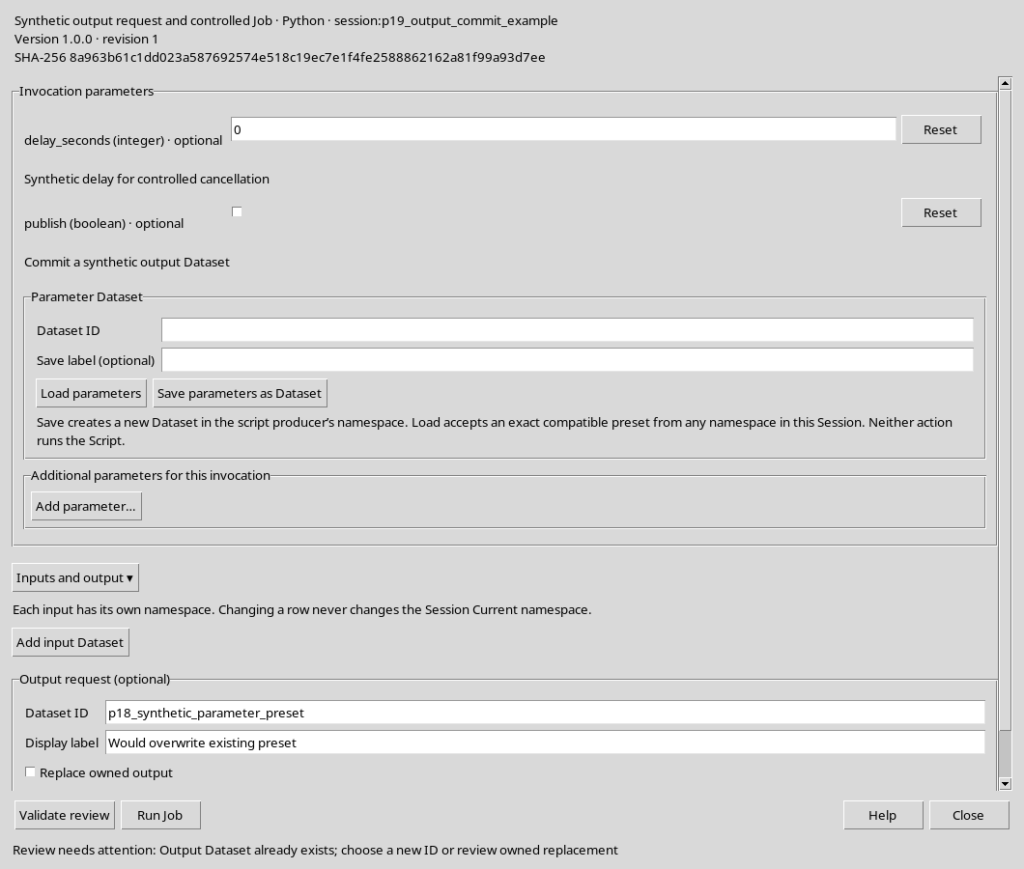
Se si richiede come destinazione un Dataset ID già presente, la configurazione predefinita è create-only. Il Runner segnala Output Dataset already exists e richiede di scegliere un nome nuovo oppure di esaminare esplicitamente le condizioni di sostituzione autorizzata. Non tentare di utilizzare un Dataset esistente come semplice destinazione senza comprenderne provenienza e proprietà.
9. Il significato di Replace owned output
La casella Replace owned output richiede una verifica ulteriore. Non costituisce un’autorizzazione generale a modificare Dataset di altri produttori: il CORE verifica namespace, identità, produttore e diritto di sostituzione. Per la prima pubblicazione didattica la casella va mantenuta disabilitata, usando un Dataset ID nuovo. Un input appartenente a un namespace differente non concede il permesso di scrivere in quel namespace.
10. Validate review non avvia un Job
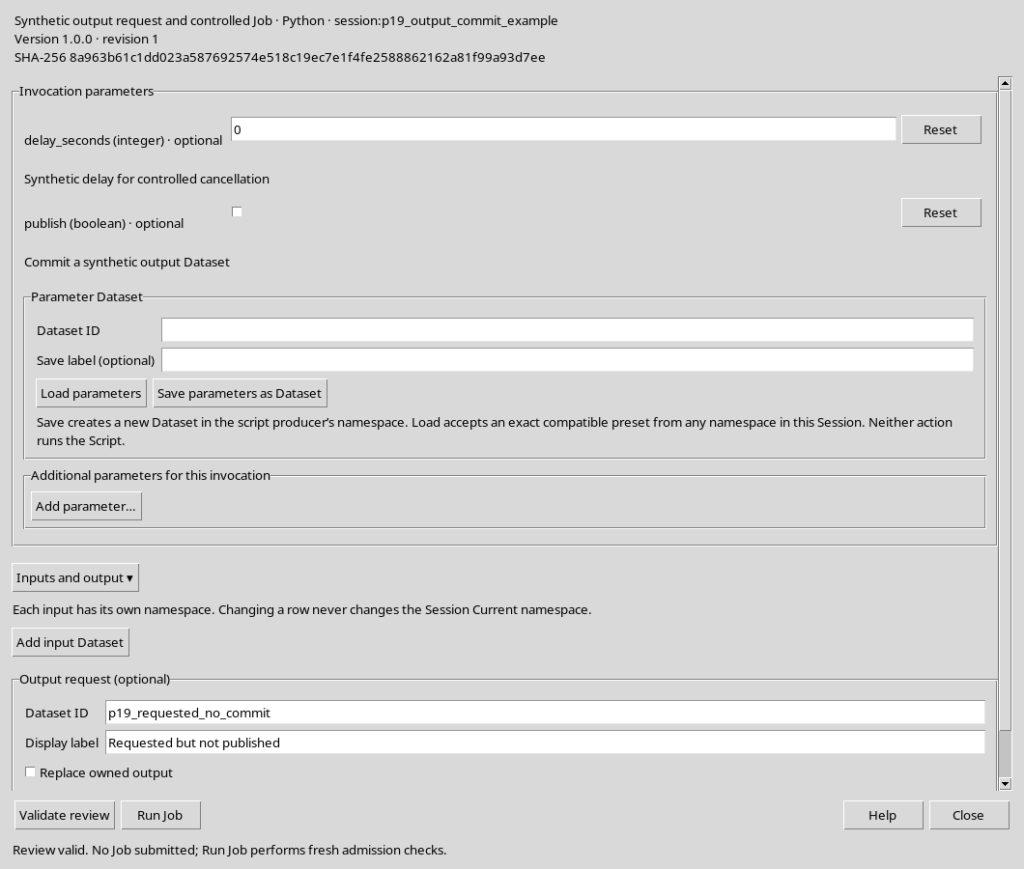
Una volta compilati i campi, premere Validate review. Il messaggio Review valid. No Job submitted conferma che la richiesta corrente ha superato i controlli disponibili, ma non significa che Python sia stato eseguito. Il controllo verifica nuovamente il sorgente registrato, i parametri tipizzati, gli input e l’eventuale richiesta di output; l’ammissione definitiva verrà ripetuta quando si premerà Run Job.
11. Richiedere un output non equivale a pubblicarlo
Il campo Output request indica una destinazione, ma non crea da solo un Dataset. È lo Script, attraverso un’API pubblica di pubblicazione, a dover produrre e registrare il dato. Nell’esempio il programma dispone di un parametro booleano publish: impostato a False, esegue il calcolo e stampa il risultato senza pubblicare dati canonici, anche se nel Runner è presente un Dataset ID di output.
12. Premere Run Job: prima esecuzione senza commit
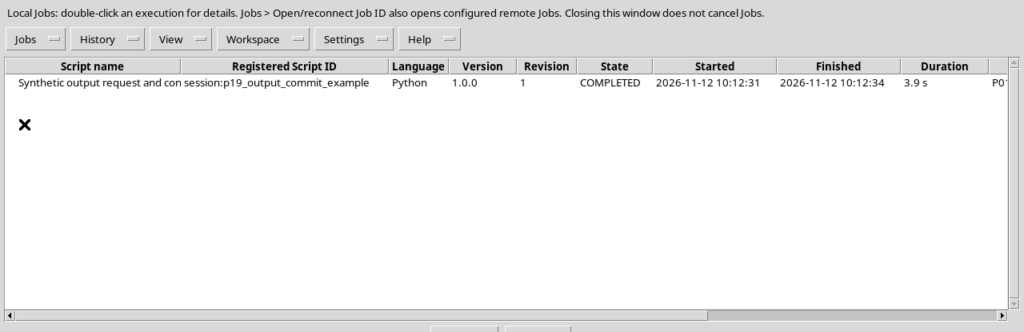
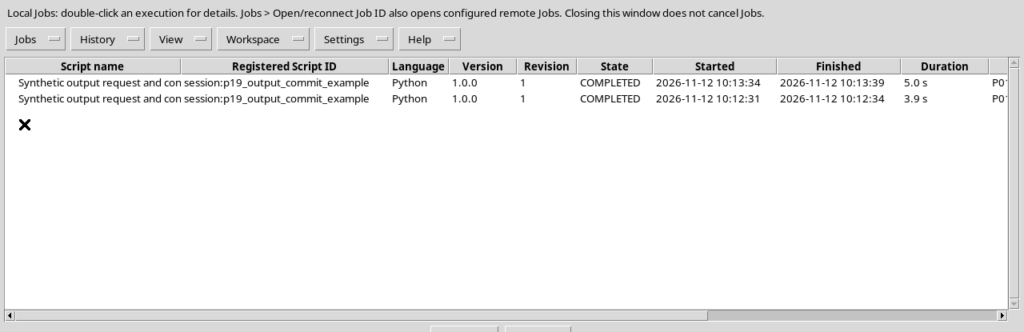
Con una richiesta valida e publish=False, premere Run Job. L’interfaccia invia la configurazione al supervisore e compare la finestra Script Jobs. La prima esecuzione dell’esempio termina nello stato COMPLETED e restituisce la media di 20,0 °C, ma non registra alcun Dataset. Questo comportamento conferma che completamento del Job e pubblicazione del risultato sono due operazioni distinte.
13. La finestra Script Jobs
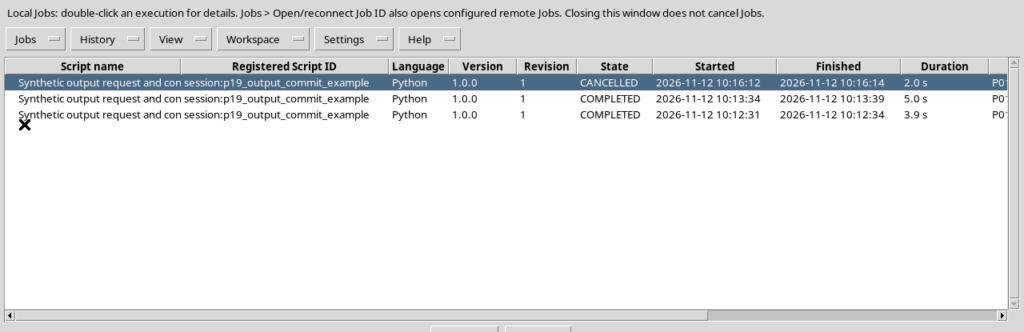
Script Jobs presenta le esecuzioni con nome, riferimento registrato, linguaggio, versione, revisione, stato, inizio, fine e durata. Selezionando un Job è possibile esaminarne il log e aprire Open execution details. L’elenco può mostrare più esecuzioni della stessa revisione: sono Job distinti con configurazioni e risultati differenti. Chiudere questa finestra non annulla un Job già inviato.
14. Verificare il risultato che non è stato pubblicato
Il primo log riporta la media sintetica, ma il registro delle pubblicazioni del Job è vuoto e il Dataset ID richiesto non risulta nel catalogo. L’assenza del Dataset è coerente con il codice effettivamente eseguito. Non bisogna dichiarare pubblicato un risultato soltanto perché compare nella console o perché il Job è indicato come COMPLETED.
15. Preparare una seconda richiesta con pubblicazione
Tornare al Runner, scegliere un nuovo Dataset ID, assegnare un’etichetta descrittiva e abilitare il comportamento publish=True dello Script. Lasciare disabilitato Replace owned output. Ripetere Validate review: la revisione del sorgente rimane la stessa, ma i parametri e la richiesta di output non coincidono con quelli della prima esecuzione.
16. La pubblicazione richiede un’API pubblica
Per registrare un Dataset numerico lo Script può usare Dataset Publication API v2 tramite il client pubblico Python gxtxt_api_call(). Il frammento seguente mostra il nucleo del protocollo, con una sola variabile numerica e una riga.
from gxtxt import gxtxt_context, gxtxt_api_call, gxtxt_api_require

ctx = gxtxt_context()
output_id = ctx["output"]["dataset_id"]
gxtxt_api_require("DATASET_PUBLICATION_API_v2@2")

definition = {
    "dataset_id": output_id,
    "contract": "table.generic",
    "storage": "csv",
    "producer_version": "1.0.0",
    "source": "Synthetic tutorial values",
    "provenance": "Arithmetic mean of five synthetic readings",
}
writer = gxtxt_api_call("DATASET_PUBLICATION_API_v2", "begin", [definition])
try:
    gxtxt_api_call("DATASET_PUBLICATION_API_v2", "declare_dimension",
                   [writer, "row", 0, {"extendible": 1}])
    gxtxt_api_call("DATASET_PUBLICATION_API_v2", "declare_variable",
                   [writer, "mean_c", {
                       "dtype": "float64", "rank": 1,
                       "dimension_ids": "row", "unit": "degC",
                       "coordinate_role": "data",
                       "semantic_role": "derived",
                   }])
    gxtxt_api_call("DATASET_PUBLICATION_API_v2", "append",
                   [writer, "row", {"mean_c": [20.0]}])
    receipt = gxtxt_api_call("DATASET_PUBLICATION_API_v2", "finalize", [writer])
    writer = None
except Exception:
    if writer is not None:
        gxtxt_api_call("DATASET_PUBLICATION_API_v2", "abort", [writer])
    raise
begin apre la pubblicazione, le dichiarazioni definiscono la dimensione e il tipo, append inserisce i valori e finalize ne effettua il commit canonico. abort elimina la pubblicazione incompleta quando si verifica un errore. Non scrivere direttamente nei file del Registry o nelle directory dei Dataset.
17. Seconda esecuzione: completamento e commit
Dopo la validazione, premere nuovamente Run Job. Anche la seconda esecuzione termina COMPLETED, ma questa volta lo Script esegue la pubblicazione. Il Job conserva il proprio identificativo e il registro delle pubblicazioni indica il nuovo Dataset canonico. Non è un effetto automatico del campo Output: è il risultato dell’esplicito commit svolto dal codice.
18. Verificare che il Dataset esista realmente
Dopo il commit, il Catalogo contiene il nuovo Dataset con contratto table.generic, produttore analysis.python_script e namespace del modulo. Il contenuto è una variabile mean_c di tipo float64, unità degC, una sola riga con valore 20,0. La verifica va effettuata con le API canoniche o il Viewer autorizzato, non deducendo l’esistenza del Dataset dal nome mostrato nel Runner.
19. Output richiesto, output pubblicato e dati temporanei
Il supervisore distingue tre elementi: Output request, cioè ciò che l’utente ha richiesto; i file e le tracce temporanee dell’esecuzione; i Committed published Dataset IDs, registrati dal CORE. Solo l’ultimo gruppo identifica risultati pubblicati e conservati come Dataset canonici. L’output standard stampato da Python resta un flusso del Job, a meno che non venga pubblicato separatamente.
20. L’identità immutabile del Job
Ogni Job conserva lo Script registrato, la versione, la revisione e lo SHA-256 della sorgente effettivamente eseguita. Conserva inoltre i parametri, gli eventuali input, la richiesta di output, il contesto della Session e le informazioni del runtime. Due Job possono usare lo stesso Script e produrre risultati diversi senza mutarne il Registry. Le copie congelate del sorgente consentono di ricostruire l’esecuzione anche quando il file dell’editor verrà modificato in futuro.
21. Leggere Open execution details
La finestra Open execution details mostra stato, codice di uscita, provenienza del sorgente, richieste di output e pubblicazioni realmente commesse. I pannelli del log permettono di consultare separatamente output del programma, stderr e diagnostica. Il percorso locale del Job e altri identificativi tecnici possono essere presenti nella vista: appartengono alla Session dell’installazione e non vanno trasferiti nelle guide pubbliche come istruzioni riutilizzabili.
22. I servizi CORE di anteprima sono separati
Quando un Dataset numerico viene pubblicato, GX-TXT può avviare una preparazione automatica CORE Dataset Preview. Questa è un’esecuzione di servizio distinta dal Job Python dell’utente. Nell’esempio la preparazione dell’anteprima del nuovo Dataset numerico è stata completata correttamente; ciò non modifica il significato dello stato del Job né il numero di esecuzioni Python esplicitamente richieste.
23. Preparare una cancellazione controllata
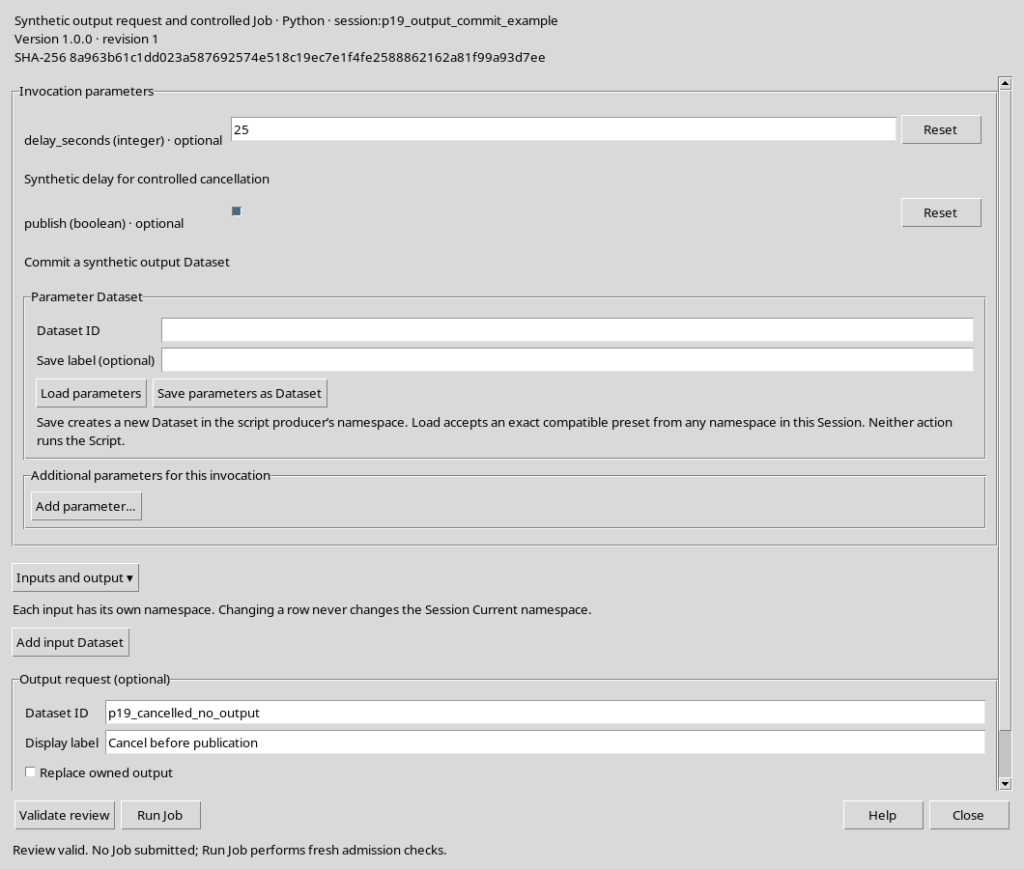
Per mostrare il comportamento di arresto viene impostato, soltanto nello Script sintetico, un breve ritardo mediante delay_seconds. Il terzo Job riceve un nuovo Dataset ID di output e lo stesso sorgente registrato. Il ritardo non rappresenta un esperimento reale: serve a mantenere l’esecuzione attiva il tempo necessario per selezionarla nella finestra Jobs.
24. Identificare il Job RUNNING da interrompere
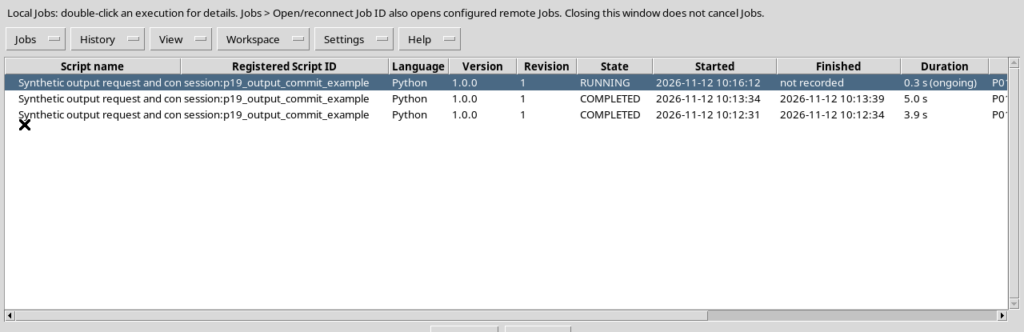
Dopo Run Job, individuare nella tabella Script Jobs l’esecuzione corretta e controllare il suo stato RUNNING. È importante distinguere il Job corrente dagli altri già COMPLETED: il pulsante o comando di cancellazione non deve essere applicato a una selezione multipla involontaria. Lo stato viene gestito dal supervisore, non dal contenuto testuale dell’editor.
25. Cancel running jobs: arresto attraverso il supervisore
Con il Job corretto selezionato, usare Jobs → Cancel running jobs. Il supervisore invia una richiesta di cancellazione e si occupa del processo e delle risorse associate. Non è necessario terminare manualmente l’interprete Python o cancellare file della Session. Nell’esempio lo stato finale diventa CANCELLED con motivo Cancellation requested, e nessun output del terzo Job viene pubblicato.
26. COMPLETED, FAILED e CANCELLED significano cose diverse
COMPLETED indica che il Job ha concluso la sua elaborazione; non garantisce che sia stato pubblicato un Dataset. FAILED identifica un errore della preparazione o dell’esecuzione, da leggere nella diagnostica. CANCELLED indica che la richiesta di interruzione è stata accettata e il supervisore ha arrestato il Job. Verificare sempre separatamente gli eventuali Dataset effettivamente commessi: cancellazione e fallimento non devono essere reinterpretati come risultati scientifici.
27. Chiudere le finestre non cancella un Job
Il pulsante Close del Runner e la chiusura di Script Jobs terminano la visualizzazione, non annullano implicitamente un’esecuzione già inviata. Un Job può continuare a essere gestito dal supervisore anche con le finestre nascoste. Per interrompere un’elaborazione attiva occorre invece la specifica azione Cancel sul Job corretto. È buona pratica attendere uno stato terminale prima di considerare conclusa la procedura.
28. Tornare al codice e conservare la provenienza
Dopo le tre prove, chiudere i dettagli, la finestra Jobs e il Runner. Nel Python Script Workspace il sorgente originale torna visibile con tema High Contrast Dark e senza pannelli superflui. Rimane registrato un solo nuovo Dataset numerico, pubblicato dalla seconda esecuzione: la prima è terminata senza output e la terza è stata cancellata.
Il procedimento dimostra che validazione, invio del Job, stato dell’esecuzione e pubblicazione canonica sono passaggi autonomi, collegati da identità e revisioni verificabili. La guida successiva tratterà l’integrazione con l’analisi Python avviata dalla normale interfaccia GX-TXT.