

Dall’immagine alla tabella scientifica revisionata
1. Obiettivo: una tabella leggibile, verificabile e riutilizzabile
Questa guida mostra un percorso completo in GX-TXT Unified Documents: importare un’immagine, delimitare una Region, estrarre una tabella con i servizi OCR, correggere le intestazioni, pubblicare un nuovo Dataset canonico e infine riprendere il lavoro da un Workspace salvato.
L’esempio impiega dati elettronici interamente sintetici, scelti per rendere il confronto fra immagine e tabella inequivocabile. Non sono misure di uno strumento reale. Il metodo può poi essere applicato a screenshot, manuali di laboratorio e immagini digitalizzate di tabelle sperimentali.
2. Due immagini di partenza dello stesso tipo di tabella
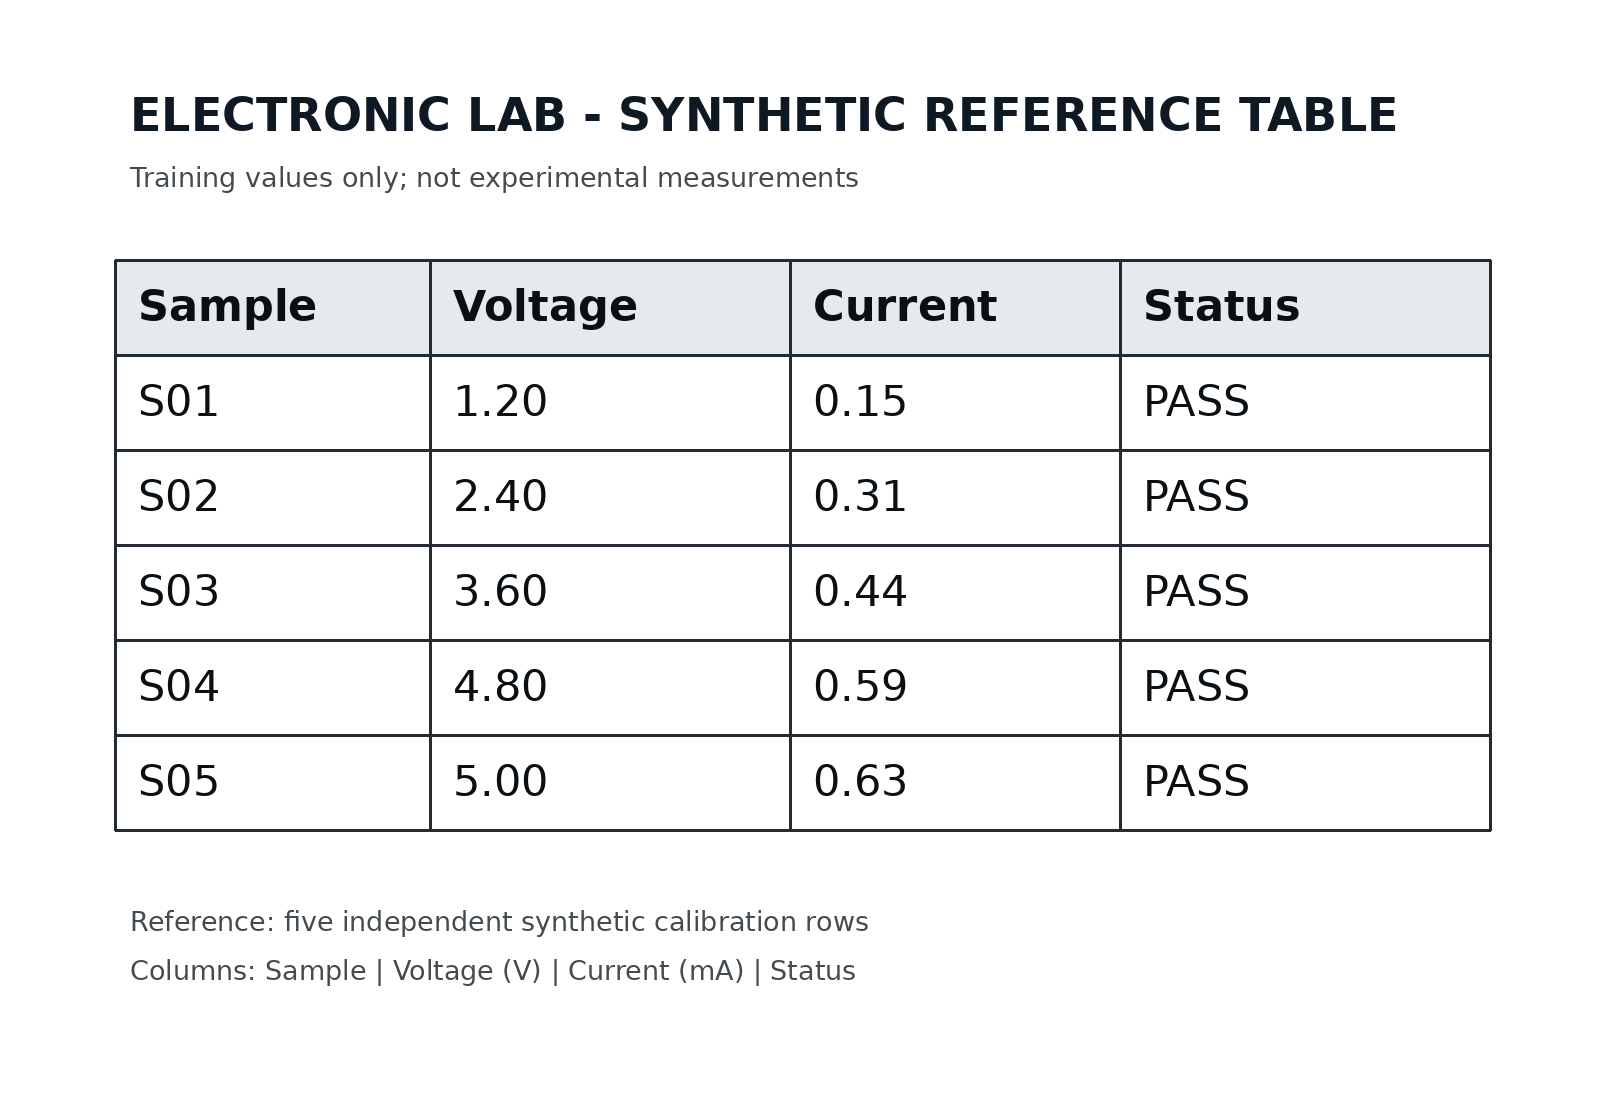
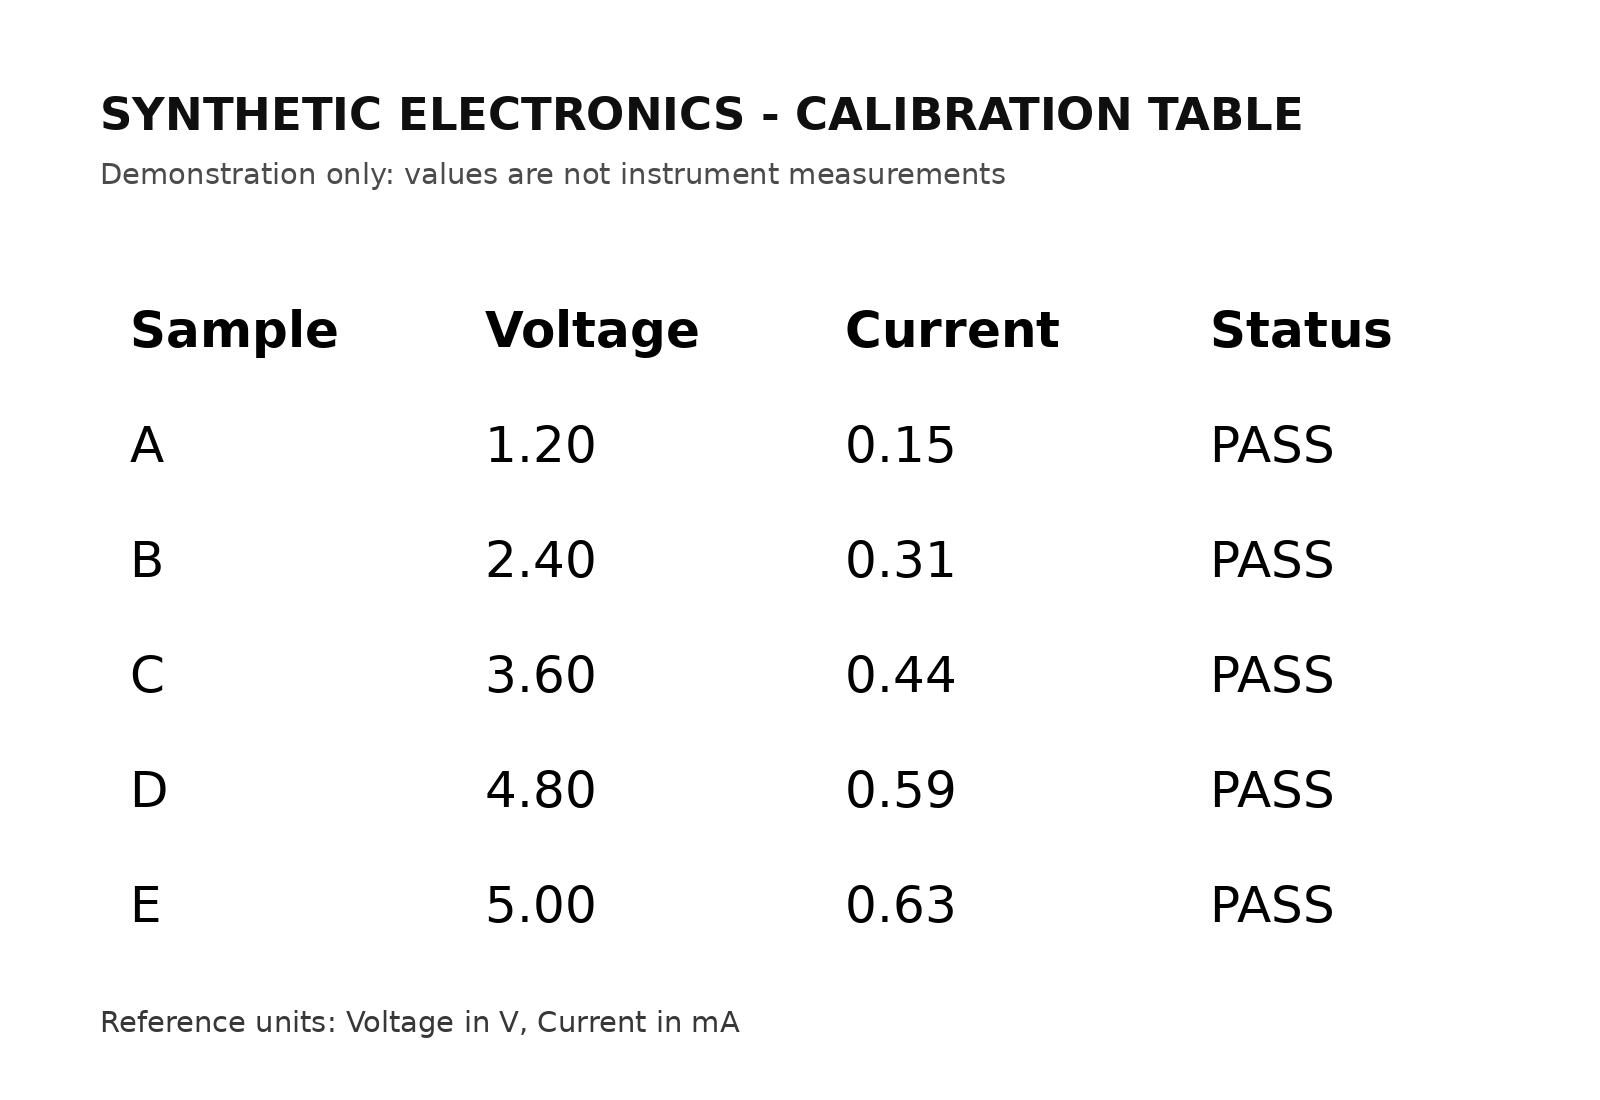
L’esercizio confronta due impaginazioni di una tabella con campione, tensione, corrente e stato: la prima usa una griglia completa, la seconda presenta righe e colonne ben distanziate senza bordi.
È possibile scaricare l’immagine con griglia e la versione senza griglia. Entrambe sono documenti didattici, non fotografie di misure. La differenza di impaginazione ci permette di osservare che una tabella visivamente chiara per una persona può essere difficile per un algoritmo OCR.
3. Importare prima la sorgente in una Session
La scheda Source del Viewer mostra Dataset canonici, non percorsi di file arbitrarî. Importare quindi l’immagine mediante il normale modulo di acquisizione GX-TXT per ottenere una sorgente di tipo image.raster nella Session.
Apertura e pubblicazione sono operazioni distinte. Il Viewer leggerà la sorgente senza alterarne i byte e creerà, quando richiesto, un nuovo Dataset per il risultato della tabella.
4. Aprire Unified Documents sulla prima immagine
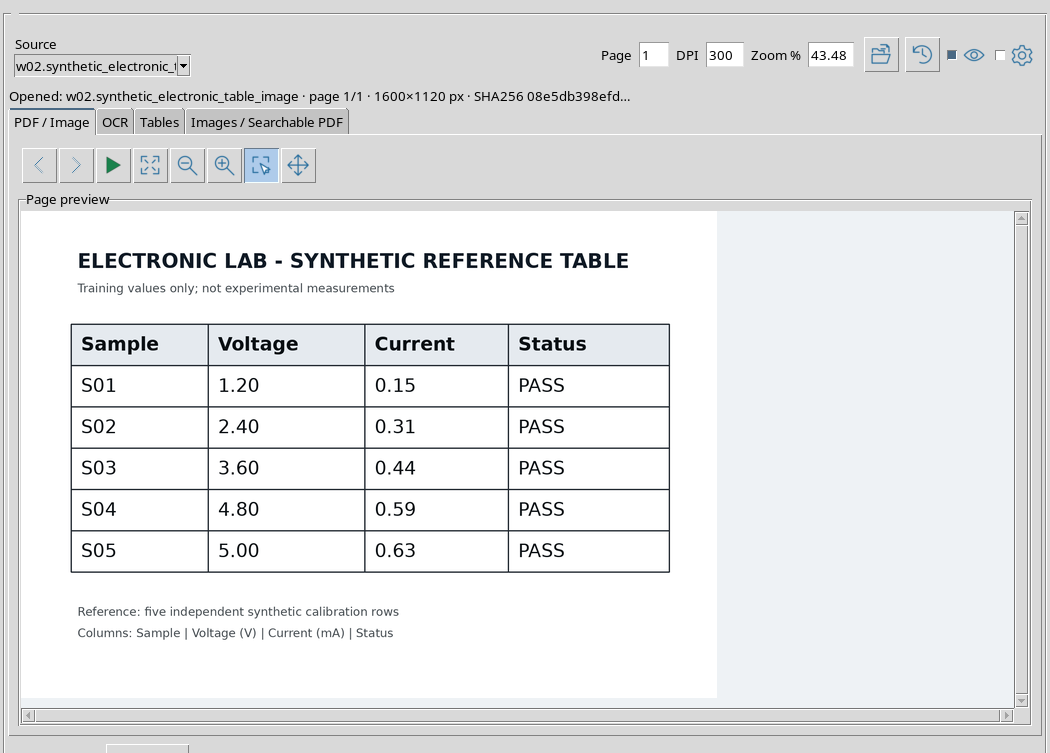
Dal pannello Viewers della finestra principale, aprire Unified Documents, selezionare la prima immagine in Source e premere Open source. La scheda PDF / Image visualizza la tabella a griglia e i suoi valori.
Osservare il numero di pagina e le dimensioni dell’immagine riportati nella barra informativa. Una singola immagine raster occupa la pagina 1/1.
5. Delimitare realmente la tabella con Region
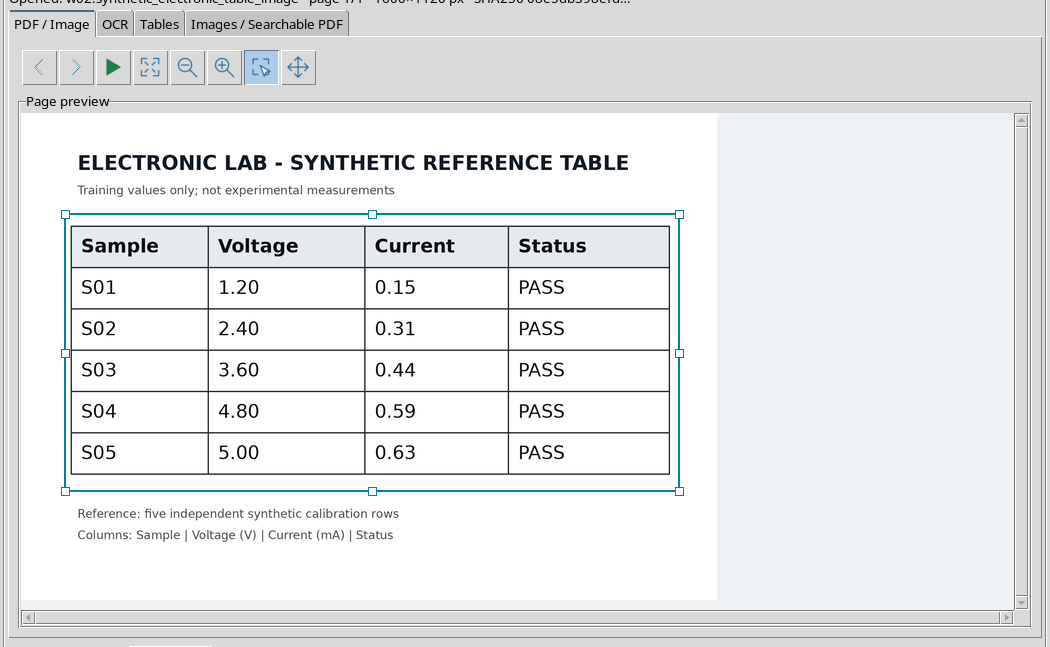
Nella scheda PDF / Image attivare Region, quindi tracciare con il mouse un rettangolo intorno alla tabella. La selezione non richiede una copia preventiva del file: definisce una regione normalizzata rispetto all’immagine sorgente.
Il bordo deve includere l’intestazione e tutte le righe che intendiamo estrarre. Per questa prima impaginazione vengono mantenute le linee della griglia, che costituiscono parte della difficoltà del riconoscimento.
6. Passare alla scheda Tables
Selezionare Tables, aprire Options e impostare il workflow desiderato. Table Extractor ricostruisce le celle usando il testo riconosciuto e la sua disposizione nello spazio.
Specificare Expected columns = 4 è un aiuto alla ricostruzione, non un ordine di fabbricare quattro colonne. First row is header segnala che la prima riga dovrà essere interpretata come intestazione al momento di pubblicare il Dataset.
7. Prima estrazione sulla tabella con griglia
Premere Extract table. Durante l’elaborazione possono comparire controlli temporaneamente disabilitati e il pulsante Cancel. Attendere la conclusione prima di cambiare sorgente o modificare le opzioni.
L’estrazione è un’operazione reale sui contenuti della regione selezionata: non basta che il Viewer mostri il titolo del documento per avere una tabella utilizzabile.
8. Un risultato non utilizzabile va dichiarato
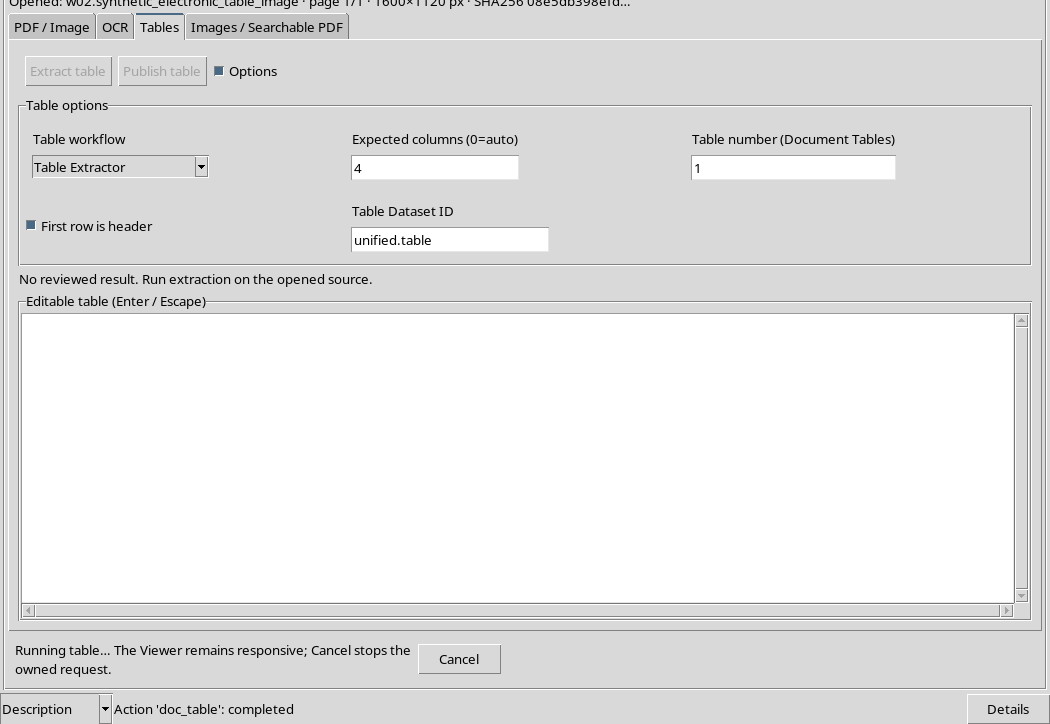
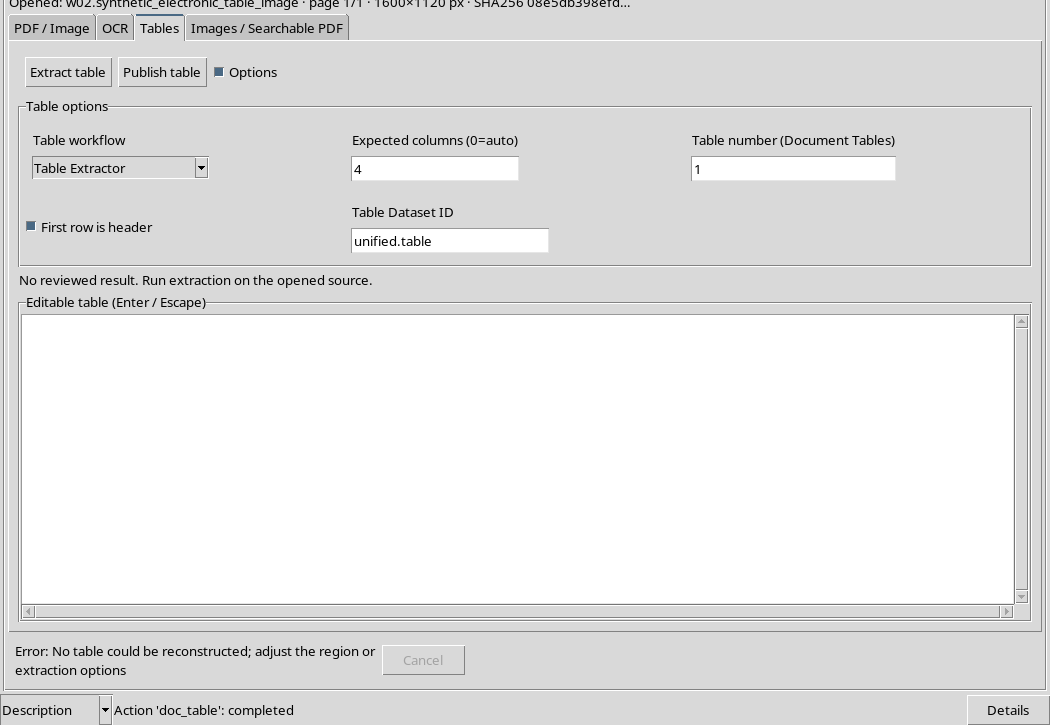
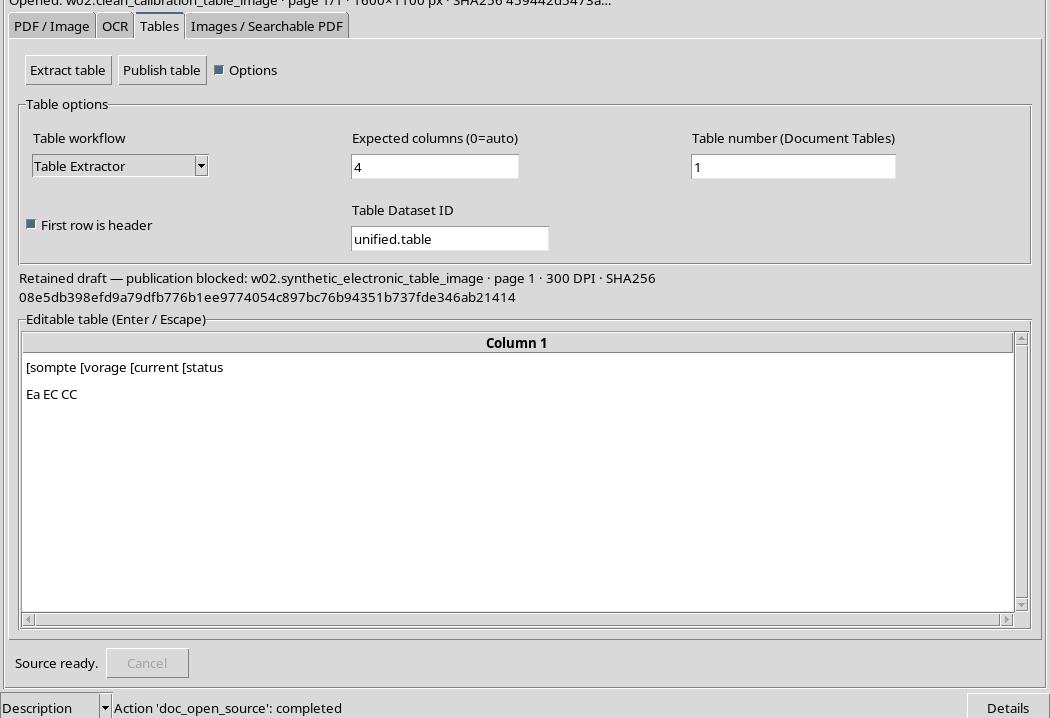
Sulla prima immagine, Table Extractor non ricostruisce una tabella utile. Il Viewer indica che è necessario modificare la regione o le opzioni. Anche Document Tables non è riuscito a ottenere la struttura desiderata: ha prodotto soltanto due righe e una colonna, non la matrice scientifica originale.
Il risultato non deve essere pubblicato come se rappresentasse cinque misure. È più corretto correggere il modo in cui il documento viene presentato, oppure scegliere una sorgente più adatta all’algoritmo.
9. Perché provare una diversa impaginazione
Il riconoscimento ottico dei caratteri e la ricostruzione di una tabella sono compiti differenti. Le linee di una griglia, le dimensioni dei font e la distanza fra le colonne possono modificare il modo in cui l’algoritmo separa parole, celle e righe.
Non esiste la garanzia che un’immagine con linee più marcate produca una tabella migliore. In questo esercizio usiamo un secondo documento con spaziature più regolari. Le due immagini restano sorgenti differenti, entrambe conservate in modo canonico.
10. Aprire la seconda immagine senza griglia
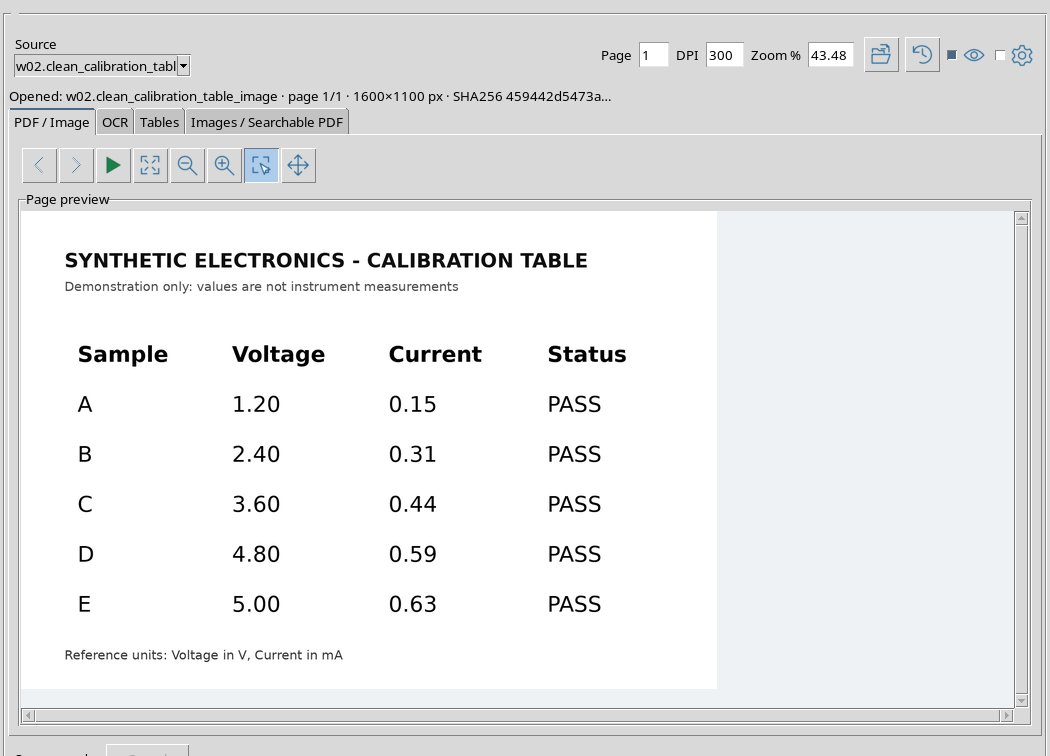
Importare la seconda immagine come image.raster, aggiornare Source, selezionarla e usare Open source. La nuova anteprima mostra le stesse categorie di dati, con colonne separate da spazi vuoti.
Il piè di pagina del documento indica esplicitamente le unità delle variabili: Voltage in V e Current in mA. Queste informazioni saranno utili nella revisione delle intestazioni.
11. Selezionare con precisione la nuova ROI
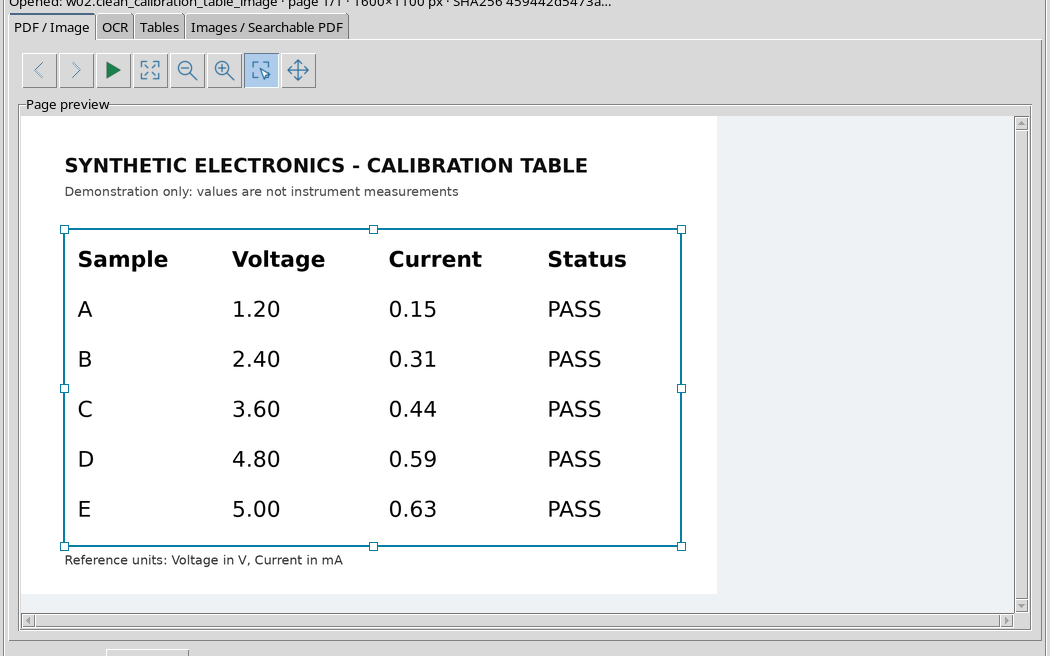
Tornare a PDF / Image, attivare Region e disegnare una selezione che comprenda soltanto l’intestazione e le cinque righe della tabella. È preferibile escludere il titolo e la nota finale con le unità, che non sono celle tabellari.
La ROI viene espressa in coordinate normalizzate rispetto ai pixel originali. Pertanto l’ingrandimento dell’anteprima non modifica il significato della regione nella sorgente.
12. Impostare Table Extractor e quattro colonne
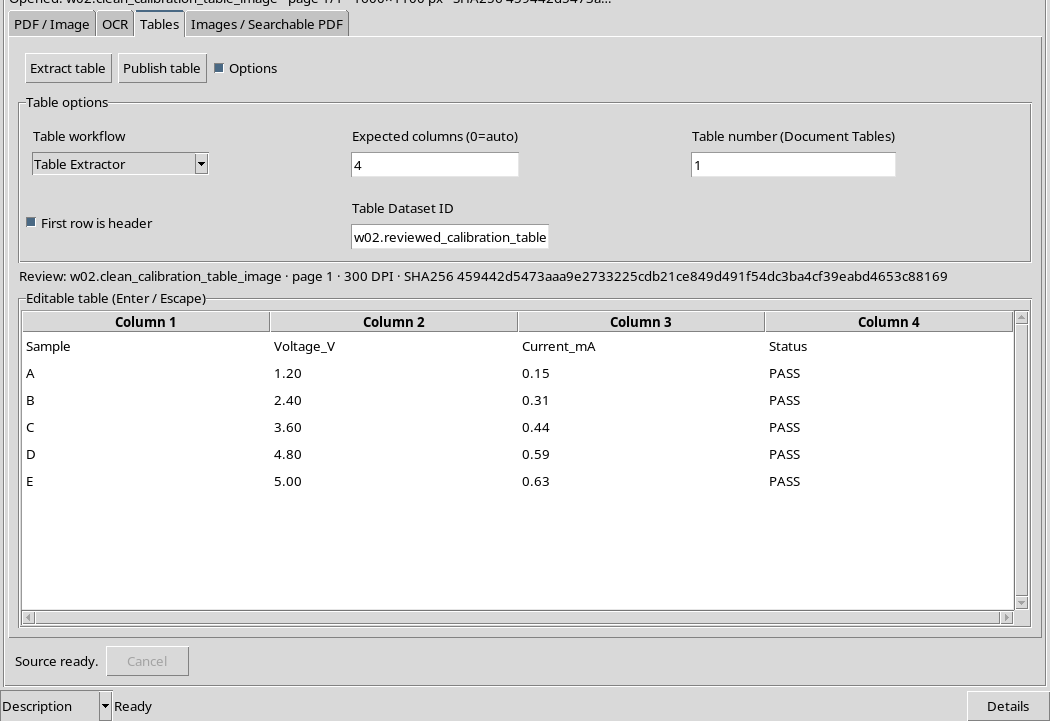
Nella scheda Tables usare Table workflow = Table Extractor, Expected columns = 4 e First row is header attivato. Il campo Table Dataset ID sarà compilato prima della pubblicazione.
In questo esempio Table number non seleziona una diversa tabella: viene mantenuto il valore predefinito. La struttura attesa è una riga di titoli più cinque righe di dati.
13. Eseguire il riconoscimento sulla nuova sorgente
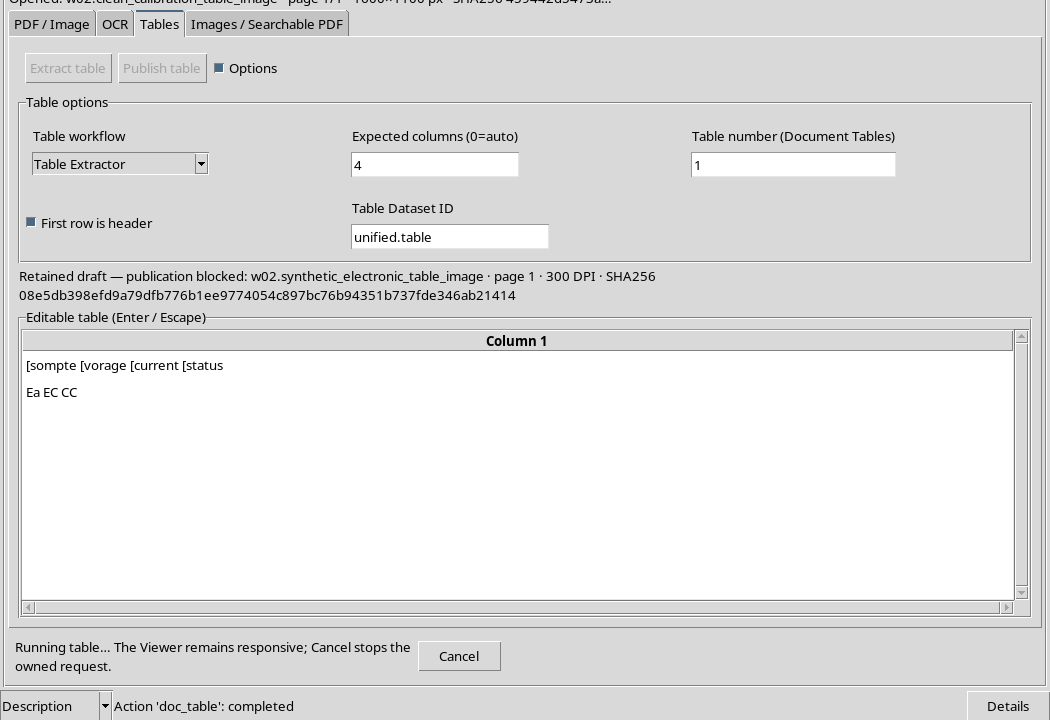
Premere Extract table. Il riconoscimento viene eseguito realmente sulla ROI e il risultato viene consegnato alla griglia modificabile della scheda Tables.
La presenza del riquadro Editable table (Enter / Escape) significa che il lavoro è ancora una bozza da controllare: Extract table da solo non crea un Dataset canonico pubblicato.
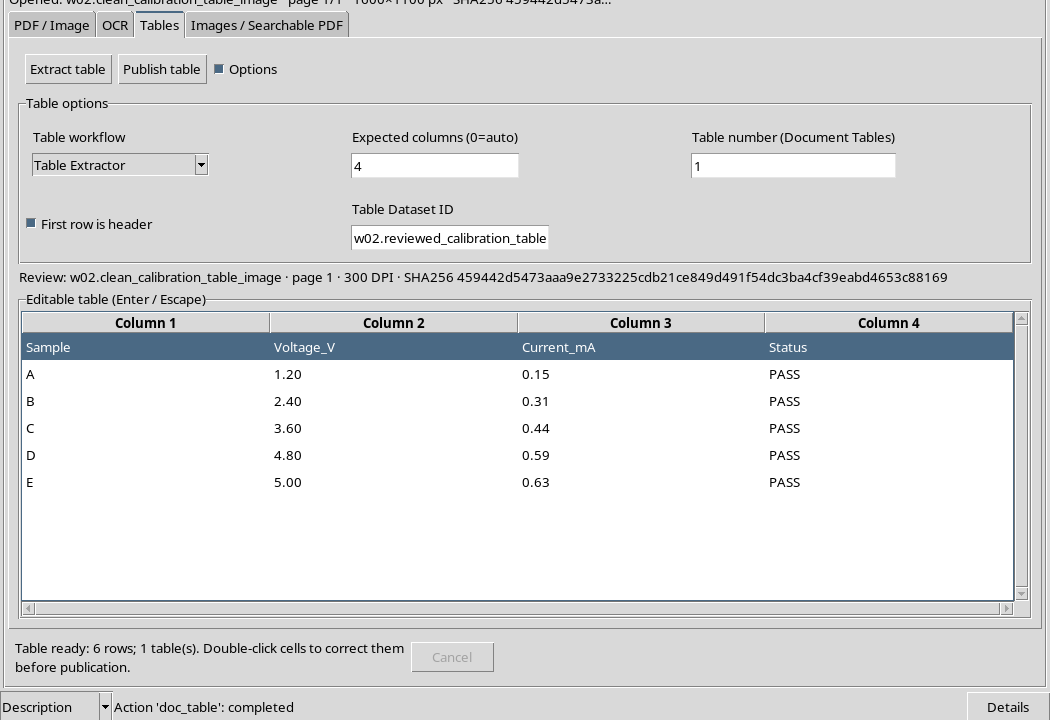
14. Confrontare le sei righe e le quattro colonne
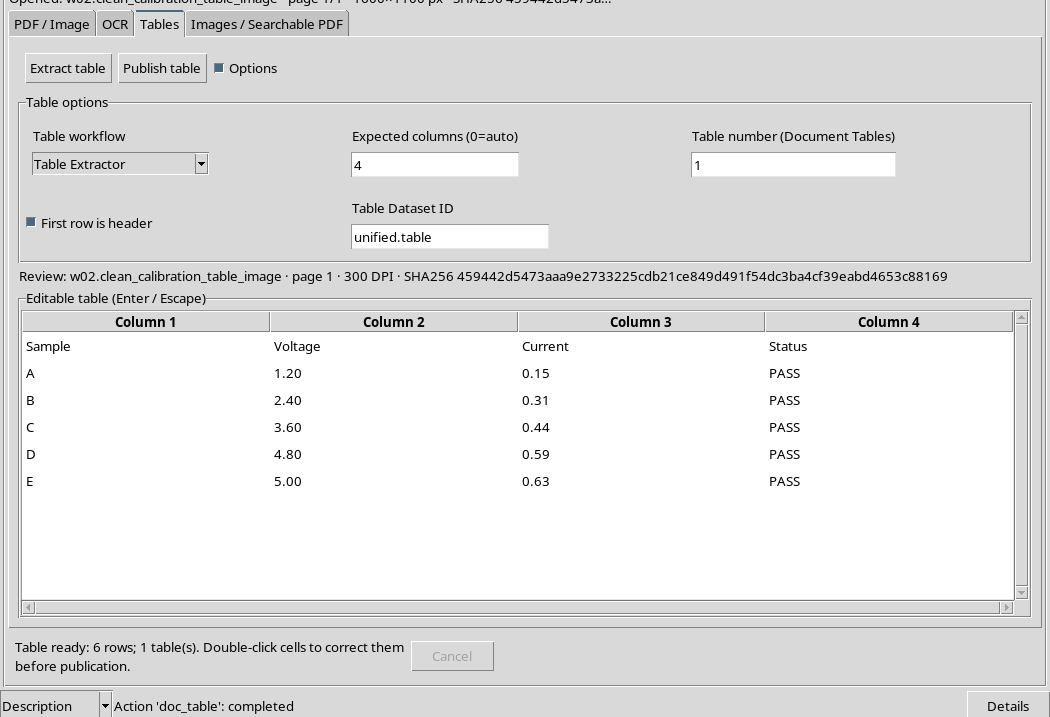
La seconda estrazione restituisce una matrice di 6 righe × 4 colonne, con Sample, Voltage, Current, Status seguiti dai campioni A, B, C, D ed E.
Il confronto con la tabella originale conferma 24 celle su 24: tutti i valori, i separatori decimali, le lettere dei campioni e le indicazioni PASS coincidono. Questo risultato è specifico della sorgente utilizzata: non costituisce una misura generale dell’accuratezza OCR.
15. Controllare prima le righe numeriche
La tabella contiene cinque coppie di valori di tensione e corrente. Nel documento didattico i valori sono:
| Campione | Tensione (V) | Corrente (mA) | Stato |
|---|---|---|---|
| A | 1,20 | 0,15 | PASS |
| B | 2,40 | 0,31 | PASS |
| C | 3,60 | 0,44 | PASS |
| D | 4,80 | 0,59 | PASS |
| E | 5,00 | 0,63 | PASS |
Queste sono cinque righe di dati, non sei misure: la prima riga della matrice è soltanto l’intestazione.
16. Integrare le unità nelle intestazioni
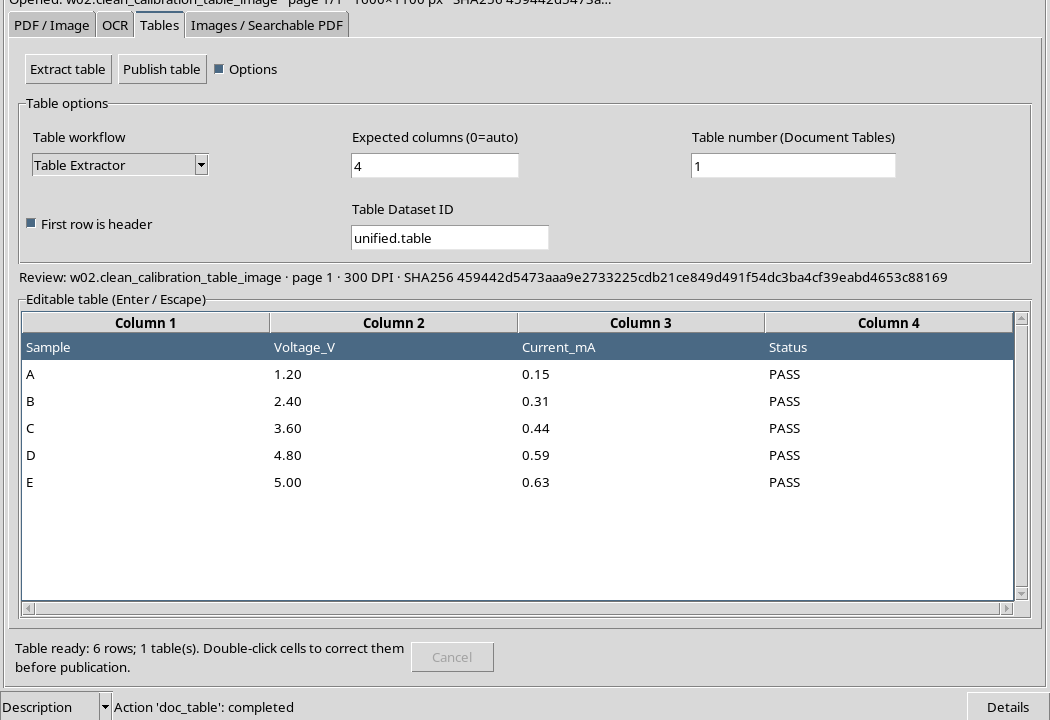
Il testo della tabella riconosciuta contiene le colonne Voltage e Current. Poiché la stessa immagine indica le unità nel piè di pagina, è possibile rendere le intestazioni più informative, modificandole in Voltage_V e Current_mA.
Questa è una correzione ragionata dell’operatore, non un’unità indovinata dall’OCR. I numeri e gli altri valori devono rimanere esattamente uguali.
17. Modificare una cella con l’editor nativo
Nella griglia originale, il doppio clic apre l’editor della cella. Modificare il contenuto e premere Return per confermare. Escape annulla una modifica in corso.
L’operazione è stata eseguita sulle due celle di intestazione. Dopo la conferma, la matrice comprende Sample, Voltage_V, Current_mA, Status e conserva tutte le cinque righe con i valori riconosciuti.
18. Perché le intestazioni contano a valle
Una tabella visualmente corretta può ancora avere una struttura poco chiara per chi deve utilizzarla in un calcolo. Un nome di colonna comprensibile consente di scegliere la variabile corretta, e le unità documentate aiutano a evitare interpretazioni errate.
Nel nostro esempio, l’annotazione delle unità nel nome delle colonne non equivale a una calibrazione fisica automatica. Il Dataset conserverà i nomi della variabile e i tipi inferiti; l’operatore deve mantenere il significato di V e mA nei successivi script di analisi.
19. Scegliere l’identificativo di pubblicazione
Nel campo Table Dataset ID inserire un nome riconoscibile, distinto dai due Dataset immagine originali. È opportuno che l’identificativo indichi il contenuto o la funzione della tabella revisionata, senza sovrascrivere una sorgente.
Prima di procedere, verificare ancora la sorgente aperta, la regione utilizzata, la presenza dell’intestazione corretta e il numero di righe.
20. Pubblicare con Publish table
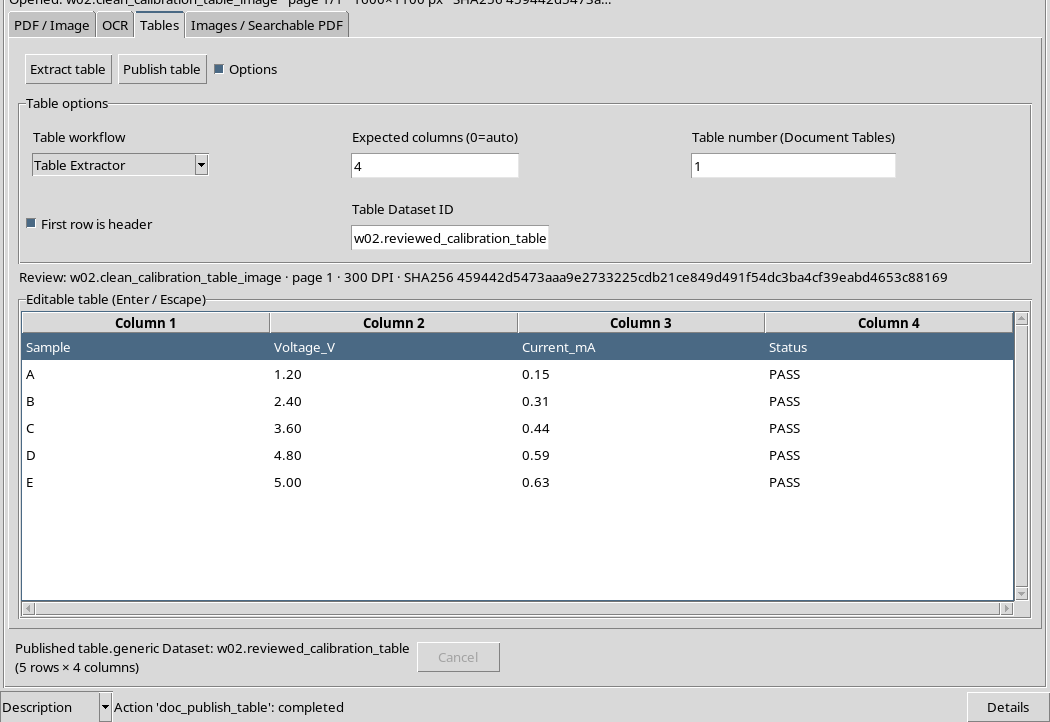
Premere Publish table. L’azione crea un nuovo Dataset canonico table.generic, associato alla sorgente immagine, alla pagina e alla regione di estrazione.
Nel caso dimostrativo il risultato è una tabella con cinque record e quattro colonne. Le immagini sorgente rimangono disponibili, separate dal Dataset tabellare pubblicato.
21. Che cosa è stato pubblicato
Il risultato canonico conserva i cinque campioni in un file tabellare CSV. Le variabili pubblicate corrispondono alle intestazioni revisionate, normalizzate come identificativi: sample, voltage_v, current_ma, status.
Le variabili voltage_v e current_ma sono state interpretate come float64, mentre sample e status sono stringhe. Questa verifica riguarda il contratto effettivo del Dataset pubblicato, non una supposizione basata sul solo aspetto della griglia.
22. Verifica indipendente con le API pubbliche GX-TXT
È utile controllare il risultato con le API pubbliche dei Dataset canonici. Leggere il contratto, le variabili, i rispettivi tipi e tutti i valori permette di confrontare il contenuto pubblicato con quello visto nella GUI e nel documento originale.
In questo esempio l’accesso canonico conferma i quattro campi, le cinque righe e la corrispondenza di tutti i valori. Il file CSV mantiene inoltre le intestazioni e i separatori decimali del contenuto revisionato.
23. Conservare la provenienza della tabella
Il Dataset pubblicato conserva il collegamento con la sorgente image.raster, il suo SHA-256, la pagina, il rendering e la regione normalizzata. Questo consente di ricostruire quale parte dell’immagine ha prodotto la tabella.
Non confondere il Dataset di risultato con l’immagine di partenza: il CSV non contiene l’intero documento, ma soltanto i dati estratti e revisionati. Le due immagini originali non sono state modificate.
24. Salvare lo stato dell’interfaccia nel Workspace
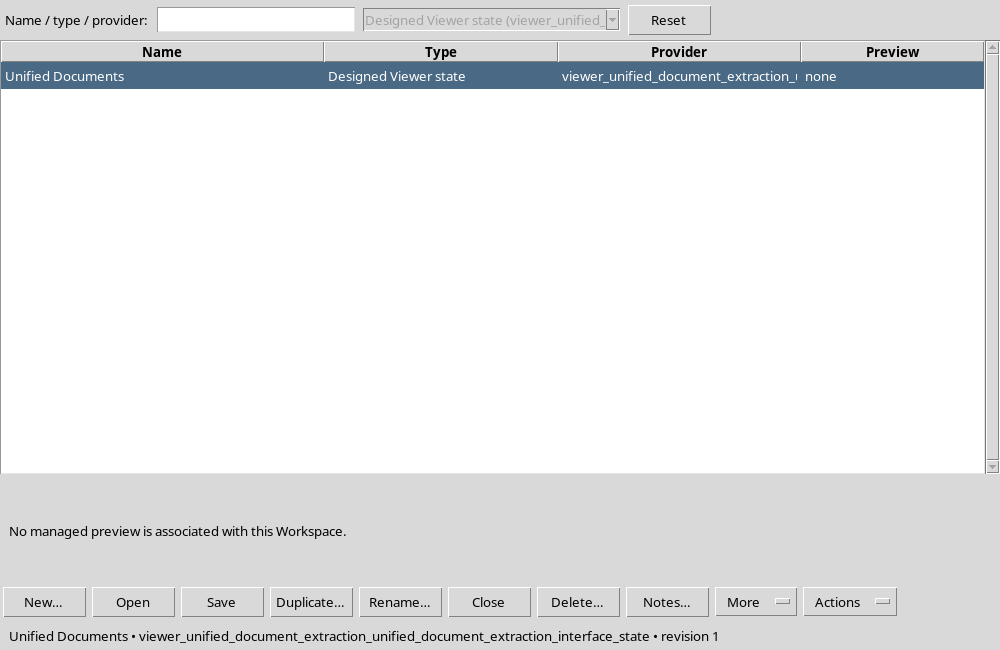
Dopo la pubblicazione, usare Workspace → Save per conservare la tabella revisionata, la sorgente, la ROI e il contesto di lavoro. Il Workspace non sostituisce il Dataset pubblicato: il suo ruolo è permettere la ripresa della revisione.
Aprire quindi Session Workspaces… per controllare che il Workspace Unified Documents risulti disponibile nel gestore condiviso del framework.
25. Chiudere e riaprire GX-TXT
Terminare normalmente il lavoro, chiudere il Viewer e l’applicazione, quindi riavviare GX-TXT e aprire la stessa Session. Il catalogo deve contenere ancora entrambe le immagini e il Dataset table.generic pubblicato.
Dal gestore Session Workspaces, selezionare il Workspace salvato e usare Open. Non occorre ricreare la tabella né importare nuovamente il file.
26. Verificare la tabella recuperata
Dopo la riapertura, la scheda Tables deve conservare pagina 1, l’area selezionata, le intestazioni annotate e i valori dei cinque campioni.
In questa procedura il confronto ha confermato che lo stato ripristinato è identico al contenuto del Workspace salvato e che il Dataset pubblicato resta leggibile attraverso le API canoniche.
27. Quali limiti considerare
La prima immagine a griglia dimostra che una tabella leggibile per una persona può non essere ricostruibile dall’OCR. Specificare quattro colonne non forza la creazione di quattro colonne corrette. Il sistema può restituire una struttura sbagliata oppure nessuna tabella.
Non pubblicare risultati incompleti o ambigui. La procedura più affidabile prevede il confronto con una sorgente indipendente, la revisione umana delle celle e la conservazione di unità e provenienza. Nel caso di misure reali, un’eventuale conversione di unità o analisi statistica va svolta in un passaggio successivo.
28. Risultato e prosecuzione
L’esercizio termina con una tabella canonica revisionata, cinque record leggibili e quattro variabili, due sorgenti immagine conservate e un Workspace recuperabile dopo il riavvio.
Il capitolo successivo completa il percorso con la pubblicazione di immagini da regioni e pagine e la creazione di un PDF ricercabile. I diversi tipi di output rimangono distinti: ciò permette a GX-TXT di preservare provenienza e contratti scientifici senza sovrascrivere i documenti originali.