

Calibrazione scientifica con le API pubbliche GX-TXT
Con Octave Script Workspace uno script GNU Octave può utilizzare dati scientifici già registrati nella Session e pubblicare un nuovo Dataset senza accedere direttamente ai file dello storage. In questo esempio leggeremo cinque tensioni sintetiche, applicheremo un guadagno double scelto nel Runner e conserveremo i valori corretti attraverso le API pubbliche GX-TXT.
Le procedure si riferiscono a GX-TXT DEV112-P005, modulo Octave Script Workspace 1.8.3. Le etichette della GUI sono riportate in inglese e il codice contiene commenti inglesi. L’editor usa il tema reale High Contrast Dark; gli altri controlli mantengono l’aspetto Tk/ttk nativo.
1. Il problema scientifico e i cinque dati di partenza
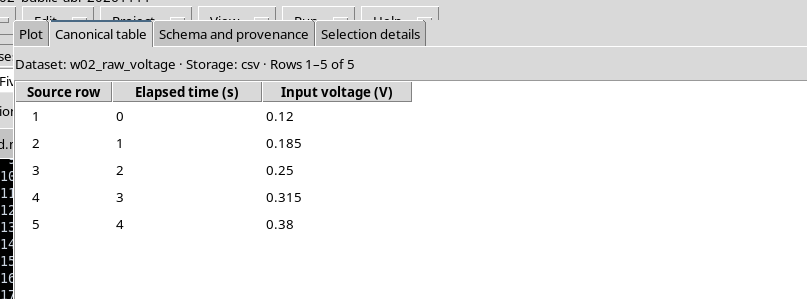
Supponiamo di avere cinque letture di tensione, in volt, acquisite in tempi successivi. Il guadagno scelto è adimensionale e pari a 1,6. La relazione utilizzata è:
V_corretto = gain × V_ingresso
Il Dataset di ingresso deve essere stato precedentemente pubblicato nella Session con contratto table.generic e con gli ID stabili delle variabili time_s e voltage_V. Per predisporlo si può seguire la guida «Pubblicare risultati numerici e output testuali», adattando i valori e gli identificativi.
| Tempo (s) | Tensione iniziale (V) |
|---|---|
| 0 | 0,120 |
| 1 | 0,185 |
| 2 | 0,250 |
| 3 | 0,315 |
| 4 | 0,380 |
Questi dati sono interamente sintetici e non derivano da uno strumento.
2. Creare uno script Session e dichiarare le API necessarie
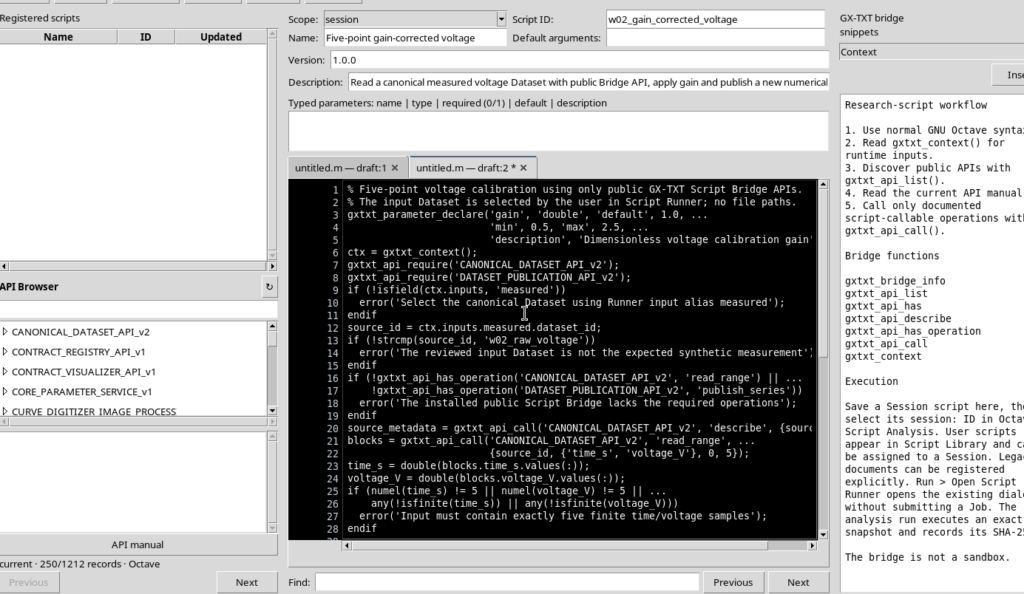
Aprire Octave Script Workspace, scegliere File → New Script e conservare Scope: session. Attribuire un identificativo, per esempio w02_gain_corrected_voltage, un nome e una descrizione; poi salvare con File → Save.
Nel campo Required APIs inserire esattamente le due API pubbliche, separate dal punto e virgola:
CANONICAL_DATASET_API_v2;DATASET_PUBLICATION_API_v2La prima fornisce l’accesso canonico ai dati, la seconda gestisce la pubblicazione numerica. Dichiararle consente al Runner di verificarne la disponibilità prima del calcolo.
3. Script GNU Octave completo
Il programma impiega il Bridge pubblico GX-TXT, senza aprire file locali né usare comandi privati del framework. Copiare il codice nell’editor; i commenti sono in inglese.
% Five-point voltage calibration using only public GX-TXT Script Bridge APIs.
% The input Dataset is selected by the user in Script Runner; no file paths.
gxtxt_parameter_declare('gain', 'double', 'default', 1.0, ...
                        'min', 0.5, 'max', 2.5, ...
                        'description', 'Dimensionless voltage calibration gain');
ctx = gxtxt_context();
gxtxt_api_require('CANONICAL_DATASET_API_v2');
gxtxt_api_require('DATASET_PUBLICATION_API_v2');
if (!isfield(ctx.inputs, 'measured'))
  error('Select the canonical Dataset using Runner input alias measured');
endif
source_id = ctx.inputs.measured.dataset_id;
if (!strcmp(source_id, 'w02_raw_voltage'))
  error('The reviewed input Dataset is not the expected synthetic measurement');
endif
if (!gxtxt_api_has_operation('CANONICAL_DATASET_API_v2', 'read_range') || ...
    !gxtxt_api_has_operation('DATASET_PUBLICATION_API_v2', 'publish_series'))
  error('The installed public Script Bridge lacks the required operations');
endif
source_metadata = gxtxt_api_call('CANONICAL_DATASET_API_v2', 'describe', {source_id});
blocks = gxtxt_api_call('CANONICAL_DATASET_API_v2', 'read_range', ...
                        {source_id, {'time_s', 'voltage_V'}, 0, 5});
time_s = double(blocks.time_s.values(:));
voltage_V = double(blocks.voltage_V.values(:));
if (numel(time_s) != 5 || numel(voltage_V) != 5 || ...
    any(!isfinite(time_s)) || any(!isfinite(voltage_V)))
  error('Input must contain exactly five finite time/voltage samples');
endif
assert(all(abs(time_s - [0; 1; 2; 3; 4]) < 1e-10));
assert(all(abs(voltage_V - [0.12; 0.185; 0.25; 0.315; 0.38]) < 1e-10));
gain = ctx.parameters.gain;
corrected_V = gain .* voltage_V;
assert(all(isfinite(corrected_V)));
request = struct('dataset_id', 'w02_gain_corrected_voltage', ...
                 'contract', 'table.generic', 'storage', 'csv', ...
                 'x_values', time_s, 'y_values', corrected_V, ...
                 'x_variable', struct('variable_id', 'time_s', ...
                                      'name', 'Elapsed time', 'unit', 's', ...
                                      'semantic_role', 'time'), ...
                 'y_variable', struct('variable_id', 'corrected_V', ...
                                      'name', 'Corrected voltage', 'unit', 'V', ...
                                      'semantic_role', 'voltage'), ...
                 'notes', 'Five synthetic input voltages scaled by a reviewed gain');
request.source_dataset_ids = {source_id};
request.source_variable_ids = {'time_s', 'voltage_V'};
request.source = source_id;
request.provenance = 'Gain-adjusted synthetic voltage from verified canonical input';
published = gxtxt_api_call('DATASET_PUBLICATION_API_v2', 'publish_series', {request});
fprintf('W02_INPUT_DATASET=%s\n', source_id);
fprintf('W02_GAIN=%.2f\n', gain);
fprintf('W02_POINT_COUNT=%d\n', numel(time_s));
for k = 1:numel(time_s)
  fprintf('W02_ROW=%d t=%.1f raw=%.3f corrected=%.3f\n', ...
          k, time_s(k), voltage_V(k), corrected_V(k));
endfor
disp('W02_PUBLICATION_COMPLETE');
disp(published);
Nella prima parte lo script verifica il Dataset selezionato, la disponibilità delle API e il contenuto numerico. Nella seconda parte calcola il risultato, lo pubblica e stampa un riepilogo di cinque righe. Gli identificativi usati nel codice devono corrispondere a quelli effettivamente registrati nella Session.
4. Il parametro dichiarato e il contesto di esecuzione
gxtxt_parameter_declare dichiara un parametro chiamato gain, di tipo double, con valore predefinito 1,0, minimo 0,5 e massimo 2,5. La dichiarazione è riconosciuta quando il sorgente viene registrato; non avvia un Job.
gxtxt_context() restituisce il contesto della specifica esecuzione. Da ctx.parameters.gain si ottiene il valore convalidato dall’utente; da ctx.inputs.measured.dataset_id si ottiene l’identificativo del Dataset associato all’alias semantico measured.
Lo script non deve costruire il percorso fisico del Dataset: il Runner fornisce un riferimento logico, controllato nella Session corrente.
5. Scoprire le operazioni pubbliche e leggere i dati
gxtxt_api_require richiede le due API prima di procedere. Con gxtxt_api_has_operation si controlla che siano disponibili precisamente le operazioni read_range e publish_series. Un’operazione mancante produce un errore riconoscibile, non un risultato vuoto da interpretare arbitrariamente.
La funzione generale gxtxt_api_call(api_id, operation, args) invia una chiamata a un servizio pubblico registrato. Gli argomenti di ciascuna operazione sono passati in una cell array Octave; l’API destinataria determina i tipi ammessi e la struttura del risultato.
Il comando describe restituisce i metadati del Dataset selezionato. Per leggere i cinque valori si utilizza:
blocks = gxtxt_api_call('CANONICAL_DATASET_API_v2', 'read_range', ...
                        {source_id, {'time_s', 'voltage_V'}, 0, 5});
time_s = double(blocks.time_s.values(:));
voltage_V = double(blocks.voltage_V.values(:));
L’intervallo parte dalla riga 0 (indice a base zero) e richiede 5 campioni. La risposta è una struttura indicizzata dagli ID stabili delle variabili; i singoli blocchi contengono valori tipizzati e metadati di lettura. L’operazione .values(:) trasforma i dati numerici nei vettori colonna usati da Octave.
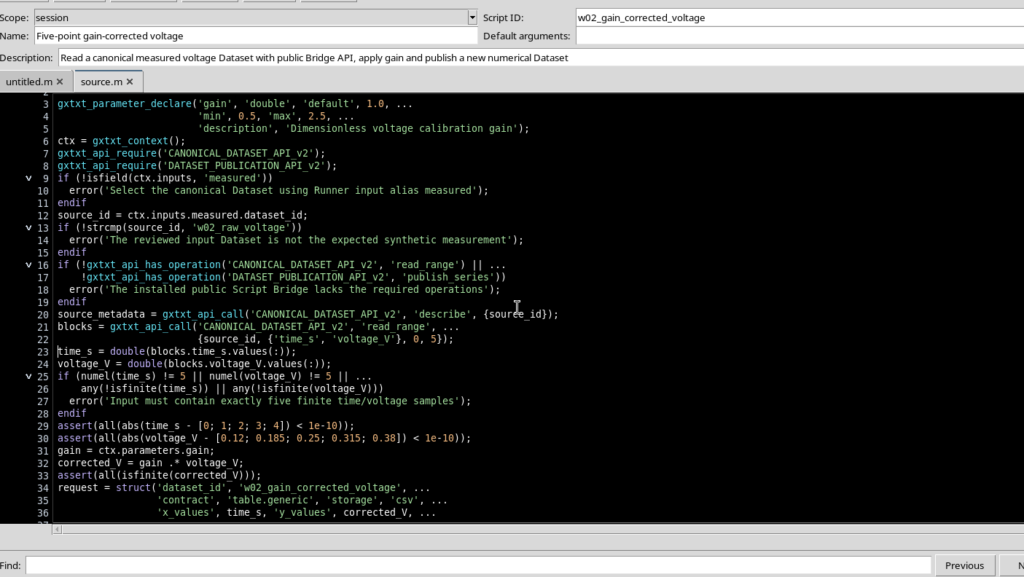
Le istruzioni assert controllano i cinque valori di questo esercizio: per misure sperimentali reali, i criteri devono essere adattati al Dataset effettivo.
6. Aprire Script Runner e scegliere il guadagno
Dopo aver salvato il sorgente, utilizzare Run → Open Script Runner…. Il Runner mostra lo script, le API richieste e il parametro tipizzato gain (double) con valore iniziale 1.0.
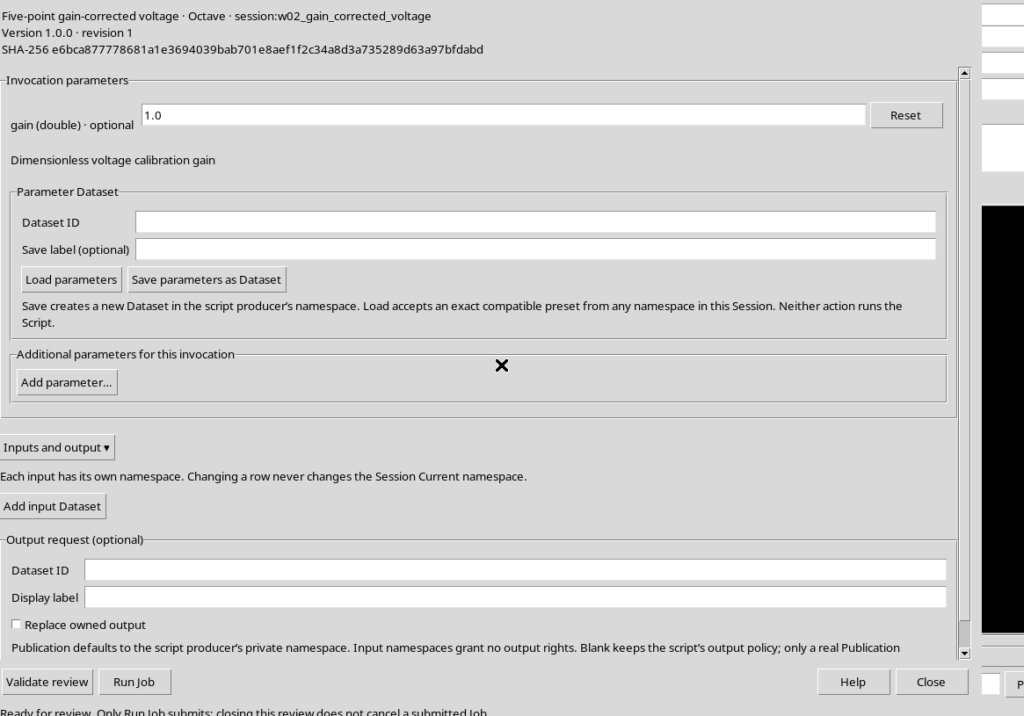
Impostare gain = 1.6. Questa modifica riguarda la singola invocazione scientifica e non altera la revisione del sorgente nel Registry.
7. Collegare l’input measured e identificare l’output
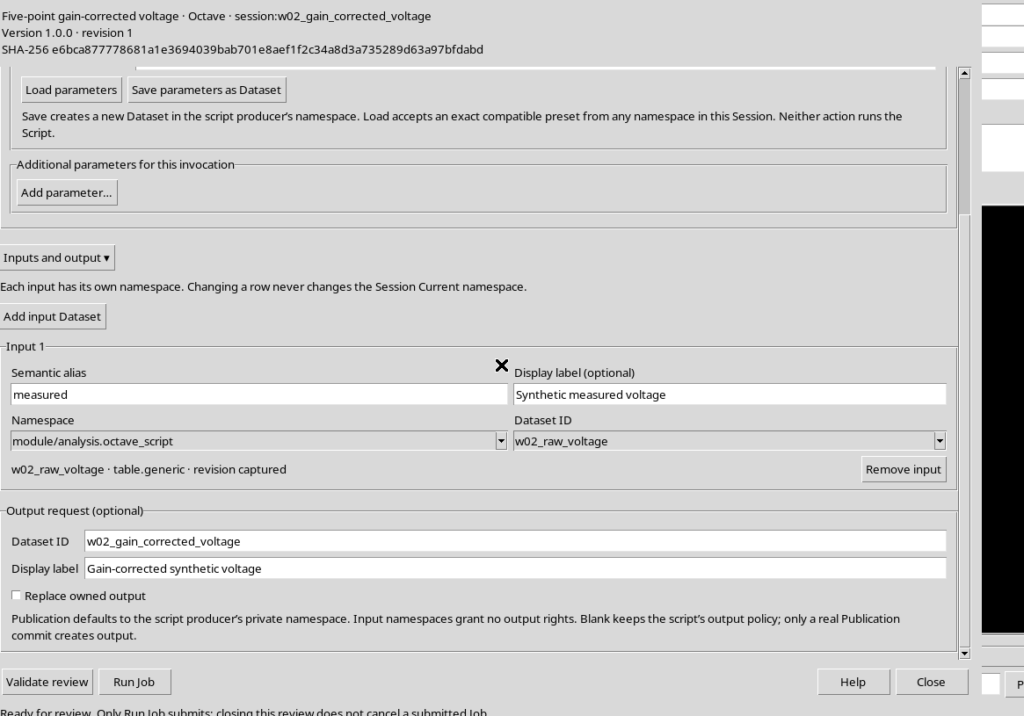
Aprire Inputs and output e scegliere Add input Dataset. Configurare i tre controlli:
- Semantic alias: measured
- Namespace: module/analysis.octave_script
- Dataset ID: w02_raw_voltage
La Namespace non è un dettaglio decorativo. Il Dataset utilizzato nell’esempio appartiene allo spazio del modulo produttore, quindi potrebbe non apparire scegliendo base.
Nella sezione Output request (optional) indicare Dataset ID: w02_gain_corrected_voltage, inserire un’etichetta descrittiva e lasciare disattivato Replace owned output. La sola compilazione del campo non pubblica alcun risultato.
8. Validare la richiesta senza eseguirla
Premere Validate review. Con l’alias, la revisione dell’input, le API e il parametro coerenti, il Runner risponde:
Review valid. No Job submitted; Run Job performs fresh admission checks.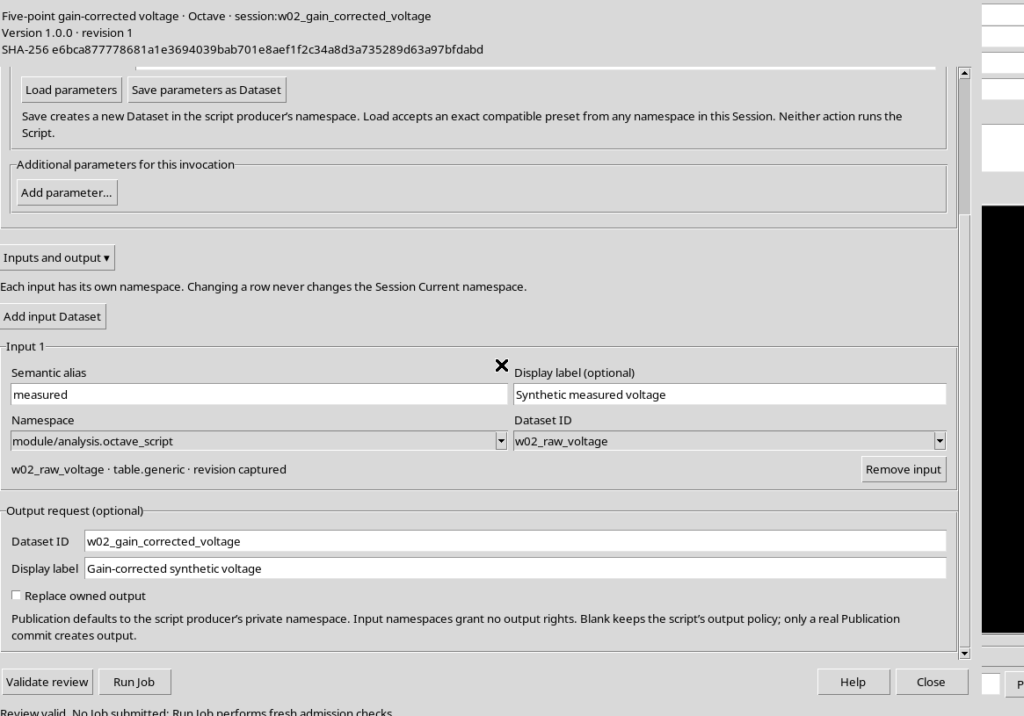
La revisione del Dataset d’ingresso è registrata nella richiesta. Il controllo serve a evitare che una sostituzione non prevista dell’input passi inosservata fra la scelta dei dati e l’esecuzione.
9. Avviare GNU Octave ed esaminare lo stato del Job
Premere Run Job una sola volta. GX-TXT esegue la revisione registrata dello script, fornendole l’alias measured e gain = 1.6.
In Run → Script Jobs Manager… il Job diventa COMPLETED dopo il calcolo. In caso di FAILED, consultare i dettagli del Job prima di tentare una nuova esecuzione.
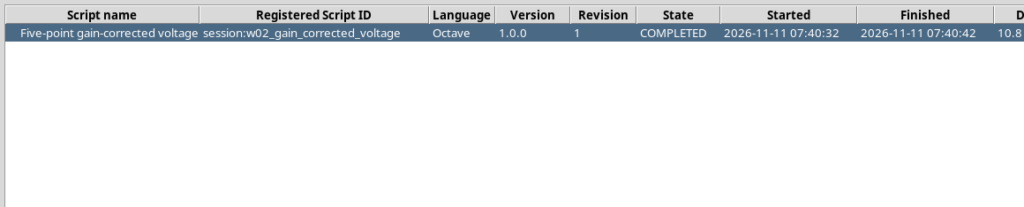
Un Job conserva la revisione eseguita, il proprio stato e i flussi di output: non va confuso con un Dataset pubblicato.
10. Leggere i risultati da Program output
Scegliere Jobs → Open execution details, quindi Program output. Le righe principali prodotte realmente dallo script sono:
W02_INPUT_DATASET=w02_raw_voltage
W02_GAIN=1.60
W02_POINT_COUNT=5
W02_ROW=1 t=0.0 raw=0.120 corrected=0.192
W02_ROW=2 t=1.0 raw=0.185 corrected=0.296
W02_ROW=3 t=2.0 raw=0.250 corrected=0.400
W02_ROW=4 t=3.0 raw=0.315 corrected=0.504
W02_ROW=5 t=4.0 raw=0.380 corrected=0.608
W02_PUBLICATION_COMPLETE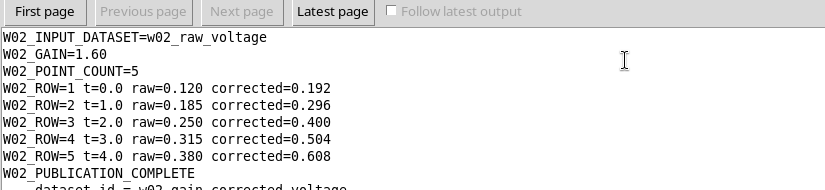
Questo testo è un resoconto dell’esecuzione. La pubblicazione numerica richiede una chiamata separata alle API: scrivere numeri su stdout non basta a creare un Dataset canonico.
11. Pubblicare una nuova serie numerica
Lo script prepara una struttura di richiesta contenente dataset_id, contract: table.generic, storage: csv, i vettori x_values e y_values e i descrittori delle variabili.
L’operazione effettiva di pubblicazione è:
published = gxtxt_api_call('DATASET_PUBLICATION_API_v2', ...
                           'publish_series', {request});
Sono dichiarate due variabili di output: time_s con unità s e corrected_V con unità V. La richiesta registra anche source_dataset_ids e source_variable_ids, affinché il nuovo Dataset conservi una relazione esplicita con i valori originali.
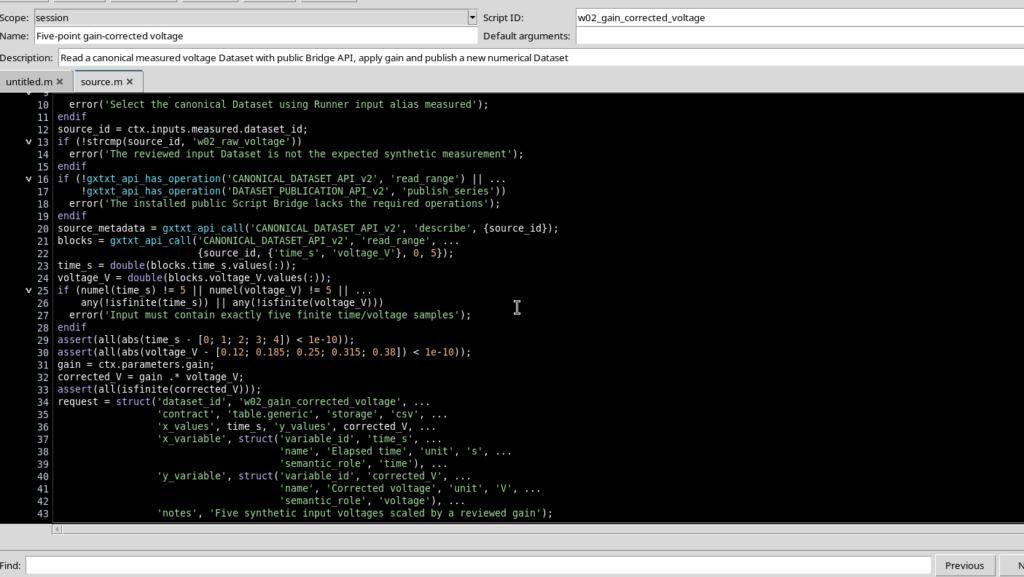
Il nuovo Dataset è distinto dall’input. Non vengono modificati i valori iniziali né scritti manualmente file o Registry interni.
12. Confrontare la tabella canonica di uscita con l’ingresso
Il Dataset pubblicato w02_gain_corrected_voltage usa table.generic e formato CSV. La scheda di consultazione Canonical table mostra cinque righe con il tempo e la tensione corretta.
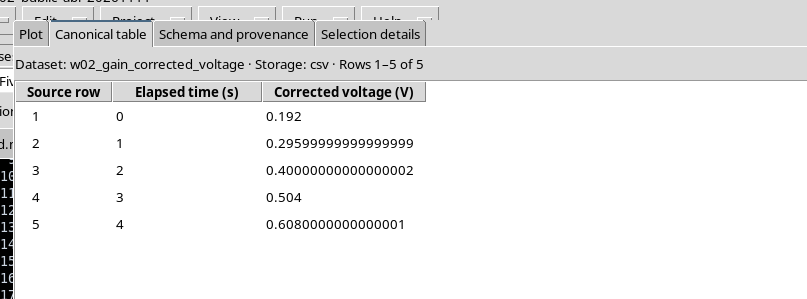
| Tempo (s) | Input (V) | Gain | Uscita (V) |
|---|---|---|---|
| 0 | 0,120 | 1,6 | 0,192 |
| 1 | 0,185 | 1,6 | 0,296 |
| 2 | 0,250 | 1,6 | 0,400 |
| 3 | 0,315 | 1,6 | 0,504 |
| 4 | 0,380 | 1,6 | 0,608 |
Nella visualizzazione dei numeri float64 possono comparire rappresentazioni come 0.29599999999999999 invece di 0.296. Sono differenze di rappresentazione binaria, non nuove misure: i confronti si effettuano con un’adeguata tolleranza.
13. Verificare schema e provenienza scientifica
La scheda Schema and provenance descrive le variabili pubblicate, compresi tipo, unità di misura e ruolo semantico. Per questo esempio time_s è una coordinata in secondi e corrected_V rappresenta dati di tensione in volt.
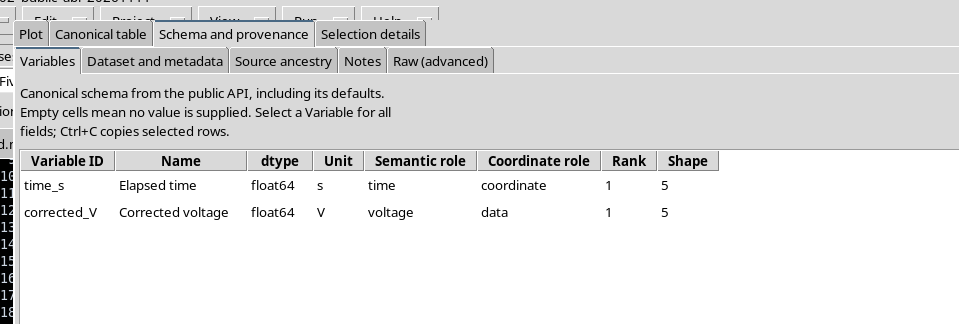
La provenienza registra w02_raw_voltage come Dataset sorgente, time_s e voltage_V come variabili di partenza e analysis.octave_script come produttore del nuovo risultato. Queste informazioni documentano il legame fra due Dataset senza attribuire falsamente un’origine strumentale ai dati sintetici.
14. Problemi frequenti e riepilogo
Se il Dataset non compare in Add input Dataset, controllare la Namespace, la Session attiva e l’identificativo. Se lo script segnala un input mancante, verificare che Semantic alias sia esattamente measured. Se Validate review rifiuta il guadagno, controllare il tipo double e i limiti della dichiarazione.
In caso di errore durante l’esecuzione consultare Program stderr e Diagnostic log. Se l’identificativo del Dataset d’uscita esiste già, non presumere che la nuova invocazione abbia il permesso di sovrascriverlo: un nuovo risultato deve essere pubblicato con un’identità disponibile oppure con una procedura di sostituzione esplicitamente autorizzata.
Il workflow completo collega Dataset canonico → input del Runner → parametro tipizzato → read_range → calcolo Octave → publish_series → nuovo Dataset canonico. L’uso delle API pubbliche separa il calcolo scientifico dai dettagli fisici dello storage e permette di controllare identità, revisioni e provenienza dei risultati.