

Pubblicazione Dual-Y e Dataset Groups
Un grafico scientifico può contenere più grandezze dipendenti dalla stessa variabile X. In GX-TXT il Curve Digitalizer permette di associare curve diverse agli assi logici Y1 e Y2, senza confondere la loro identità con il lato sinistro o destro di un futuro grafico.
Questa guida spiega come digitalizzare due curve, pubblicarle quando hanno la stessa unità, separarle quando possiedono unità fisiche incompatibili, e collegare i risultati mediante un Dataset Group. L’esempio impiega un raster sintetico didattico, non osservazioni strumentali. La pubblicazione e il raggruppamento non costituiscono stime di accuratezza o incertezza.
1. Selezionare il raster originale
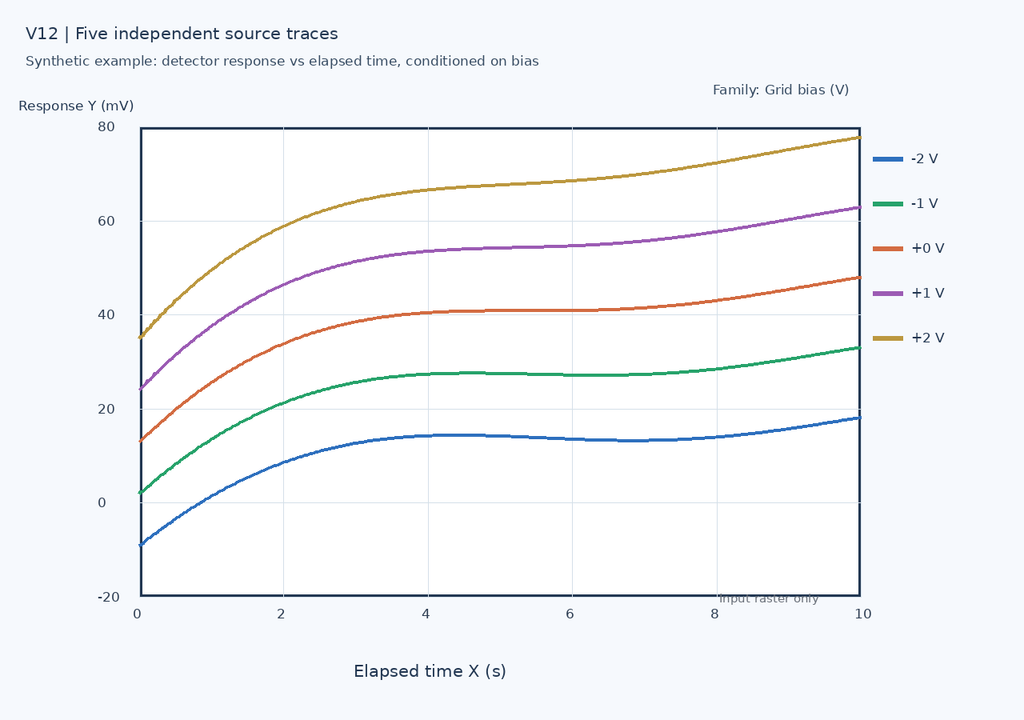
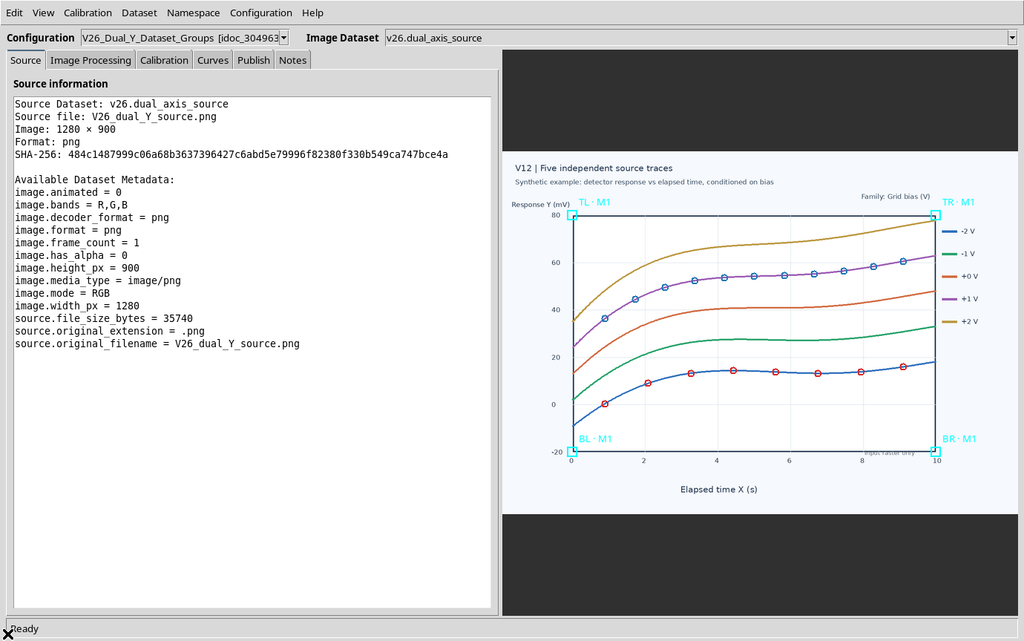
L’immagine contiene cinque tracce colorate. Utilizzeremo due tracciati per costruire due curve scientifiche, lasciando gli altri come elementi dell’immagine che non saranno digitalizzati.
La sorgente, con dimensioni 1280 × 900 pixel, è caricata nella scheda Source come Image Dataset originale.
2. Definire la calibrazione geometrica condivisa
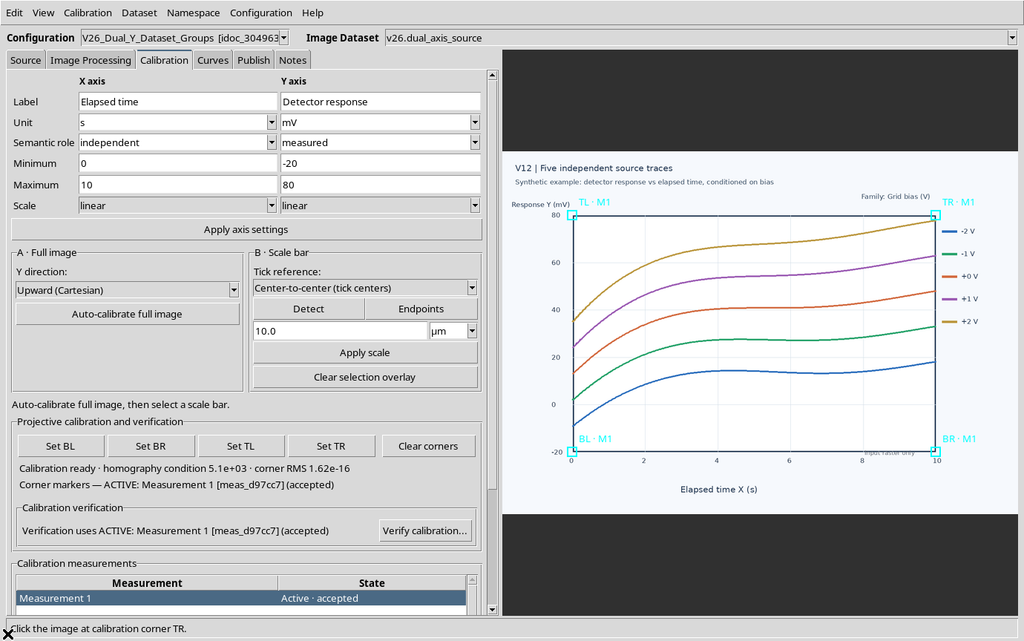
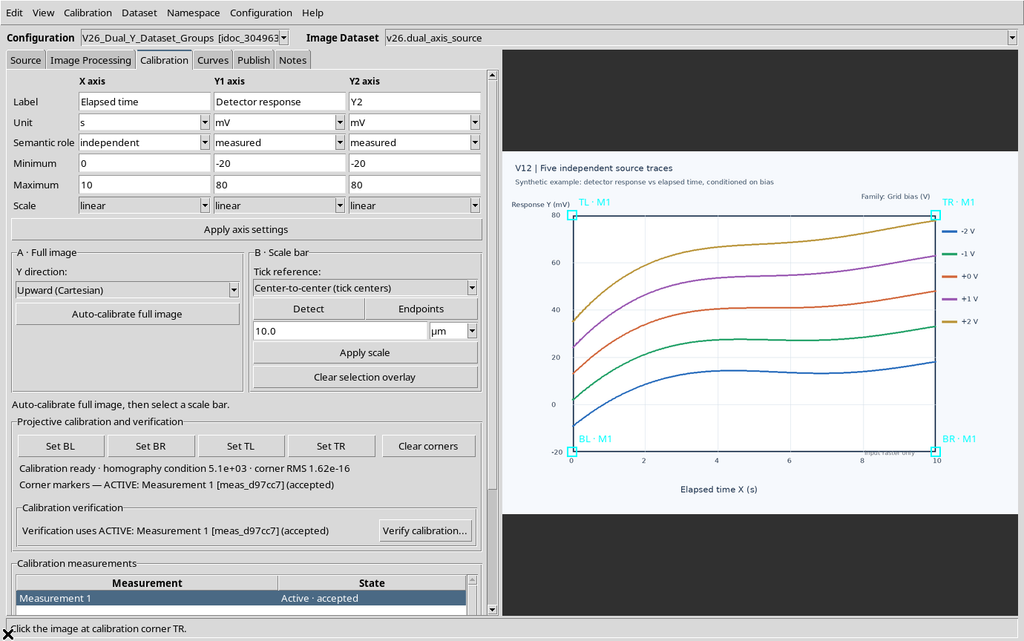
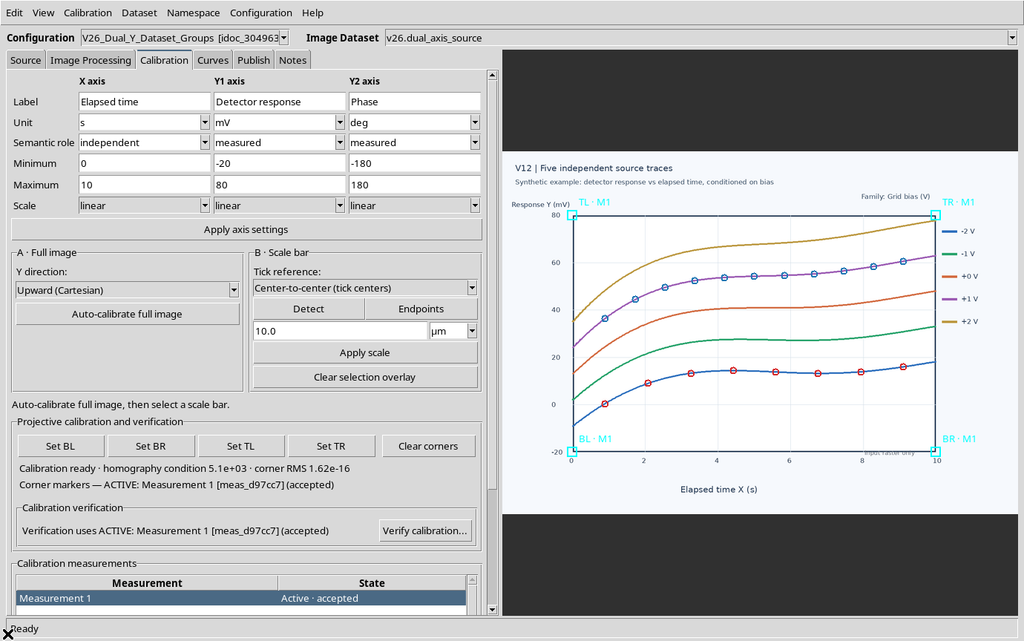
Nella scheda Calibration impostiamo X da 0 a 10 s e Y1 da −20 a 80 mV. Selezioniamo i quattro angoli della regione del grafico e accettiamo la calibrazione.
La corrispondenza geometrica fra pixel e piano normalizzato rimane unica per gli assi Y1 e Y2.
3. Abilitare il secondo asse
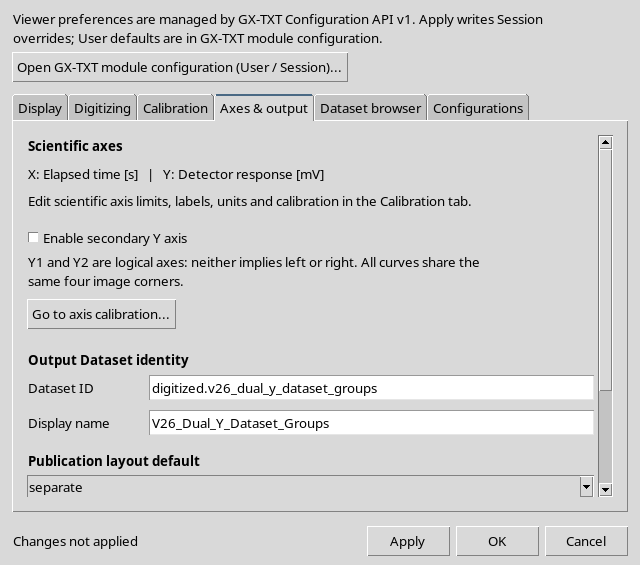
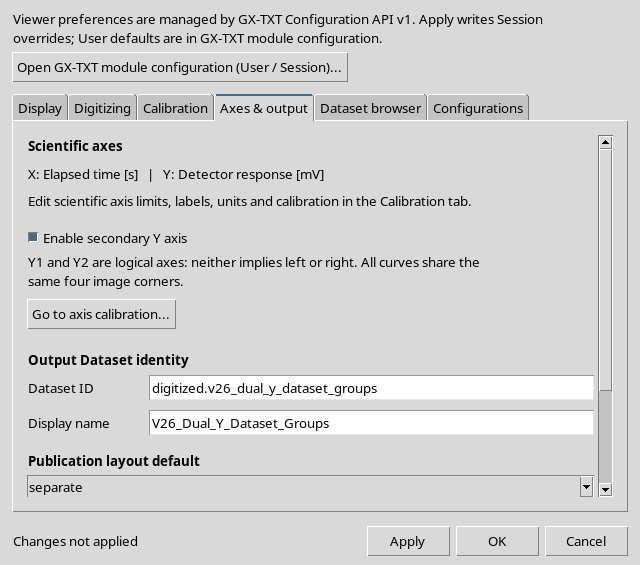
In Configuration → Viewer settings… → Axes & output, il checkbox Enable secondary Y axis permette di introdurre Y2 nella configurazione corrente.
Attiviamo il checkbox e premiamo Apply, poi OK. Questa operazione non aggiunge una nuova immagine né sposta i quattro angoli della calibrazione.
4. Dichiarare le grandezze X, Y1 e Y2
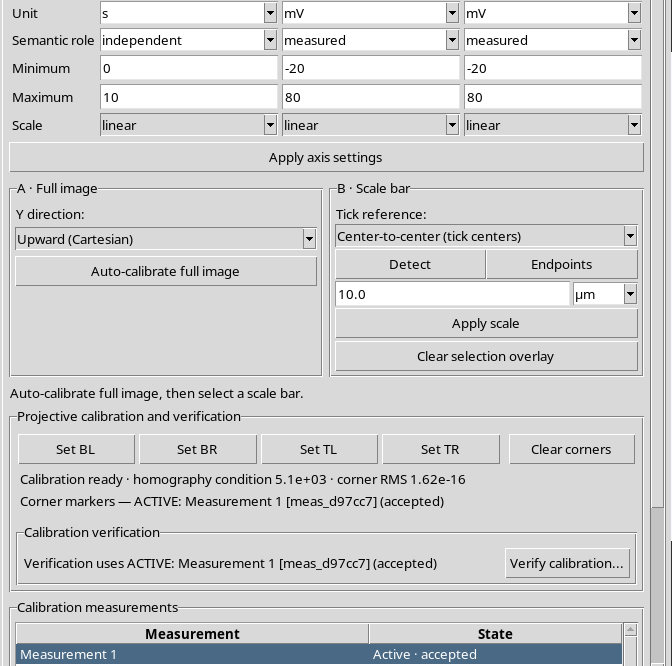
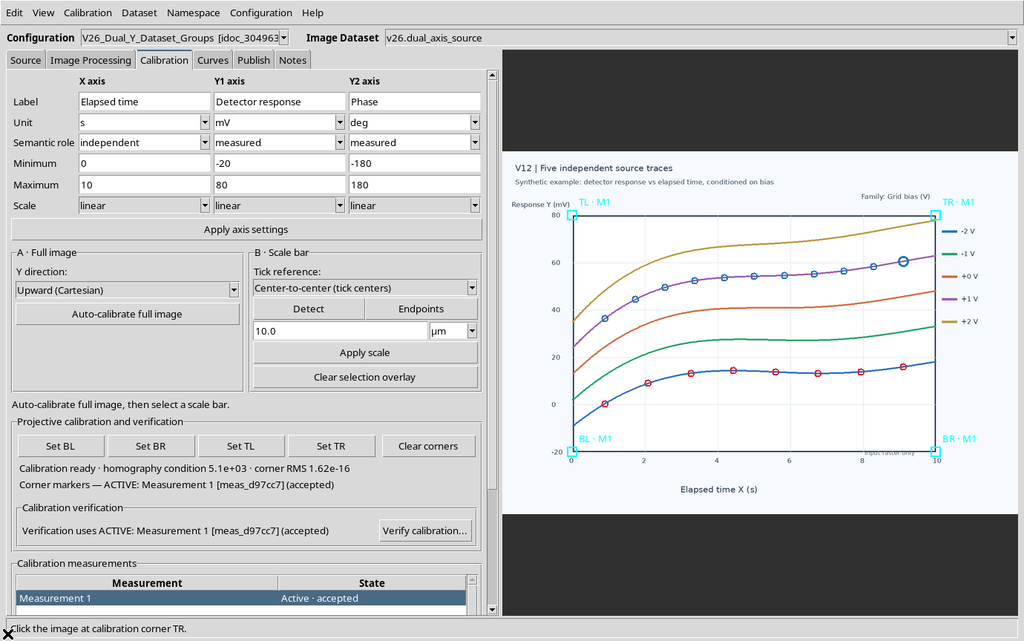
La scheda Calibration mostra ora tre colonne per il significato scientifico degli assi: X, Y1 e Y2.
Y1 e Y2 rappresentano variabili logiche distinte; nessuna delle due implica automaticamente una posizione a sinistra o a destra del grafico.
5. Creare la curva Y1
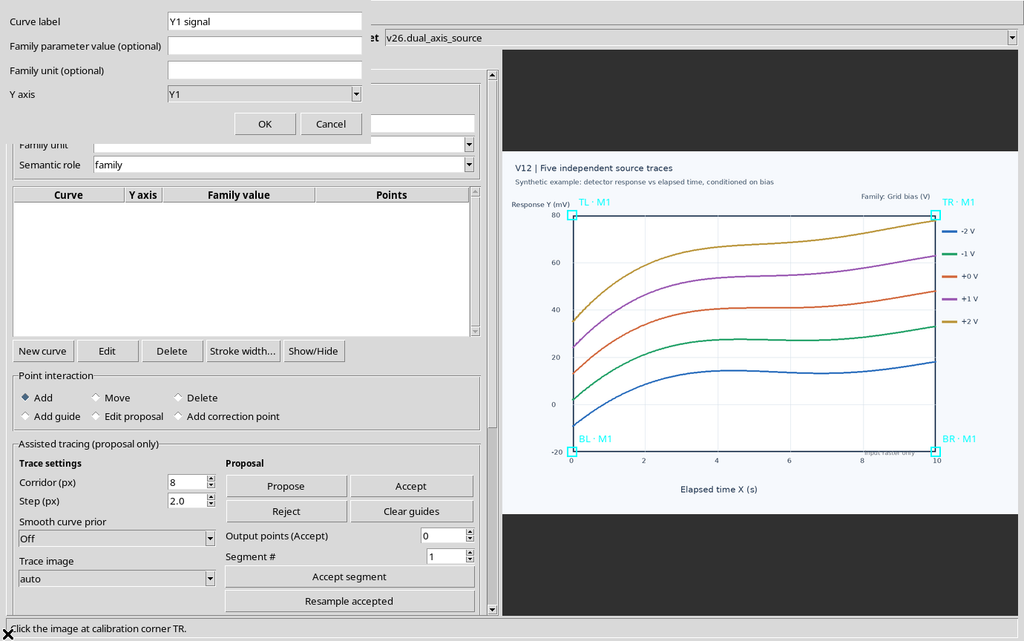
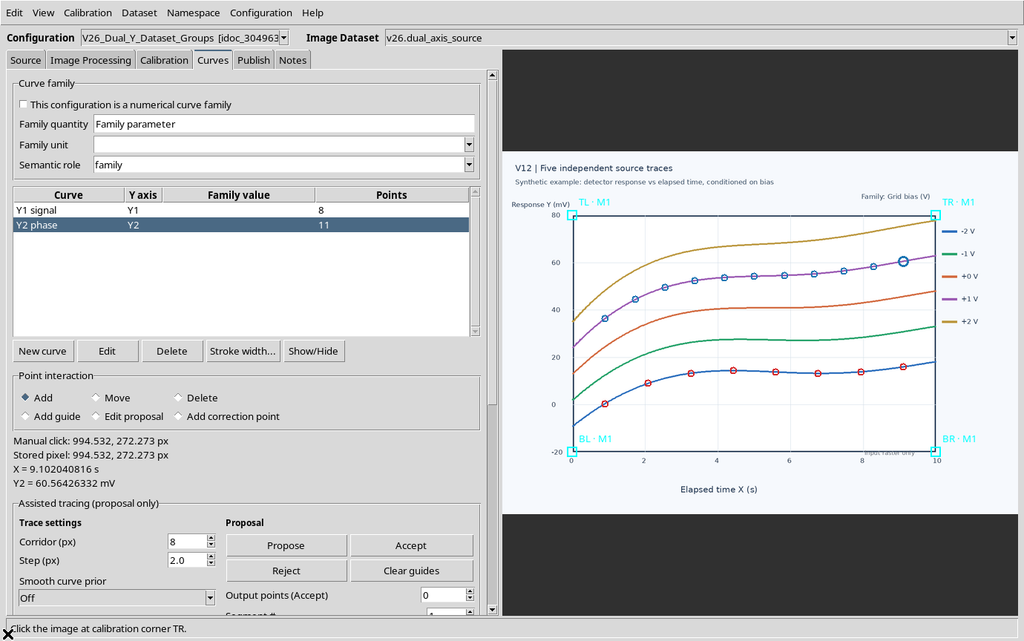
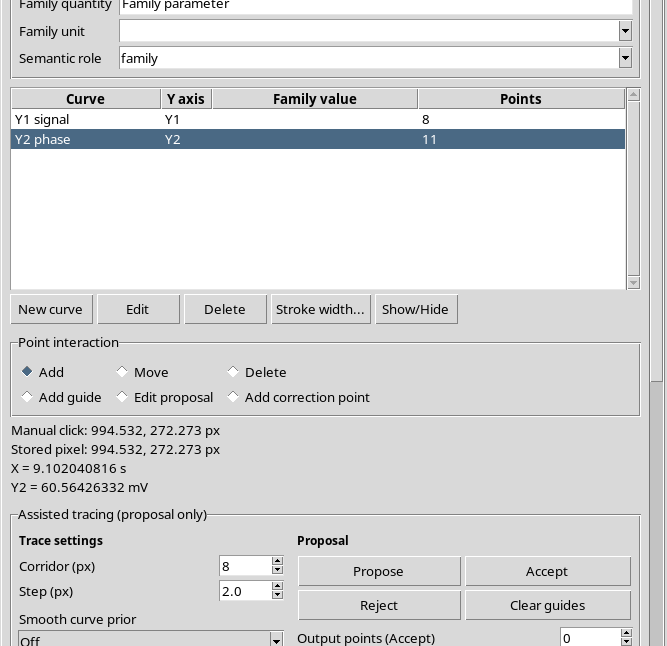
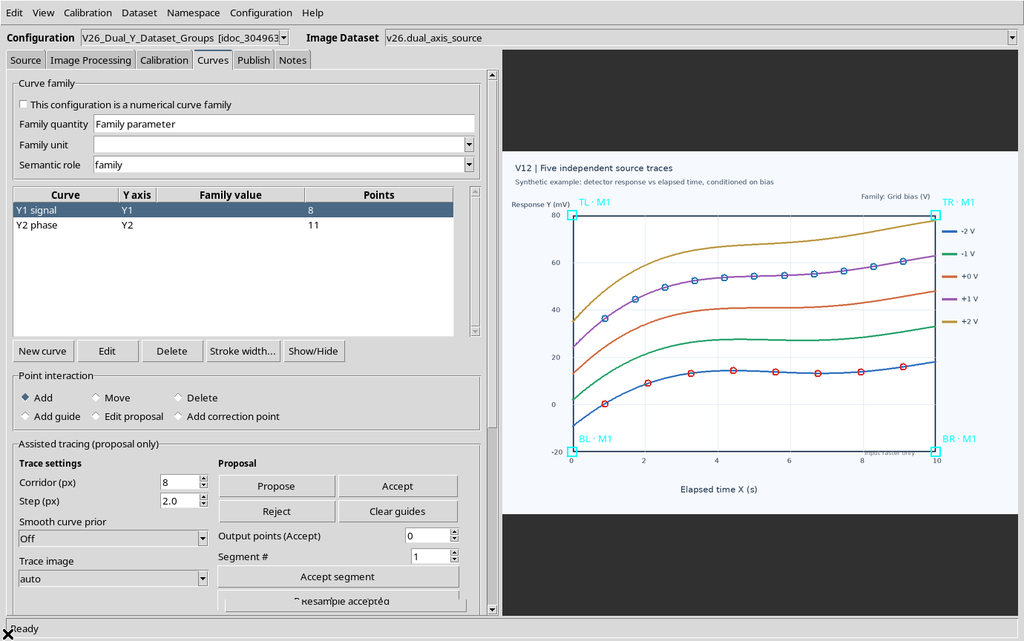
Nella scheda Curves premiamo New curve e inseriamo il nome Y1 signal. Nel campo Y axis scegliamo Y1.
L’ID scientifico della curva non è il suo nome visualizzato; rimarrà disponibile anche se l’etichetta dovesse cambiare.
6. Creare una curva associata a Y2
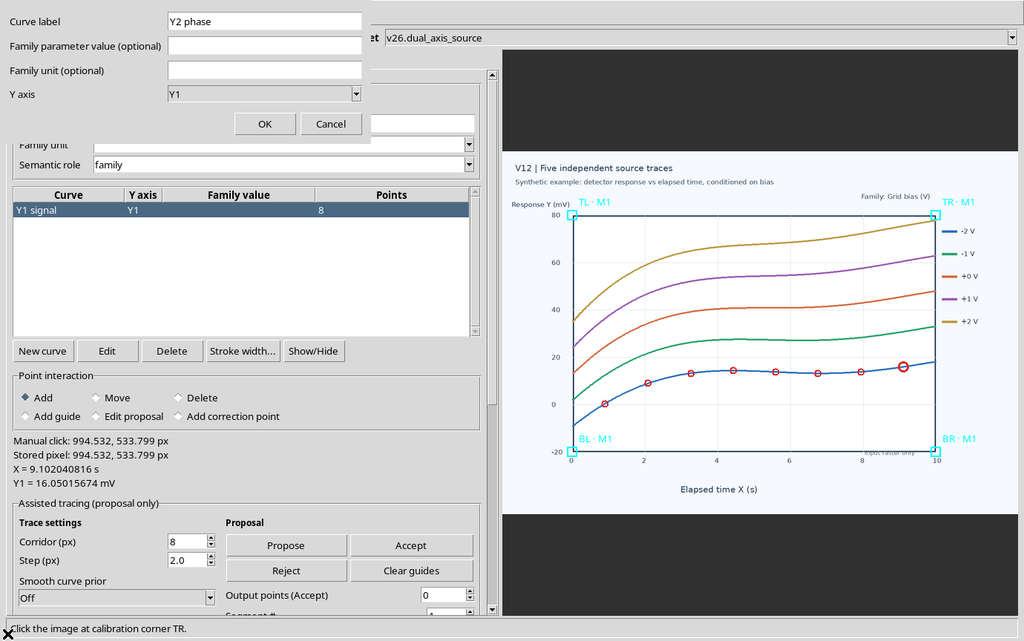
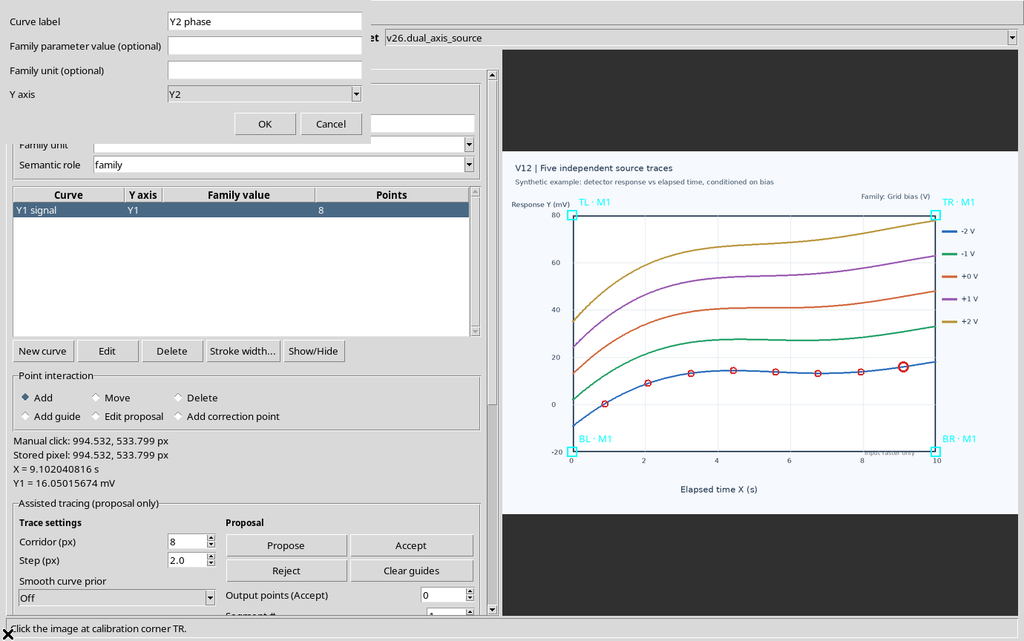
Creiamo una seconda serie denominata Y2 phase. Nel dialogo di creazione, il selettore Y axis offre le opzioni Y1 e Y2.
Scegliamo esplicitamente Y2 prima di confermare. Il colore del tratto non determina l’asse: è il collegamento registrato dalla GUI che costituisce la dichiarazione scientifica.
7. Acquisire punti diversi per le due serie
Usando Add, digitalizziamo 8 punti per Y1 e 11 per Y2, per un totale di 19 punti manuali.
Le due curve conservano quantità di punti differenti e identificativi originali distinti. Non occorre interpolare punti ulteriori per poterle pubblicare.
8. Tre identità fondamentali
Il risultato deve preservare tre concetti: curve_key, identificativo stabile della serie; y_axis_id, che dichiara Y1 oppure Y2; point_id, che identifica il punto originale. Il nome della curva è invece descrittivo.
L’ordine dei punti è espresso dal ruolo point_order, con origine zero all’interno di ogni curva. Il raggruppamento non va ricostruito dal colore della linea o da un ordinamento globale per X.
Per ricostruire correttamente il risultato, leggere curve_key e y_axis_id come informazioni distinte: la prima identifica la serie, il secondo indica quale asse scientifico interpretarne i valori Y. point_id permette invece di riconoscere la posizione acquisita sul raster. Nel nostro esempio gli ordini interni sono da 0 a 7 per Y1 e da 0 a 10 per Y2: non costituiscono un’unica sequenza di diciannove campioni.
9. Caso con unità uguali
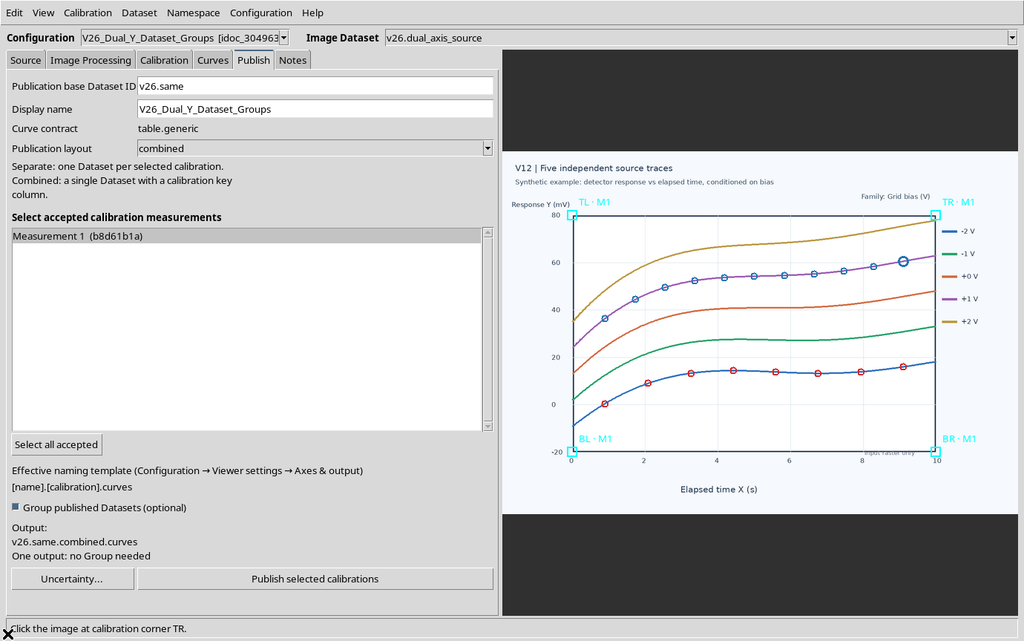
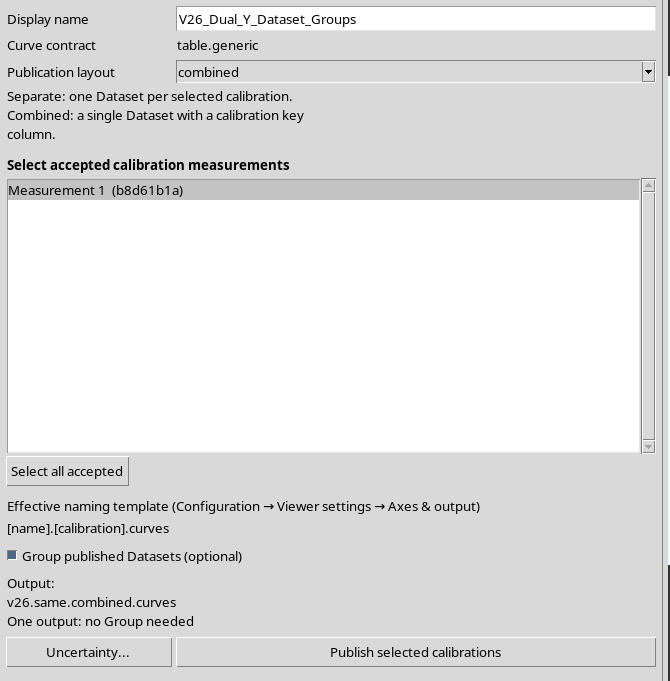
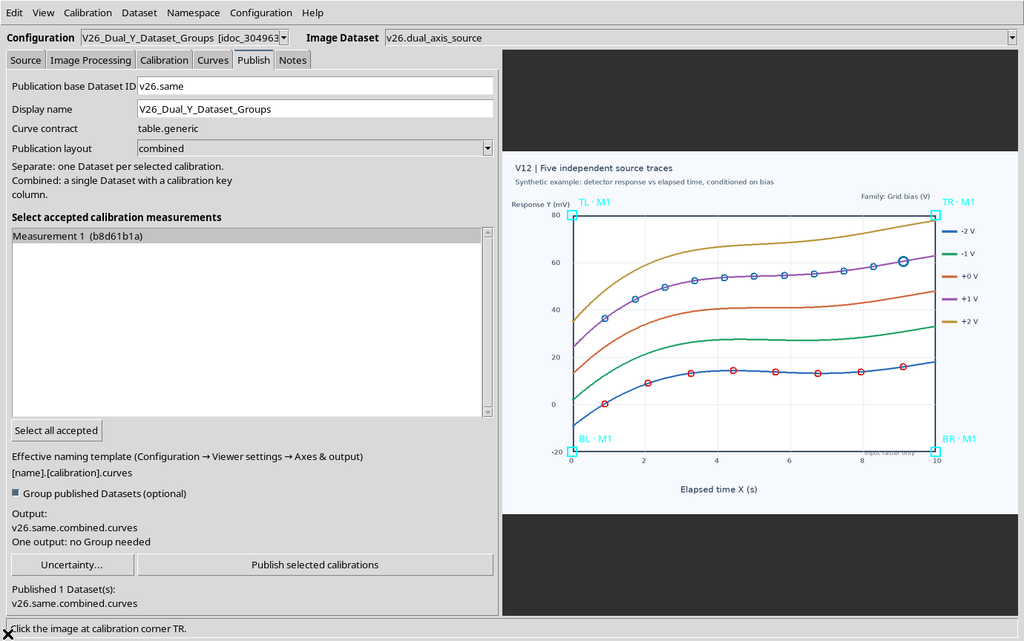
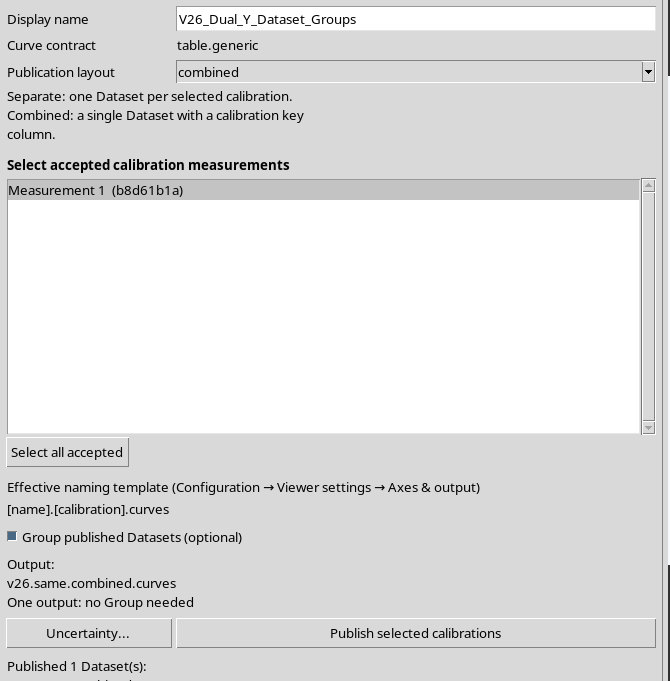
Inizialmente Y1 e Y2 sono dichiarate entrambe in mV. Nella scheda Publish scegliamo Combined con una sola calibrazione accettata.
La GUI prevede un solo Dataset mixed. Le due serie possono condividere una colonna Y perché tutte le righe dichiarano la medesima unità fisica.
10. Pubblicare il Dataset mixed
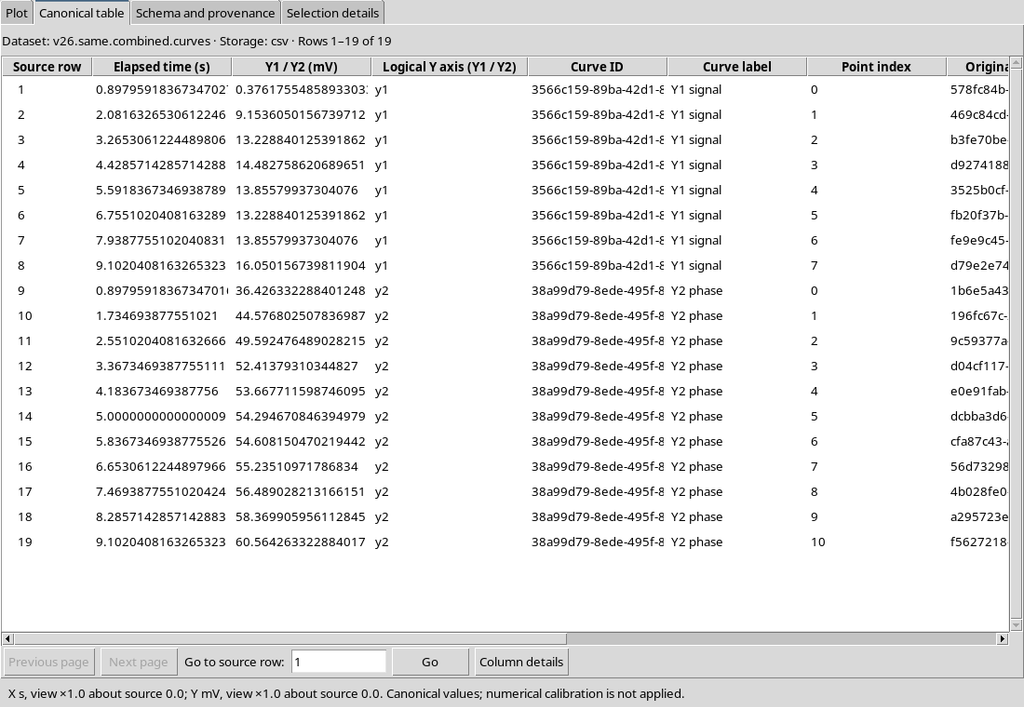
Premiamo Publish selected calibrations. Il risultato è un Dataset canonico table.generic di 19 righe.
La colonna y_axis_id distingue le 8 righe Y1 dalle 11 righe Y2; il punto e la curva mantengono le loro identità originali.
11. Group selezionato ma un solo output
Il checkbox Group published Datasets (optional) non impone la creazione di un Group quando il piano produce un solo Dataset.
Un Dataset Group serve a collegare più Dataset canonici esistenti. Con una tabella omogenea già completa non è necessario un contenitore aggiuntivo.
La scelta del checkbox riguarda l’eventuale raggruppamento degli output, non il numero delle curve presenti nel documento. Quando le unità coincidono, Y1 e Y2 sono conservate nel medesimo Dataset di 19 righe: y_axis_id identifica a quale asse appartiene ciascuna riga. Si verifica il risultato nel messaggio di Publish e nel catalogo CORE: un unico Dataset non richiede un Group con due membri.
12. Cambiare l’unità scientifica di Y2
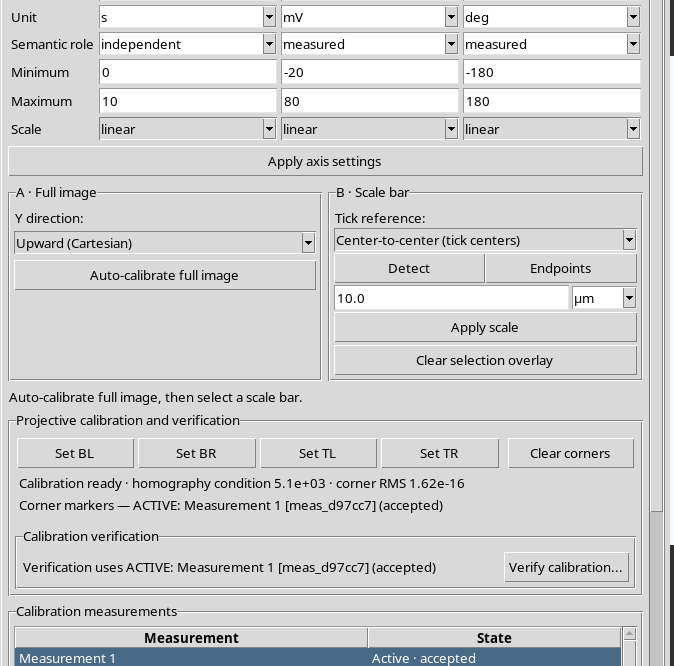
Nel secondo scenario impostiamo Y2 come Phase, con unità deg, minimo −180, massimo 180 e scala lineare.
Y1 resta espressa in mV. Dopo Apply axis settings il documento ha due grandezze Y fisicamente differenti.
13. I punti originali non si spostano
La nuova dichiarazione Y2 cambia il mapping delle coordinate scientifiche della seconda curva, non i suoi point_id o le posizioni pixel originali.
Le coordinate dei punti Y1 rimangono invariate. Una variazione di unità e limiti è una nuova interpretazione scientifica, non una conversione automatica dell’unità di Y1: deve essere giustificata dal grafico che si sta studiando.
Per controllare la modifica, confrontare separatamente coordinate raster e coordinate scientifiche. I pixel e i point_id di Y2 rappresentano sempre gli undici clic originari, mentre i valori numerici Y seguono ora la scala Phase da −180 a 180 gradi. Gli otto punti di Y1 continuano a essere interpretati in millivolt. Non si tratta di convertire millivolt in gradi: cambia la grandezza scientifica associata al secondo tracciato.
14. Anteprima con due unità incompatibili
Anche mantenendo Combined come layout di calibrazione, la pubblicazione produce due Dataset quando le unità Y sono incompatibili.
L’anteprima distingue i risultati con i suffissi y1 e y2. Un’unica colonna numerica Y non può contemporaneamente dichiarare millivolt e gradi.
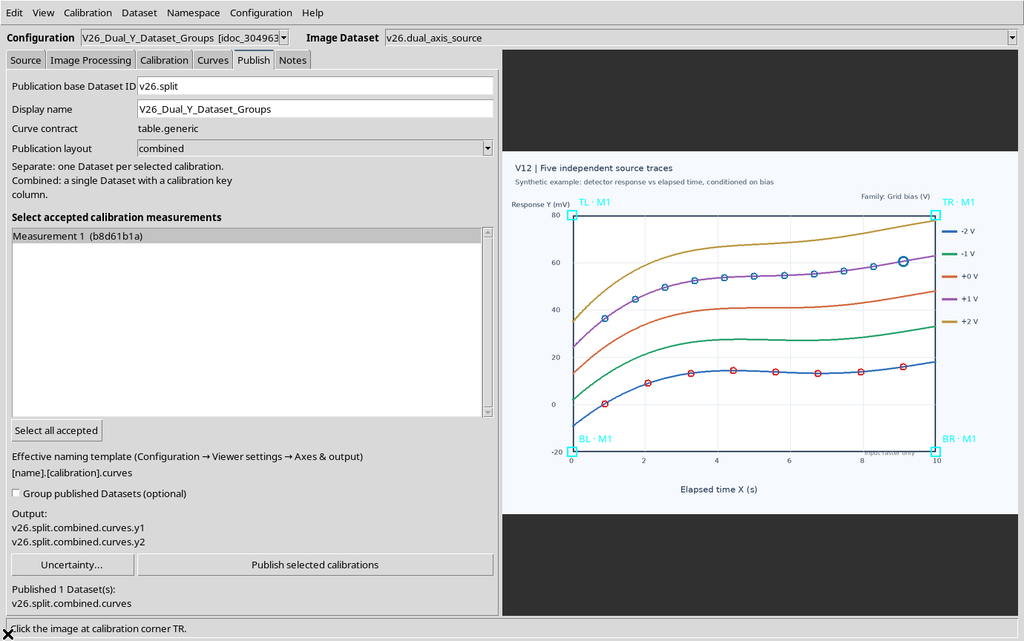
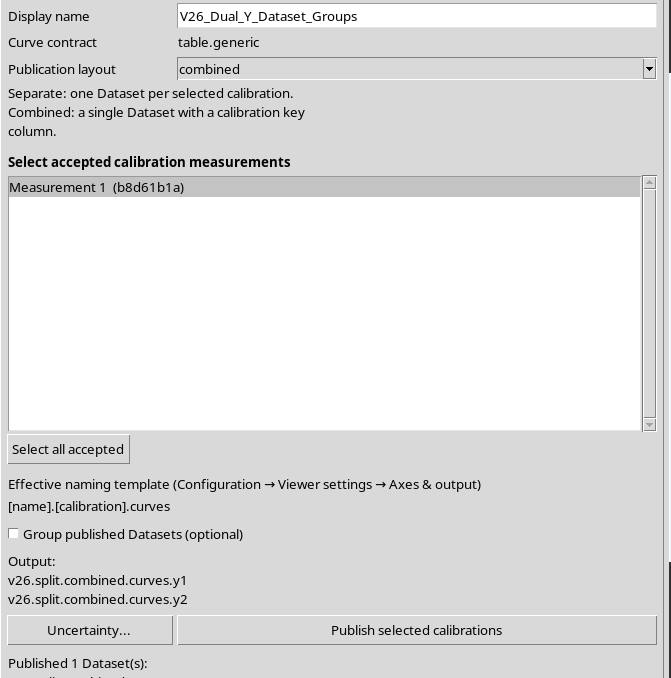
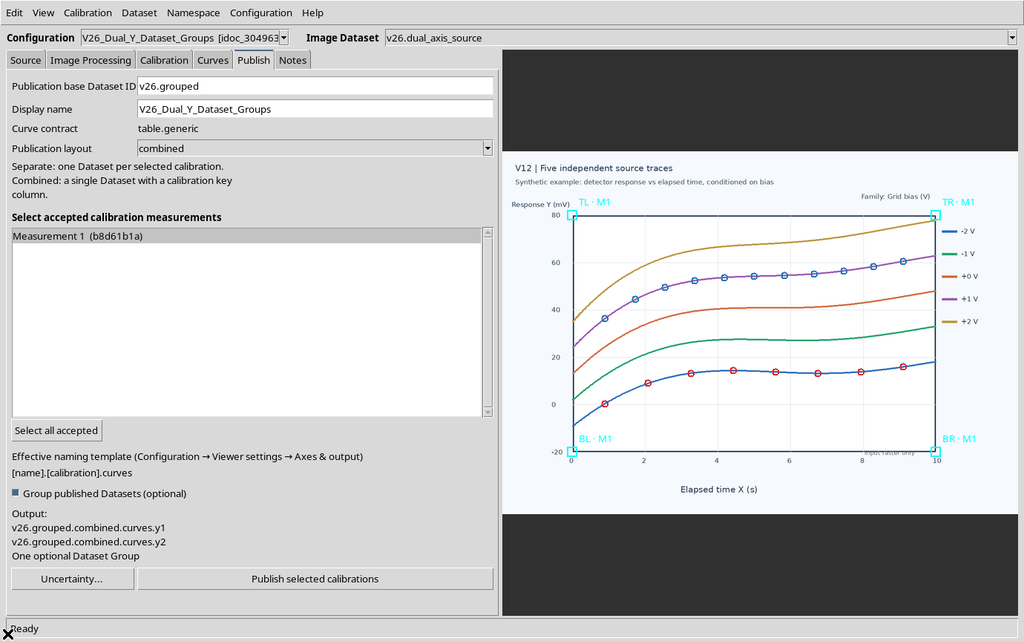
15. Pubblicare i due risultati senza Group
Disabilitiamo temporaneamente Group published Datasets e pubblichiamo.
Il risultato comprende un Dataset con 8 righe Y1 in mV e un altro con 11 righe Y2 in deg. Entrambi sono disponibili nel catalogo della Session.
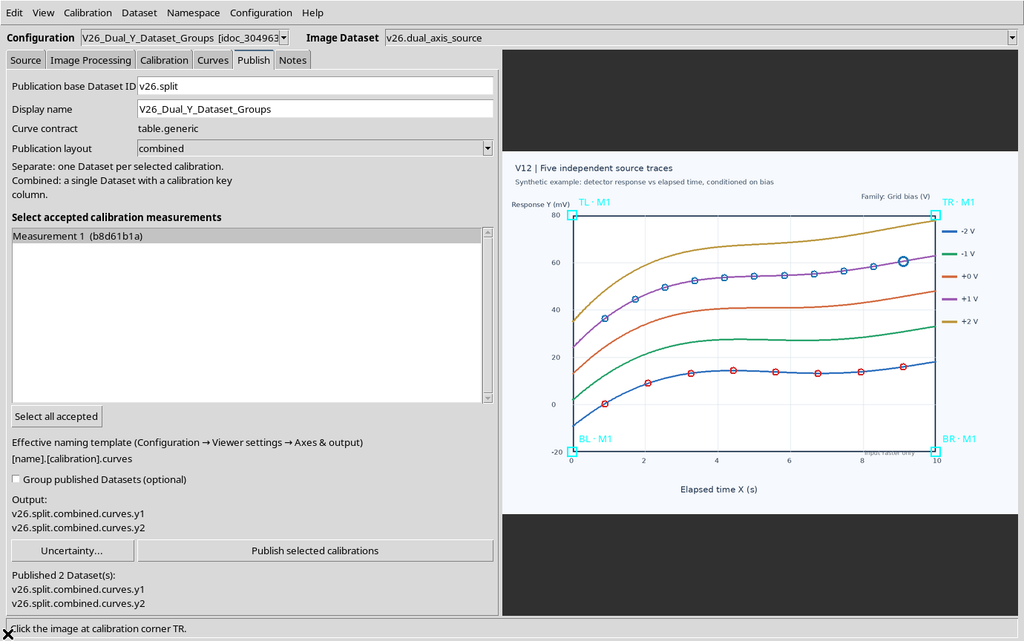
16. Cosa significa Separate per unità
Il frazionamento per unità non perde dati e non cambia i pixel. Le due tabelle contengono complessivamente ancora 19 punti.
Il layout Combined/Separate riguarda il trattamento delle realizzazioni di calibrazione; la separazione per Y1/Y2 è inoltre vincolata alla compatibilità delle unità fisiche pubblicate nel Variable Schema v3.
La suddivisione in due tabelle è imposta dalla non omogeneità delle unità Y: una colonna numerica canonica non deve rappresentare contemporaneamente mV e deg. Perciò si ottengono un Dataset Y1 con otto righe e un Dataset Y2 con undici righe, ognuno con il proprio schema di variabili. Questo criterio è distinto dalla scelta Separate o Combined relativa alle calibrazioni. Entrambi i risultati restano collegati alla stessa sorgente e conservano i rispettivi punti originali.
17. Abilitare il Dataset Group
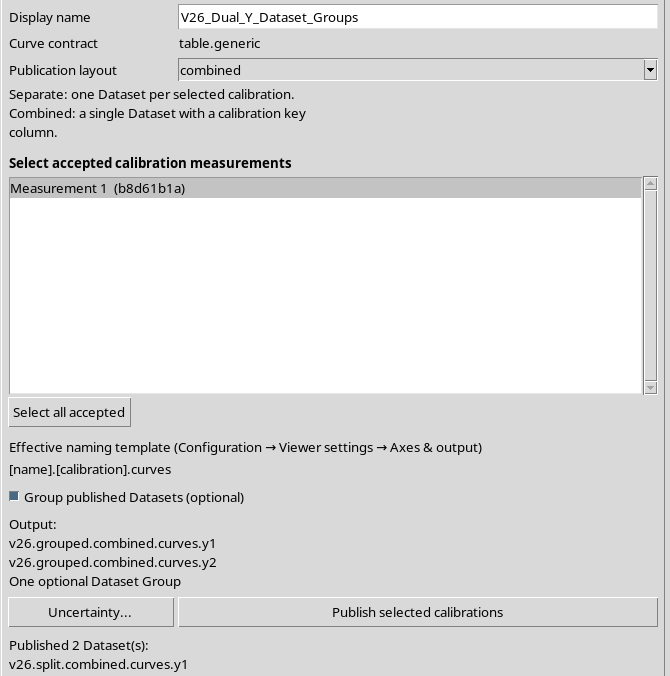
Per collegare i due output, attiviamo Group published Datasets (optional) nella scheda Publish.
L’anteprima mostra due Dataset scientifici e un Group opzionale. La selezione del checkbox non crea un’ulteriore colonna numerica e non converte i gradi in millivolt.
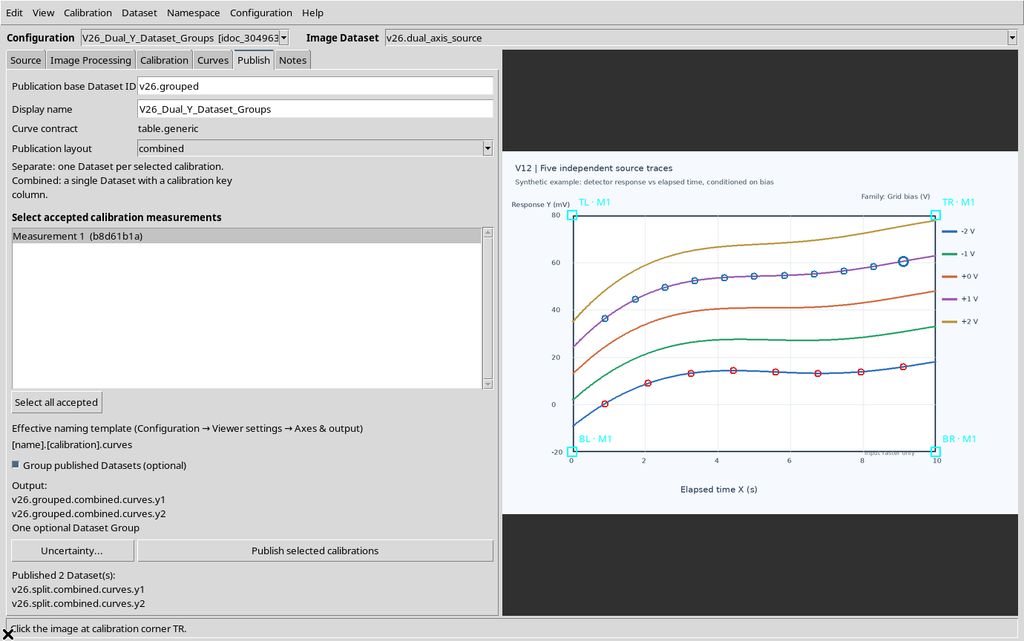
18. Creare il Group dalla GUI
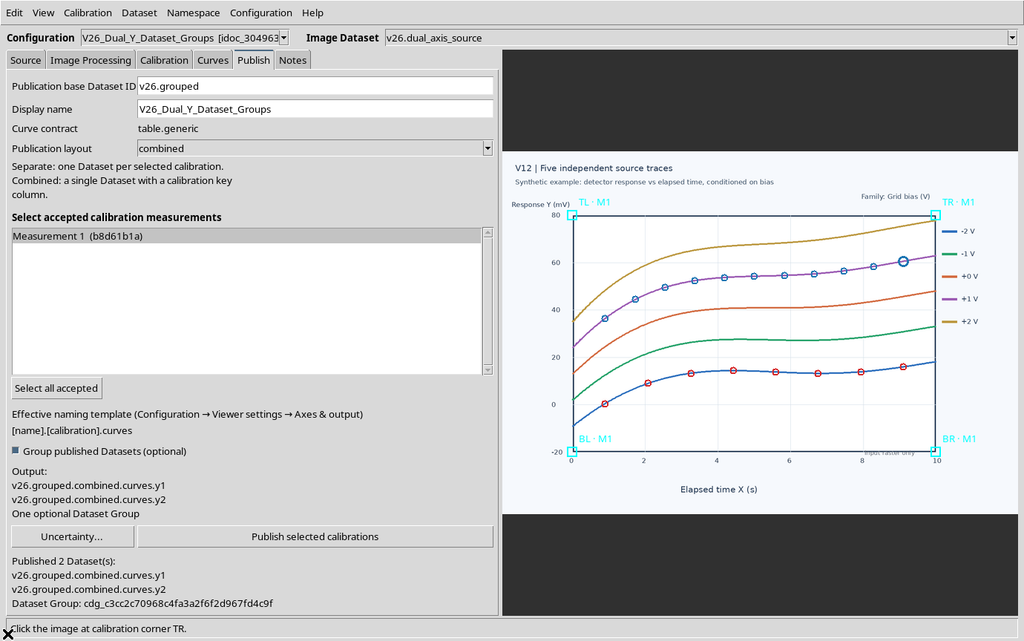
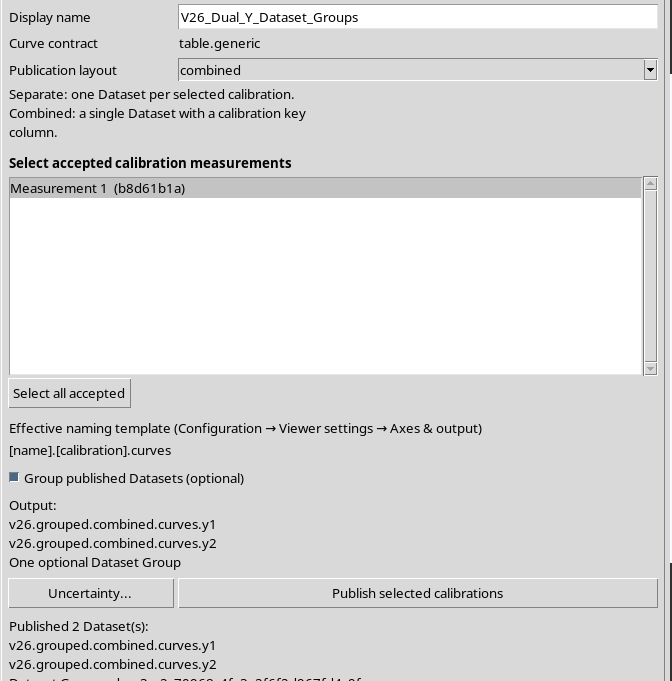
Confermiamo Publish selected calibrations. Il Viewer registra due Dataset canonici e richiede al produttore autorizzato un Dataset Group.
Il messaggio conclusivo riporta gli identificativi dei due Dataset e del nuovo Group. L’ID del Group è opaco e non deve essere ricostruito manualmente.
19. Il Group nel catalogo CORE
Nel browser Dataset di GX-TXT compare un nodo padre con due membri figli.
I ruoli dei membri sono curve_digitizer.axis.y1 e curve_digitizer.axis.y2. La struttura mostra che l’associazione non sostituisce le tabelle numeriche originali.
Nel Dataset browser identificare il nodo Group e verificarne l’elenco dei membri prima di aprirne i dati. Il ruolo curve_digitizer.axis.y1 individua il Dataset della grandezza in mV, mentre curve_digitizer.axis.y2 individua quello in gradi. I due membri possono essere aperti singolarmente: ciascuno possiede ancora la propria tabella canonica, con otto oppure undici righe. Il nodo padre descrive la relazione fra i Dataset e non una nuova variabile numerica.
20. Ispezionare il Group
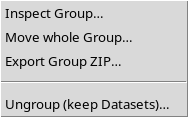
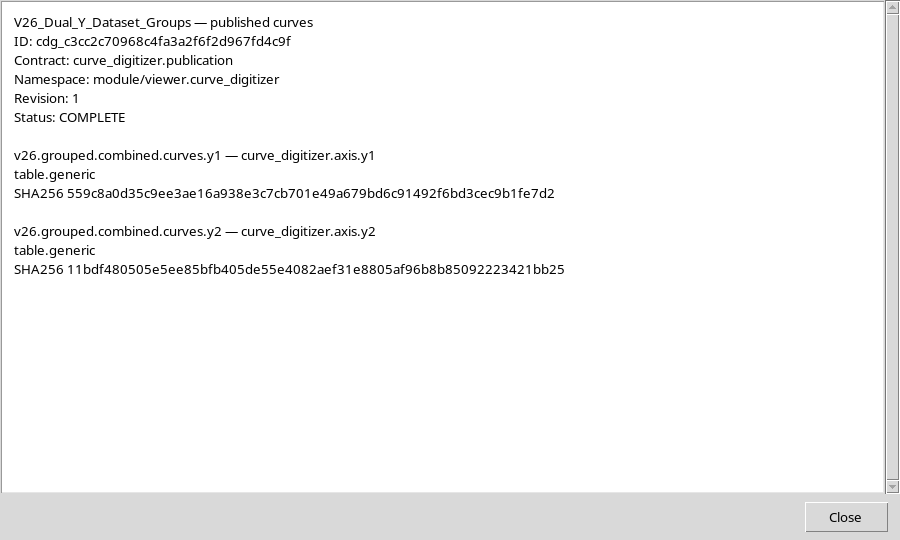
Dal menu contestuale del nodo selezioniamo Inspect Group….
La finestra mostra identità, contratto, stato, membri, ruoli e impronte SHA-256. Questo è il modo corretto per controllare se il Group contiene realmente i risultati richiesti.
21. Il significato di COMPLETE
Nel nostro esempio il CORE riporta status COMPLETE: i due membri necessari sono presenti e coerenti con il contratto e le impronte registrate.
Un Group non è soltanto un elenco di nomi. Se un membro mancasse, avesse un contenuto diverso o fosse stato spostato in modo incompatibile, l’ispezione potrebbe segnalare uno stato degradato.
Lo stato COMPLETE riguarda la coerenza del raggruppamento, non la completezza scientifica dell’esperimento. In particolare, il CORE può confrontare i riferimenti del Group con i membri disponibili, i loro contratti e le impronte registrate. Questa verifica non certifica che il tracciamento dei punti sia accurato, né che le grandezze Y1 e Y2 siano convertibili fra loro. Occorre quindi distinguere l’integrità dei dati dalla loro interpretazione fisica.
22. Identità e revisione del Group
Il manifest comprende group_id, revision, primary_dataset_id, members e group_contract. Il contratto del Group è curve_digitizer.publication; i membri mantengono il proprio contratto table.generic.
Il Group conserva i riferimenti alle identità e ai digest dei Dataset. Non memorizza una seconda copia delle loro righe numeriche.
Nell’ispezione, group_id identifica la relazione complessiva, mentre primary_dataset_id e members individuano i Dataset a cui essa si riferisce. Il campo revision appartiene al manifest del Group e non è un indice dei punti digitalizzati. I riferimenti e i digest permettono di distinguere una struttura di pubblicazione da una semplice lista di nomi, senza replicare i contenuti delle due tabelle.
23. Consultare il caso mixed nel CORE
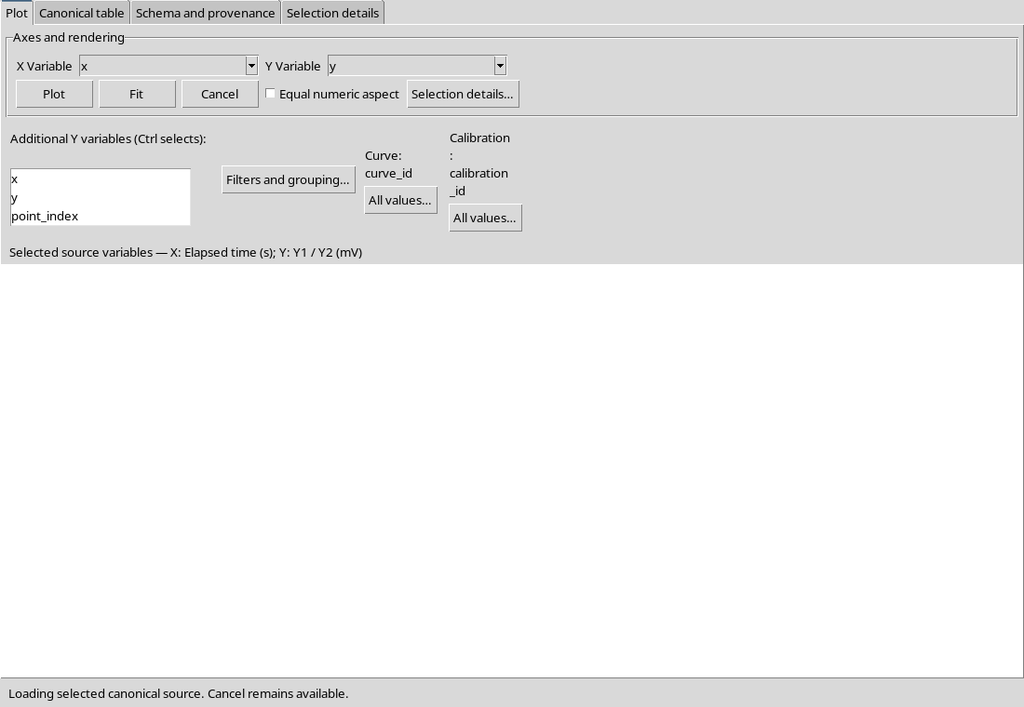
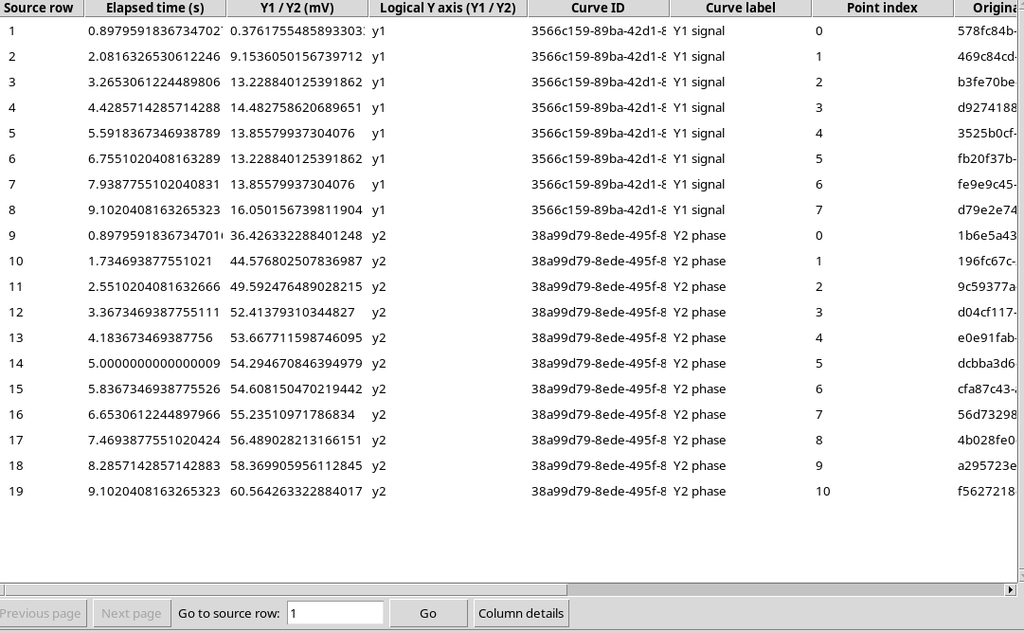
Apriamo il Dataset pubblicato quando Y1 e Y2 condividevano l’unità mV nel CORE Scientific Dataset Viewer.
La Canonical table contiene 19 righe e conserva il collegamento Y1/Y2. La vista Plot è un’anteprima, non sostituisce la lettura dello schema.
24. Curve Schema v2 e y_axis_id
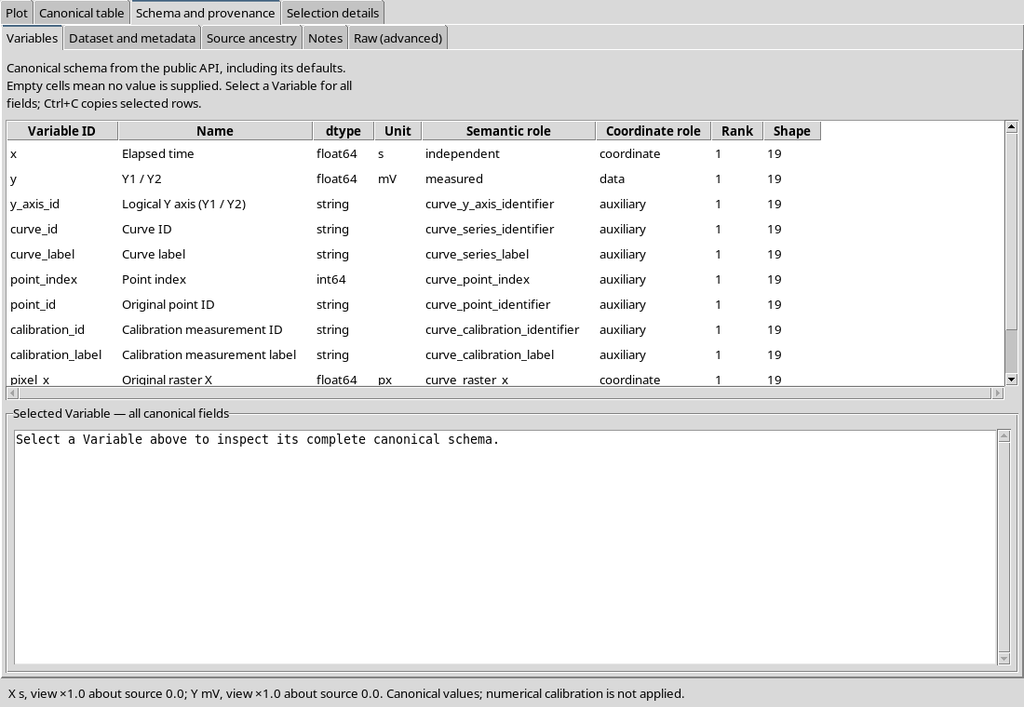
Nella scheda Variables compare la variabile testuale y_axis_id.
Il contratto Curve Digitalizer schema 2 conserva l’identità Y1/Y2 per ogni riga. I consumatori devono risolvere il suo ruolo dalla API pubblica, non dedurre la variabile dal posto che occupa nel CSV.
25. Consultare il Dataset separato Y1
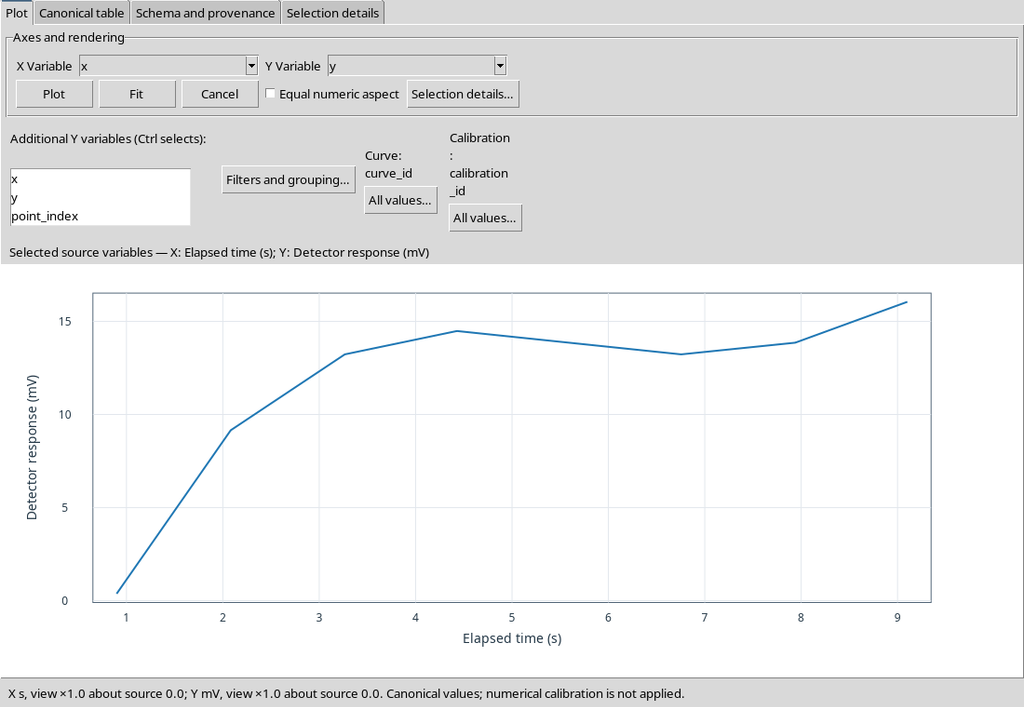
Apriamo il risultato Y1 della pubblicazione con unità differenti.
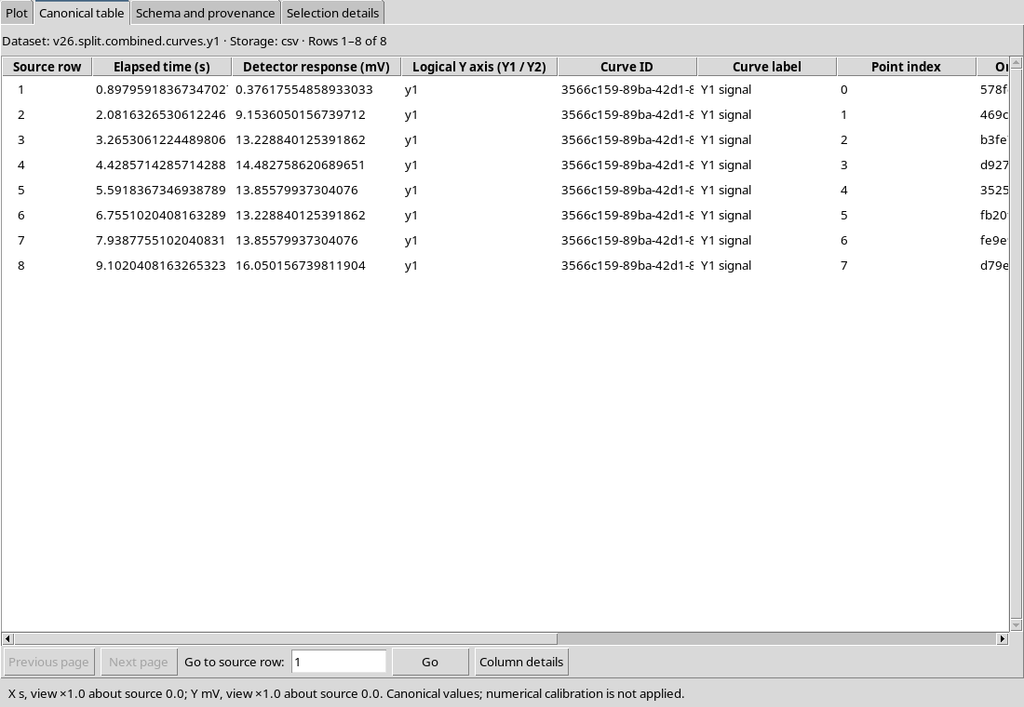
Il CORE mostra 8 righe, tutte associate alla prima curva, con variabile Y in mV e coordinate del raster ancora disponibili.
26. Consultare il Dataset separato Y2
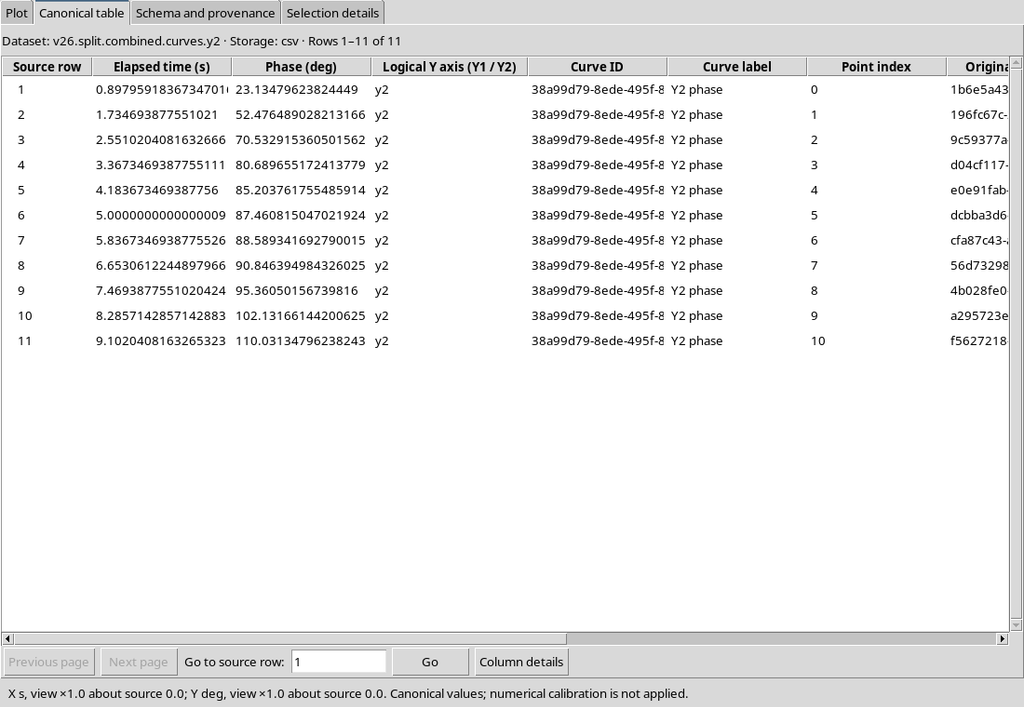
Apriamo il Dataset Y2 con unità deg.
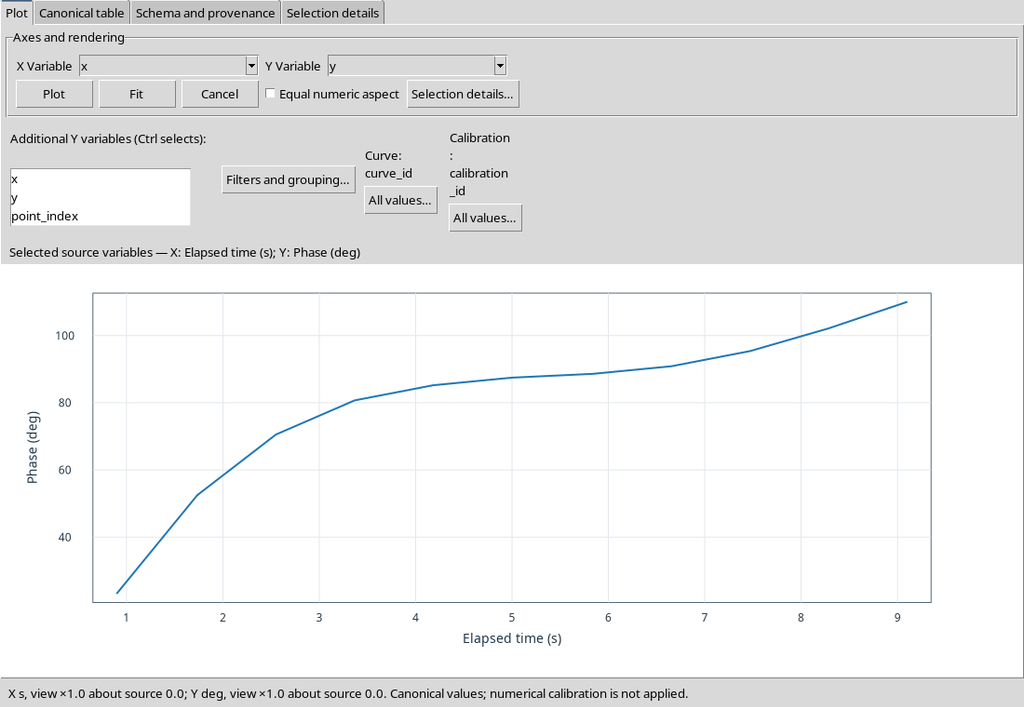
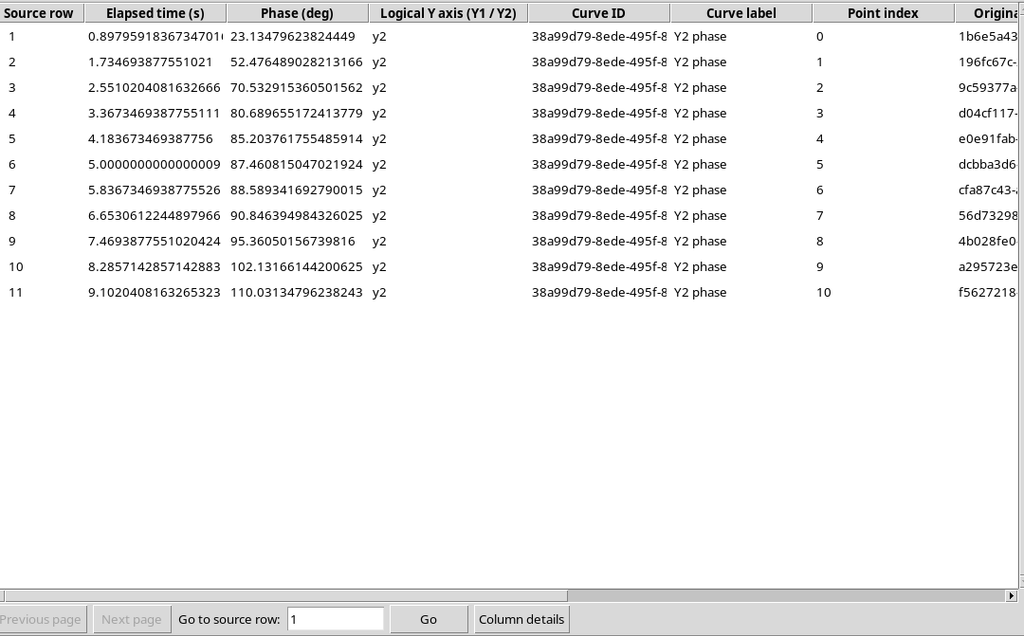
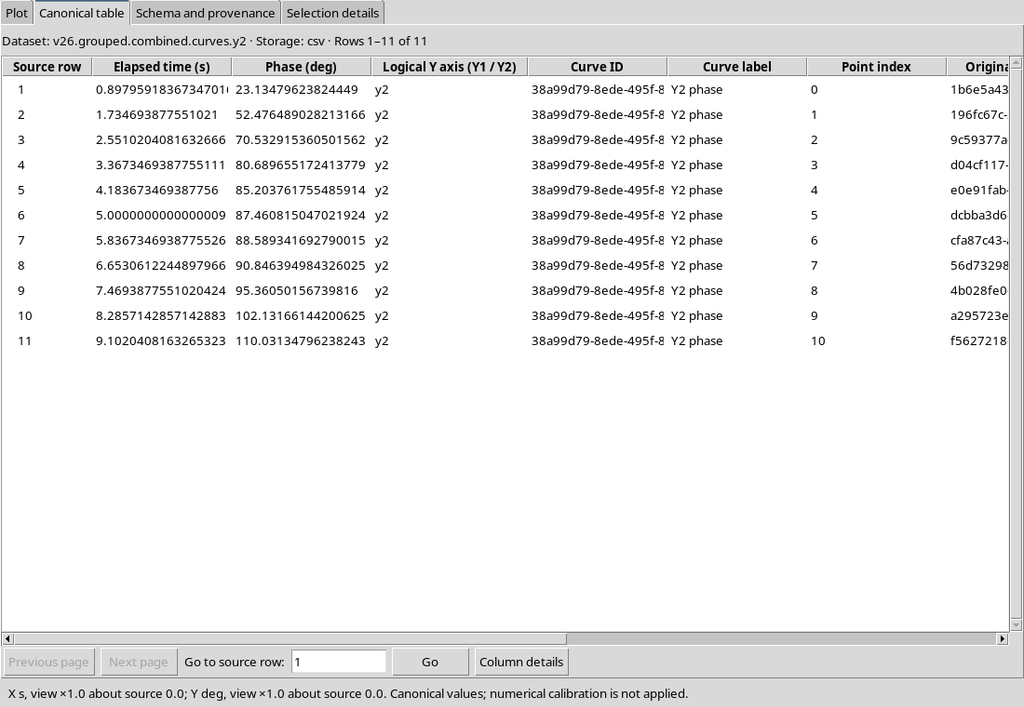
La Canonical table contiene 11 righe della seconda curva. La loro grandezza fisica è distinta da quella pubblicata per Y1.
27. Il Group non esegue calcoli numerici
Il Dataset Group non calcola medie, non esegue fitting, non converte unità e non stima incertezze o correlazioni.
Un Group è una relazione di pubblicazione fra oggetti canonici. Eventuali elaborazioni a valle richiedono software numerico e ipotesi scientifiche esplicite.
Per esempio, il Group consente di ritrovare insieme la risposta Y1 in millivolt e la fase Y2 in gradi, ma non produce una tabella con una Y unica e non esegue trasformazioni fra grandezze. Per confrontare o rappresentare le due serie occorre leggere ogni membro secondo le sue unità e le sue coordinate X; eventuali interpolazioni o analisi congiunte richiedono un’elaborazione esplicita e una giustificazione scientifica distinta dalla semplice appartenenza al Group.
28. Aprire il membro Y1 del Group
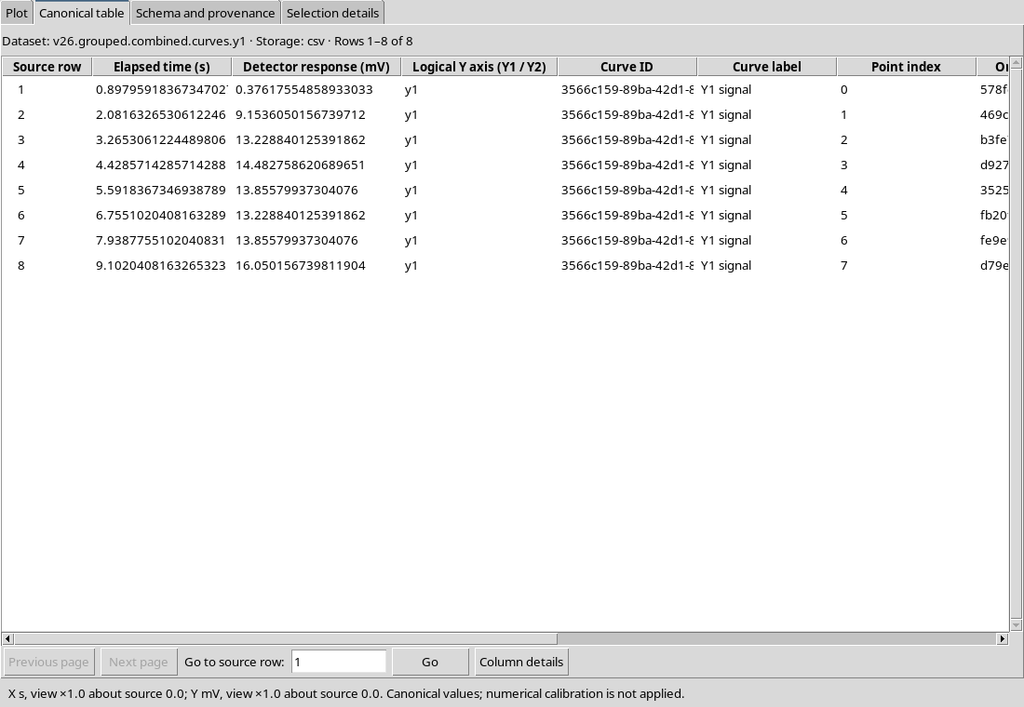
Dal browser apriamo il membro Y1.
Il suo Dataset conserva 8 righe e le coordinate originali. Il confronto con l’uscita Y1 pubblicata senza Group conferma che i CSV e gli SHA-256 canonici sono identici.
29. Il membro Y1 nello Schema e nella provenienza
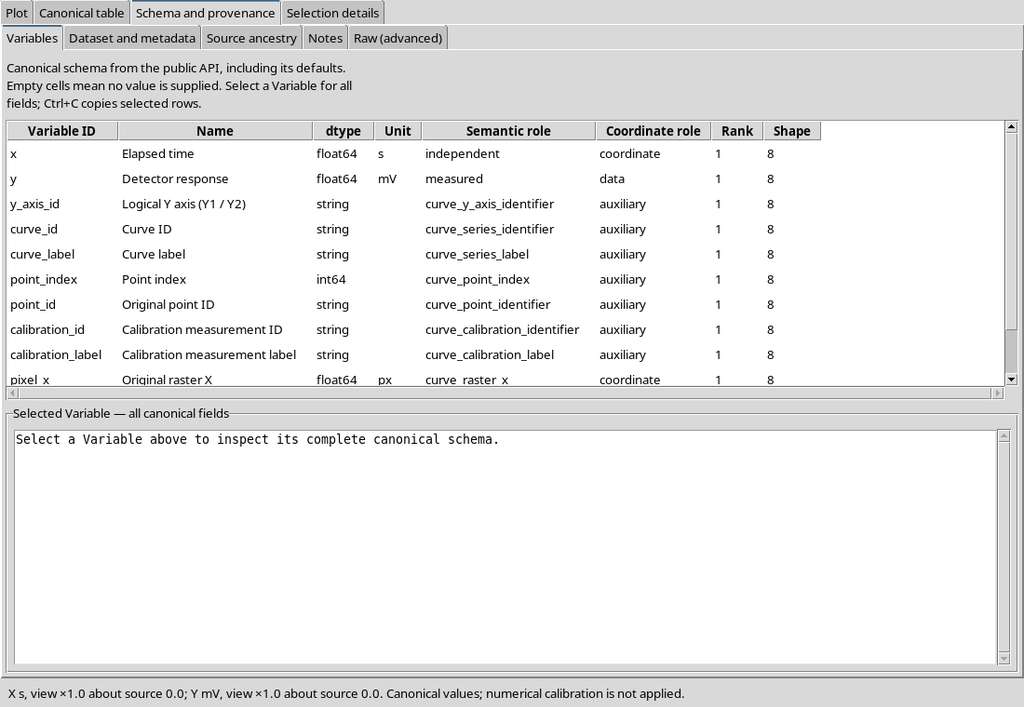
Il Variable Schema v3 descrive Y in mV e il campo y_axis_id.
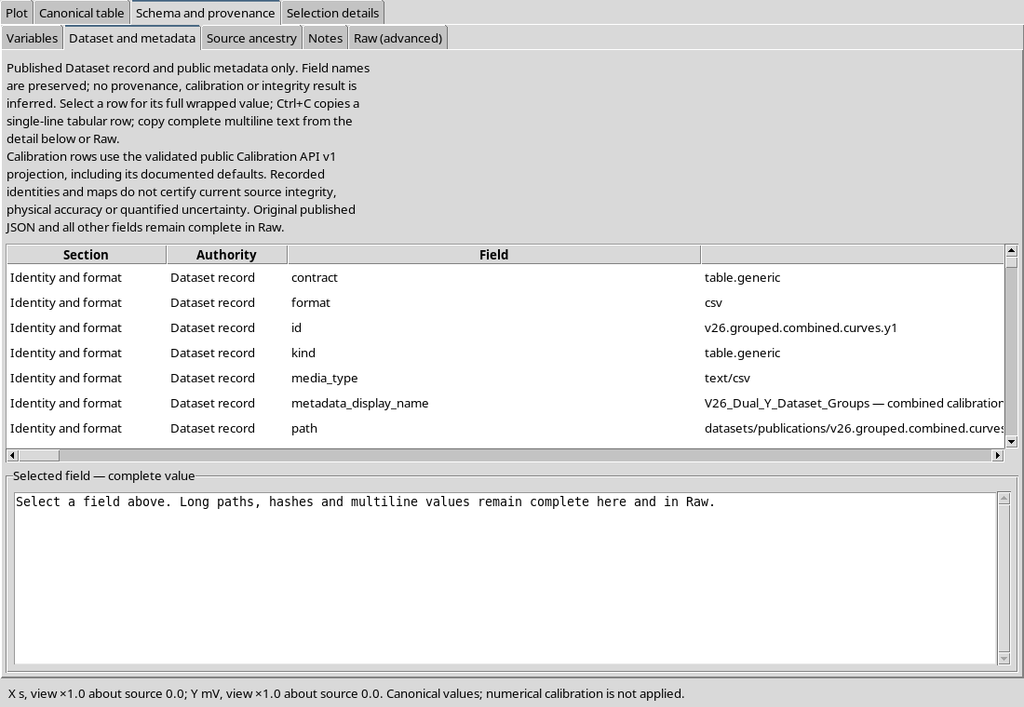
I metadati preservano la sorgente e il collegamento all’asse logico, senza introdurre una nuova misura o duplicare i dati del primo tracciato.
30. Aprire il membro Y2 del Group
Apriamo anche il secondo membro.
Il Dataset contiene 11 righe, in gradi, con gli stessi point_id e pixel della precedente uscita Y2 non raggruppata. Anche per Y2 il contenuto canonico è identico prima e dopo il raggruppamento.
31. Verificare Schema e ascendenza di Y2
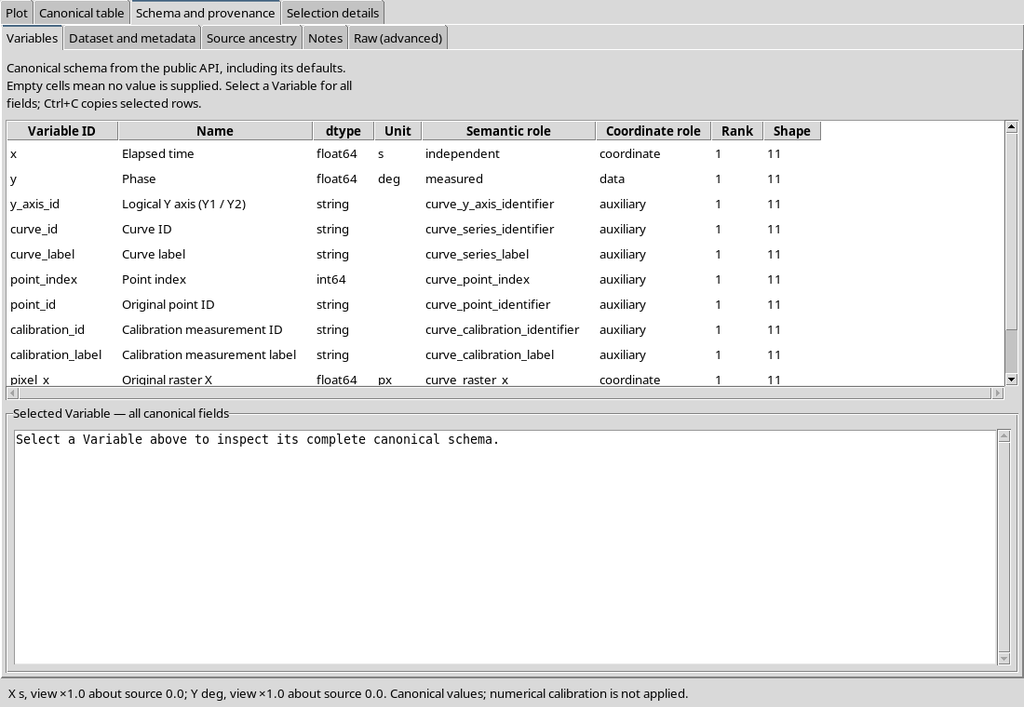
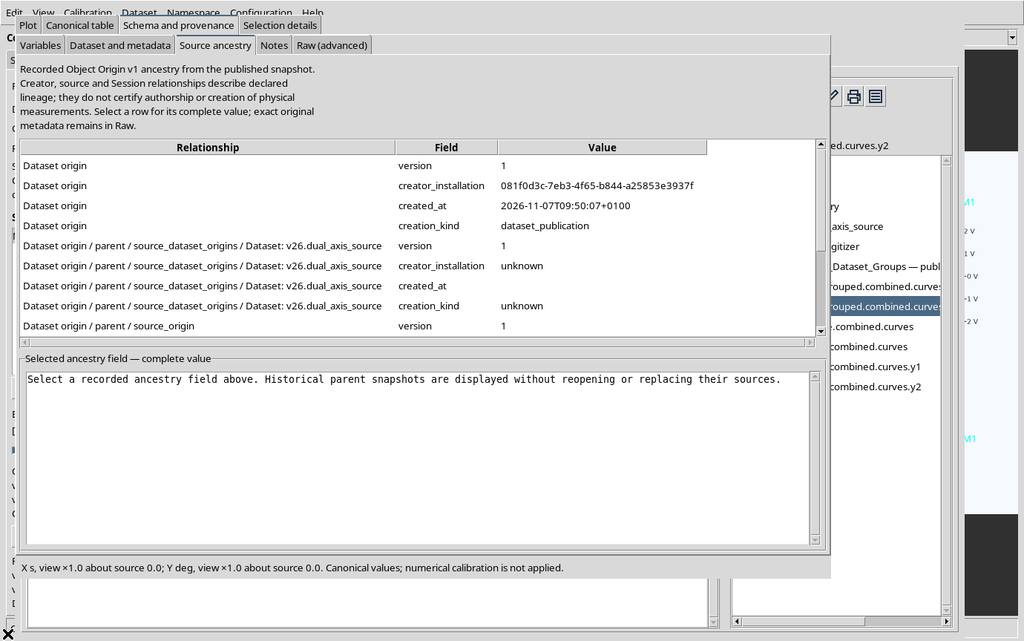
Nella scheda Variables la grandezza Y è dichiarata in deg e la curva è collegata a Y2.
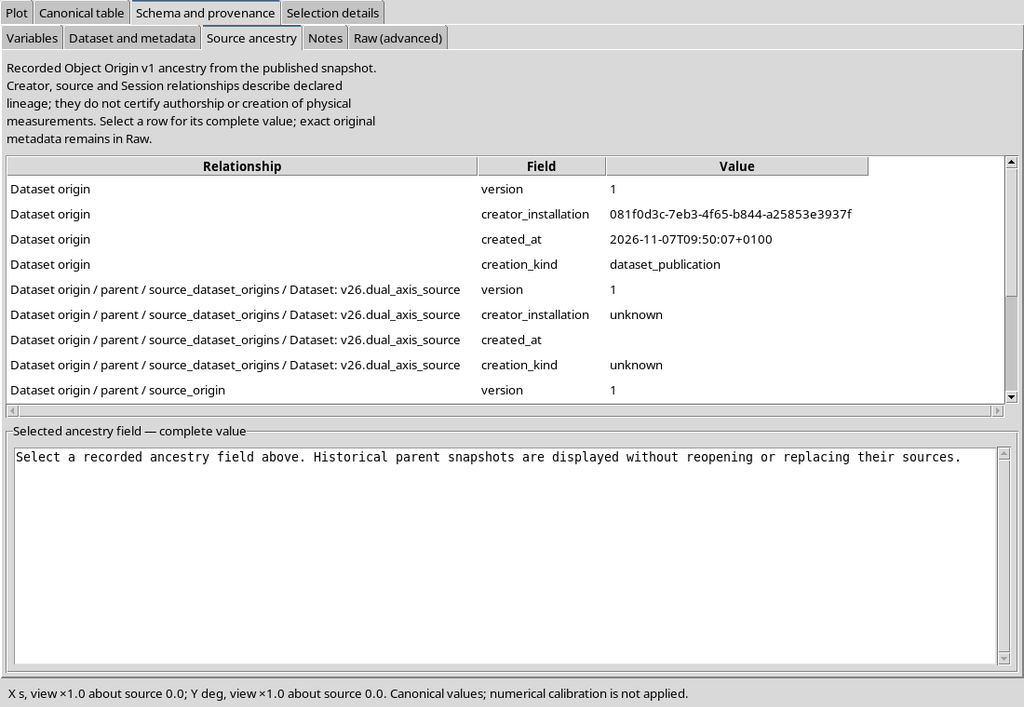
La sezione Source ancestry riconduce il membro al raster originale. Nessuna operazione del Group ha alterato la sorgente.
32. Confrontare i due output e i due membri
| Grandezza | Output autonomo | Membro del Group |
|---|---|---|
| Y1, mV | 8 righe | 8 righe identiche |
| Y2, deg | 11 righe | 11 righe identiche |
| Punti sorgente | 19 | 19 |
La relazione Group non genera una terza serie di 19 punti. Conserva un riferimento a ciascuno dei due Dataset, con ruoli scientifici differenti.
33. Namespace, SHA-256 e revisione
La Dataset Group API del CORE lega ciascun membro al contratto, alla revisione e al digest canonico. I membri devono rispettare le condizioni di namespace e identità richieste dal CORE.
Nella pubblicazione dimostrativa lo stato è COMPLETE e la revisione è 1. Non modificare direttamente i file del Group: utilizzare le operazioni pubbliche autorizzate del framework.
Un controllo utile consiste nel leggere il manifest del Group e confrontare identificativi, ruoli e digest con i Dataset effettivamente presenti nel catalogo della Session. L’impronta SHA-256 serve a verificare il contenuto di un membro, mentre la revisione del Group riguarda il documento che ne descrive la relazione. La revisione 1 indicata nell’esempio non è una versione del Curve Digitalizer. Per conservare questa tracciabilità, non rinominare né riscrivere manualmente gli oggetti canonici.
34. Se il Group non viene creato
La pubblicazione dei Dataset e la successiva creazione del Group non sono necessariamente una sola transazione atomica. Se il raggruppamento fallisce, i Dataset già pubblicati possono restare validi.
Controllare il messaggio della GUI e il browser prima di ripetere un’operazione. Non presumere che un errore del Group abbia automaticamente cancellato le tabelle precedenti.
Se il messaggio conclusivo non conferma il Group, verificare prima se i due Dataset Y1 e Y2 sono stati comunque registrati. La loro presenza nel catalogo non dimostra, da sola, che esista anche il nodo padre. Esaminare separatamente l’esito della pubblicazione numerica e quello della creazione del Group; solo dopo identificare l’operazione da ripetere, evitando pubblicazioni duplicate o collisioni di ID. Un eventuale problema del raggruppamento non deve essere confuso con una perdita automatica dei dati già pubblicati.
35. Salvare la configurazione
Usiamo Configuration → Save configuration.
Il documento scientifico salva sorgente, assi, calibrazione e curve. I Dataset numerici e il loro Group hanno una persistenza distinta nel CORE della Session.
36. Riaprire le curve e gli assi
Chiudiamo normalmente il Viewer e lo riapriamo dalla stessa Session.
Ritroviamo le due curve con 8 e 11 punti e le unità Y1 mV e Y2 deg. Identificativi, pixel e calibrazione condivisa sono invariati.
37. Riaprire Publish e Source
Nella scheda Publish rimangono il piano e il checkbox del Group.
La scheda Source presenta ancora il Dataset immagine originale. Per una nuova pubblicazione è prudente verificare sempre anche la selezione delle calibrazioni accettate.
38. Verificare il Group dopo Reopen
Nel browser del CORE il nodo Group è ancora presente con i due membri.
La rilettura tramite le API pubbliche conferma COMPLETE, lo stesso Group ID, la stessa revisione e le stesse impronte dei due Dataset canonici.
Dopo la riapertura della Session, individuare nuovamente il Group nel browser e utilizzare Inspect Group… per rileggere lo stato. Controllare che compaiano entrambi i membri, con i ruoli curve_digitizer.axis.y1 e curve_digitizer.axis.y2, e confrontare identificativi, revisione e impronte con quelli della pubblicazione. È un controllo diverso dalla riapertura dell’Interactive Document: il primo verifica gli oggetti canonici, il secondo la persistenza della configurazione del Viewer.
39. Leggere Y1/Y2 e Group tramite API pubbliche
Un consumatore scientifico può interrogare CURVE_DIGITIZER_DATASET_SCHEMA_API_v1 per ottenere l’identità degli assi e dei membri, evitando ipotesi sui nomi delle colonne. L’esempio Tcl richiede una Session GX-TXT aperta e un vero ID di Dataset pubblicato.
# Activate the versioned public Curve Digitalizer Dataset Schema API.
::GX::modulePublicApiActivate viewer.curve_digitizer CURVE_DIGITIZER_DATASET_SCHEMA_API_v1

# Replace this example ID with an actual published Dataset ID.
set datasetId "example.dualy.y1"

# Resolve the scientific axes, curve identities and semantic columns.
set description [::GX::CurveDigitizerDataset::describe $datasetId]
set schema [::GX::CurveDigitizerDataset::read $datasetId]
set axes [dict get $description axes]
set logicalYAxis [dict get $schema columns y_axis_id]

# Read a bounded set of source-linked canonical numeric points.
set samples [::GX::CurveDigitizerDataset::rasterPoints $datasetId "" 0 100]

# Read Group membership through the producer's public adapter.
set grouping [::GX::CurveDigitizerDataset::datasetGroup $datasetId]
if {[dict get $grouping grouped]} {
    set session [::GX::sessionInspectionCurrentSession]
    set groupId [dict get $grouping group_id]
    set groupManifest [::GX::datasetGroupGet $session $groupId]
    set members [dict get $groupManifest members]
}
La funzione describe comprende schema, curve, assi e appartenenza al Group; rasterPoints restituisce dati con coordinate originali del raster. datasetGroupGet verifica i membri effettivi del Group dal CORE.
Nello script, datasetId deve essere sostituito con l’ID di un Dataset realmente pubblicato nella Session. describe espone il contesto degli assi; read permette di risolvere i ruoli delle colonne; rasterPoints consulta un insieme limitato di punti conservandone il collegamento al raster. La chiamata datasetGroup consente di stabilire se esiste un raggruppamento; solo in tal caso il codice consulta il manifest tramite datasetGroupGet. L’esempio mostra come individuare i dati, non esegue un fitting.
40. Procedura operativa e limiti
- Importare il raster e accettare una calibrazione completa a quattro angoli.
- Abilitare Y2 e dichiarare nome, unità e limiti di entrambi gli assi.
- Associare ogni curva a Y1 oppure Y2 nel dialogo New curve / Edit curve.
- Digitalizzare i punti e verificare le identità delle due serie.
- Con unità uguali, controllare la pubblicazione mixed e il ruolo y_axis_id.
- Con unità incompatibili, mantenere separati i Dataset per asse fisico.
- Attivare Group published Datasets quando occorre collegare più risultati autonomi.
- Ispezionare nel CORE lo stato, i ruoli, i membri e gli SHA-256 canonici.
- Salvare, chiudere e riaprire; verificare punto per punto gli assi e la persistenza del Group.
- Non inferire accuratezza, deviazione standard o covarianza dal solo raggruppamento.
Nel caso illustrato, la decisione pratica dipende innanzitutto dalle unità Y: se entrambe le curve sono in mV si può usare un Dataset mixed con y_axis_id; se Y1 è in mV e Y2 in deg occorrono due Dataset con schemi distinti. Il Group è utile soltanto per mantenere il collegamento fra tali pubblicazioni. Prima di procedere, controllare che le due serie mantengano 8 e 11 punti, che la calibrazione sia accettata e che il Dataset Group riporti membri e stato coerenti.
L’esempio utilizza una calibrazione accettata e nessuna dichiarazione di incertezza numerica. L’eventuale pubblicazione Dual-Y con incertezze revisionate richiede altri controlli scientifici e un modello esplicito, non fornito automaticamente dal Dataset Group.
Conclusione: Dual-Y preserva il significato e l’unità di ciascuna curva. Quando i valori condividono l’unità si può pubblicare una tabella mixed; quando le unità sono incompatibili, il CORE collega due Dataset distinti mediante un Group senza alterarne il contenuto.