

Dichiarazione delle incertezze e covarianza fisica
In GX-TXT, digitalizzare una curva significa ricavare punti scientifici a partire dai pixel di un’immagine calibrata. Le coordinate ottenute non contengono automaticamente un’informazione sulla loro incertezza: il solo fatto che l’immagine abbia una determinata risoluzione o uno spessore visibile non consente di stabilire quanto sia incerta una misura.
Il Curve Digitalizer distingue nessuna incertezza dichiarata, incertezze standard fisiche assegnate esplicitamente e incertezze di localizzazione e calibrazione propagate numericamente. Questa guida illustra la loro differenza e mostra come leggere i risultati di CURVE_DIGITIZER_UNCERTAINTY_API_v1, il servizio numerico NUMERIC_API_v1 e la covarianza completa pubblicata.
Tutti i valori di incertezza usati nell’esempio sono ipotesi didattiche. Non provengono da strumenti, ripetizioni sperimentali o certificati di calibrazione.
1. Prima distinzione: punti, spessore e incertezza
I punti digitalizzati hanno una posizione nel raster e, dopo la calibrazione, una posizione X/Y in unità fisiche. La larghezza della linea e le osservazioni del rapporto Quality riguardano invece il segno grafico. Nessuno dei due è una incertezza standard.
In assenza di una dichiarazione motivata, il sistema non deve introdurre automaticamente un errore di un pixel, di mezzo pixel o uno scarto statistico stimato soltanto dall’aspetto della figura.
2. Sorgente sintetica e calibrazione
L’esempio utilizza un raster originale di 1280 × 900 pixel, con una linea scura sinuosa e una seconda traccia rosa, volutamente separata. Sono stati acquisiti 15 punti manuali sulla prima linea.
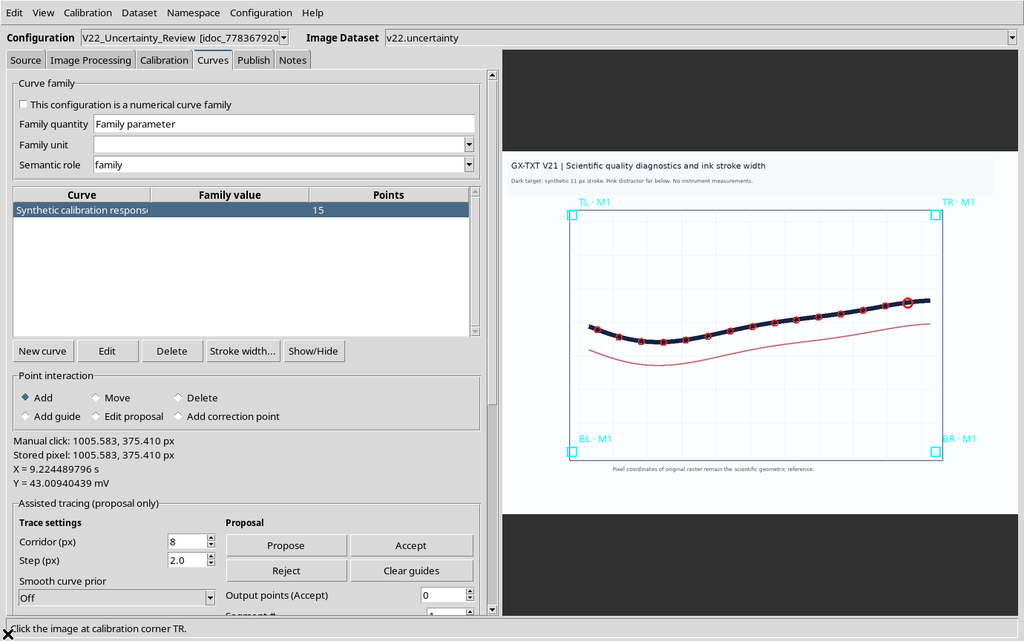
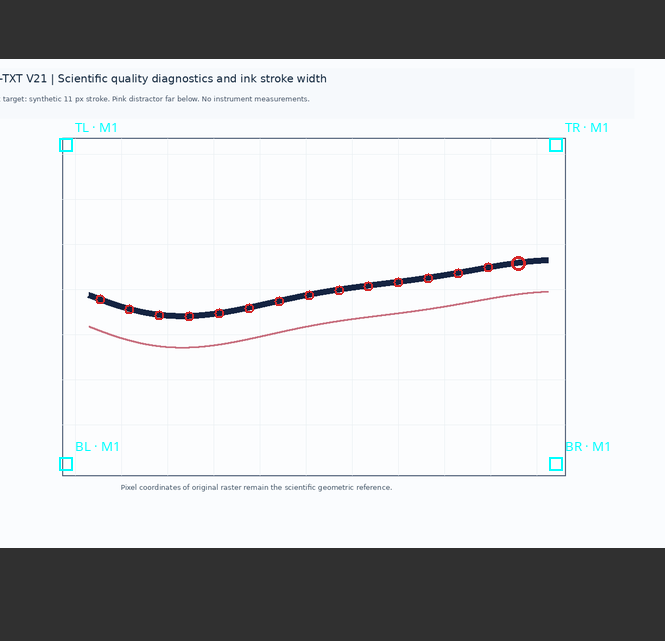
La calibrazione a quattro angoli associa X a 0–10 s e Y a −20–80 mV. Le stesse coordinate, lo stesso ordine dei punti e gli stessi identificativi saranno mantenuti nei tre Dataset numerici di confronto.
3. Pubblicare senza incertezza: Error model none
In Publish, selezionare la calibrazione accettata e predisporre un nuovo Dataset numerico.
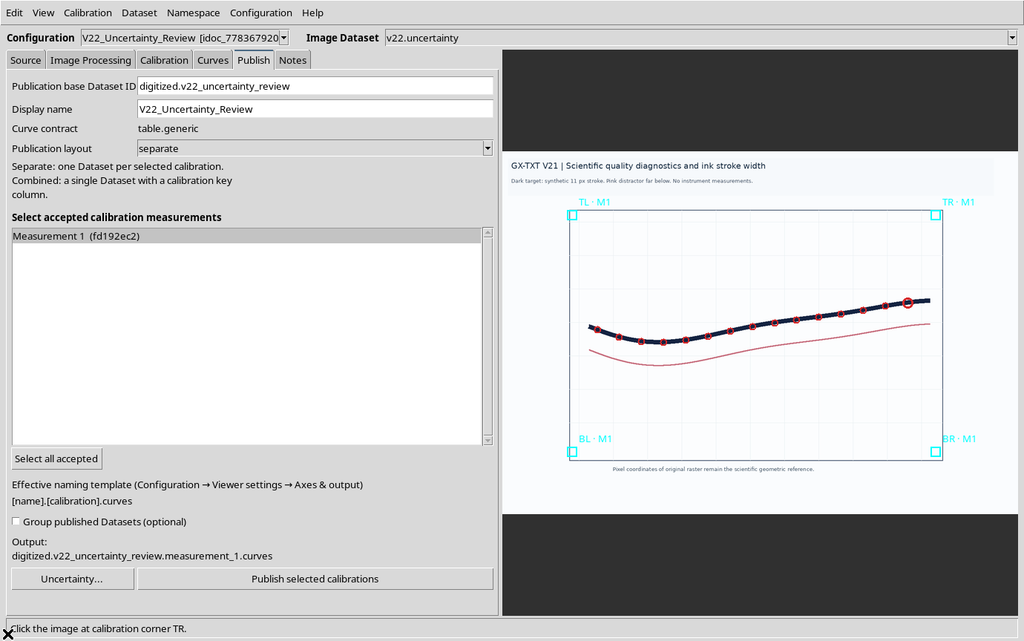
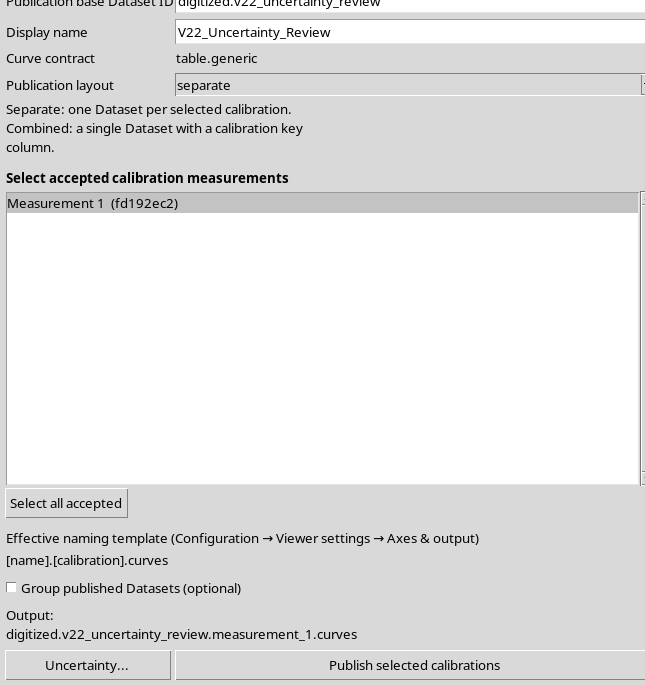
Con il modello none, il comando Publish selected calibrations crea la tabella ordinaria con le coordinate scientifiche e quelle raster.
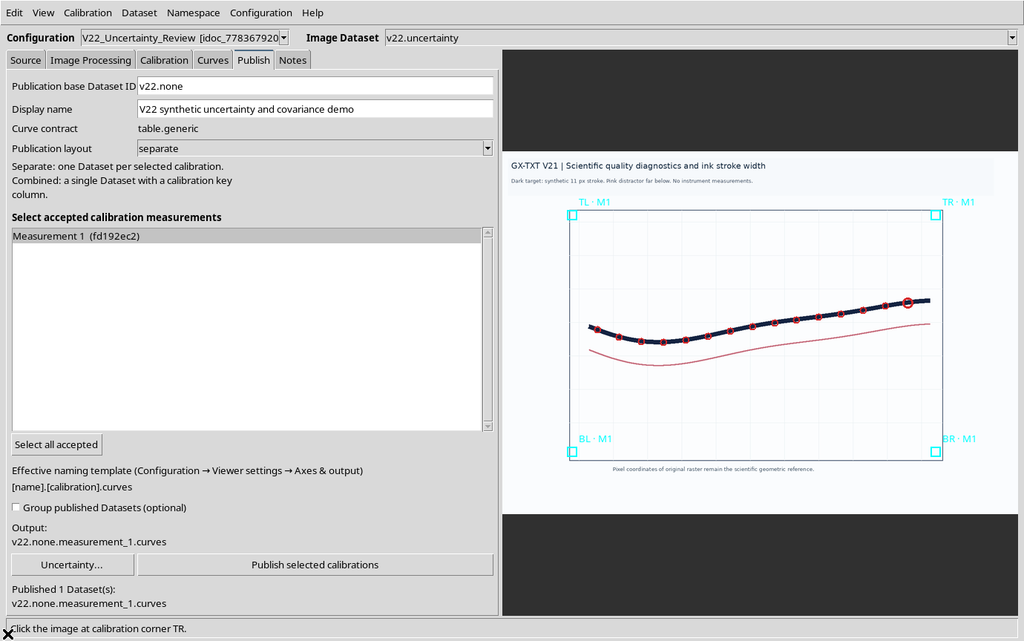
La tabella di questo esempio contiene 15 righe e non contiene le colonne sigma_x, sigma_y e covariance_xy. L’assenza di tali colonne non significa che la misura sia esatta; significa che non è stato dichiarato un modello metrologico.
4. Aprire Pixel and calibration uncertainty
Da Publish, premere Uncertainty… per aprire l’editor di dichiarazione.
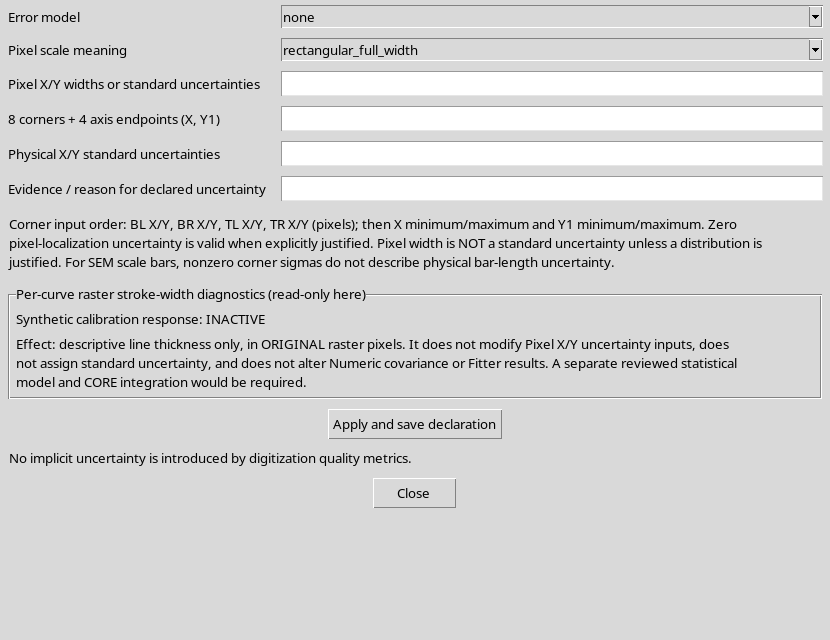
All’inizio è selezionato Error model = none. I campi relativi ai pixel, agli input di calibrazione e alle incertezze fisiche sono vuoti. Non compaiono valori statistici precompilati.
L’editor memorizza assunzioni scientifiche nella configurazione corrente: non è un semplice controllo grafico del Canvas.
5. I tre modelli disponibili
La scelta Error model offre tre modalità:
| Modello | Significato |
|---|---|
| none | Non viene propagata alcuna incertezza dichiarata |
| physical_override | Sono fornite direttamente incertezze standard fisiche X e Y |
| pixel_calibration | Sono forniti un modello di localizzazione pixel e gli input incerti della calibrazione |
Non si tratta di una graduatoria della qualità dei dati. Ogni modello è ammissibile soltanto se l’operatore può giustificarne le ipotesi.
6. physical_override: assegnare due sigme fisiche
Scegliere physical_override e indicare due incertezze standard nelle unità fisiche degli assi. Nell’esempio si dichiarano 0,03 s e 0,20 mV.
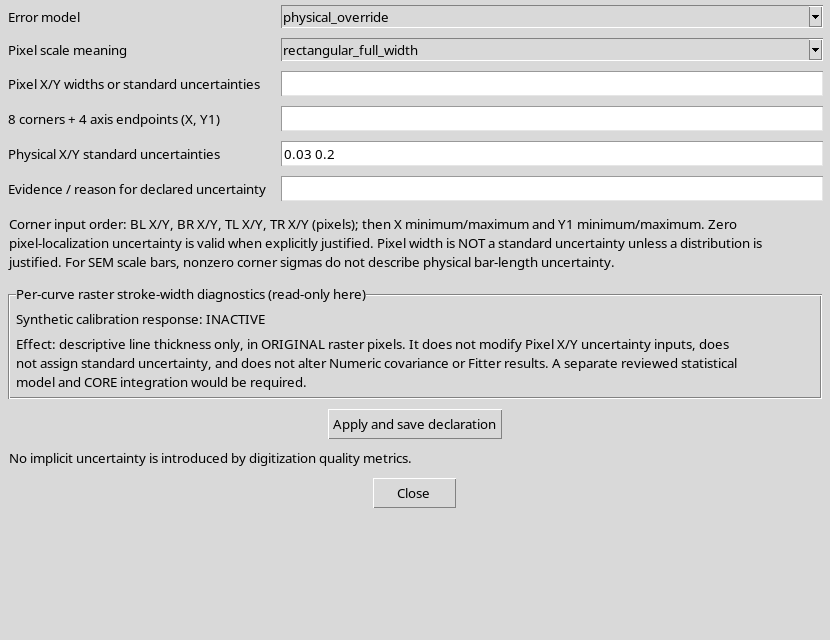
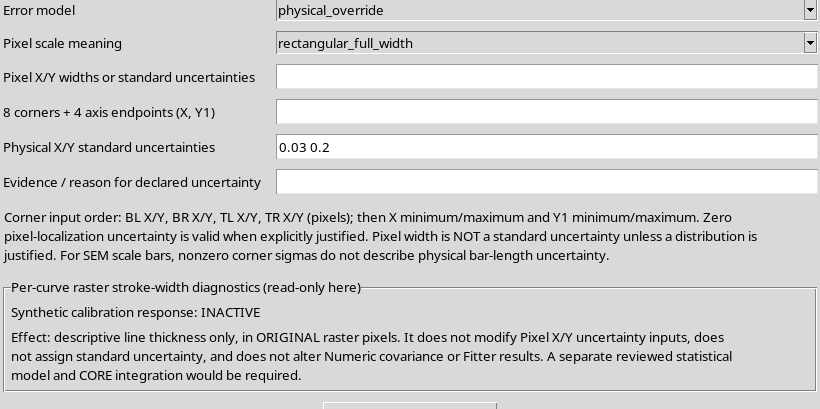
Sono numeri ipotetici per mostrare il funzionamento del software; non costituiscono una caratterizzazione reale del segnale sintetico, del tempo o dell’ampiezza di misura.
7. La motivazione è obbligatoria
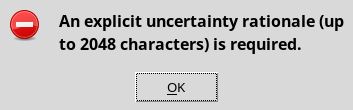
Questa protezione impedisce di registrare una dichiarazione priva del contesto necessario per interpretarla.
8. Confermare la dichiarazione fisica
Inserire una motivazione esplicita, verificare le unità e premere Apply and save declaration.
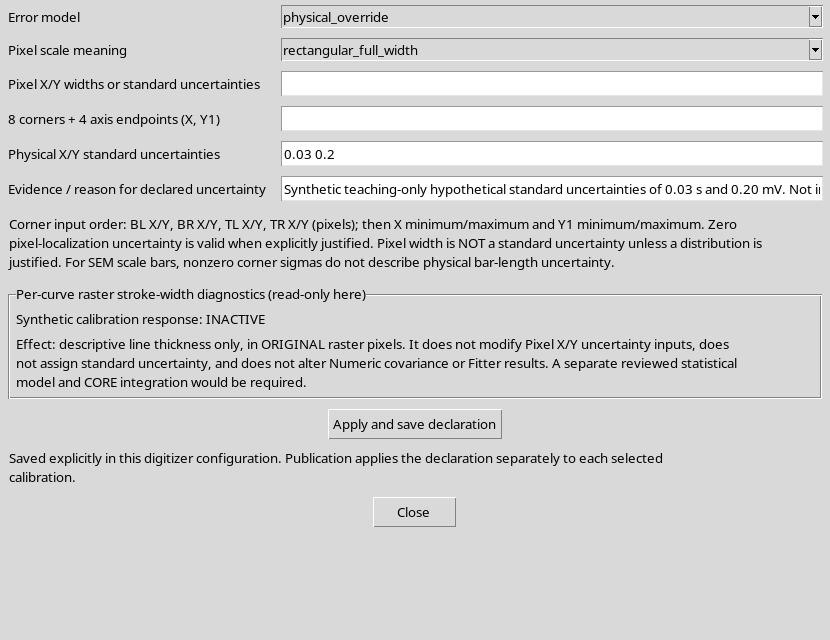
Lo stato della finestra indica che la dichiarazione è stata salvata nella configurazione. I due numeri sono ora un’ipotesi scientifica revisionata, non una regolazione temporanea dell’interfaccia.
9. Pubblicare il modello physical_override
Chiudere l’editor, specificare un Dataset ID distinto e pubblicare la calibrazione accettata.
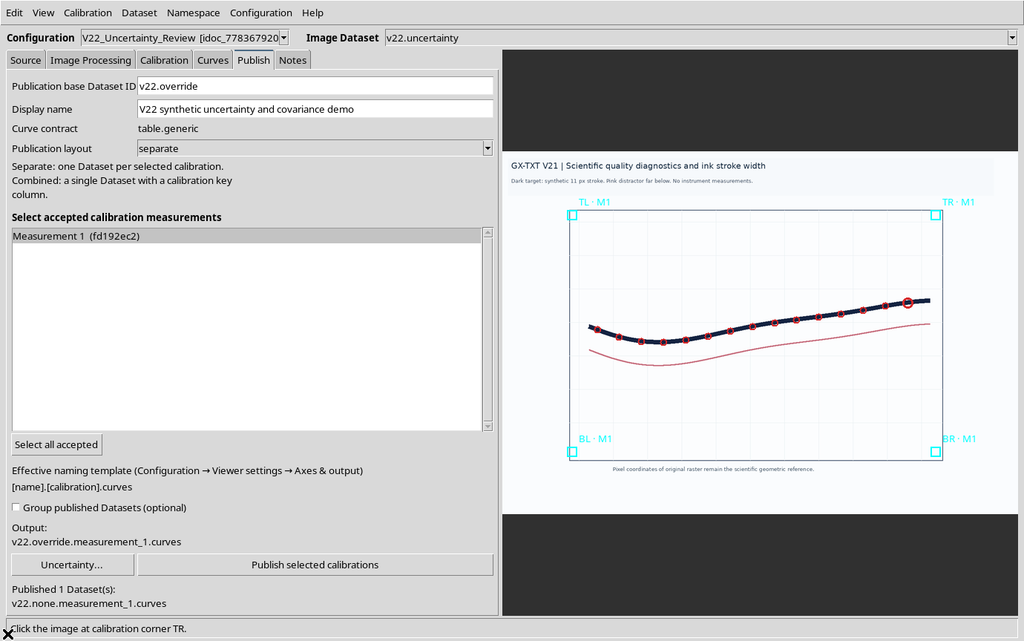
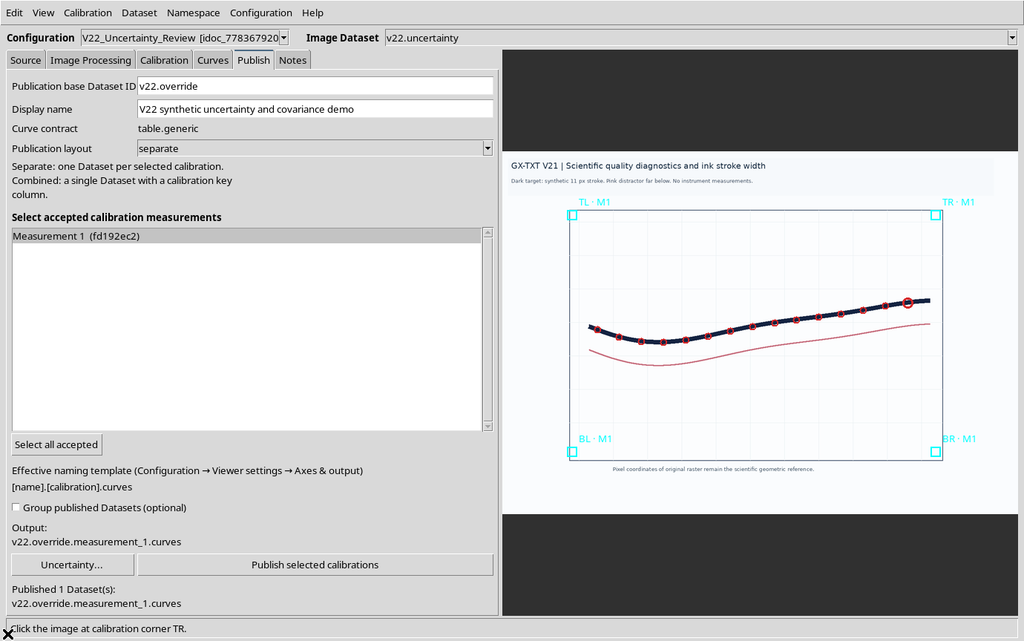
Il risultato contiene le colonne sigma_x, sigma_y e covariance_xy, con i valori standard dichiarati. Nell’esempio tutti i punti hanno sigma_x = 0,03 s, sigma_y = 0,20 mV, e covarianza X/Y nulla.
10. Perché physical_override non crea correlazioni condivise
Nel modello qui dichiarato, le incertezze sono assegnate indipendentemente alle coordinate fisiche di ciascun punto. Non sono introdotti contributi comuni derivanti dalla calibrazione.
La matrice di covarianza della risposta Y è quindi diagonale, con varianza 0,04 mV² per ogni punto. Il fatto che il modello sia semplice non significa che sia preferibile: è appropriato solo se l’indipendenza assunta è scientificamente sostenibile.
11. Riutilizzare una dichiarazione salvata
Riaprendo Uncertainty…, il modello fisico appena approvato viene ricaricato.
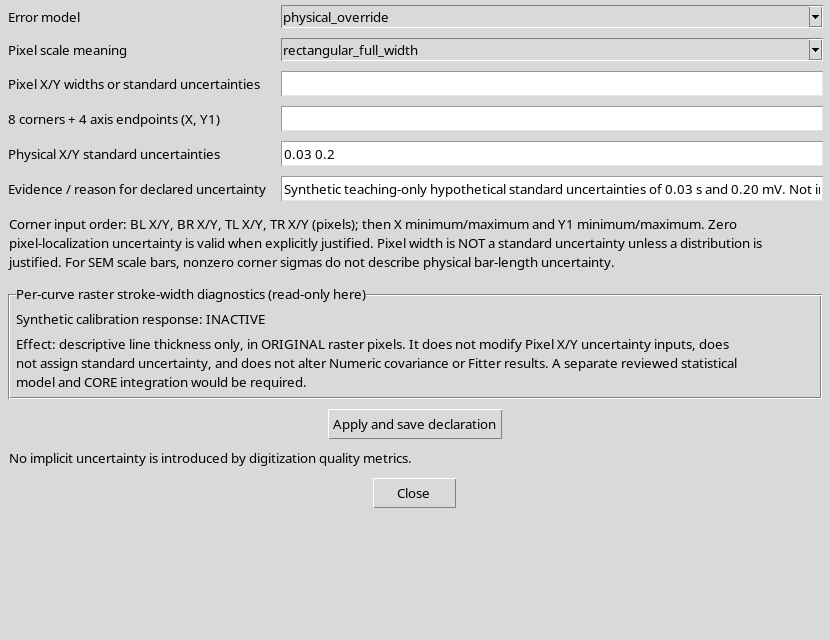
Ciò permette di verificare quali ipotesi siano effettivamente collegate alla configurazione. Cambiare uno dei suoi input non modifica retroattivamente i Dataset già pubblicati.
12. pixel_calibration: il modello più articolato
La modalità pixel_calibration distingue la localizzazione incerta dei punti sul raster dalle incertezze degli elementi usati per determinare la trasformazione di calibrazione.
Per la configurazione monoasse dell’esempio, l’editor richiede due input pixel e dodici incertezze standard di calibrazione. Le prime riguardano la posizione locale del punto, mentre le dodici possono produrre effetti comuni a più punti.
13. Ordine dei dodici input di calibrazione
Nel modello monoasse l’ordine richiesto è:
| Indici | Origine delle incertezze standard |
|---|---|
| 1–2 | Bottom left: pixel X, pixel Y |
| 3–4 | Bottom right: pixel X, pixel Y |
| 5–6 | Top left: pixel X, pixel Y |
| 7–8 | Top right: pixel X, pixel Y |
| 9–10 | X minimum, X maximum nelle unità dell’asse X |
| 11–12 | Y minimum, Y maximum nelle unità dell’asse Y |
Le unità dei primi otto elementi sono i pixel originali; quelle degli ultimi quattro sono fisiche. Un elenco privo di tale corrispondenza non documenta una calibrazione riproducibile.
14. La GUI rifiuta un numero errato di input
Se si inseriscono soltanto due valori nella casella delle incertezze di calibrazione, l’editor rifiuta la dichiarazione perché ne richiede esattamente dodici.
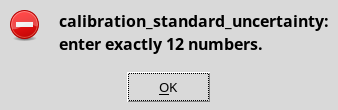
Non vengono creati parametri mancanti in modo implicito e non è possibile approvare una matrice incompleta.
15. La GUI rifiuta valori negativi
Una incertezza standard deve essere un valore finito e non negativo. Inserendo un numero negativo nella lista, il Viewer presenta un errore.
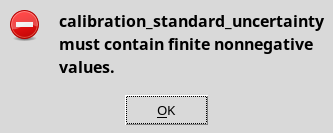
Il controllo è distinto da quello sulle unità e dalla motivazione: l’operatore deve garantire contemporaneamente completezza, coerenza dimensionale e significato scientifico.
16. Localizzazione zero dichiarata esplicitamente
Il modello ammette una localizzazione pixel 0 0, purché questa scelta sia esplicitamente giustificata.
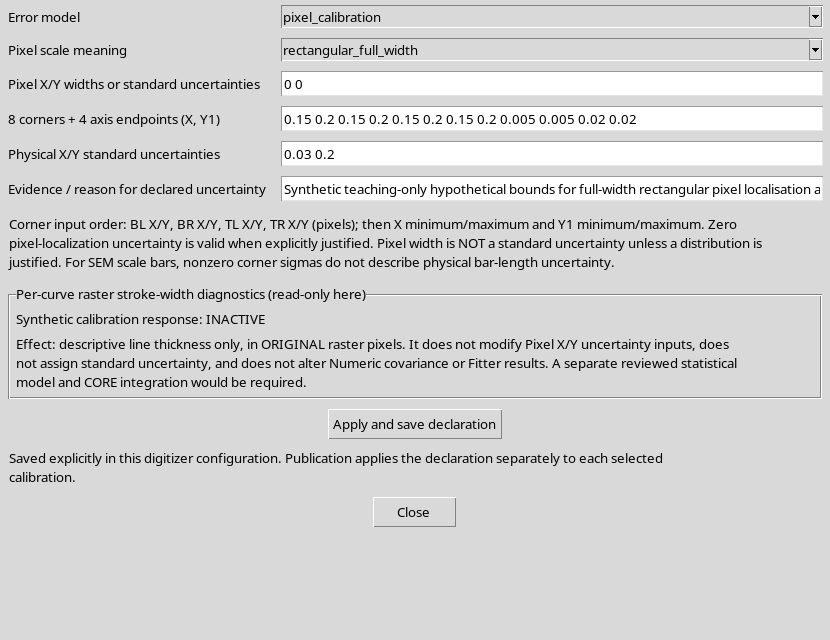
L’esempio dimostra che il Viewer non impone automaticamente una soglia positiva derivata dalla dimensione del pixel. Una localizzazione zero non annulla, però, i contributi condivisi delle dodici incertezze di calibrazione non nulle.
Il valore zero è una scelta dichiarata del modello: non implica che la localizzazione reale dei pixel sia esatta.
17. Ampiezza rettangolare e incertezza standard
Selezionando rectangular_full_width, i due numeri di localizzazione rappresentano ampiezze complete di intervalli uniformi, non direttamente deviazioni standard.
Per un’ampiezza completa w, la conversione dichiarata è:
σ_pixel = w / √12
Nell’esempio le ampiezze 1,2 px e 1,8 px corrispondono a circa 0,3464 px e 0,5196 px di incertezza standard locale.
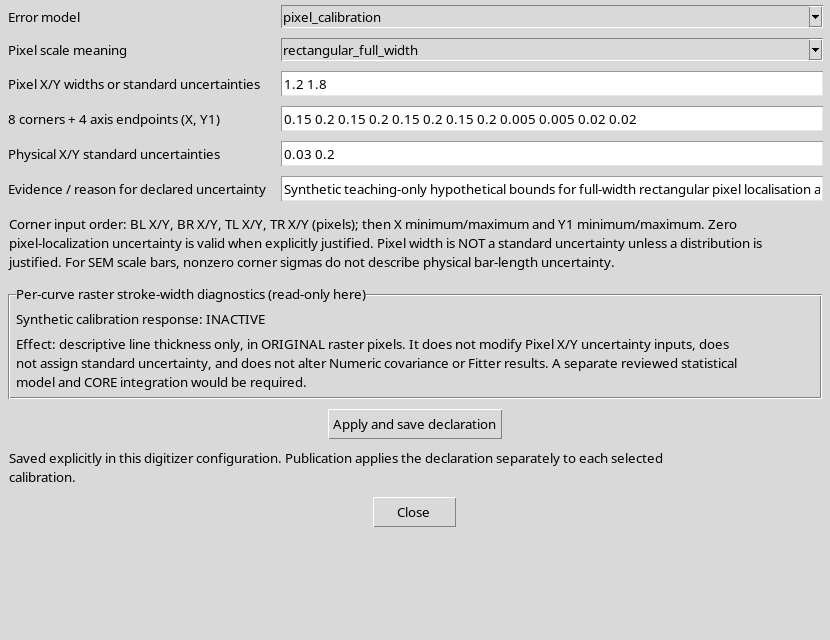
18. Dodici incertezze ipotetiche per la calibrazione
Le otto coordinate pixel degli angoli ricevono, a titolo dimostrativo, le incertezze standard alternate 0,15 px in X e 0,20 px in Y. Gli estremi X ricevono 0,005 s ciascuno; gli estremi Y 0,02 mV ciascuno.
Questi valori non sono stati misurati. Servono a costruire un esempio nel quale la trasformazione di calibrazione abbia un contributo comune e riconoscibile alla covarianza di più punti.
19. Pubblicare il modello correlato
Dopo la motivazione e Apply and save declaration, tornare a Publish e utilizzare un nuovo Dataset ID.
Le 15 righe numeriche conservano gli stessi identificativi, lo stesso ordine e le stesse coordinate dell’esempio none e di physical_override, ma ora contengono incertezze propagate dal servizio numerico pubblico.
20. Confrontare i tre Dataset
| Proprietà | none | physical_override | pixel_calibration |
|---|---|---|---|
| Coordinate X/Y | Invariate | Invariate | Invariate |
| Righe pubblicate | 15 | 15 | 15 |
| Colonne sigma/covarianza | Assenti | Presenti | Presenti |
| Contributi condivisi della calibrazione | Non dichiarati | Assenti nel modello | Presenti |
| Covarianza fra punti diversi | Non pubblicata | Nulla nel modello indipendente | Generalmente non nulla |
Una sigma marginale più piccola non dimostra un risultato più accurato se le assunzioni che l’hanno prodotta sono diverse.
21. Fattori locali e fattori condivisi
Il modello numerico conserva due tipi di contributi: un fattore Lᵢ associato al singolo punto e un fattore Sᵢ associato agli input comuni della calibrazione.
La covarianza fisica fra le coordinate dei punti i e j è:
Cov(zᵢ,zⱼ) = δᵢⱼ · LᵢLᵢᵀ + SᵢSⱼᵀ
Il primo termine esiste sulla diagonale dei punti; il secondo può produrre una covarianza anche quando i e j sono diversi. È la ragione per cui le sole colonne sigma_x e sigma_y non descrivono tutti gli effetti della calibrazione.
22. sigma_x, sigma_y e covariance_xy
Per ciascun punto il risultato contiene due incertezze standard marginali, nelle unità di X e Y, e la covarianza tra le sue coordinate.
Per la prova le unità sono s, mV e s·mV. Nel modello pixel_calibration anche covariance_xy può essere diverso da zero, perché gli input di calibrazione influenzano entrambe le coordinate scientifiche.
covariance_xy non è una correlazione adimensionale, e non va trasformata automaticamente in un peso indipendente per un fitting.
23. Che cosa significa covarianza fra punti
Quando la stessa taratura determina la posizione di più punti, la sua incertezza può introdurre movimenti coordinati nelle coordinate risultanti. La covarianza fra due punti distinti registra questa dipendenza.
Nell’esempio la matrice Y ricostruita presenta un valore assoluto massimo fuori diagonale di circa 0,000768 mV². Questo numero riguarda soltanto le ipotesi didattiche esplicitate.
24. Modificare un punto rende obsoleta la revisione
Dopo la revisione dell’incertezza, se si aggiunge un sedicesimo punto alla curva, la dichiarazione salvata non descrive più esattamente lo stesso insieme di punti e identificativi.
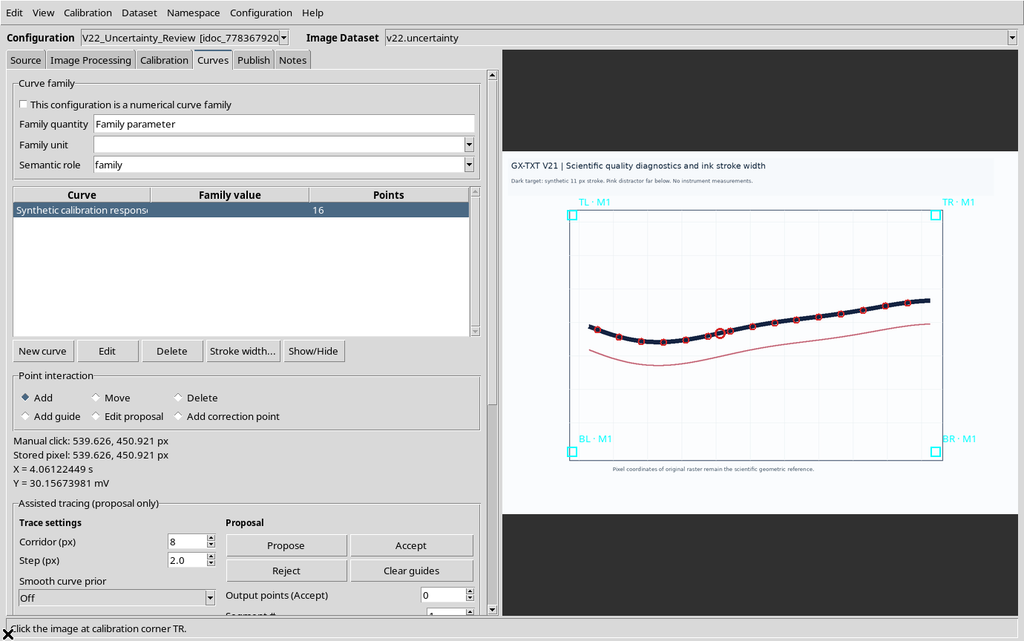
Tentando di pubblicare un altro Dataset senza effettuare una nuova revisione, la GUI blocca l’operazione.
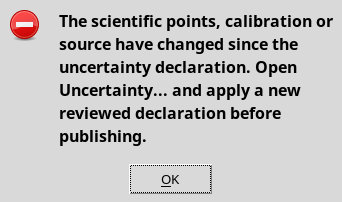
Questa protezione impedisce che fattori numerici calcolati per quindici punti vengano attribuiti silenziosamente a un Dataset diverso.
25. Undo e ripristino dei dati
Con Edit → Undo è possibile ripristinare i quindici punti precedenti.
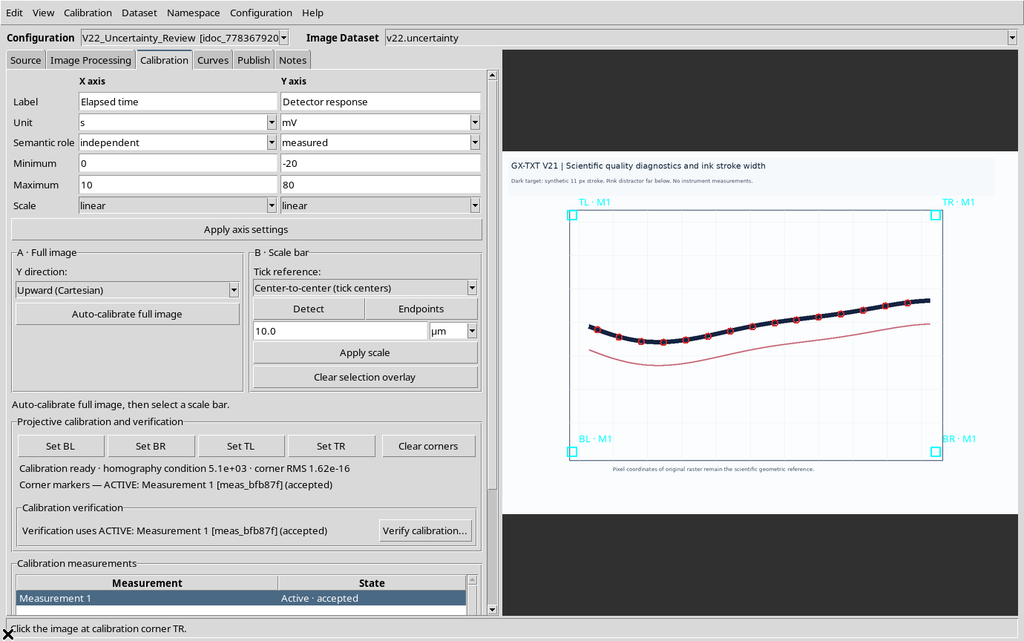
Il Dataset che era stato pubblicato prima della modifica resta comunque immutato. La revisione corrente deve essere confrontata con lo stato scientifico effettivo prima di una nuova pubblicazione.
26. normal_standard_uncertainty è una seconda convenzione
Il menu Pixel scale meaning offre anche normal_standard_uncertainty. In questa modalità il numero immesso rappresenta direttamente una sigma standard di localizzazione, non l’ampiezza completa di un intervallo rettangolare.
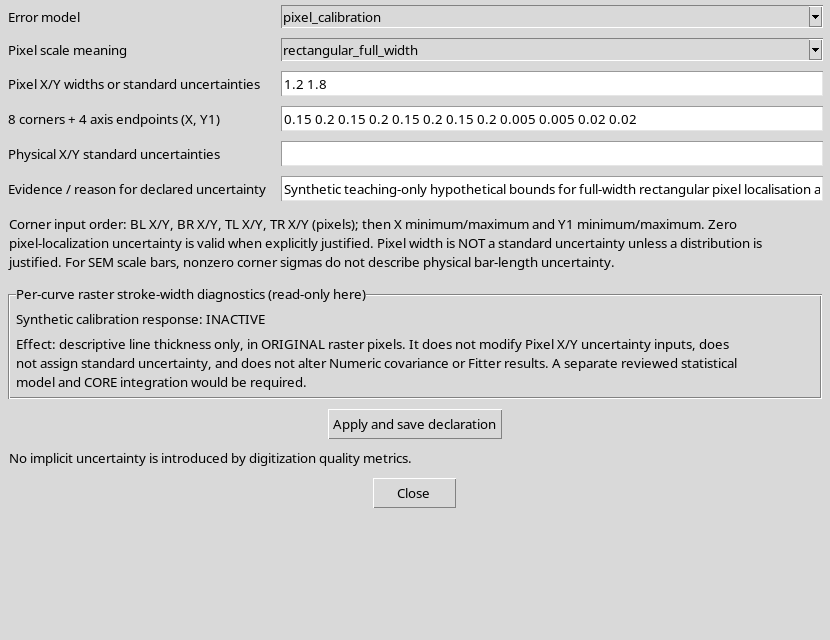
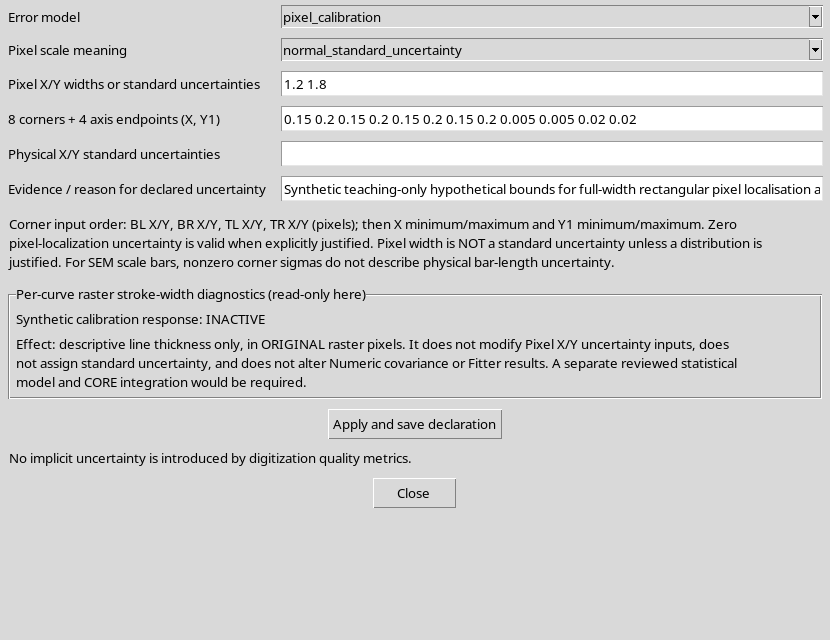
Se si cambia la scelta senza premere Apply and save declaration, riaprendo l’editor compare ancora il modello rettangolare precedentemente approvato.
Cambiare la convenzione senza cambiare i numeri può alterarne completamente il significato: va trattato come una nuova dichiarazione scientifica.
27. Save, Close e Reopen
Salvare la configurazione, chiudere normalmente il Curve Digitalizer e riaprirlo nella stessa Session.
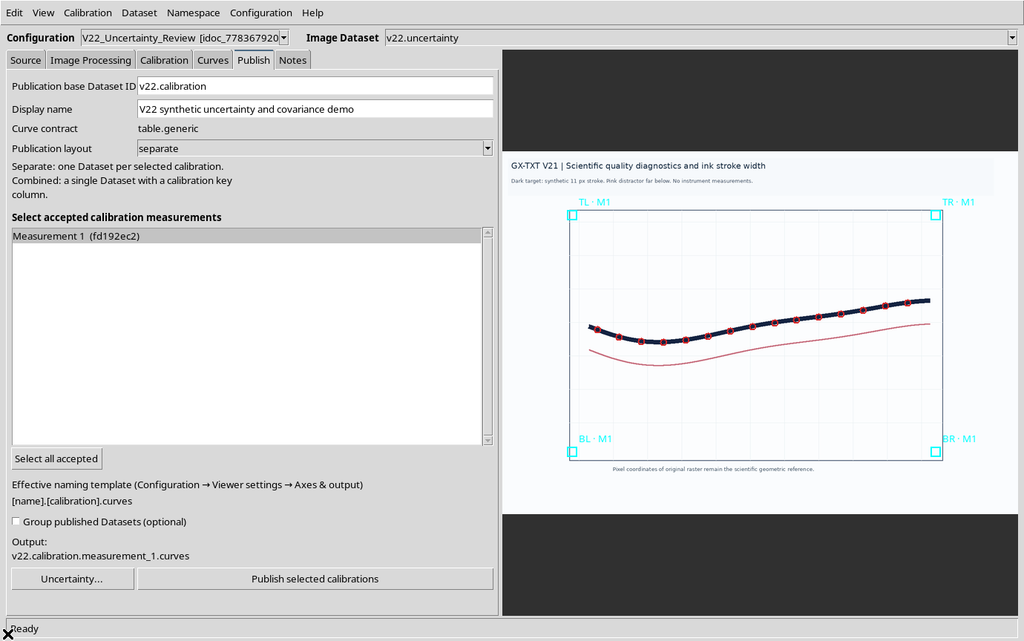
La dichiarazione resta disponibile nel documento.
La riapertura ha conservato i quindici punti, la calibrazione, l’identità della sorgente e il modello pixel_calibration con le ipotesi numeriche dichiarate.
28. Consultare i dati numerici nel CORE Viewer
Un Dataset pubblicato può essere aperto dal browser GX-TXT con il CORE Scientific Dataset Viewer, senza accedere agli oggetti privati del Curve Digitalizer.
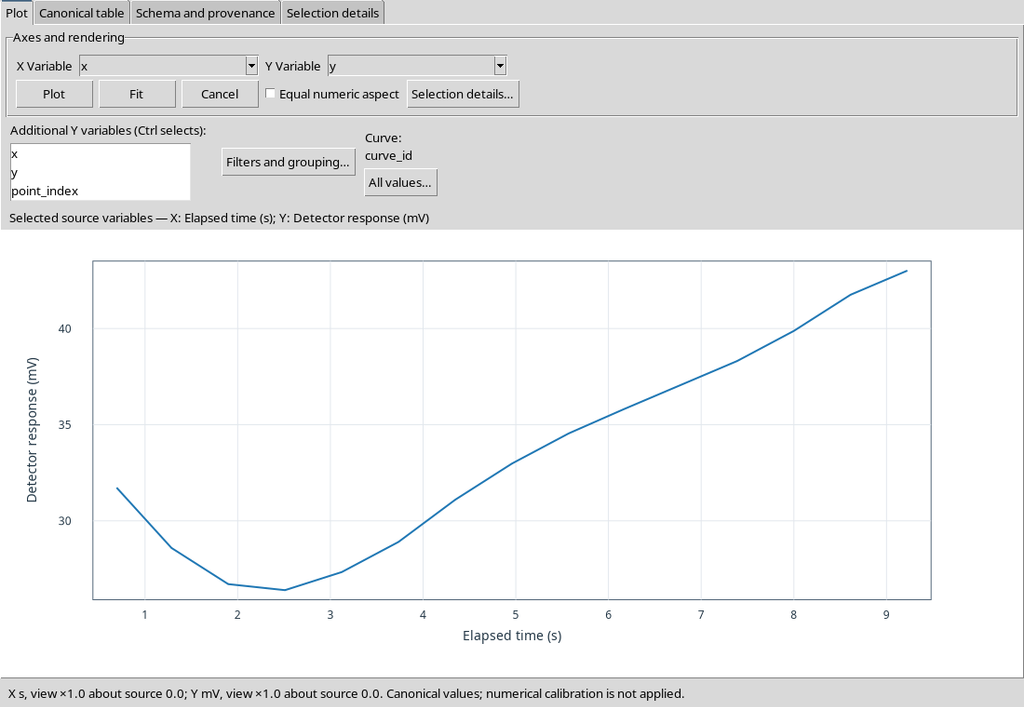
È possibile così distinguere l’Interactive Document ancora modificabile dai dati scientifici canonici già consolidati.
29. Le colonne realmente pubblicate
Nella tabella canonica compaiono X, Y, identificativi dei punti, coordinate del raster originale e le tre colonne di incertezza.
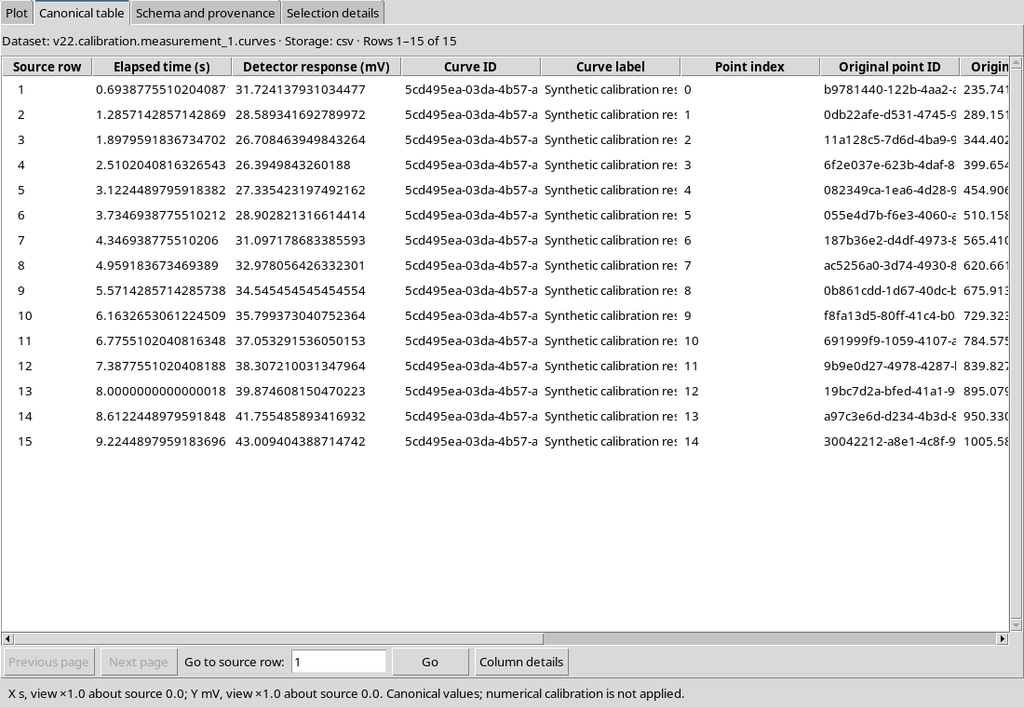
Per physical_override l’incertezza standard X è 0,03 s e la Y è 0,20 mV, senza covarianza XY. Per pixel_calibration i valori cambiano lungo la curva in base alla trasformazione e ai fattori comuni. I point_id, tuttavia, rimangono identici.
30. Schema e provenienza dei metadati
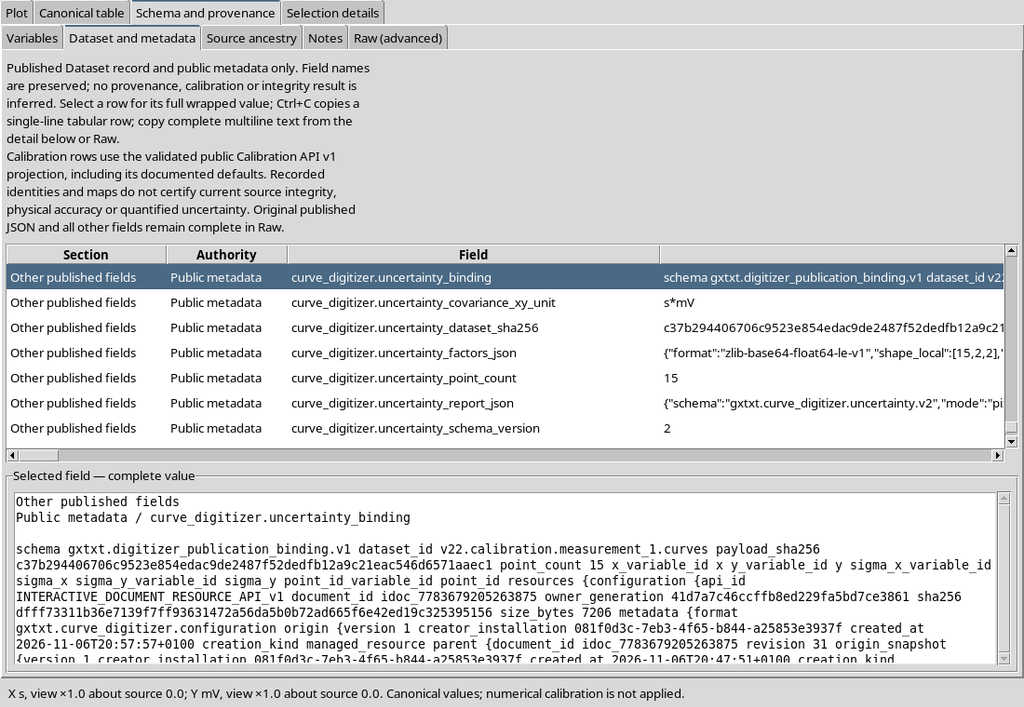
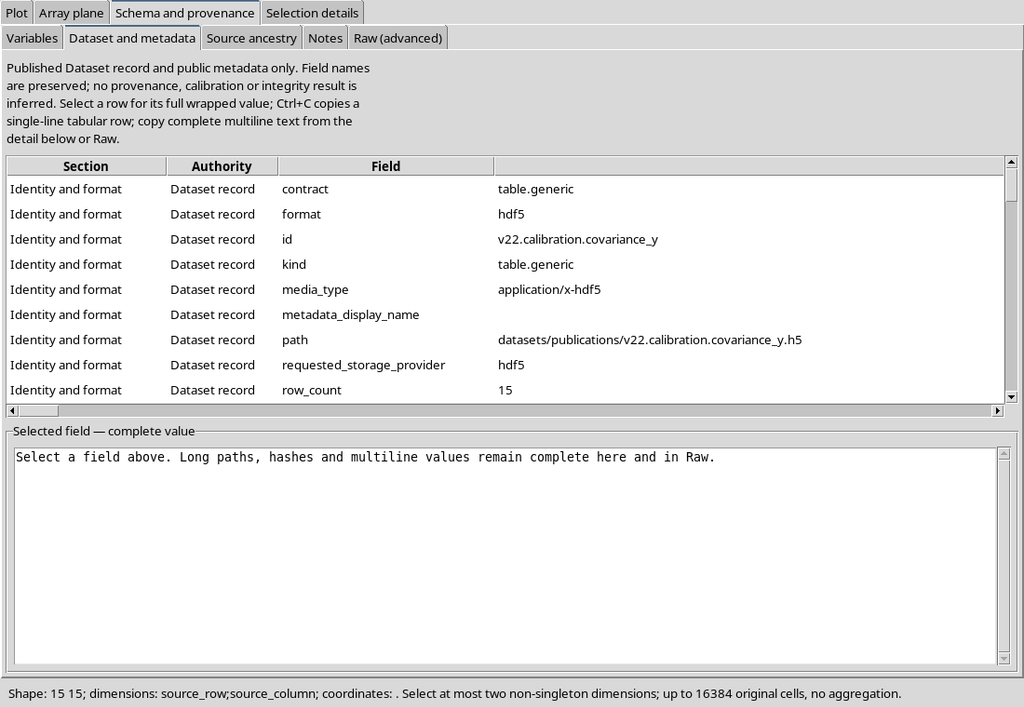
La sezione Schema and provenance contiene le chiavi pubblicate dal Curve Digitalizer.
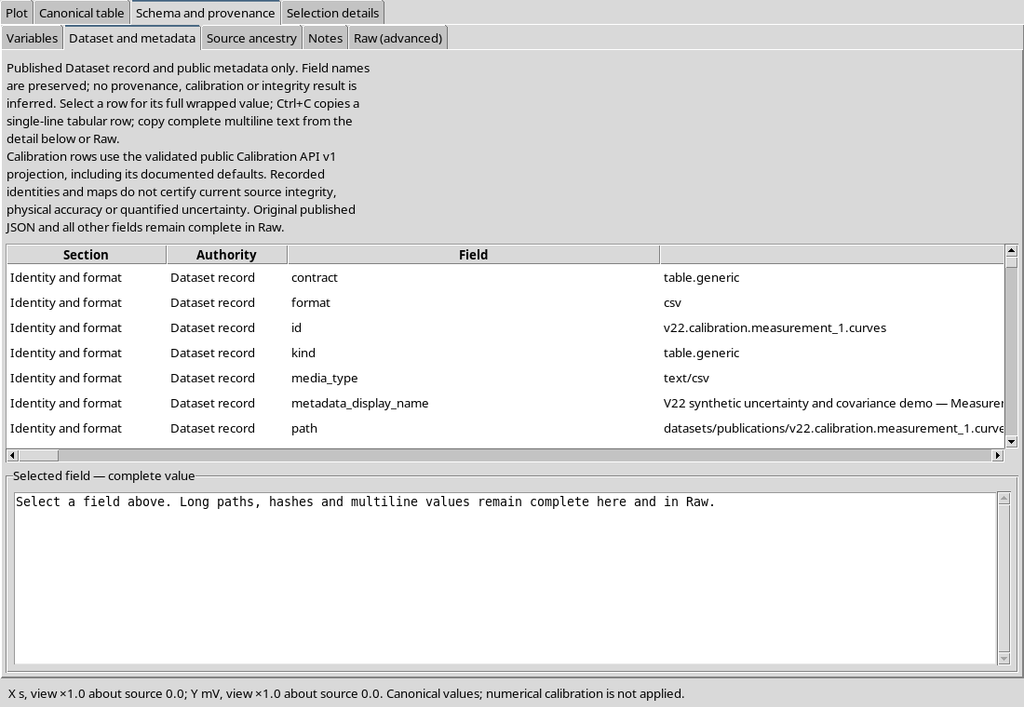
Lo schema dell’incertezza esaminato è versione 2.
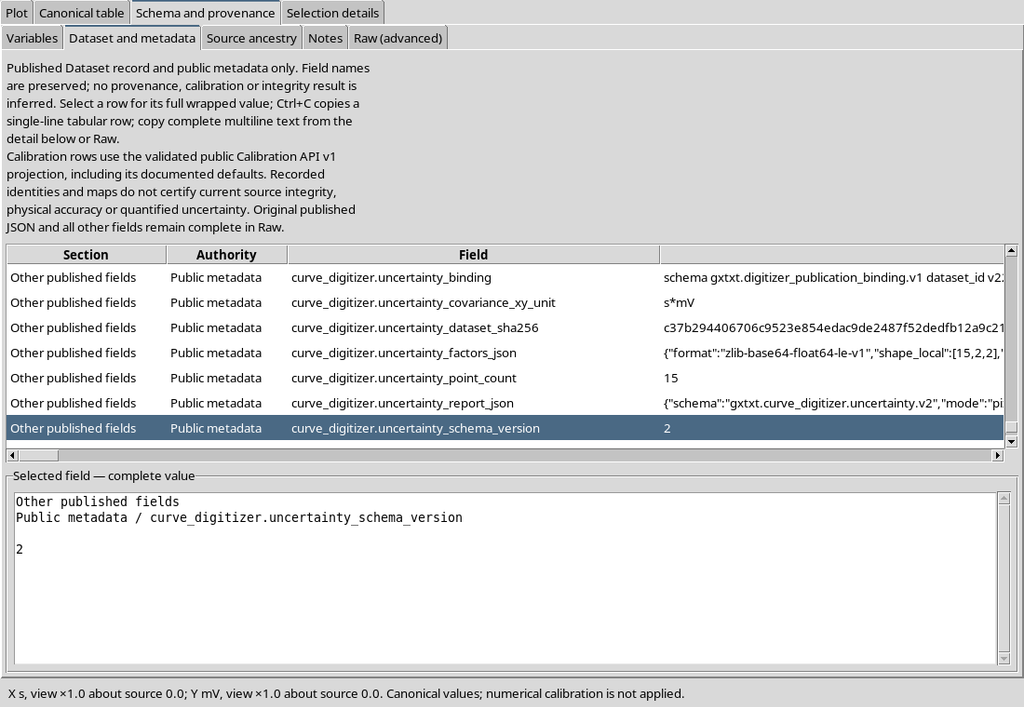
I metadati includono i riferimenti alla sorgente e ai byte canonici, necessari per verificare che la dichiarazione sia legata proprio al Dataset pubblicato.
31. Leggere il report JSON della dichiarazione
Il rapporto di incertezza registra modalità, input, motivazione, unità, calibrazione e segnalazione della presenza di fattori condivisi.
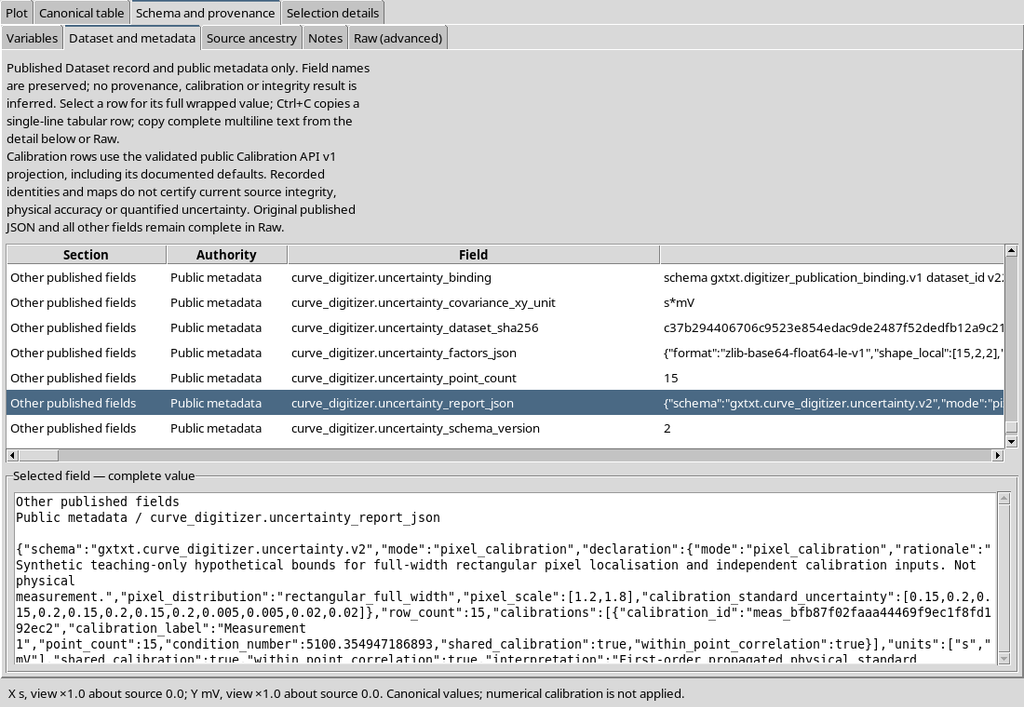
Si tratta di informazioni scientifiche portabili: un altro strumento del framework può leggerle senza conoscere la posizione dei campi dell’editor grafico.
32. Fattori compatti e identità numerica
Il modello conserva fattori locali e condivisi in forma compressa, con schema e hash dei byte numerici.
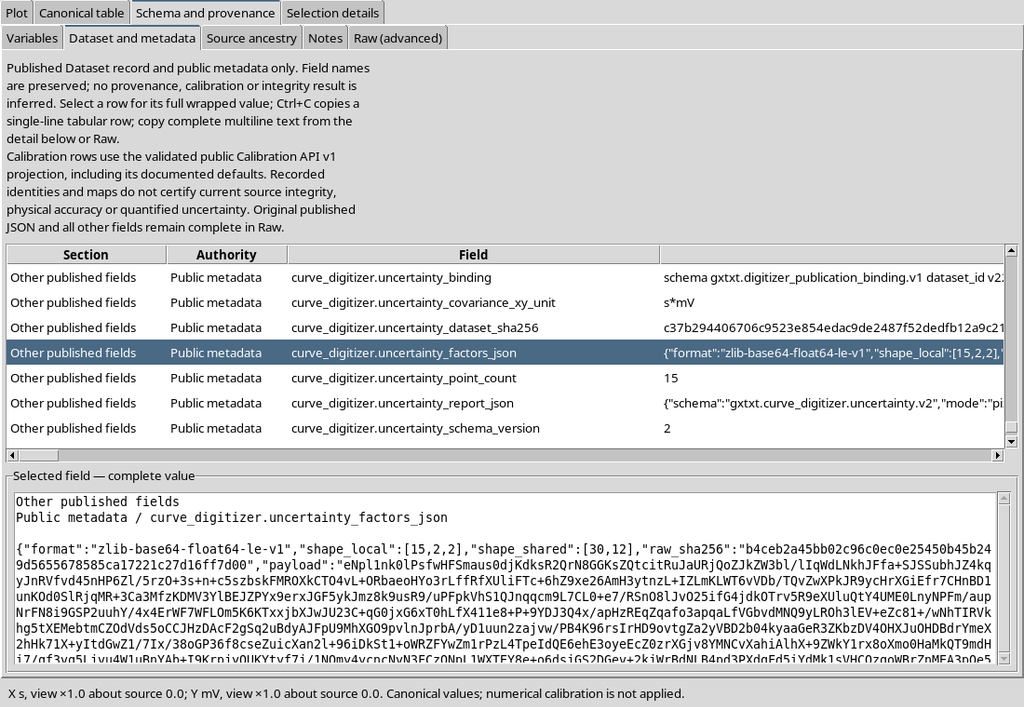
Con 15 punti e 12 input comuni, le forme sono 15 × 2 × 2 per i fattori locali e 30 × 12 per quelli condivisi. Da questi dati si può ricostruire la covarianza senza trattare erroneamente come indipendenti tutti i punti.
33. La revisione del CORE e la fonte numerica
La pubblicazione con incertezza abilitata è subordinata al servizio NUMERIC_API_v1 e all’interpretazione del CORE Statistical Result Semantics. Non basta una anteprima calcolata localmente nella GUI.
Lo SHA-256 del Dataset pubblicato viene conservato insieme alla dichiarazione.
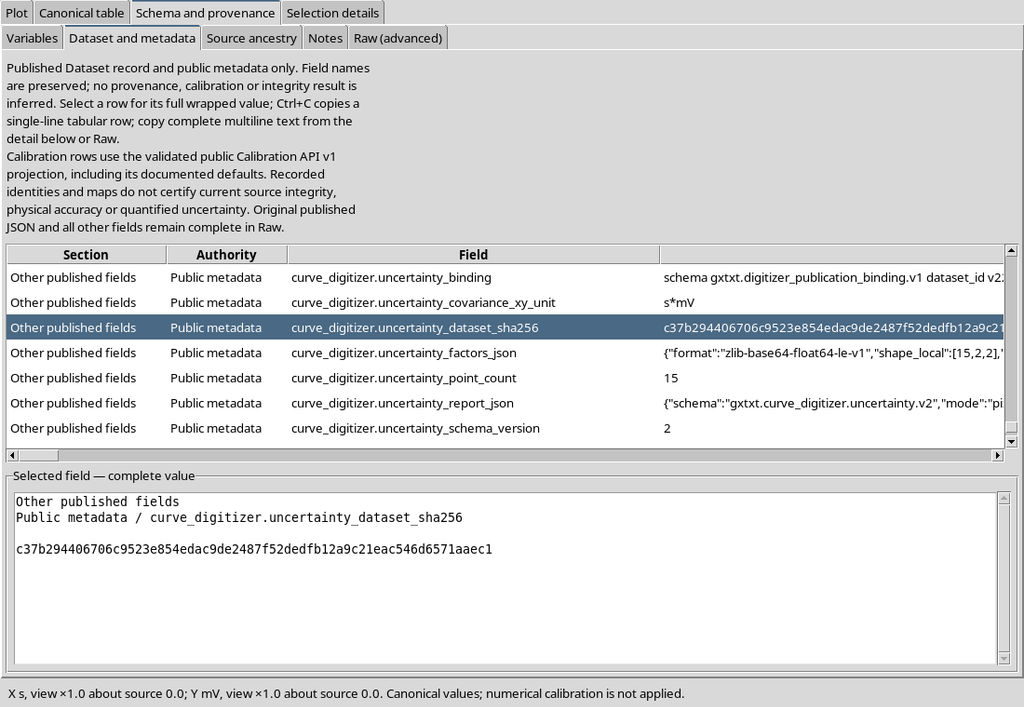
Questa identità protegge il legame fra punti, modello e risultato: modificare i byte canonici successivamente invaliderebbe la revisione.
34. Pubblicare la covarianza completa della risposta Y
Per questo esempio, la API pubblica ha autorizzato la pubblicazione di un Dataset HDF5 contenente una matrice completa 15 × 15 della risposta Y.
La matrice è un output autonomo, distinto dalle quindici righe con le sigme marginali. Nel CORE Viewer compare come variabile bidimensionale nella scheda Array plane.
I metadati documentano l’unità mV·mV, cioè la covarianza della risposta in unità fisiche al quadrato.
35. Leggere la matrice e verificare le correlazioni
Con Read plane, il CORE Viewer visualizza la matrice di covarianza.
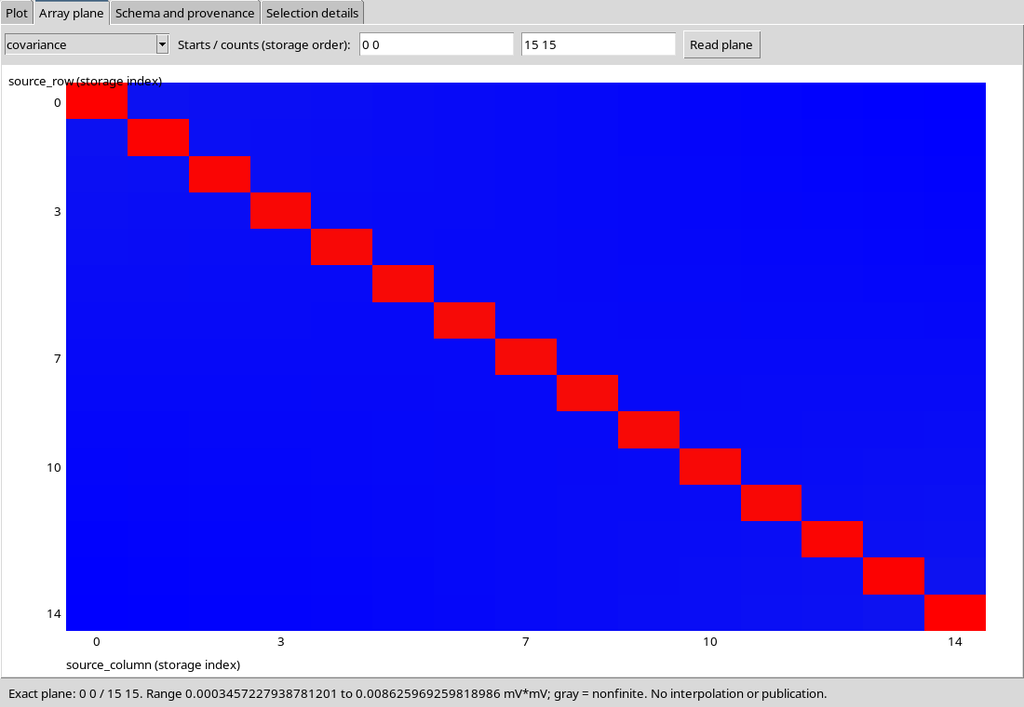
Le componenti fuori diagonale non sono nulle. L’esempio è stato controllato anche ricostruendo indipendentemente i 225 elementi mediante i fattori locali e condivisi pubblicati: la differenza assoluta massima rispetto alla matrice HDF5 è circa 5,2 × 10⁻¹⁸ mV², un residuo numerico di arrotondamento.
Questo dimostra la coerenza tecnica dei risultati di questo test, non l’esattezza di una misura strumentale.
36. Un Dataset per ogni significato
Nel browser Dataset risultano disponibili la sorgente e gli output separati:
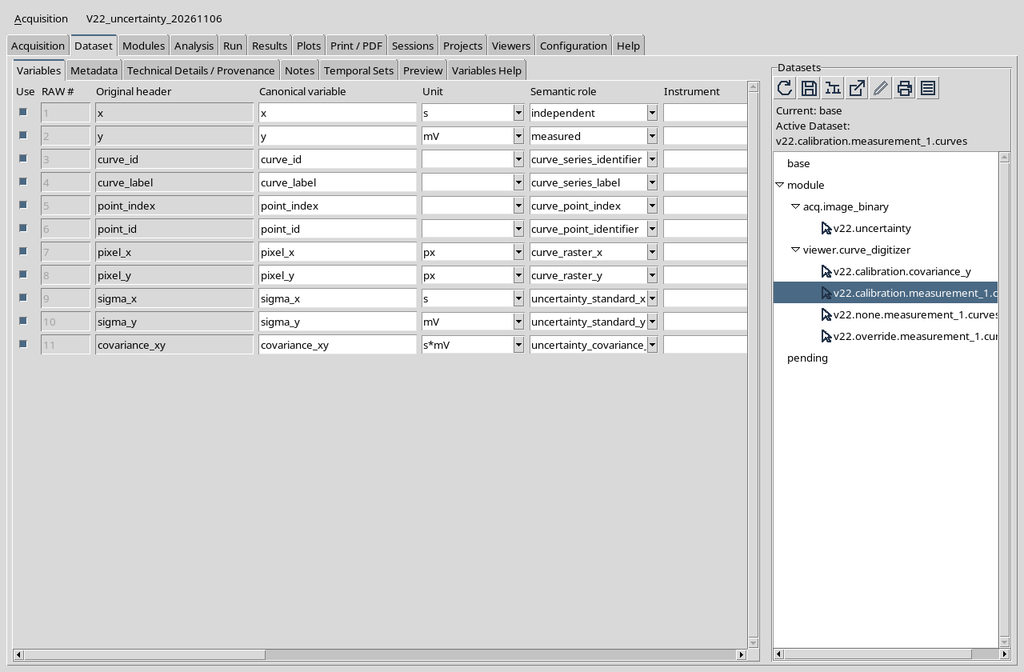
Il Dataset none conserva soltanto i punti; physical_override contiene le due sigme dichiarate; pixel_calibration contiene la propagazione di localizzazione e calibrazione; il Dataset covariance_y aggiunge la matrice Y completa.
Un report già pubblicato non viene riscritto automaticamente quando si modificano più tardi i punti nel Viewer.
37. Leggere le API pubbliche e qualificare il fitting
Esempio Tcl da eseguire nell’ambiente GX-TXT con una Session attiva. Sostituire l’identificativo esemplificativo del Dataset con quello effettivamente pubblicato:
# Activate the public, versioned Curve Digitalizer uncertainty API.
::GX::modulePublicApiActivate viewer.curve_digitizer CURVE_DIGITIZER_UNCERTAINTY_API_v1

set dataset_id "example.published.curves"
if {![::GX::CurveDigitizerUncertainty::hasReport $dataset_id]} {
    error "A CORE-reviewed uncertainty report is required."
}

# Read the validated declaration and its original-row factor model.
set report [::GX::CurveDigitizerUncertainty::read $dataset_id]
set details [::GX::CurveDigitizerUncertainty::reportJson $dataset_id]
set factors [::GX::CurveDigitizerUncertainty::factorsJson $dataset_id]

# Inspect the authoritative CORE interpretation before using the model.
set reviewed [::GX::CurveDigitizerUncertainty::coreMeaning $dataset_id]
La stessa API pubblica dispone di publishCovariance(datasetId, outputId, axis), per pubblicare una matrice completa quando il CORE ne autorizza l’interpretazione. L’operazione genera un nuovo Dataset canonico: va eseguita deliberatamente con un identificativo di uscita libero.
Il CORE ha giudicato ammissibile, per questo esempio, il piano full_response_covariance / y_of_x. Questa qualifica riguarda la covarianza della risposta per un eventuale GLS: l’incertezza del predittore X non è inclusa. Non equivale a un fit già eseguito né autorizza automaticamente qualunque algoritmo ODR o GLS.
38. Limiti scientifici e operativi
Le incertezze dichiarate sono standard, condizionate alle distribuzioni e al modello di calibrazione forniti. Non sono intervalli di confidenza, né una stima automatica dell’accuratezza.
Il contratto pubblicato prevede limiti di 4096 righe per la propagazione e 512 righe per la materializzazione della matrice completa. Il modello monoasse utilizza dodici input condivisi; un sistema con Y1/Y2 ne utilizza quattordici. La guida qui riportata esercita esclusivamente il caso monoasse.
Quando più calibrazioni vengono pubblicate con incertezze dichiarate, vanno trattate come realizzazioni separate finché non esiste un modello convalidato delle correlazioni incrociate. Inoltre, una barra di scala fisica non è descritta automaticamente dalle incertezze degli otto angoli di una omografia.
I rapporti Quality e Stroke width non sostituiscono una dichiarazione fisica. Nel rapporto Quality lo stato dell’accuratezza rimane not_assessed: una dichiarazione di incertezza standard, anche se propagata dal CORE, non rappresenta una verifica dell’accuratezza dello strumento.
39. Procedura di verifica consigliata
- Conservare il raster originale e controllare la calibrazione prima di acquisire i punti.
- Pubblicare senza incertezza quando non è disponibile un modello giustificato: non inventare sigme.
- Se si dispone di dati metrologici, scegliere physical_override o pixel_calibration secondo il significato reale degli input.
- Specificare unità, distribuzione, valori e motivazione; non lasciare il modello implicito.
- Premere Apply and save declaration e controllare che la revisione sia stata registrata.
- Dopo qualunque modifica ai punti, alla sorgente o alla calibrazione, riesaminare la dichiarazione prima di pubblicare.
- Controllare nei metadati pubblici lo schema dell’incertezza, lo SHA del Dataset e l’esito della revisione Numeric.
- Se servono correlazioni tra punti, leggere i fattori condivisi o pubblicare una covarianza completa tramite la API pubblica autorizzata.
- Per il fitting, usare il piano scientifico del CORE e verificare quali variabili e correlazioni siano effettivamente incluse.
La conclusione è centrale: una covarianza numericamente ben calcolata è valida soltanto rispetto a ipotesi metrologiche esplicite e giustificate. GX-TXT può conservarle, propagarle e renderle verificabili; non può ricavare una precisione strumentale dal solo aspetto del grafico.