

Pubblicare curve indipendenti e famiglie numeriche
Una stessa immagine può contenere più tracciati. Il Curve Digitalizer di GX-TXT permette di acquisirli come curve scientifiche indipendenti, ciascuna con una propria identità, oppure come famiglia numerica, nella quale a ogni curva è associata una condizione fisica.
Le due modalità non richiedono di digitalizzare nuovamente i punti. Cambia invece la struttura del Dataset pubblicato: per le curve indipendenti viene utilizzato table.generic, per la famiglia curve_family.table. In entrambi i casi il raggruppamento dei punti dipende dalla chiave della curva e non dalla sua etichetta visibile.
L’esempio è un raster sintetico didattico, non un esperimento strumentale. La guida riguarda una sola calibrazione accettata e il layout di pubblicazione separate. La gestione di più calibrazioni, layout combined e regole avanzate di naming viene trattata separatamente.
1. Una sorgente con cinque tracciati
L’immagine originale presenta cinque linee colorate su una griglia, con una legenda che associa a ciascuna linea una condizione Grid bias compresa fra −2 e +2 V.
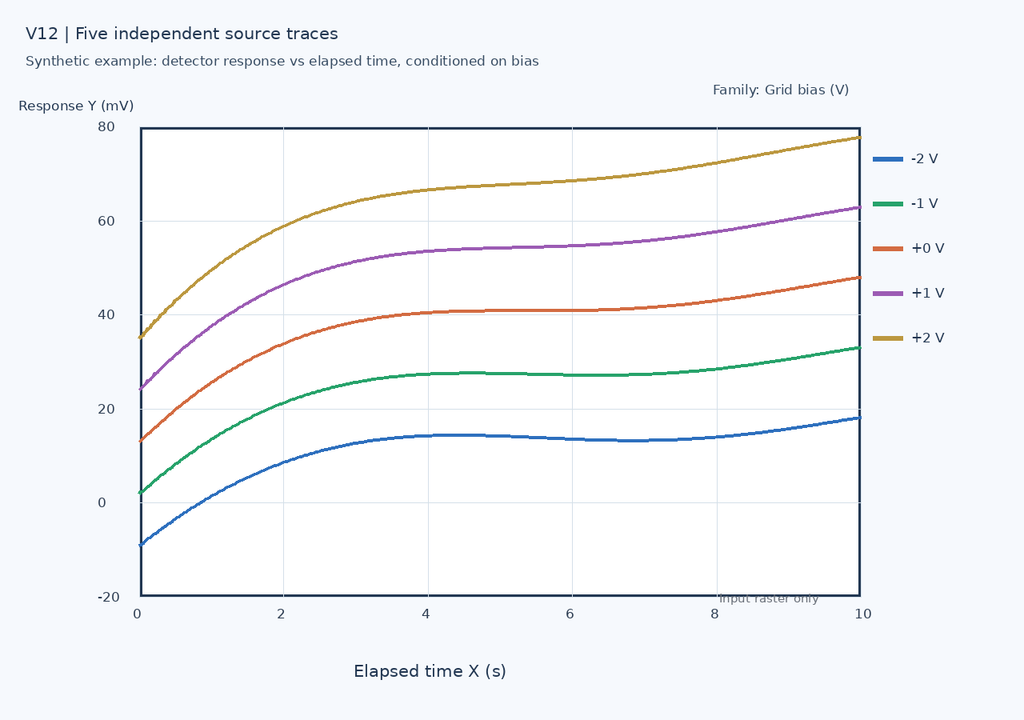
Il file misura 1280 × 900 pixel. La presenza di cinque linee nella figura non produce automaticamente cinque curve numeriche: sono necessari l’associazione alla sorgente, la calibrazione e l’acquisizione dei punti.
2. Definire la calibrazione scientifica comune
Nella scheda Calibration impostare le grandezze Elapsed time e Detector response, con unità rispettivamente s e mV. I limiti sono X = 0–10 s e Y = −20–80 mV.
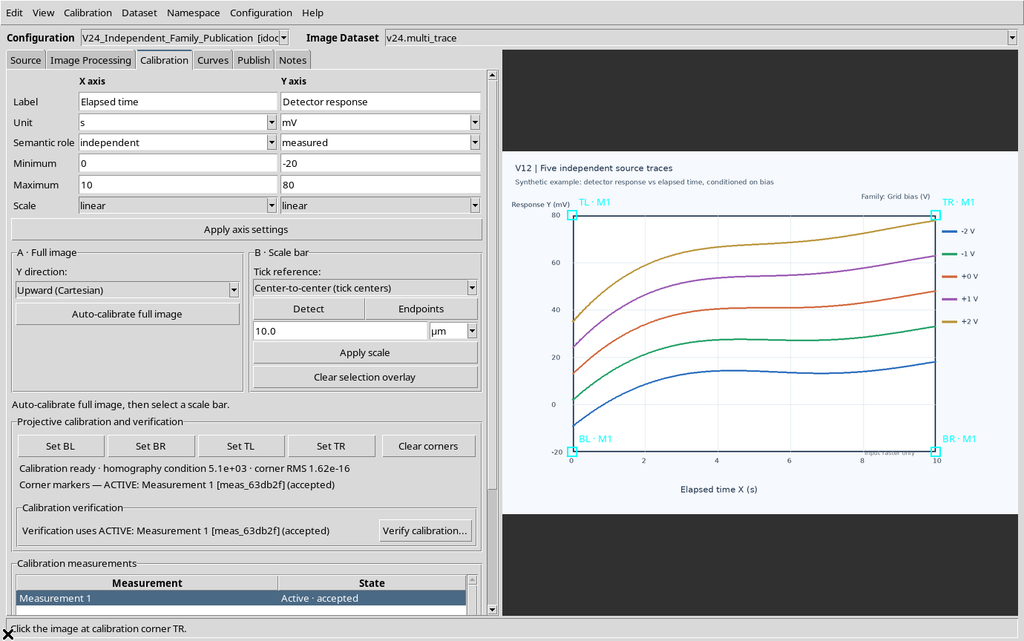
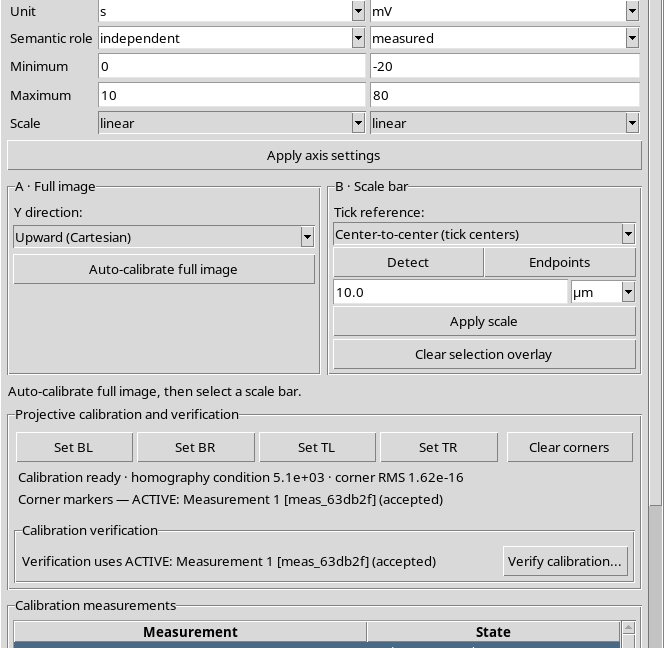
Selezionare i quattro angoli del rettangolo originale e accettare la misura. La stessa trasformazione è valida per tutte le cinque curve perché condividono la medesima immagine e i medesimi assi.
3. Differenza fra una curva e un Dataset
Una curva è una serie di punti scientifici con un identificativo proprio. Un Dataset è l’oggetto canonico pubblicato da GX-TXT, che può contenere più curve.
In modalità indipendente, cinque curve possono quindi essere raccolte in un solo Dataset tabellare. Il Dataset dovrà conservare sia le coordinate dei punti, sia un campo che dica a quale curva appartenga ogni riga.
4. Creare la prima curva indipendente
Nella scheda Curves, mantenere disabilitato This configuration is a numerical curve family. Premere New curve e assegnare un nome alla prima linea.
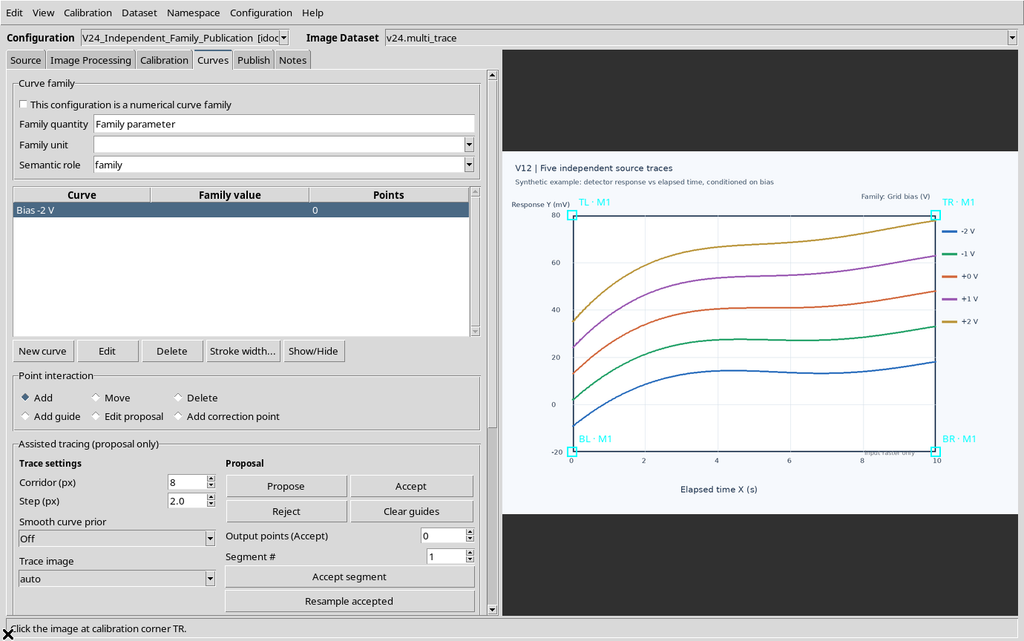
Il nome è descrittivo. L’identificativo scientifico della curva viene attribuito internamente dal framework e non deve essere ricostruito dal testo del nome.
5. Aggiungere una seconda curva
Ripetere New curve per il secondo tracciato.
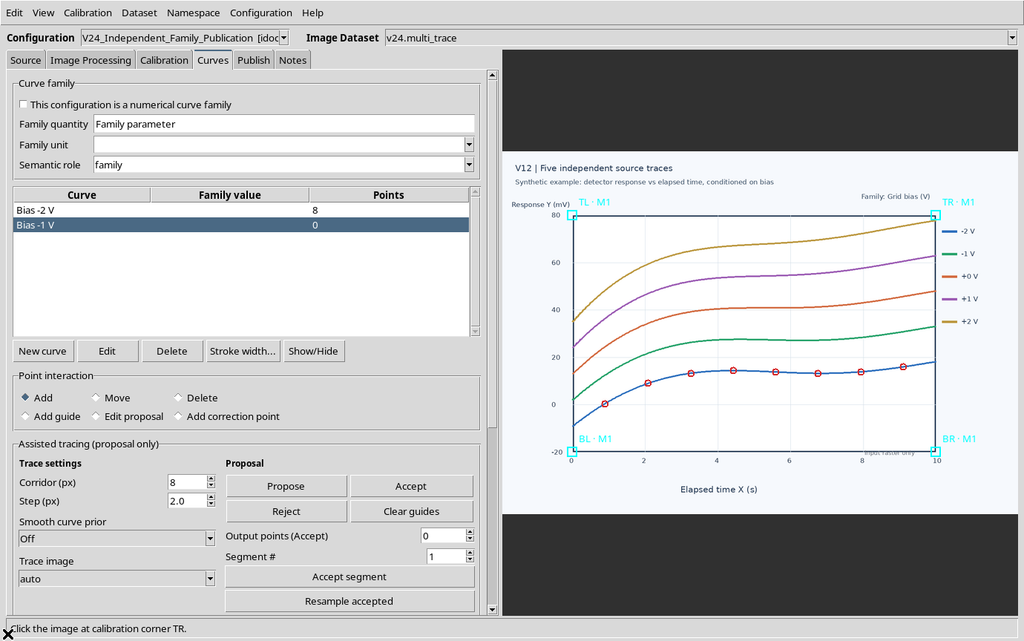
Ogni nuova curva compare in una riga separata e può essere selezionata per acquisire, correggere o visualizzare soltanto i suoi punti.
6. Aggiungere le altre tre curve
Creare anche le curve successive, mantenendo il rapporto con le rispettive tracce della figura.
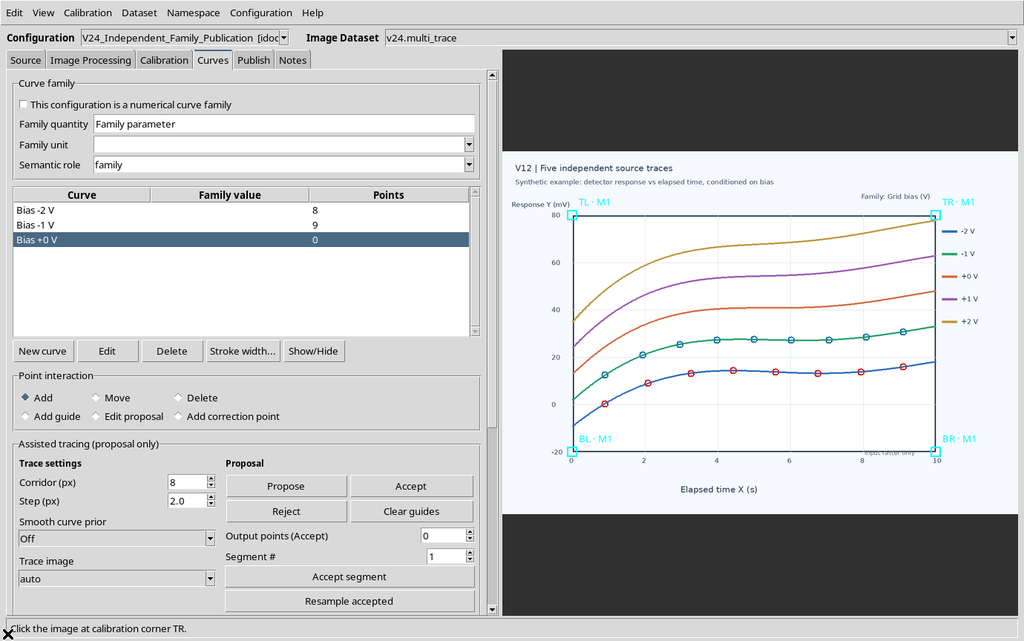
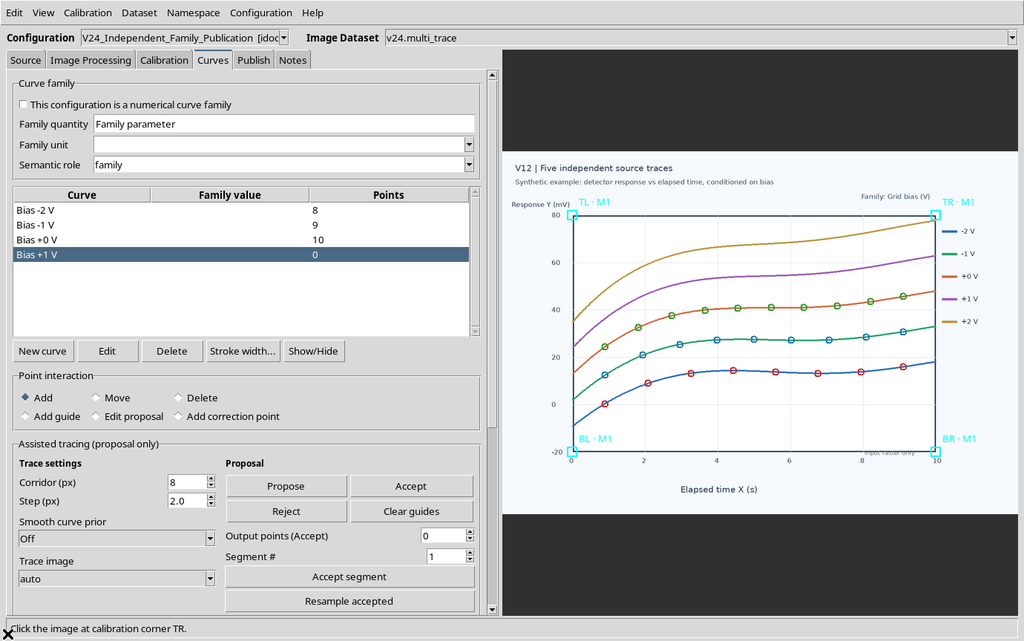
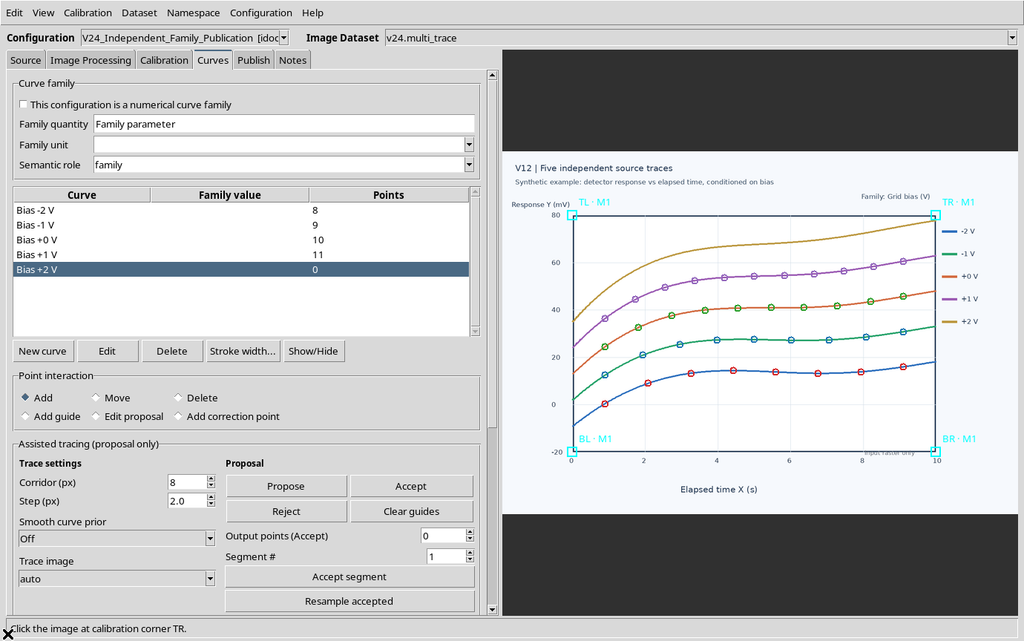
I cinque nomi riportano le condizioni indicate nella legenda, ma in questa prima modalità non esiste ancora un vero parametro numerico family_value: i valori nel nome sono soltanto testo.
7. Acquisire i punti manuali
Selezionare una curva alla volta, usare la modalità Add e cliccare sul corrispondente tratto del raster.
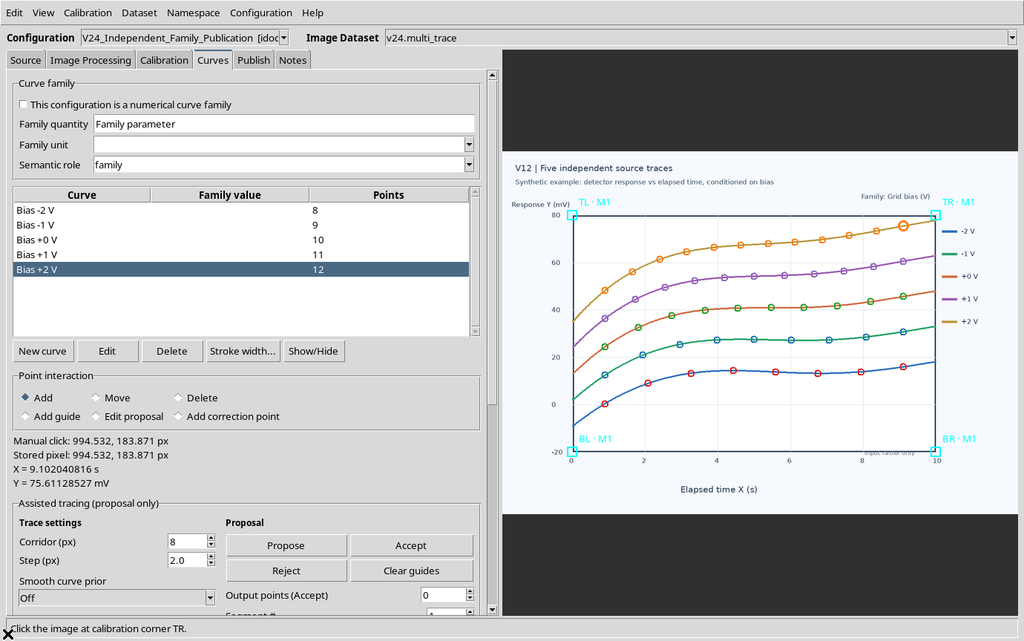
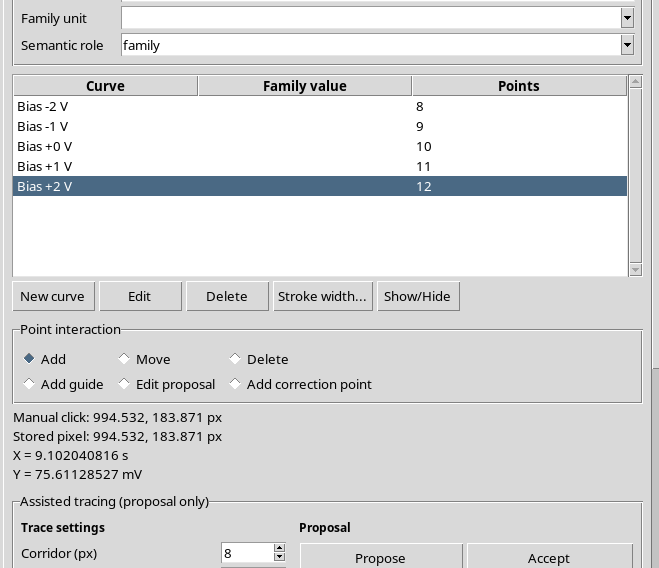
Nell’esempio i cinque tracciati hanno rispettivamente 8, 9, 10, 11 e 12 punti, per un totale di 50 punti scientifici. Il numero diverso di punti non impedisce di rappresentarli come curve autonome.
8. Identificare e ordinare i punti
La serie possiede una propria chiave curve_key. Ogni punto ha un ordine point_order, che in questa configurazione parte da zero all’interno della serie.
| Curva didattica | Punti | Indici interni |
|---|---|---|
| Bias −2 V | 8 | 0–7 |
| Bias −1 V | 9 | 0–8 |
| Bias 0 V | 10 | 0–9 |
| Bias +1 V | 11 | 0–10 |
| Bias +2 V | 12 | 0–11 |
Non assumere che curve_name sia una chiave unica: è un’etichetta modificabile. Non assumere neppure che point_order equivalga sempre a un ordinamento per X: il comportamento dipende dalla politica scelta in Digitizing.
9. Preparare la pubblicazione indipendente
Aprire la scheda Publish. Selezionare l’unica calibrazione accettata e impostare un Publication base Dataset ID distinto da quello della sorgente.
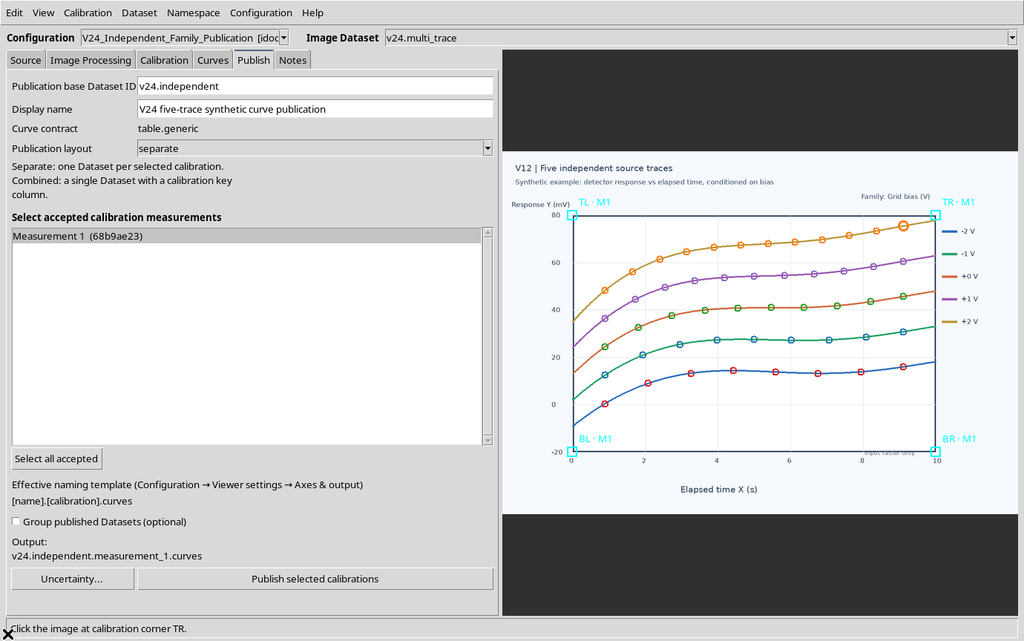
Per questo percorso utilizziamo il layout separate e una sola realizzazione della calibrazione. Non stiamo confrontando più calibrazioni né creando un Dataset Group.
10. Pubblicare il Dataset table.generic
Premere Publish selected calibrations. GX-TXT verifica la sorgente, la calibrazione e la struttura delle righe, quindi registra l’output canonico.
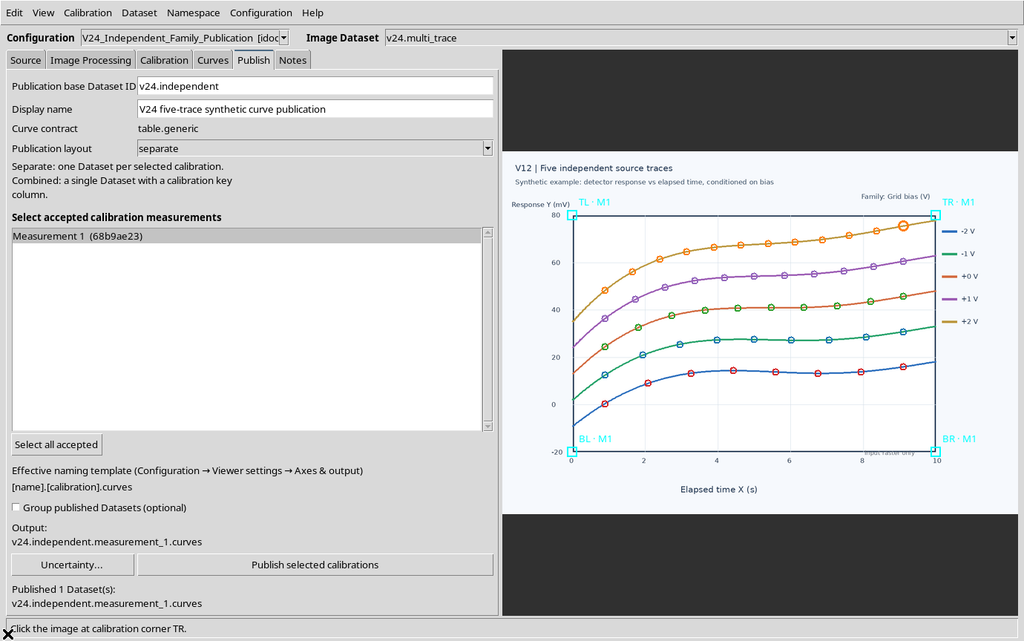
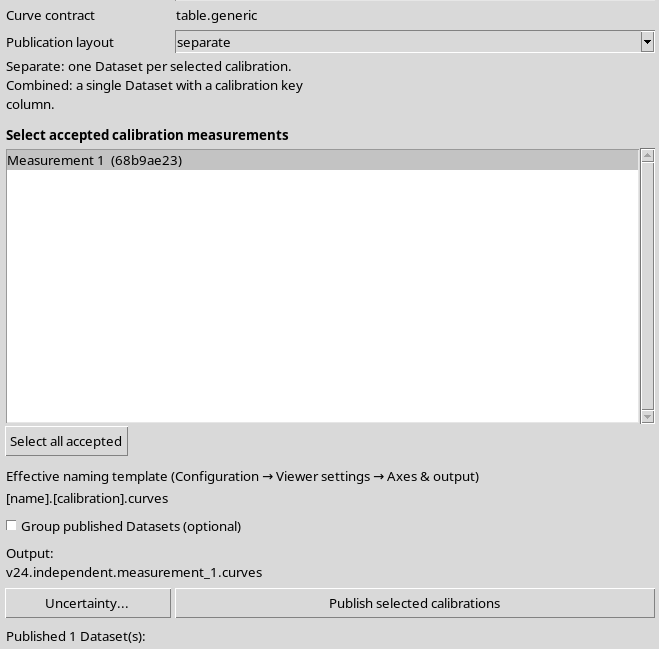
Il risultato contiene 50 righe numeriche nel contratto table.generic, benché le curve siano cinque.
11. Aprire il risultato dal catalogo Dataset
Nel browser Dataset della Session è disponibile il nuovo Dataset numerico. Selezionarlo e aprirlo con il comando nativo.
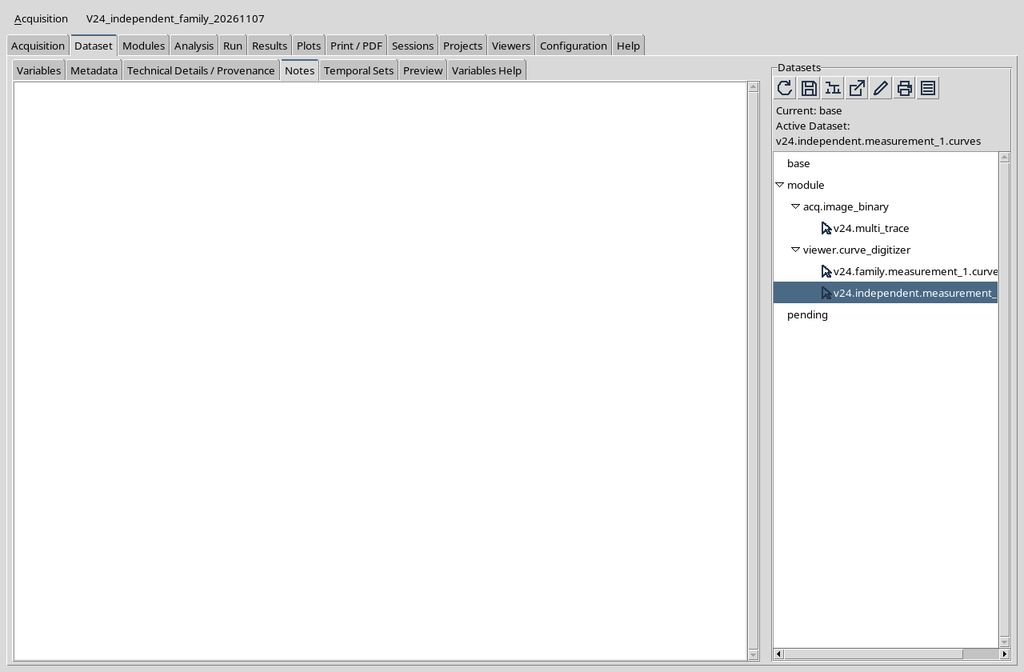
Il risultato resta indipendente dall’Interactive Document del Curve Digitalizer. Per consultare le righe non è necessario mantenere aperta la finestra in cui sono state create.
12. La tab Plot del Viewer scientifico CORE
Il CORE Scientific Dataset Viewer offre una scheda Plot e una tabella canonica.
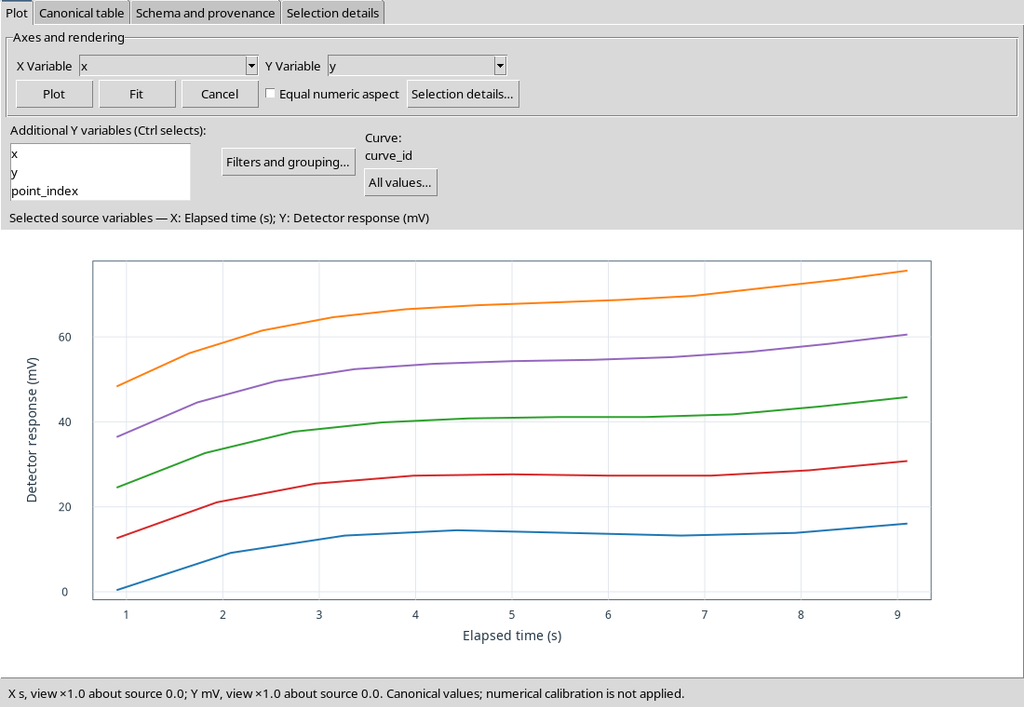
Il grafico generico non sostituisce la semantica delle curve: un consumatore deve riconoscere curve_key e distinguere le serie, anziché collegare indiscriminatamente tutti i punti X/Y della tabella.
13. Il formato lungo dei dati indipendenti
Aprire Canonical table.
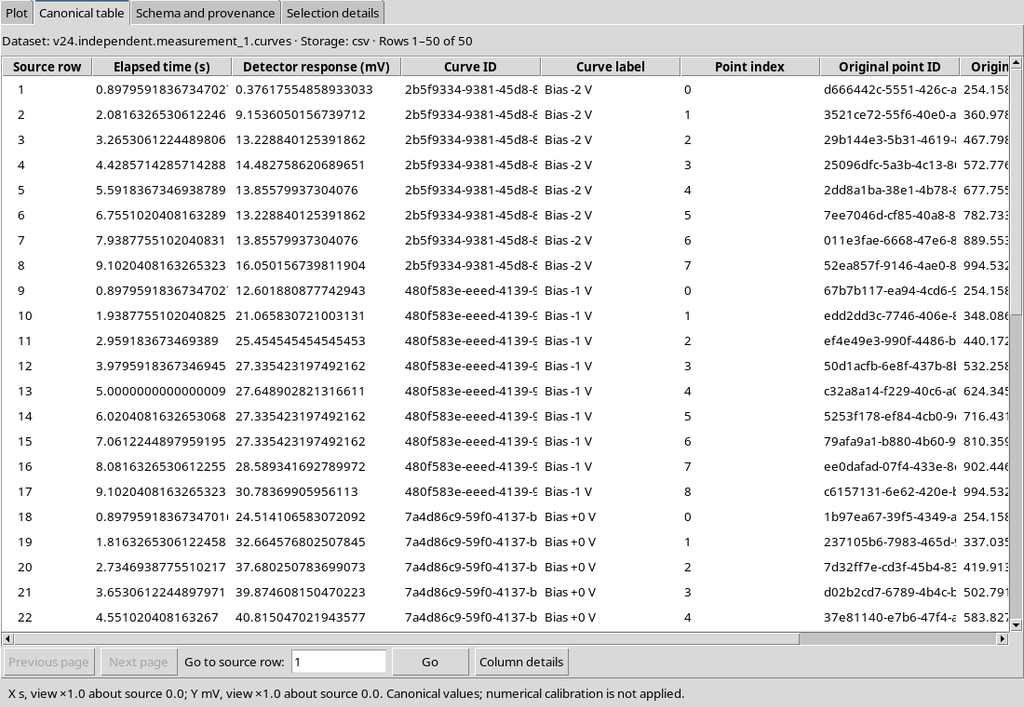
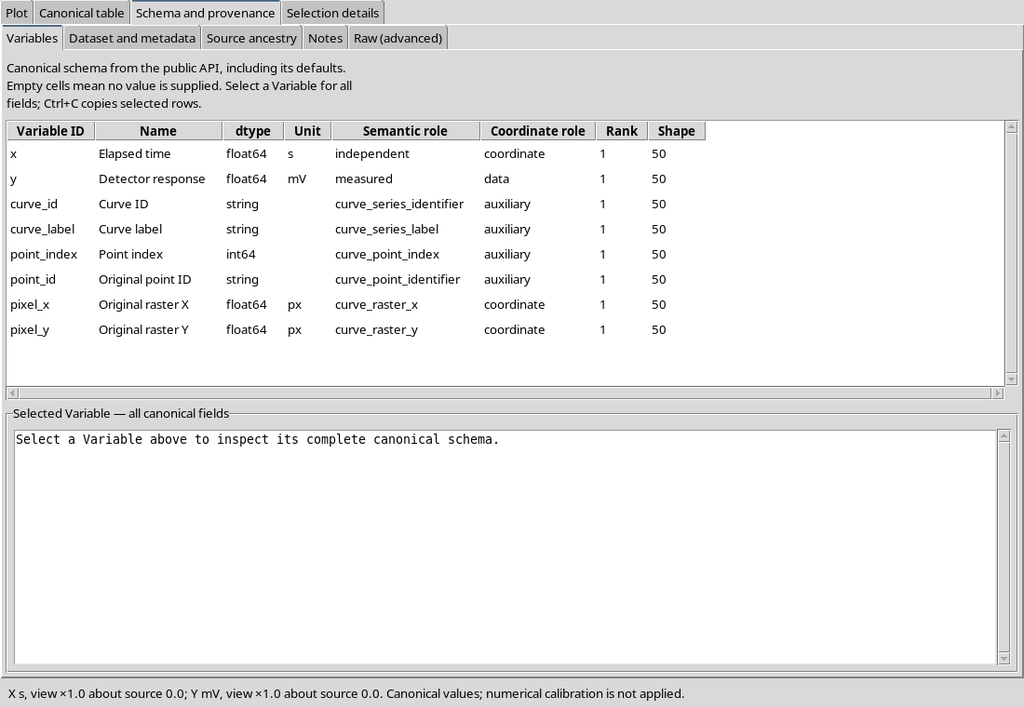
La pubblicazione include, nell’implementazione esaminata, le variabili tecniche x, y, curve_id, curve_label, point_index, point_id, pixel_x e pixel_y. Ogni riga rappresenta un punto.
Questi nomi tecnici sono utili per leggere l’esempio, ma gli strumenti futuri dovrebbero risolvere le colonne tramite i ruoli semantici pubblici.
14. Il contratto semantico indipendente
La pubblicazione conserva metadati che identificano la modalità independent, il contratto table.generic, l’immagine originale e la calibrazione.
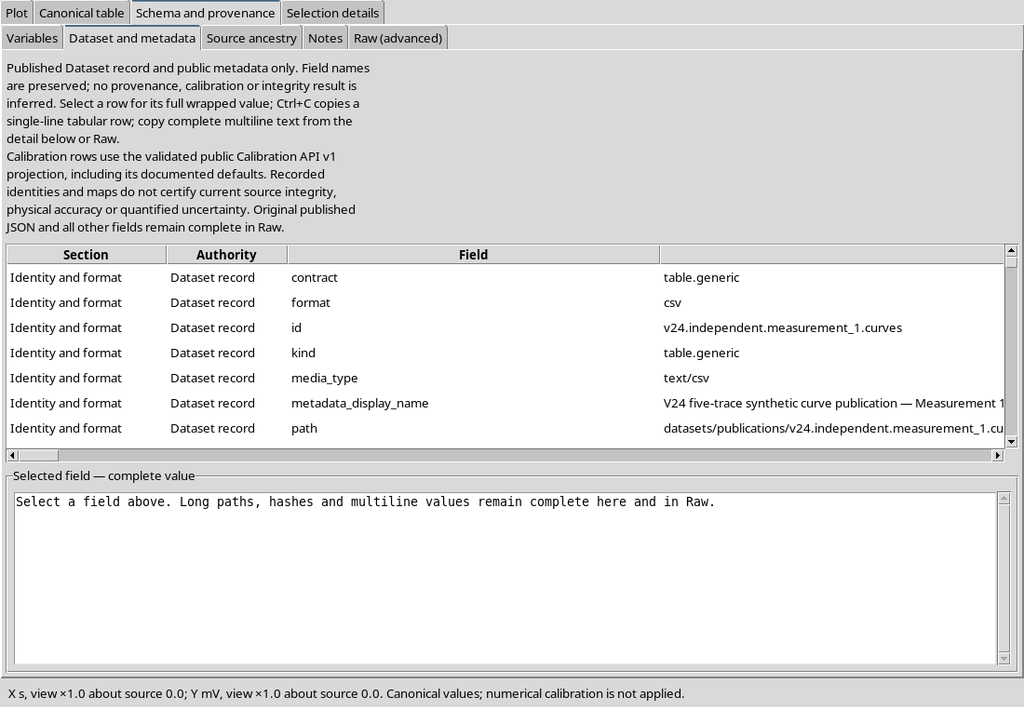
I ruoli principali sono:
| Ruolo stabile | Significato |
|---|---|
| x, y | Coordinate scientifiche calibrate |
| curve_key | Identità opaca della curva |
| curve_name | Etichetta visibile della curva |
| point_order | Ordine del punto nella curva |
| raster_x, raster_y | Coordinate pixel dell’immagine originale |
La chiave opaca è la base del raggruppamento. Il titolo della curva può cambiare senza cambiare necessariamente la sua identità.
15. Variable Schema v3 del Dataset indipendente
Nella sezione Variables del CORE si trovano otto variabili, comprese le coordinate raster.
Selezionando il campo identificativo della curva si può verificarne il tipo testuale.
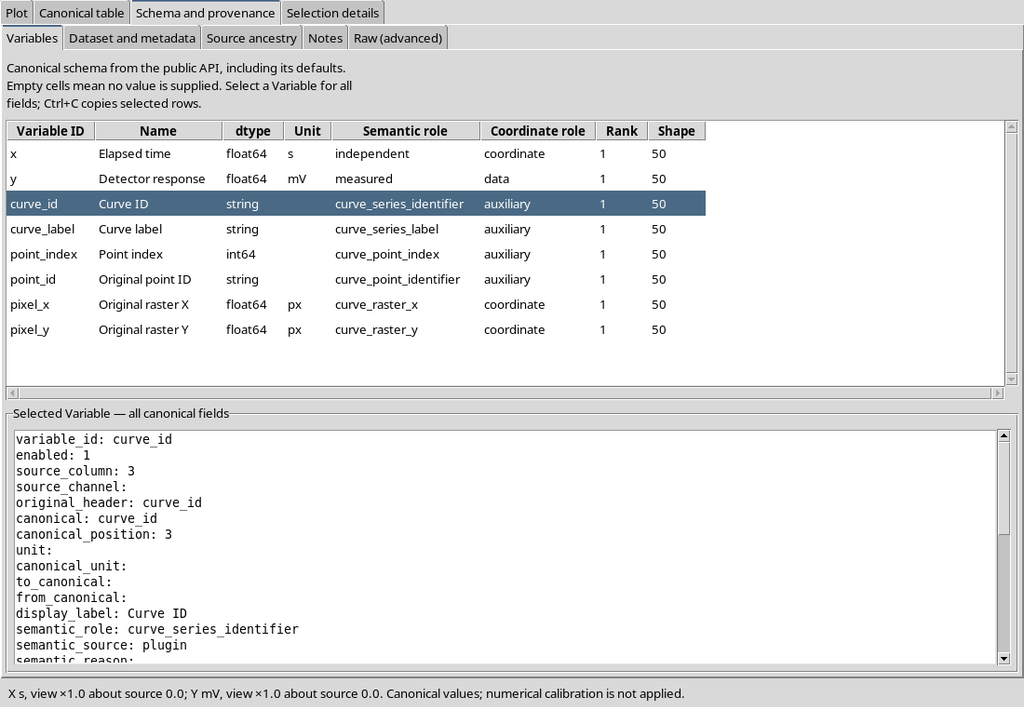
In questa pubblicazione non è presente una colonna numerica family_value. Un’etichetta contenente «−2 V» non è sufficiente a trasformare la struttura in una famiglia.
16. Attivare numerical curve family
Ritornare alla scheda Curves del Digitalizer e abilitare This configuration is a numerical curve family.
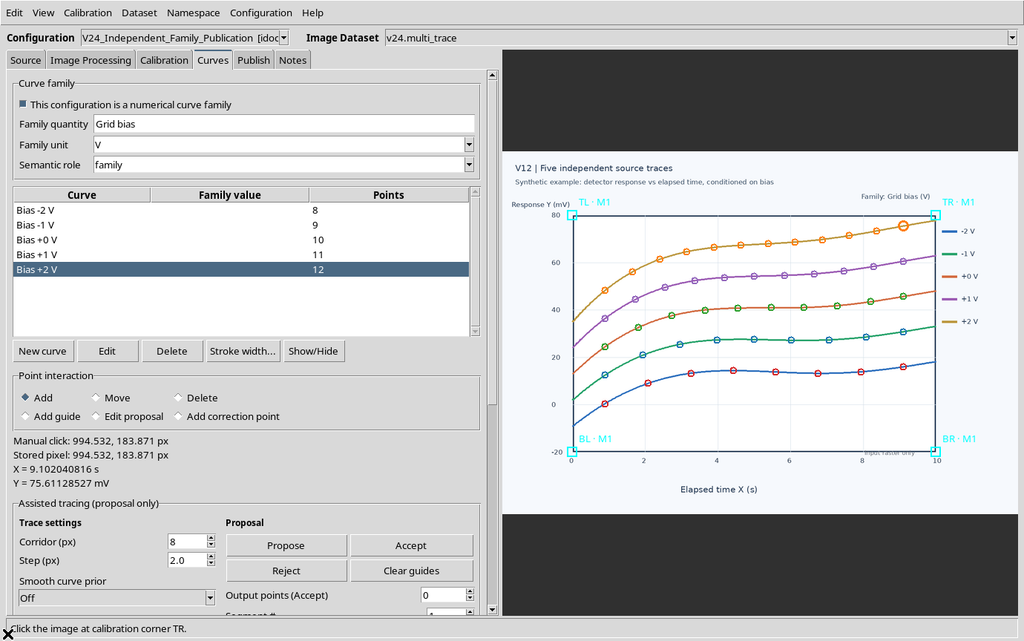
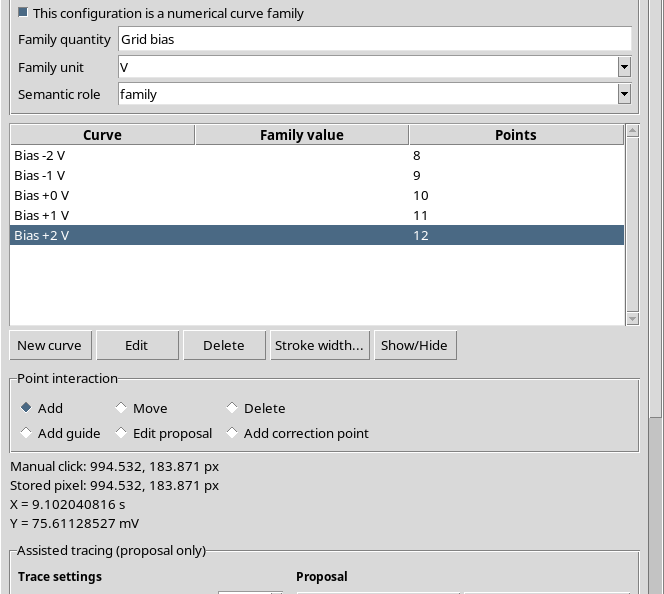
L’esempio usa Grid bias come nome della quantità, V come unità e family come ruolo scientifico. L’attivazione cambia il tipo di output previsto, ma non elimina né ricrea i cinquanta punti già accettati.
17. La famiglia richiede veri parametri numerici
Tentando di pubblicare subito, quando le curve non possiedono un valore numerico, il Viewer mostra un errore.
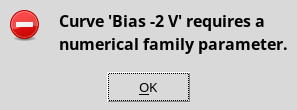
Non è possibile dedurre il parametro dal titolo «Bias −2 V». Il titolo è testo libero: il valore deve essere registrato nel campo dedicato, con la sua unità.
18. Aprire Edit curve per assegnare il parametro
Selezionare la prima curva e premere Edit.
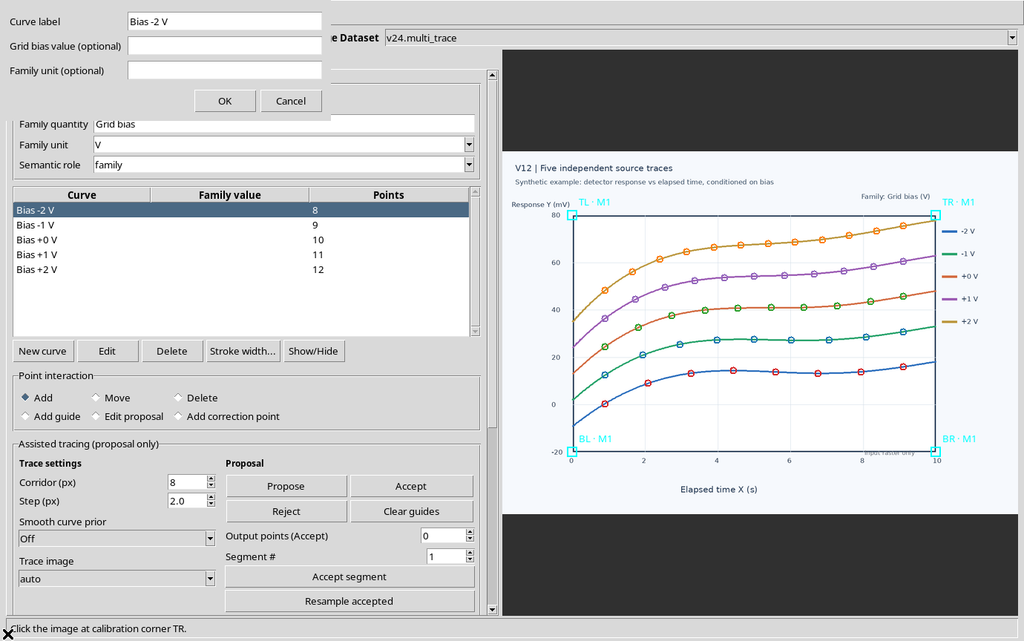
Nel dialogo inserire il valore del parametro per la curva.
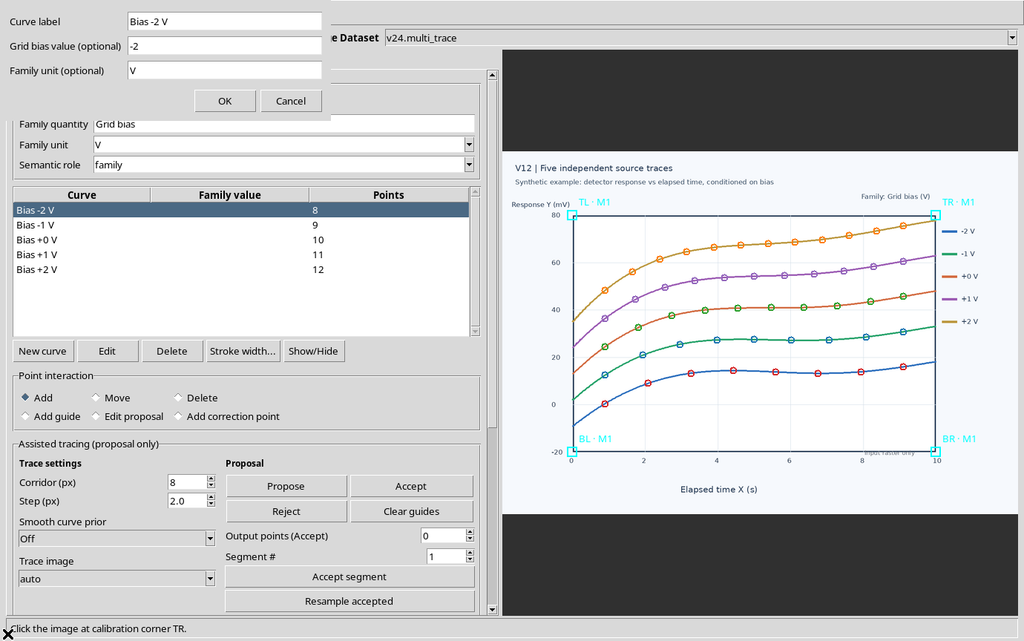
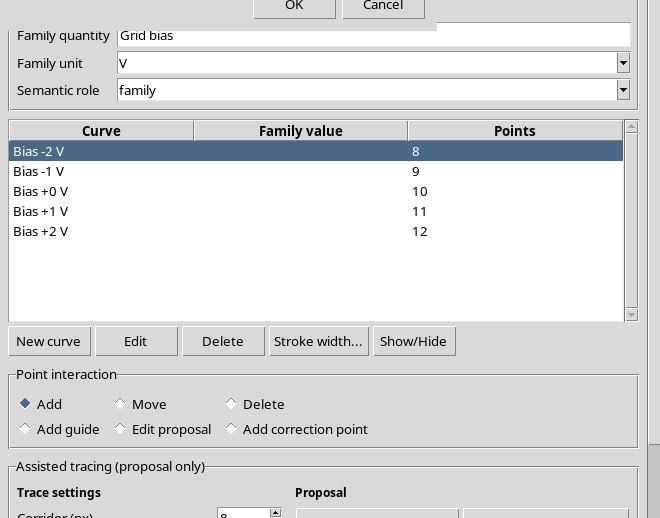
La prima condizione è −2 V. Il parametro appartiene alla serie e sarà ripetuto nelle righe di quella serie al momento della pubblicazione della famiglia.
19. Assegnare gli altri valori
Ripetere la procedura per i tracciati restanti: −1 V, 0 V, +1 V, +2 V.
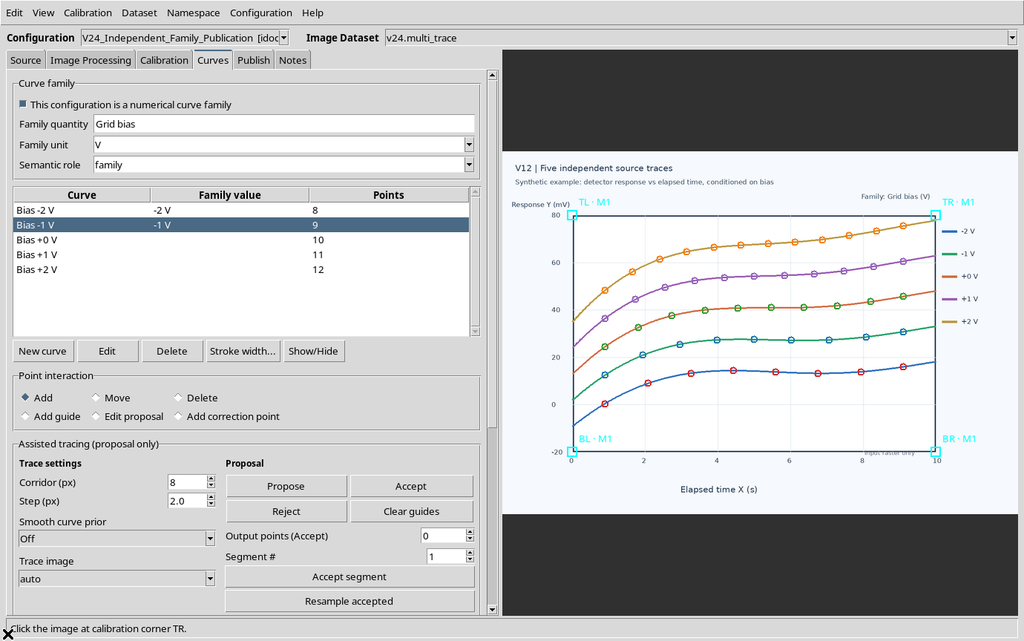
I valori non sono nuove misure della variabile Y: descrivono una condizione esterna associata a ciascuna curva.
20. Controllare le unità delle curve
Nell’esempio una prova intenzionalmente errata assegna all’ultima curva il valore 2 con unità mA, mentre la famiglia è definita in V.
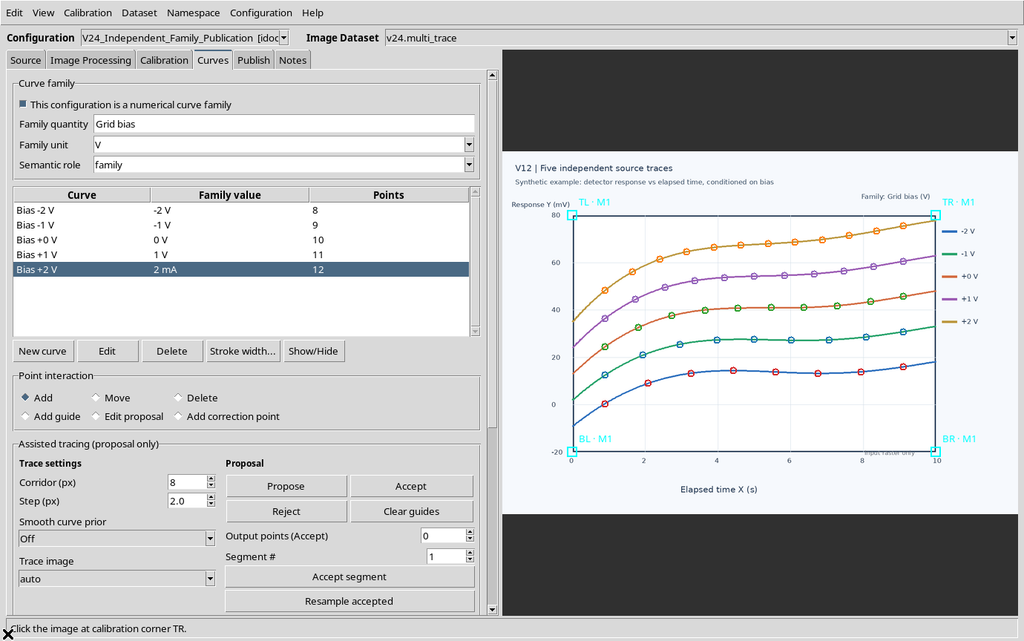
La GUI blocca la pubblicazione.
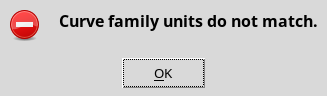
Il controllo impedisce di riunire in una colonna numerica comune condizioni espresse in unità dichiarate incompatibili.
21. Correggere l’unità della quinta curva
Aprire nuovamente Edit curve e correggere la sua unità in V.
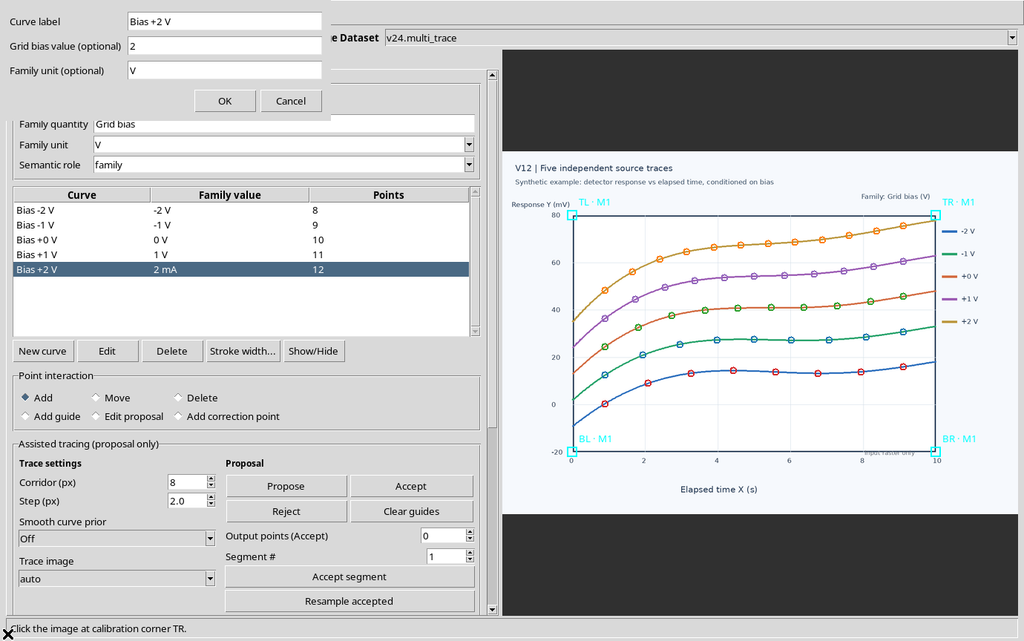
Non è necessario spostare o digitalizzare di nuovo i dodici punti della quinta serie: la modifica riguarda esclusivamente la descrizione del parametro.
22. Verificare la famiglia pronta
La tabella Curves mostra ora tutte le cinque condizioni numeriche correttamente espresse in volt.
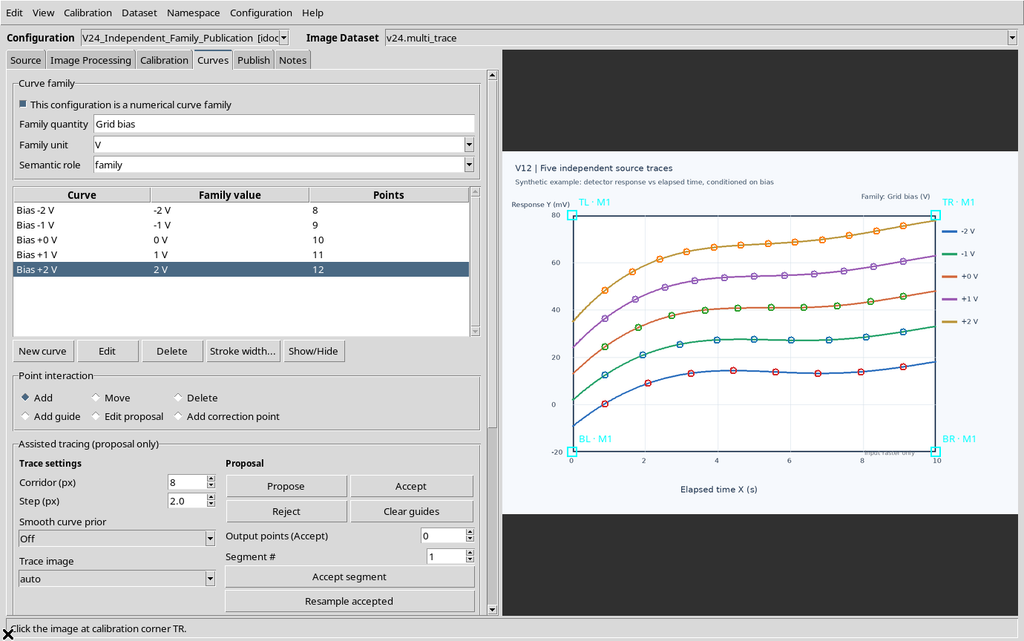
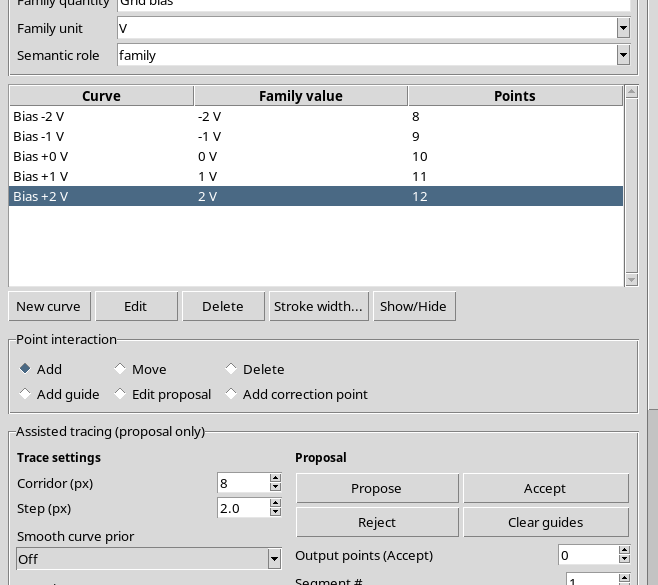
I conteggi rimangono 8, 9, 10, 11 e 12. Il raggruppamento è ancora associato alle identità delle cinque curve.
23. Preparare un secondo ID di output
Aprire Publish, mantenere la medesima calibrazione accettata e scegliere un nuovo ID base destinato al Dataset della famiglia.
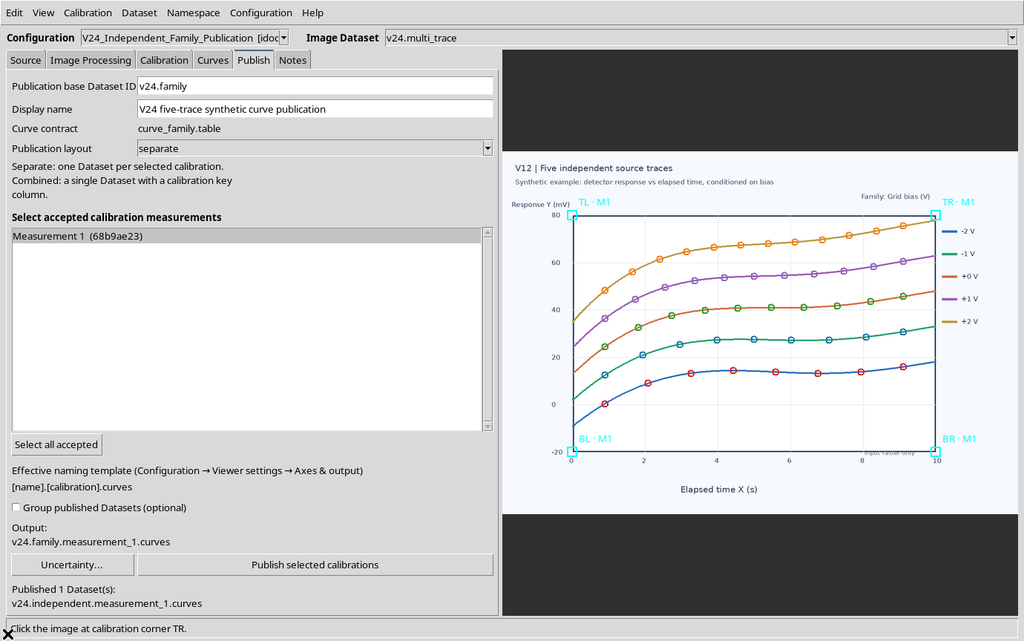
Utilizzare un ID diverso evita di confondere il risultato independent con il nuovo risultato numerical_family.
24. Pubblicare curve_family.table
Premere Publish selected calibrations.
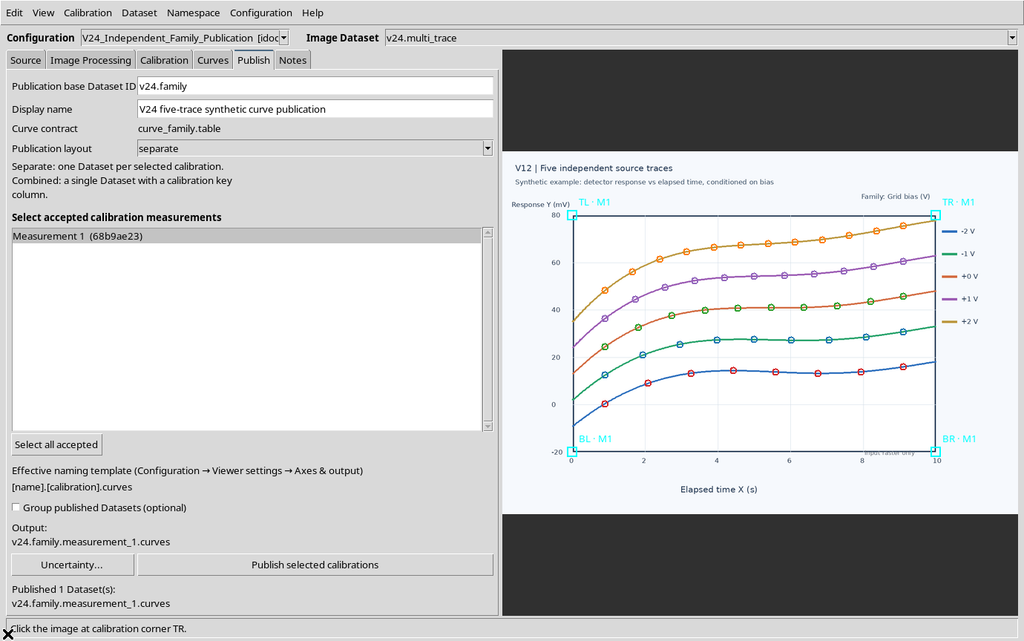
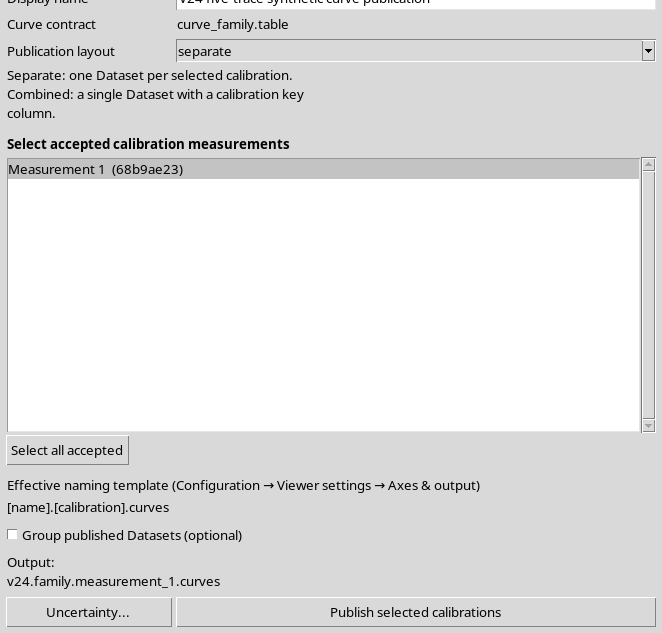
Il risultato ha ora il contratto curve_family.table, con 50 righe e una colonna numerica per la condizione Grid bias. I campioni scientifici X/Y sono quelli già digitalizzati.
25. Consultare la famiglia dal browser
Il browser Dataset mostra entrambi gli output, separatamente identificati.
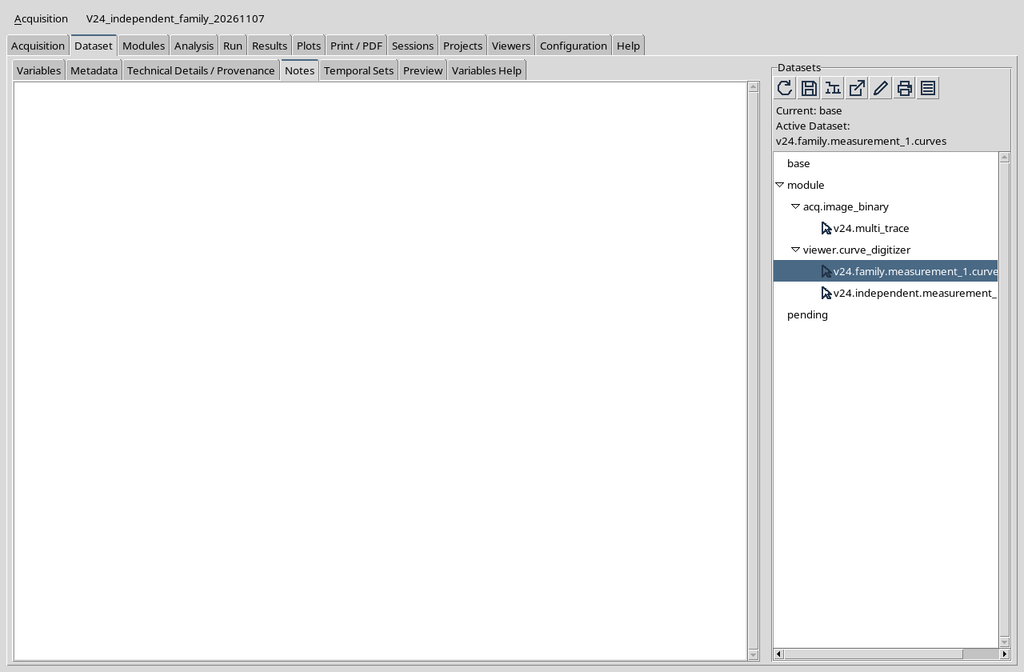
Aprendo il Dataset della famiglia si ottiene il CORE Scientific Dataset Viewer.
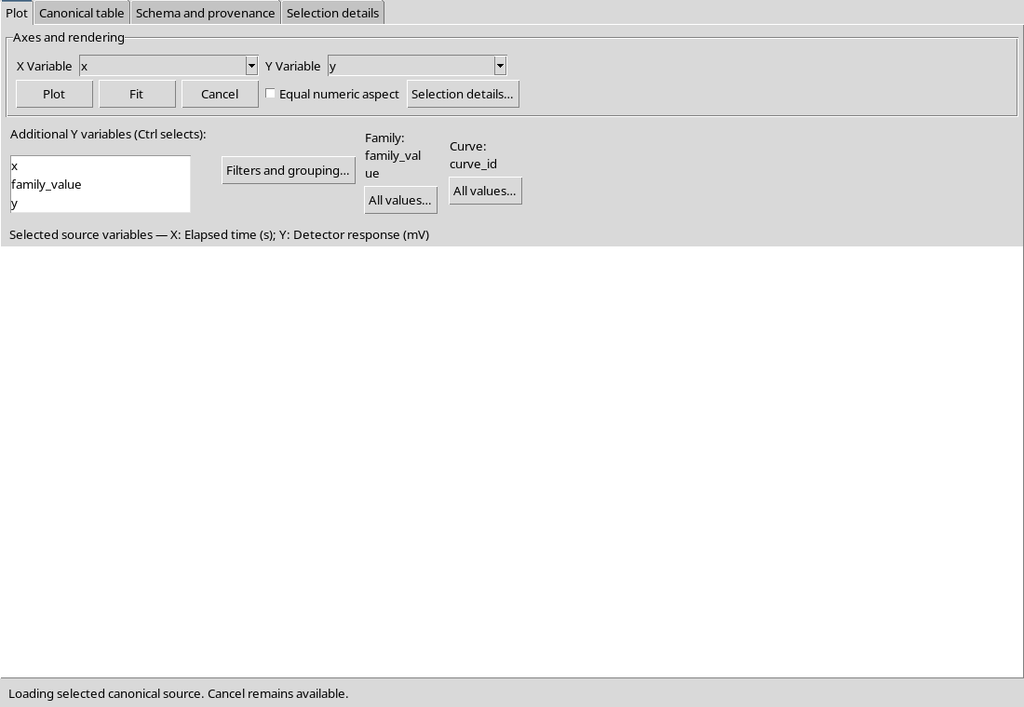
La corretta interpretazione scientifica non dipende dal nome della finestra o dal grafico generico, ma dal contratto curve_family.table e dai ruoli semantici.
26. La tabella canonica della famiglia
Nella tabella canonica compare ora la colonna family_value.
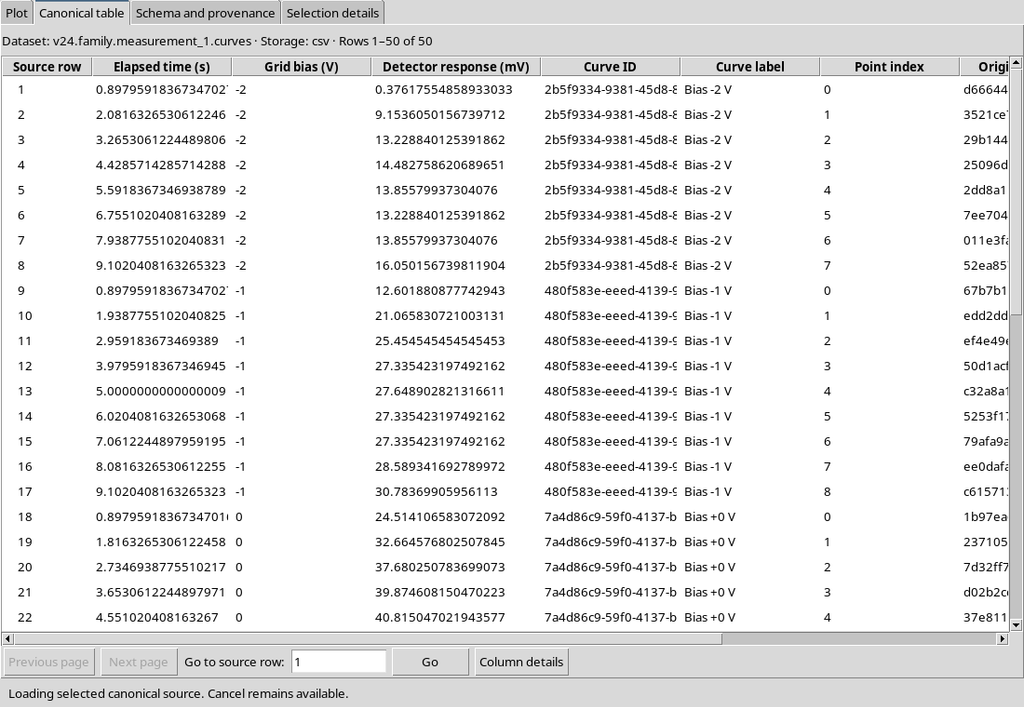
Per ogni punto di una determinata curva il valore del parametro è ripetuto: per esempio, la curva Bias −2 V conserva family_value = -2 in tutte le sue otto righe.
27. Una nuova colonna, non nuovi punti
Confrontando i due Dataset riga per riga si trova che i campi comuni sono identici: X/Y scientifiche, coordinate raster, etichetta, identificativo della curva, identificativo del punto e ordine.
| Proprietà | Curve indipendenti | Famiglia numerica |
|---|---|---|
| Contratto | table.generic | curve_family.table |
| Modalità | independent | numerical_family |
| Righe | 50 | 50 |
| Curve | 5 | 5 |
| Variabili canoniche | 8 | 9 |
| Parametro numerico | Assente | family_value |
| Chiave del raggruppamento | curve_key | curve_key |
La nuova colonna cambia il significato delle righe; non costituisce una seconda acquisizione sperimentale.
28. La provenienza strutturata del Dataset
Aprire Schema and provenance per leggere il contratto del risultato famiglia.
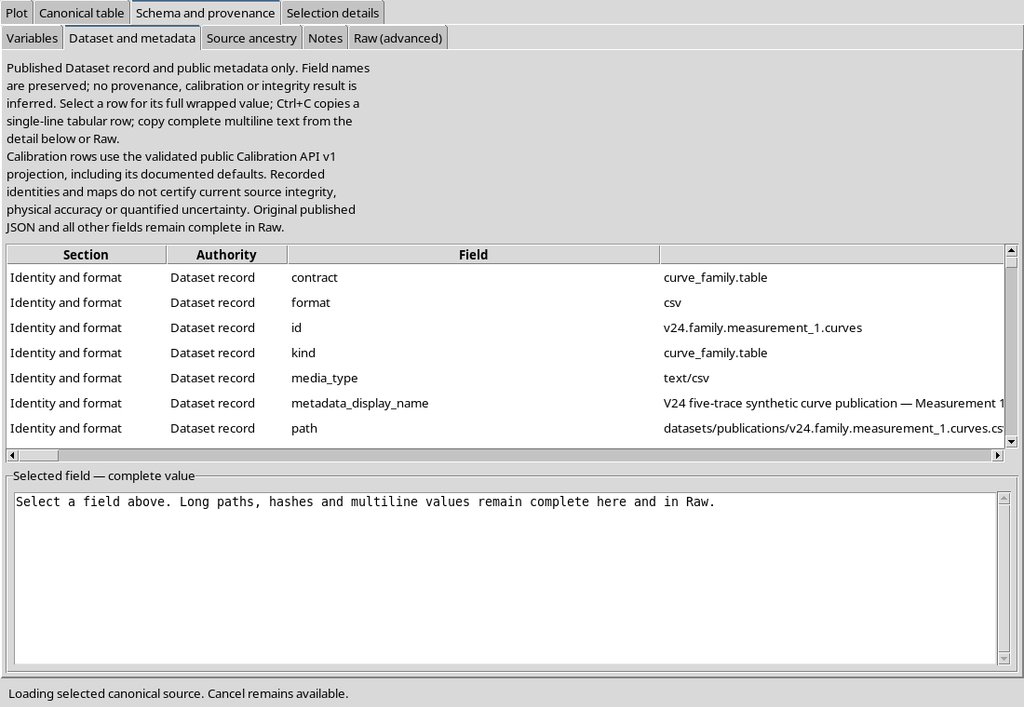
I metadati identificano l’immagine sorgente, la sua impronta SHA-256, la trasformazione di calibrazione e i ruoli delle variabili. La provenienza deve essere letta insieme ai dati, non ricostruita dai colori del grafico.
29. Nove variabili nella famiglia
La scheda Variables mostra nove variabili, contro le otto della pubblicazione indipendente.
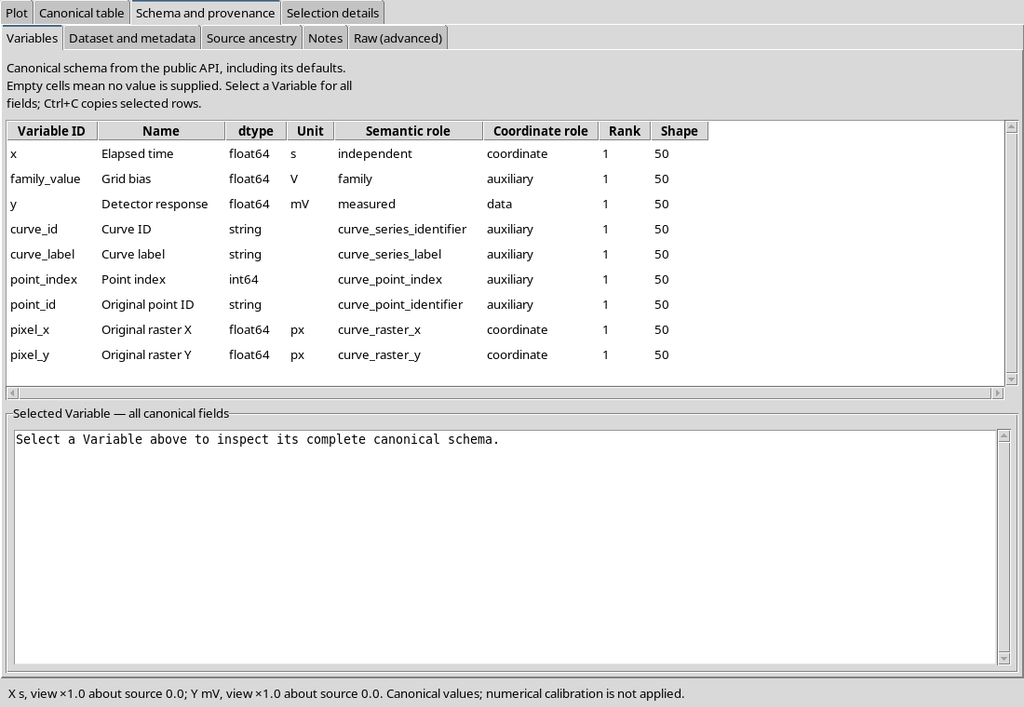
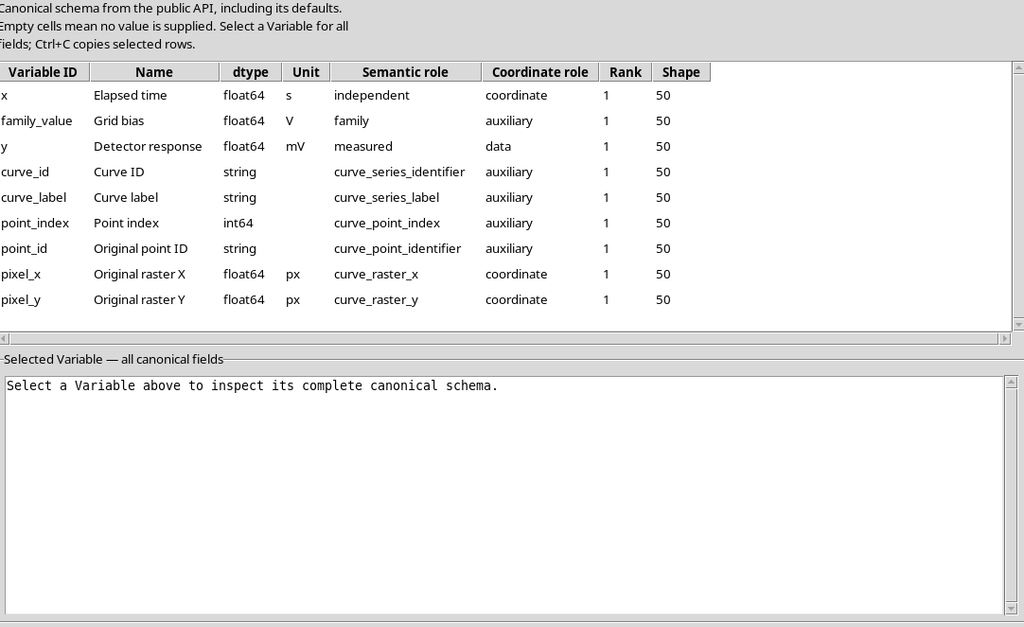
La variabile aggiuntiva è di tipo float64, ha unità V e ruolo family. Le coordinate X e Y continuano ad avere rispettivamente unità s e mV, senza cambio di asse.
30. Verificare l’ascendenza della sorgente
La scheda Source ancestry permette di controllare il collegamento del risultato con i suoi dati originari.
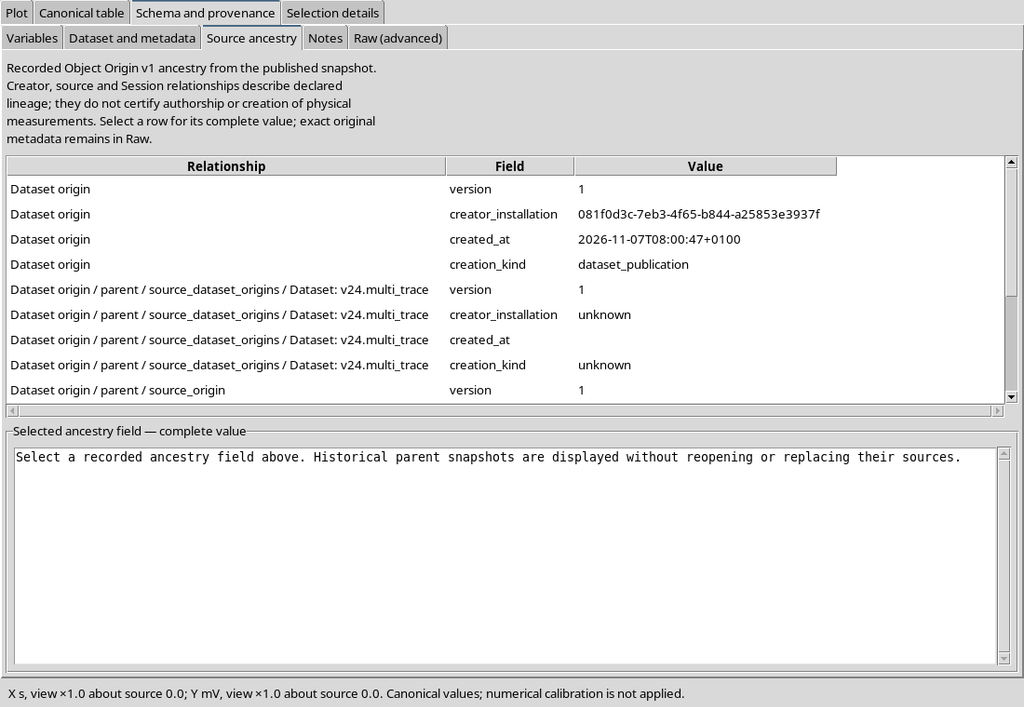
Nell’esempio entrambe le pubblicazioni conservano la stessa impronta dell’immagine originale e lo stesso SHA-256 della calibrazione. Non sono state generate due immagini diverse e non è stata ripetuta la calibrazione.
31. Il ruolo family_parameter nel Variable Schema
Selezionando la variabile family_value nel CORE si legge la sua descrizione.
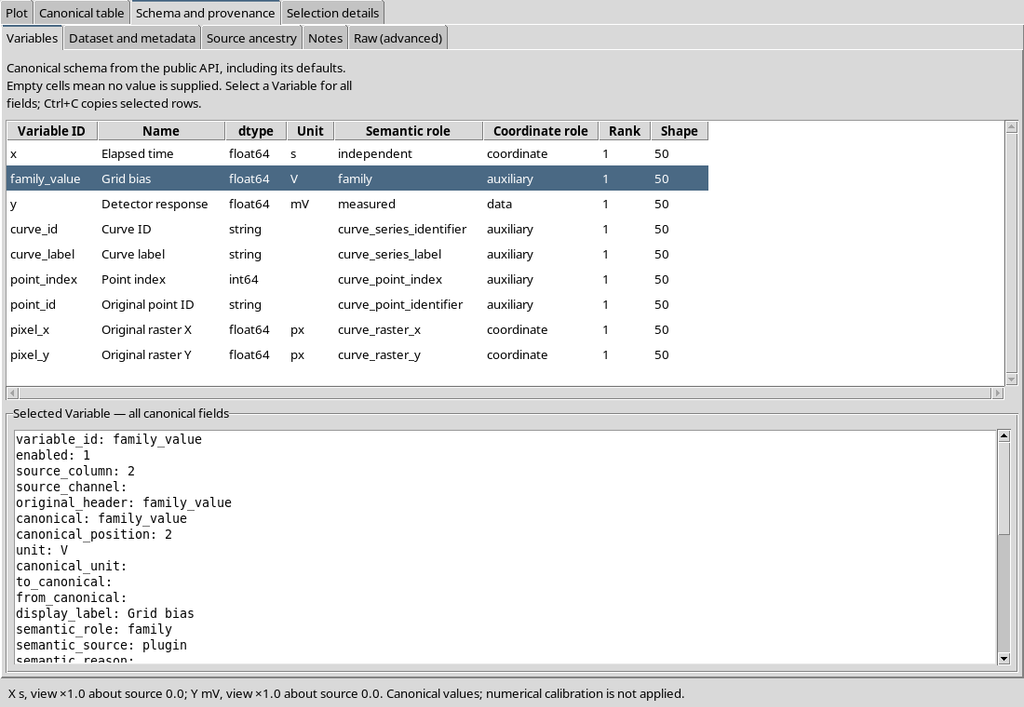
Il suo ruolo semantico stabile è family_parameter. Il parametro numerico descrive la condizione della serie, non il tempo X e non la risposta misurata Y.
32. Perché curve_key non può essere sostituito dal parametro
Nel Dataset famiglia è ancora presente una variabile testuale di identificazione della curva.
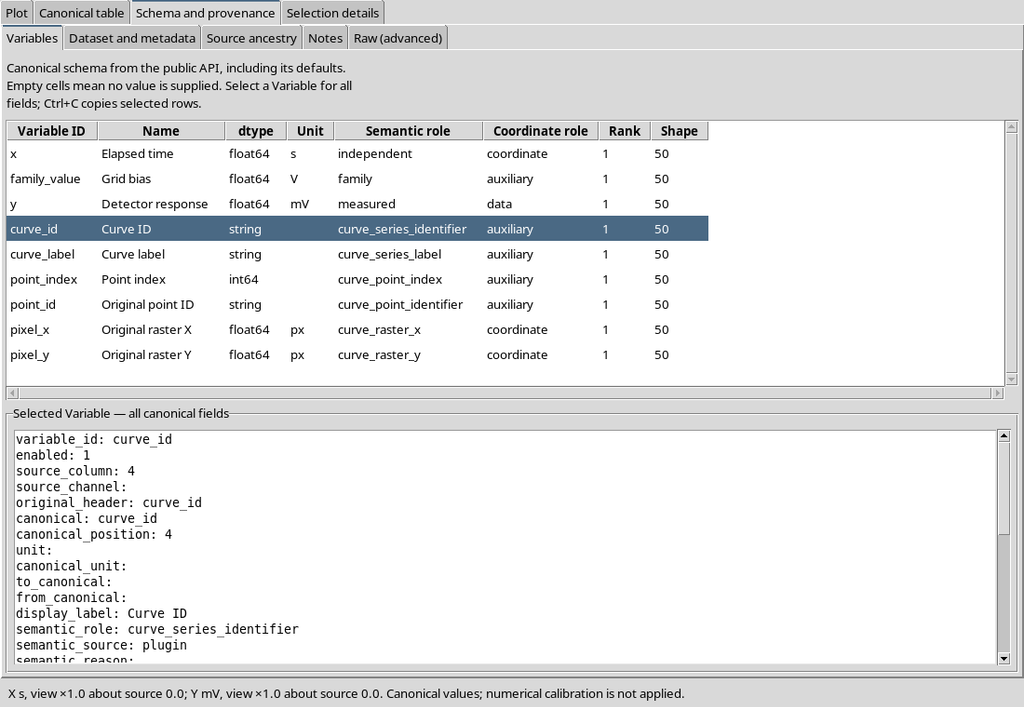
curve_key serve a separare le serie. family_parameter descrive una condizione numerica e non è una chiave primaria: in altri esperimenti due curve potrebbero condividere lo stesso valore del parametro, ma rimanere due curve differenti.
33. L’ordine dei punti è interno alla curva
Il campo point_order è un intero con origine zero.
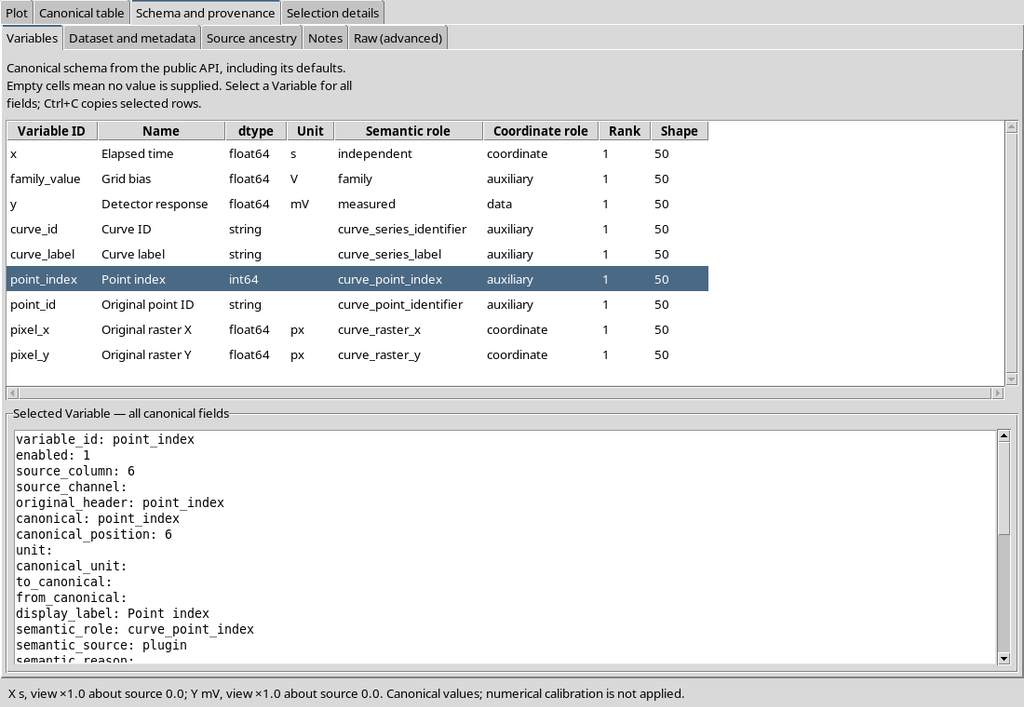
Nell’esempio le sequenze sono 0–7, 0–8, 0–9, 0–10 e 0–11, ciascuna nella propria curva. Ordinare globalmente i record per X o per il parametro non è equivalente a ricostruire la sequenza definita dall’operatore.
34. Le coordinate raster restano disponibili
Entrambi i Dataset pubblicati conservano le coordinate dei pixel originali, oltre a X/Y calibrate.
Questi riferimenti sono essenziali per il controllo scientifico: permettono di confrontare un punto numerico con la traccia originale senza dover ricostruire approssimativamente la geometria dal grafico visualizzato.
La sorgente utilizzata è un’immagine sintetica; la concordanza dei clic con le sue formule matematiche non misura l’accuratezza di uno strumento.
35. Tornare temporaneamente a independent
Il controllo This configuration is a numerical curve family può essere disabilitato nella configurazione corrente.
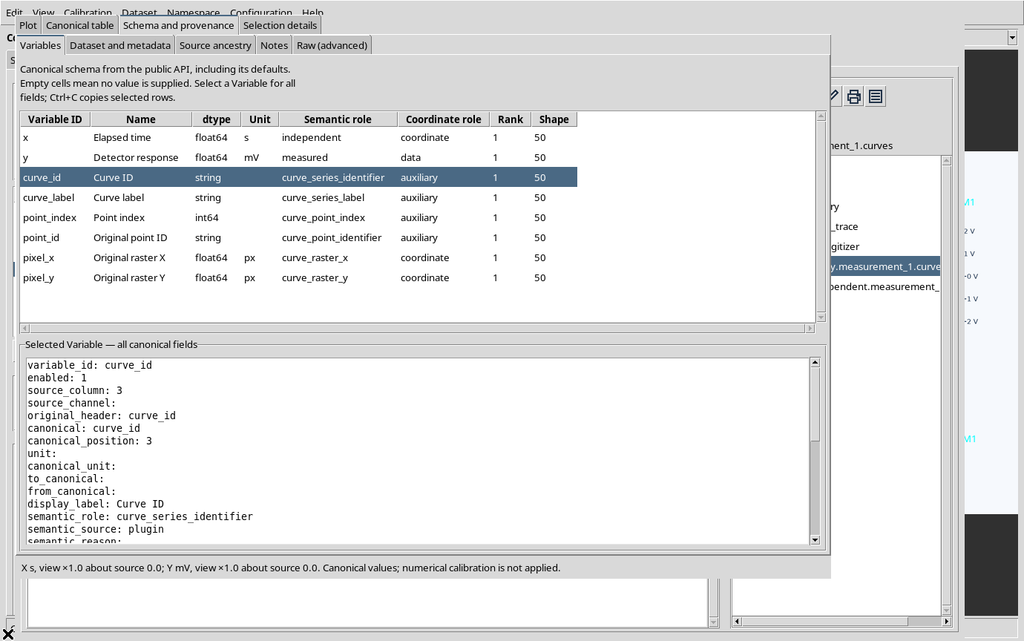
I cinque tracciati e i loro punti restano disponibili. I Dataset già pubblicati non vengono cancellati o reinterpretati dal cambio di modalità del documento ancora modificabile.
36. Riattivare la famiglia
Riabilitando il checkbox si ritrovano le cinque condizioni numeriche.
Nell’esempio la sequenza di punti, gli identificativi e le coordinate è rimasta invariata, sia nel documento sia negli output già consolidati.
37. Salvare, chiudere e riaprire
Usare Configuration → Save configuration, chiudere normalmente il Viewer e riaprirlo dalla stessa Session.
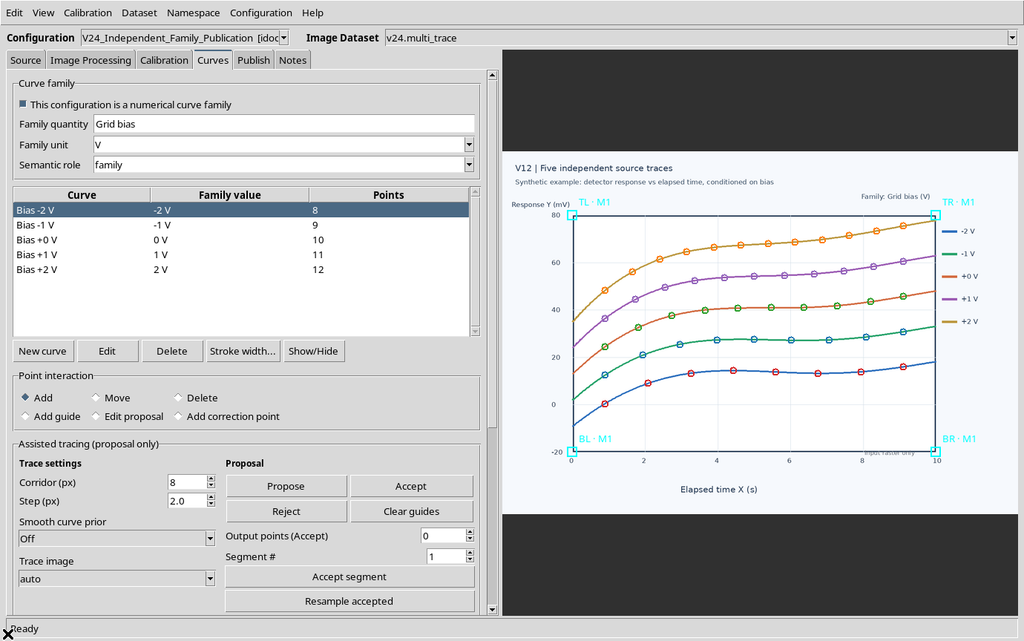
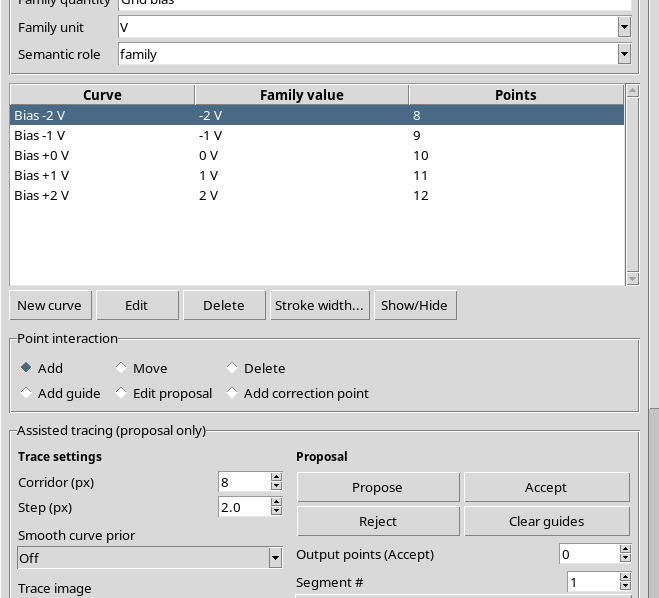
Tornano le cinque curve, i valori −2, −1, 0, +1 e +2 V e i cinquanta punti originali.
38. Persistenza degli output e della sorgente
La scheda Publish mostra il piano di pubblicazione della famiglia, ancora associato alla calibrazione accettata.
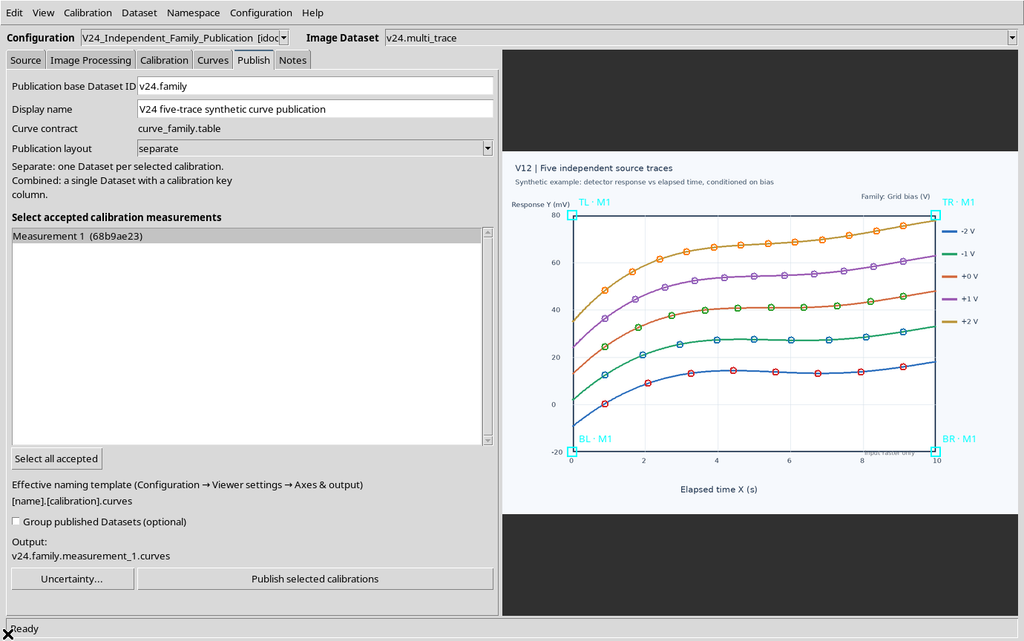
La scheda Source conferma che il Dataset sorgente è ancora quello originale.
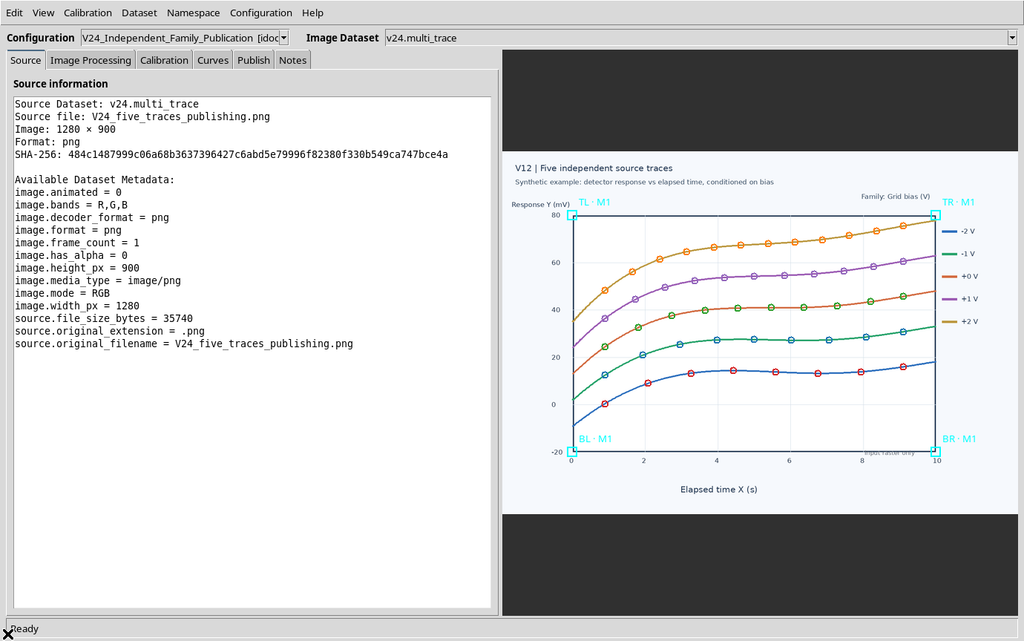
Le API pubbliche continuano a leggere i due Dataset già pubblicati, con identità e SHA-256 invariati. Questa persistenza è distinta dall’operazione di salvataggio della configurazione corrente.
39. Leggere le colonne tramite le API pubbliche
I programmi che consumano il risultato non dovrebbero dedurre ruoli scientifici da nomi tecnici come curve_id, curve_label o family_value, perché potrebbero evolvere. La API versionata del Curve Digitalizer risolve le associazioni dai metadati e dal Variable Schema v3.
Un esempio Tcl nell’ambiente GX-TXT, con la Session appropriata aperta:
# Activate the public Curve Digitalizer Dataset Schema API.
::GX::modulePublicApiActivate viewer.curve_digitizer CURVE_DIGITIZER_DATASET_SCHEMA_API_v1

set dataset_id "example.family.curves"
set manifest [::GX::CurveDigitizerDataset::read $dataset_id]

# Resolve semantic roles rather than assuming CSV header positions.
set curve_key_variable [dict get $manifest columns curve_key]
set point_order_variable [dict get $manifest columns point_order]
set x_variable [dict get $manifest columns x]
set y_variable [dict get $manifest columns y]

# A numerical family also declares a repeated numeric parameter.
if {[dict get $manifest mode] eq "numerical_family"} {
    set parameter_variable [dict get $manifest columns family_parameter]
}

# Read the original raster positions through the bounded public API.
set batch [::GX::CurveDigitizerDataset::rasterPoints $dataset_id "" 0 100]

# Group rows by curve_key, then order within each group by point_order.
La funzione rasterPoints fornisce le coordinate sorgente in una lettura limitata. I ruoli restituiti dalla API sono collegati alle variabili canoniche effettivamente pubblicate.
40. Curve indipendenti e famiglie non sono sinonimi
La modalità independent è appropriata quando le curve devono essere considerate serie distinte, senza un parametro numerico comune dichiarato.
La modalità numerical_family è appropriata quando la variazione di una quantità, come Grid bias in volt, ha un significato scientifico esplicito per ogni serie.
Non convertire una famiglia soltanto perché i nomi delle curve contengono numeri: occorrono unità coerenti e un vero parametro. Viceversa, non considerare due Dataset come nuove misurazioni indipendenti se provengono dalla stessa identica acquisizione dei punti.
41. Procedura operativa consigliata
- Importare il raster originale e accettare la calibrazione scientifica.
- Creare una curva per ogni tracciato, assegnando nomi chiari e acquisendo i punti nella serie corretta.
- Verificare i conteggi e il raggruppamento per curva, senza usare il nome come identificativo.
- Per curve indipendenti, mantenere disattivata la famiglia e pubblicare il Dataset table.generic.
- Per una famiglia, abilitare This configuration is a numerical curve family e indicare quantità, unità e valore numerico di ciascuna curva.
- Correggere valori assenti o unità incompatibili prima della pubblicazione.
- Pubblicare il Dataset curve_family.table con un’identità distinta.
- Aprire i due risultati nel CORE e confrontare le righe canoniche e il Variable Schema.
- Utilizzare CURVE_DIGITIZER_DATASET_SCHEMA_API_v1 per risolvere le colonne, curve_key per il raggruppamento e point_order per la sequenza.
- Salvare, chiudere e riaprire; controllare la sorgente, il numero di punti, il parametro della famiglia e la persistenza dei Dataset.
Conclusione: la conversione da curve indipendenti a famiglia numerica cambia la semantica della tabella pubblicata, non i pixel né le coordinate originali. La distinzione corretta fra identità della curva, ordine dei punti e parametro della famiglia consente agli strumenti successivi di analisi di utilizzare i dati senza confondere tracciati o condizioni sperimentali.